

Hallo, Habr! Bei Dodo Pizza Engineering lieben wir Daten sehr (wer tut das nicht?). Jetzt erzählen wir die Geschichte, wie wir alle Daten der Dodo Pizza-Welt sammeln und jedem Mitarbeiter des Unternehmens einen bequemen Zugang zu diesem Datensatz ermöglichen. Die Aufgabe mit einem Sternchen: Die Nerven des Data Engineering-Teams schonen.
Wie wahre Messies sammeln wir verschiedene Informationen über die Arbeit unserer Pizzerien:
- Wir behalten alle Bestellungen der Nutzer im Gedächtnis;
- Wir wissen, wie lange es gedauert hat, die erste Pizza in Syktywkar zu backen;
- Wir sehen, wie lange die Pizza gerade jetzt auf dem Wärmegestell in Woronesch abkühlt;
- Wir speichern Daten über den Abgang von Produkten;
- und vieles, vieles mehr.
Für die Arbeit mit Daten bei Dodo Pizza sind jetzt mehrere Teams zuständig, eines davon ist das Data Engineering-Team. Momentan steht vor uns (also uns) die Aufgabe: Jedem Mitarbeiter des Unternehmens einen bequemen Zugang zu diesem Datensatz zu ermöglichen.
Als wir darüber nachdachten, wie wir das umsetzen können, fanden wir einen sehr interessanten Ansatz zum Datenmanagement – (den Link finden Sie in einem großartigen Artikel). Die Ideen darin passten sehr gut zu unserem Konzept, wie wir unser System aufbauen wollen. Weiter im Artikel werden wir unseren neu gedachten Ansatz vorstellen und wie wir seine Implementierung bei Dodo Pizza Engineering sehen.
Was wir unter "Daten" verstehen
Lassen Sie uns zuerst klären, was wir unter Daten bei Dodo Pizza Engineering verstehen:
- Ereignisse, die von Diensten gesendet werden (wir haben einen gemeinsamen Bus, der mit RabbitMQ betrieben wird);
- Datensätze innerhalb der Datenbank (für uns sind das MySQL und CosmosDB);
- Clickstream von der mobilen Anwendung und der Website.
Damit das Geschäft von Dodo Pizza diese Daten nutzen und sich auf sie verlassen kann, ist es wichtig, dass folgende Bedingungen erfüllt sind:
- Sie müssen integrativ sein. Wir müssen sicherstellen, dass wir die Daten während ihrer Verarbeitung, Speicherung und Anzeige nicht verändern. Wenn das Geschäft unseren Daten nicht vertrauen kann, haben sie keinen Nutzen.
- Sie müssen einen Zeitstempel haben und dürfen nicht überschrieben werden. Das bedeutet, dass wir jederzeit die Möglichkeit haben wollen, zurückzugehen und die Daten eines bestimmten Zeitraums anzusehen. Zum Beispiel, um herauszufinden, wie viele Pizzen am 8. Juli 2018 verkauft wurden.
- Sie müssen zuverlässig sein. Bei der Sammlung und Speicherung von Daten dürfen wir nicht nur die Integrität, sondern auch die Zuverlässigkeit nicht verlieren. Wir können keine Daten verlieren, Zeitabschnitte, denn damit verlieren wir das Vertrauen unserer Kunden (sowohl extern als auch intern).
- Sie müssen mit einem stabilen Schema arbeiten – wir schreiben Abfragen für diese Daten. Wir möchten auf keinen Fall, dass sich mit Änderungen am Anwendungscode, mit Refactoring, die Abfragen so stark ändern, dass sie nicht mehr funktionieren. Derjenige, der die Abfragen schreibt, wird niemals erfahren, dass Sie Refactoring durchgeführt haben, bis alles kaputt ist. Wir wollen davon nicht von den Kunden erfahren.
In Anbetracht all dieser Anforderungen sind wir zu dem Schluss gekommen, dass die Daten bei Dodo ein Produkt sind. Genauso wie die öffentliche API des Dienstes. Dementsprechend sollte das Team, das die Dienstleistung besitzt, auch die Daten besitzen. Zudem sollten Änderungen am Datenmodell immer abwärtskompatibel sein.
Traditioneller Ansatz – Data Lake
Um die Herausforderungen der zuverlässigen Speicherung und Verarbeitung großer Datenmengen zu meistern, gibt es einen traditionellen Ansatz, der in vielen Unternehmen, die mit solchen Datenpools arbeiten, angewendet wird – Data Lake. Im Rahmen dieses Ansatzes sammeln Data Engineers Informationen aus allen Komponenten des Systems und speichern sie in einem großen Speicher (das kann zum Beispiel Hadoop, Azure Kusto, Apache Cassandra oder sogar eine MySQL-Replikation sein, wenn die Daten hineinpassen).
Anschließend schreiben dieselben Ingenieure Abfragen für dieses Speicher. Die Implementierung dieses Ansatzes in Dodo Pizza Engineering bedeutet, dass das Data Engineering-Team das Datenmodell im analytischen Storage besitzen wird.
In diesem Szenario werden die Teams sehr traurige Katzen, und das aus folgenden Gründen:
- Sie müssen die Änderungen in ALLEN Diensten innerhalb des Unternehmens überwachen. Und es gibt viele davon, und Änderungen geschehen ständig (im Durchschnitt mergen wir etwa 100 Pull-Requests pro Woche, während viele Dienste überhaupt keine Pull-Requests erstellen).
- Bei Änderungen am Datenmodell muss der Produktverantwortliche und das Team, das das Datenmodell ändert, warten, bis das Data Engineering den erforderlichen Code geschrieben hat, um die Änderungen zu unterstützen. Dabei hat man schon lange festgestellt, dass Situationen, in denen ein Team auf ein anderes warten muss, sehr selten sind. Und wir möchten nicht, dass dies ein "normaler" Teil des Entwicklungsprozesses wird.
- Es muss in ALLEM Das Geschäft des Unternehmens. Das Netzwerk der Pizzerien scheint ein einfaches Geschäft zu sein, aber das ist nur der äußere Schein. Es ist äußerst schwierig, ein Team zu versammeln, das über genügend Kompetenzen verfügt, um ein angemessenes Datenmodell für das gesamte Unternehmen zu erstellen.
- Es ist ein einzelner Ausfallpunkt. Jedes Mal, wenn es nötig ist, die Daten zu ändern, die der Service zurückgibt, oder eine Abfrage zu schreiben, fallen all diese Aufgaben an das Data Engineering-Team. Am Ende hat das Team einen überlasteten Backlog.
Das bedeutet, dass das Team an einem Schnittpunkt einer enormen Menge an Bedürfnissen sitzt und diese kaum befriedigen kann. Dabei befindet sich das Team ständig unter Zeitdruck und Stress. Das möchten wir wirklich nicht. Daher müssen wir überlegen, wie wir diese Probleme lösen und gleichzeitig die Möglichkeit zur Datenanalyse erhalten können.
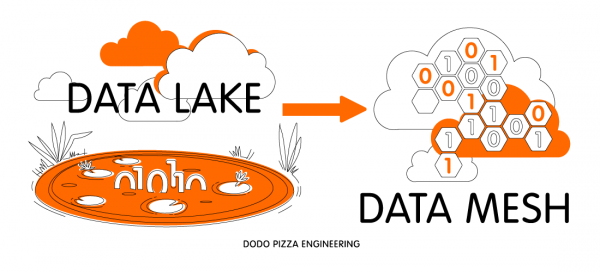
Vom Data Lake zum Data Mesh übergehen
Zum Glück haben sich nicht nur wir diese Frage gestellt. Tatsächlich wurde ein ähnliches Problem in der Industrie bereits gelöst (Halleluja!). Nur in einem anderen Bereich: Deployment von Anwendungen. Ja, ich spreche über den DevOps-Ansatz, bei dem das Team festlegt, wie das Produkt, das sie erstellen, bereitgestellt werden soll.
Einen ähnlichen Ansatz zur Lösung der Probleme des Data Lakes schlug Zhamak Dehghani, Beraterin bei ThoughtWorks, vor. Indem sie beobachtete, wie ähnliche Herausforderungen Netflix und Spotify angehen, verfasste sie einen großartigen Artikel (der Link dazu war am Anfang des Artikels). Die wichtigsten Ideen, die wir daraus gezogen haben:
- Teilen Sie den großen Data Lake in Daten-Domänen auf, die sehr ähnlich zu Domain-driven Design-Domänen sind. Jede Domäne ist ein kleiner Bound Context.
- Feature-Teams, die für DDD-Domänen verantwortlich sind, sind auch für die entsprechenden Daten-Domänen verantwortlich. Sie verwalten das Schema, nehmen Änderungen vor und laden Daten in dieses ein. Dabei wissen sie genau, wie sie die Datenladung ändern können, ohne etwas kaputt zu machen, wenn sich die Anwendung ändert. Das Wissen geht nicht verloren. Um Daten freizugeben, müssen sie nicht weiter gehen. Das Team führt den gesamten Entwicklungszyklus von der Änderung operativer Daten bis zur Bereitstellung analytischer Daten für Dritte durch. Ein Team besitzt alles, was mit der Domäne zur tun hat (sowohl mit der Geschäftsdomain als auch mit der Datendomäne).
- Data Engineer – eine Rolle innerhalb des Feature-Teams. Es muss nicht unbedingt eine separate Person sein, aber es ist erforderlich, dass das Team über diese Kompetenz verfügt.
Währenddessen arbeitet das Data Engineering-Team…
Wenn man sich vorstellt, dass das alles mit einem Fingerschnippen realisiert wird, bleibt nur noch zu beantworten, zwei Fragen:
Womit wird das Data Engineering-Team jetzt beschäftigt sein? Im Dodo Pizza Engineering gibt es bereits ein Plattform-/SRE-Team. Ihre Aufgabe ist es, den Entwicklern Werkzeuge für eine einfache Bereitstellung von Services zu geben. Das Data Engineering-Team wird dieselbe Rolle nur für die Daten übernehmen.
Die Umwandlung operativer Daten in analytische Daten ist ein komplexer Prozess. Analytische Daten für das gesamte Unternehmen zugänglich zu machen, ist noch komplizierter. Genau an der Lösung dieser Probleme wird das Data Engineering-Team arbeiten.
Wir planen, dem Feature Team ein praktisches Set von Werkzeugen und Praktiken zur Verfügung zu stellen, mit denen sie die Daten aus ihrem Service für das restliche Unternehmen veröffentlichen können. Zudem werden wir für die gemeinsamen Infrastrukturteile des Data-Pipelines verantwortlich sein (Warteschlangen, zuverlässige Speicherung, Cluster für Datenverarbeitungen).
Wie werden Data Engineer-Fähigkeiten im Feature Team entstehen? Es ist komplizierter mit dem Feature Team. Natürlich könnten wir versuchen, in jedes unserer Teams einen Data Engineer einzustellen. Aber das ist sehr schwierig. Jemanden mit einem soliden Hintergrund in der Datenverarbeitung zu finden und ihn zu überzeugen, in einem Produktteam zu arbeiten, ist eine Herausforderung.
Ein großer Vorteil von Dodo ist, dass wir internes Training schätzen. Daher ist unser Plan jetzt folgender: Das Data Engineering-Team beginnt, die Daten einiger Services zu veröffentlichen, weint, sticht sich, aber isst weiter den Kaktus. Sobald wir verstehen, dass wir einen funktionierenden Prozess zur Veröffentlichung haben, beginnen wir, darüber im Feature Team zu berichten.
Wir haben mehrere Möglichkeiten, dies zu tun:
- , auf dem wir erklären, wie der Prozess aussieht, den wir erstellt haben, welche Werkzeuge es gibt und wie man sie am effektivsten nutzen kann.
- Ein Auftritt auf dem DevForum wird uns helfen, Feedback von den Produktentwicklern zu sammeln. Danach können wir uns den Produktteams anschließen und ihnen helfen, Aufgaben zur Datenveröffentlichung zu lösen und Schulungen für die Teams zu organisieren.
Datenverbrauch
Ich habe jetzt viel über die Veröffentlichung von Daten gesprochen. Aber es gibt auch noch den Verbrauch. Was ist in dieser Hinsicht?
Wir haben ein tolles BI-Team, das sehr komplexe Berichte für die Managementgesellschaft erstellt. Innerhalb von Dodo IS gibt es viele Berichte für unsere Partner, die ihnen helfen, Pizzerien zu verwalten. In unserem neuen Modell betrachten wir sie als Datennutzer, die ihre eigenen Datenbereiche haben. Und genau die Nutzer werden für ihre eigenen Bereiche verantwortlich sein. Manchmal kann der Datenbereich eines Nutzers mit einer Abfrage im analytischen Lager beschrieben werden – und das ist gut. Aber wir verstehen, dass das nicht immer funktionieren wird. Deshalb möchten wir, dass die Plattform, die wir für die Produktteams schaffen, auch von den Datennutzern verwendet werden kann (schließlich werden es im Fall von Berichten innerhalb von Dodo IS dieselben Teams sein).
So sehen wir die Arbeit mit Daten in Dodo Pizza Engineering. Wir freuen uns auf Ihre Gedanken dazu in den Kommentaren.
Quelle: habr.com
