

DataHub mit offenem Quellcode: Plattform zur Suche und Entdeckung von Metadaten von LinkedIn
Eine schnelle Suche nach den benötigten Daten ist für jedes Unternehmen unerlässlich, das auf eine große Menge an Daten angewiesen ist, um Entscheidungen auf der Grundlage dieser Daten zu treffen. Dies beeinflusst nicht nur die Produktivität der Datenverwender (einschließlich Analysten, Entwicklern von Machine Learning, Datenbearbeitungsspezialisten und Data Engineers), sondern hat auch direkte Auswirkungen auf die Endprodukte, die von einem qualitativ hochwertigen Machine Learning (ML)-Pipeline abhängen. Darüber hinaus wirft der Trend zur Implementierung oder Schaffung von Machine Learning-Plattformen selbstverständlich die Frage auf: Wie sieht Ihre Methode zur internen Entdeckung von Funktionen, Modellen, Kennzahlen, Datensätzen usw. aus?
In diesem Artikel werden wir erläutern, wie wir die Datenquelle unter einer offenen Lizenz veröffentlicht haben in unserer Plattform zur Suche und Entdeckung von Metadaten, seit den frühen Tagen des Projekts . LinkedIn betreibt eine eigene Version von DataHub unabhängig von der Open-Source-Version. Wir beginnen damit, zu erklären, warum wir zwei separate Entwicklungsumgebungen benötigen, und werden dann die ersten Ansätze zur Nutzung von WhereHows mit Open Source erörtern und unsere interne (Produktions-)Version von DataHub mit der Version auf vergleichen. Wir werden auch Einzelheiten über unsere neue automatisierte Lösung zum Senden und Empfangen von Open Source-Updates teilen, um beide Repositories zu synchronisieren. Schließlich geben wir Anleitungen, wie Sie mit der Open Source-Version von DataHub beginnen können, und besprechen kurz seine Architektur.
WhereHows ist jetzt DataHub!
Das LinkedIn-Metadaten-Team hat zuvor den Nachfolger von WhereHows, die Plattform zur Suche und Entdeckung von Metadaten von LinkedIn, vorgestellt und Pläne zur Öffnung damit geteilt. Kurz nach dieser Ankündigung veröffentlichten wir die Alpha-Version von DataHub und teilten diese mit der Community. Seitdem haben wir kontinuierlich zum Repository beigetragen und mit interessierten Nutzern zusammengearbeitet, um die am meisten nachgefragten Funktionen hinzuzufügen und Probleme zu beheben. Jetzt freuen wir uns, die offizielle Veröffentlichung von .
Open-Source-Ansätze
WhereHows, das ursprüngliche Portal von LinkedIn zur Datensuche und -herkunft, wurde als internes Projekt gestartet; das Metadaten-Team hat den . Seitdem hat das Team stets zwei verschiedene Codebasen unterstützt – eine für den Open-Source-Code und eine für die interne Nutzung bei LinkedIn, da nicht alle Produktfunktionen, die für die Anwendungsfälle von LinkedIn entwickelt wurden, im Allgemeinen für ein breiteres Publikum anwendbar waren. Darüber hinaus hat WhereHows einige interne Abhängigkeiten (Infrastruktur, Bibliotheken usw.), deren Quellcode nicht öffentlich ist. In den folgenden Jahren durchlief WhereHows zahlreiche Iterationen und Entwicklungszyklen, was die Synchronisation der beiden Codebasen zu einer großen Herausforderung machte. Das Metadaten-Team hat über die Jahre hinweg versucht, verschiedene Ansätze zu verfolgen, um die interne Entwicklung und die Open-Source-Entwicklung zu synchronisieren.
Erster Versuch: „Zuerst Open Source“
Ursprünglich folgten wir dem Entwicklungsmodell „zuerst Open Source“, bei dem die Hauptentwicklung in einem Repository für Open Source erfolgt und Änderungen für die interne Bereitstellung vorgenommen werden. Das Problem mit diesem Ansatz besteht darin, dass der Code immer zuerst auf GitHub hochgeladen wird, bevor er vollständig intern geprüft wird. Solange keine Änderungen aus dem Open-Source-Repository vorgenommen werden und kein neues internes Deployment erfolgt, entdecken wir keine Produktionsprobleme. Im Falle eines fehlerhaften Deployments war es zudem sehr schwierig, den Verursacher zu ermitteln, da die Änderungen in Chargen vorgenommen wurden.
Zusätzlich hat dieses Modell die Produktivität des Teams bei der Entwicklung neuer Funktionen, die schnelle Iterationen erforderten, verringert, da es erforderte, dass alle Änderungen zunächst im Open-Source-Repository vorgenommen und dann in das interne Repository übertragen werden. Um die erforderliche Bearbeitungszeit zu verkürzen, konnten notwendige Korrekturen oder Änderungen zunächst im internen Repository erfolgen, was jedoch zu einem enormen Problem wurde, als es darum ging, diese Änderungen wieder in das Open-Source-Repository einzugliedern, da die beiden Repositories nicht mehr synchron waren.
Dieses Modell ist viel einfacher für allgemeine Plattformen, Bibliotheken oder Infrastrukturprojekte umzusetzen als für voll funktionsfähige benutzerdefinierte Webanwendungen. Darüber hinaus eignet sich dieses Modell perfekt für Projekte, die von Anfang an mit Open Source beginnen, aber WhereHows wurde als vollständig internes Webanwendungsprojekt entwickelt. Es war wirklich schwierig, sich vollständig von allen internen Abhängigkeiten zu abstrahieren, sodass wir eine interne Abspaltung behalten mussten, aber die Beibehaltung einer internen Abspaltung und die Entwicklung hauptsächlich mit Open Source haben nicht ganz funktioniert.
Zweiter Versuch: „Zuerst intern“
** Als zweiten Versuch sind wir zu einem Entwicklungsmodell „zuerst intern“ übergegangen, bei dem die Hauptentwicklung innerhalb des Unternehmens stattfindet und Änderungen regelmäßig in den Open Source Code übernommen werden. Obwohl dieses Modell am besten zu unserem Anwendungsfall passt, bringt es Herausforderungen mit sich. Das direkte Hochladen aller Unterschiede in das Open Source Repository und dann der Versuch, Merge-Konflikte später zu lösen, ist eine Möglichkeit, erfordert aber viel Zeit. Entwickler versuchen in den meisten Fällen, dies bei jeder Codeüberprüfung zu vermeiden. Infolgedessen wird dies viel seltener, in größeren Chargen durchgeführt, was die nachträgliche Lösung von Merge-Konflikten erschwert.
Beim dritten Mal hat es geklappt!
Die beiden oben genannten erfolglosen Versuche führten dazu, dass das WhereHows-Repository auf GitHub lange Zeit veraltet blieb. Das Team arbeitete weiterhin an der Verbesserung der Funktionen und der Architektur des Produkts, sodass die interne Version von WhereHows für LinkedIn immer perfekter wurde als die Open Source-Version. Es hatte sogar einen neuen Namen – DataHub. Basierend auf den vorherigen Misserfolgen entschied das Team, eine skalierbare langfristige Lösung zu entwickeln.
Für jedes neue Open Source-Projekt berät und unterstützt das Open Source-Entwicklungsteam von LinkedIn ein Entwicklungsmodell, bei dem die Projektmodule vollständig Open Source entwickelt werden. Versionierte Artefakte werden in einem öffentlich zugänglichen Repository bereitgestellt und dann mit Hilfe von . Die Befolgung dieses Entwicklungsmodells ist nicht nur vorteilhaft für diejenigen, die Open-Source-Software verwenden, sondern führt auch zur Schaffung einer moduläreren, erweiterbaren und anpassbaren Architektur.
Um diesen Zustand für eine ausgereifte interne Anwendung wie DataHub zu erreichen, wird jedoch eine erhebliche Zeitmenge benötigt. Dies schließt auch die Möglichkeit aus, eine vollständig funktionierende Open-Source-Implementierung bereitzustellen, bevor alle internen Abhängigkeiten vollständig abstrahiert sind. Daher haben wir Werkzeuge entwickelt, die uns helfen, schneller und mit weniger Aufwand Beiträge zu Open-Source-Projekten zu leisten. Diese Lösung ist sowohl für das Metadaten-Team (Entwickler von DataHub) als auch für die Open-Source-Community vorteilhaft. In den folgenden Abschnitten wird dieser neue Ansatz erörtert.
Automatisierung der Veröffentlichung mit Open Source
Der letzte Ansatz der Metadaten-Gruppe zum Open-Source-DataHub besteht darin, ein Tool zu entwickeln, das die interne Codebasis und das Open-Source-Repository automatisch synchronisiert. Die hochrangigen Funktionen dieses Werkzeugs umfassen:
- Synchronisierung des LinkedIn-Codes mit / aus dem Open Source, ähnlich .
- Generierung eines Lizenzkopfs, ähnlich .
- Automatische Erstellung von Open-Source-Commit-Protokollen aus internen Commit-Protokollen.
- Verhinderung interner Änderungen, die den Open-Source-Build gefährden, durch .
In den folgenden Unterabschnitten werden die oben genannten Funktionen mit interessanten Problemen ausführlich behandelt.
Synchronisierung des Quellcodes
Im Gegensatz zur Open-Source-Version von DataHub, die ein einziges GitHub-Repository darstellt, ist die LinkedIn-Version von DataHub eine Kombination mehrerer Repositories (intern als ). Die DataHub-Schnittstelle, die Bibliothek für Metadatenmodelle, der Backend-Dienst für das Metadaten-Repository und Streaming-Jobs befinden sich in verschiedenen Repositories bei LinkedIn. Um die Nutzung von Open Source zu erleichtern, haben wir jedoch ein einziges Repository für die Open-Source-Version von DataHub.
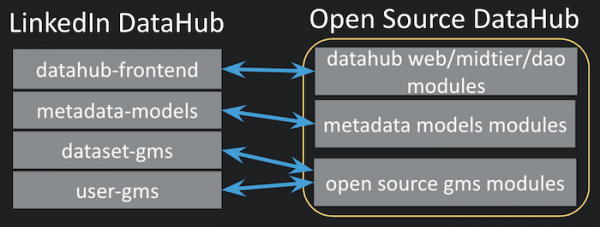
Abbildung 1: Synchronisierung zwischen Repositories LinkedIn DataHub und einem einzigen Repository DataHub mit offenem Quellcode
Um die automatischen Arbeitsabläufe für den Zusammenbau, das Versenden und das Abrufen zu unterstützen, erstellt unser neues Tool automatisch eine dateibasierte Zuordnung, die jeder Quelldatei entspricht. Für die Nutzung des Tools ist jedoch eine anfängliche Konfiguration erforderlich, und die Benutzer müssen eine hochrangige Zuordnung der Module bereitstellen, wie unten gezeigt.
{
  "datahub-dao": [
    "${datahub-frontend}\/datahub-dao"
  ],
  "gms\/impl": [
    "${dataset-gms}\/impl",
    "${user-gms}\/impl"
  ],
  "metadata-dao": [
    "${metadata-models}\/metadata-dao"
  ],
  "metadata-builders": [
    "${metadata-models}\/metadata-builders"
  ]
}
Die Zuordnung auf Modulebene ist ein einfaches JSON, dessen Schlüssel die Zielmodule im Open-Source-Repository sind und dessen Werte eine Liste der Quelmodule in den LinkedIn-Repositories darstellen. Jedes Zielmodul im Open-Source-Repository kann von beliebig vielen Quelmodulen gespeist werden. Zur Bezeichnung der internen Repository-Namen in den Quelmodulen wird im Bash-Stil verwendet. Mit der Zuordnungsdatei auf Modulebene erstellen die Tools eine dateibasierte Zuordnungsdatei, indem sie alle Dateien in den zugehörigen Verzeichnissen scannen.
{
  "${metadata-models}\/metadata-builders\/src\/main\/java\/com\/linkedin\/Foo.java":
"metadata-builders\/src\/main\/java\/com\/linkedin\/Foo.java",
  "${metadata-models}\/metadata-builders\/src\/main\/java\/com\/linkedin\/Bar.java":
"metadata-builders\/src\/main\/java\/com\/linkedin\/Bar.java",
  "${metadata-models}\/metadata-builders\/build.gradle": null,
}
Die dateibasierte Zuordnung wird automatisch von den Tools erstellt; sie kann jedoch auch vom Benutzer manuell aktualisiert werden. Dieses Mapping stellt eine 1:1-Zuordnung der LinkedIn-Quelldatei zu einer Datei im Open-Source-Repository dar. Es gibt einige Regeln, die mit dieser automatischen Erstellung der dateibasierten Zuordnung verbunden sind:
- Bei mehreren Quelmodulen für ein Zielmodul im Open Source kann es zu Konflikten kommen, beispielsweise wenn dasselbe , in mehr als einem Quelmodul existiert. Als Strategie zur Konfliktlösung verwenden unsere Tools standardmäßig die Regel „der letzte gewinnt“.
- "null" bedeutet, dass die Quelldatei nicht Teil des Open-Source-Repositories ist.
- Nach jeder Übermittlung in den offenen Quellcode oder aus ihm heraus wird diese Zuordnung automatisch aktualisiert und ein Schnappschuss erstellt. Dies ist notwendig, um Änderungen und Löschungen im Quellcode nach der letzten Aktion zu bestimmen.
Erstellung von Commit-Protokollen
Commit-Protokolle für Commits mit offenem Quellcode werden ebenfalls automatisch erstellt, indem die Commit-Protokolle interner Repositories zusammengeführt werden. Unten sehen Sie ein Beispiel eines Commit-Protokolls, das die Struktur eines von unserem Tool erstellten Commit-Protokolls zeigt. Der Commit zeigt deutlich an, welche Versionen der Quellrepositorien in diesem Commit verpackt sind, und bietet eine Zusammenfassung des Commit-Protokolls. Prüfen Sie dieses an einem realen Beispiel eines Commit-Protokolls, das von unserem Werkzeug erstellt wurde.
metadata-models 29.0.0 -> 30.0.0
    Hinzugefügt: Aspektmodell foo
    Fehler behoben: bar

dataset-gms 2.3.0 -> 2.3.4
    Hinzugefügt: rest.li API zur Bereitstellung des foo-Aspekts

MP_VERSION=dataset-gms:2.3.4
MP_VERSION=metadata-models:30.0.0
Testen von Abhängigkeiten
LinkedIn hat , die hilft sicherzustellen, dass Änderungen der internen Multi-Produkt-Umgebung die Builds der abhängigen Multi-Produkte nicht beeinträchtigen. Das DataHub-Repository mit offenem Quellcode ist kein Multi-Produkt und kann nicht von einem Multi-Produkt direkt abhängen, aber durch ein Multi-Produkt-Wrapper, das den Quellcode von DataHub mit offenem Quellcode abruft, können wir dieses Testsystem für Abhängigkeiten trotzdem nutzen. Somit führt jede Änderung (die möglicherweise später offenbart wird) in einem der Multi-Produkte, die das DataHub-Repository mit offenem Quellcode speisen, ein Build-Ereignis im Multi-Produkt-Wrapper aus. Folglich besteht die Regel, dass jede Änderung, die das Erstellen des Multi-Produkt-Wrappers verhindert, die Tests vor dem Commit des ursprünglichen Multi-Produkts nicht besteht und zurückgewiesen wird.
Dies ist ein nützliches Verfahren, das dabei hilft, jeden internen Commit zu verhindern, der den Build des offenen Quellcodes beeinträchtigt, und ihn während des Erstellens des Commits zu erkennen. Ohne dies wäre es ziemlich schwierig zu bestimmen, welcher interne Commit zum Build-Ausfall des Repositories mit offenem Quellcode geführt hat, da wir batchmäßige interne Änderungen im DataHub-Repository mit offenem Quellcode ablegen.
Unterschiede zwischen DataHub mit offenem Quellcode und unserer Produktionsversion
Bis zu diesem Zeitpunkt haben wir unsere Lösung zur Synchronisierung von zwei Versionen der DataHub-Repositories besprochen, aber noch nicht die Gründe definiert, warum wir überhaupt zwei verschiedene Entwicklungsschienen benötigen. In diesem Abschnitt listen wir die Unterschiede zwischen der öffentlichen Version von DataHub und der Produktionsversion auf den LinkedIn-Servern auf und erklären die Gründe für diese Unterschiede.
Eine der Quellen für die Unterschiede ergibt sich aus der Tatsache, dass unsere Produktionsversion von Code abhängt, der noch nicht offen ist, wie LinkedIn's Offspring (die interne Struktur zur Implementierung von Abhängigkeiten bei LinkedIn). Offspring wird in der internen Codebasis häufig verwendet, da es die bevorzugte Methode zur Verwaltung dynamischer Konfiguration ist. Da dies jedoch kein Open Source ist, mussten wir Alternativen mit offenem Quellcode für den open-source DataHub finden.
Es gibt auch andere Gründe. Während wir Metadatenmodell-Erweiterungen für die Bedürfnisse von LinkedIn erstellen, sind diese Erweiterungen in der Regel sehr spezifisch für LinkedIn und lassen sich möglicherweise nicht direkt auf andere Umgebungen anwenden. Zum Beispiel haben wir sehr spezifische Labels für Teilnehmer-IDs und andere Arten von Metadatenübereinstimmungen. Daher haben wir diese Erweiterungen derzeit aus dem Metadatenmodell des open-source DataHub ausgeschlossen. Während wir mit der Community interagieren und ihre Bedürfnisse verstehen, werden wir an allgemeinen Versionen dieser Erweiterungen mit offenem Quellcode arbeiten, wo dies erforderlich ist.
Die Benutzerfreundlichkeit und eine einfachere Anpassung für die Open-Source-Community haben auch einige Unterschiede zwischen den beiden Versionen von DataHub inspiriert. Unterschiede in der Streaming-Verarbeitungsinfrastruktur sind ein gutes Beispiel dafür. Während unsere interne Version eine Infrastruktur für verwaltete Streaming-Verarbeitung nutzt, haben wir uns entschieden, für die Open-Source-Version eine integrierte (autonome) Streaming-Verarbeitung zu verwenden, da dies weitere Infrastrukturabhängigkeiten vermeidet.
Ein weiteres Beispiel für den Unterschied ist die Existenz eines GMS (Generisches Metadaten-Repository) in der Open-Source-Implementierung, anstelle mehrerer GMS. GMA (Generische Metadatenarchitektur) ist der Name der internen Architektur für DataHub, während GMS das Metadatenrepository im Kontext von GMA ist. GMA ist eine sehr flexible Architektur, die es Ihnen ermöglicht, jede Datenstruktur (z. B. Datensätze, Benutzer usw.) in ein eigenes Metadatenrepository zu verteilen oder mehrere Datenstrukturen in einem einzigen Metadatenrepository zu speichern, solange das Verzeichnis, das die Zuordnung der Datenstruktur zu GMS enthält, aktualisiert wird. Zur Vereinfachung haben wir eine Instanz von GMS gewählt, die alle verschiedenen Datenstrukturen im Open-Source-DataHub speichert.
Die vollständige Liste der Unterschiede zwischen den beiden Implementierungen finden Sie in der Tabelle unten.
Produktmerkmale
LinkedIn DataHub
Open Source DataHub
Unterstützte Datenkonstrukte
1) Datensätze 2) Benutzer 3) Metriken 4) ML-Funktionen 5) Diagramme 6) Dashboards
1) Datensätze 2) Benutzer
Unterstützte Metadatenquellen für Datensätze
1) 2) Couchbase 3) 4) 5) HDFS 6) Hive 7) Kafka 8) MongoDB 9) MySQL 10) Oracle 11) 12) Presto 12) 13) Teradata 13) Vector 14)
Hive Kafka RDBMS
Pub-sub
Confluent Kafka
Stream-Verarbeitung
Verwaltet
Eingebettet (eigenständig)
Dependency Injection & Dynamische Konfiguration
LinkedIn Offspring
Build-Tools
Ligradle (LinkedIn’s interner Gradle-Wrapp)
CI/CD
CRT (LinkedIn’s interne CI/CD)
and
Metadatenstände
Verteilte mehrere GMS: 1) Dataset GMS 2) User GMS 3) Metric GMS 4) Feature GMS 5) Chart/Dashboard GMS
Einzelnes GMS für: 1) Datensätze 2) Benutzer
Mikroservices in Docker-Containern
vereinfachen das Bereitstellen und Verteilen von Anwendungen mithilfe von Jeder Teil des Dienstes im Open-Source-DataHub, einschließlich Infrastrukturkomponenten wie Kafka, , und , hat sein eigenes Docker-Image. Für die Orchestrierung der Docker-Container haben wir verwendet .
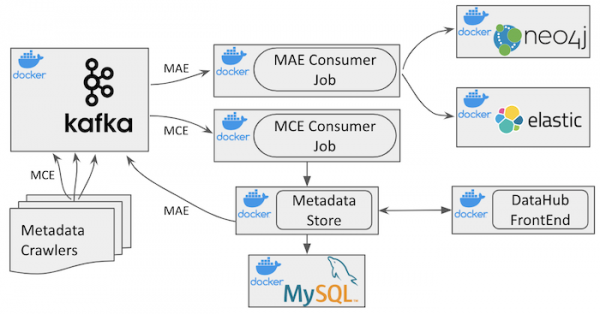
Abbildung 2: Architektur DataHub *Open Source*
Sie können die hochrangige Architektur von DataHub auf dem Bild oben sehen. Neben den Infrastrukturkomponenten hat es vier verschiedene Docker-Container:
datahub-gms: Metadatenrepository-Dienst
datahub-frontend: Anwendung , die die DataHub-Oberfläche bereitstellt.
datahub-mce-consumer: Anwendung , die den Änderungsereignisstrom von Metadaten (MCE) verwendet und das Metadatenrepository aktualisiert.
datahub-mae-consumer: Anwendung , die den Audit-Eventstrom von Metadaten (MAE) verwendet und eine Suchindex- und Graphdatenbank erstellt.
Dokumentation zum Open-Source-Repository und enthält detailliertere Informationen über die Funktionen verschiedener Dienste.
CI / CD in DataHub mit Open Source
Das Open-Source-Repository von DataHub verwendet für die kontinuierliche Integration und für das kontinuierliche Deployment. Beide haben eine gute Integration mit GitHub und sind einfach einzurichten. Für den Großteil der Open-Source-Infrastruktur, die von der Community oder von privaten Unternehmen (z.B. ), wurden Docker-Images erstellt, die im Docker Hub bereitgestellt werden, um die Nutzung für die Community zu vereinfachen. Jedes Docker-Image, das im Docker Hub gefunden wird, kann einfach mit einem einfachen Befehl verwendet werden. .
Bei jedem Commit im Open-Source-Repository von DataHub werden alle Docker-Images automatisch erstellt und im Docker Hub mit dem Tag „latest“ bereitgestellt. Wenn im Docker Hub eine , werden alle Tags im Open-Source-Repository ebenfalls mit den entsprechenden Tag-Namen im Docker Hub veröffentlicht.
Nutzung von DataHub
ist sehr einfach und besteht aus drei einfachen Schritten:
- Klonen Sie das Open-Source-Repository und starten Sie alle Docker-Container mit docker-compose unter Verwendung des bereitgestellten Docker-Compose-Skripts für eine schnelle Einrichtung.
- Laden Sie die im Repository bereitgestellten Beispieldaten mit dem ebenfalls bereitgestellten Kommandozeilenwerkzeug herunter.
- Durchsuchen Sie DataHub in Ihrem Browser.
Ein aktiver ist ebenfalls eingerichtet für schnelle Fragen. Benutzer können auch direkt im GitHub-Repository Issues erstellen. Am wichtigsten ist, dass wir alle Rückmeldungen und Vorschläge willkommen heißen und schätzen!
Zukunftspläne
Derzeit wird jede Infrastruktur oder Mikrodienst für DataHub mit Open Source als Docker-Container aufgebaut, und das gesamte System wird mithilfe von orchestriert. In Anbetracht der Beliebtheit und breiten Verfügbarkeit möchten wir auch bald eine auf Kubernetes basierende Lösung anbieten.
Wir planen auch, eine schlüsselfertige Lösung für die Bereitstellung von DataHub in einem öffentlichen Cloud-Dienst wie , oder anzubieten. Angesichts der jüngsten Ankündigung von LinkedIn zur Migration zu Azure wird dies den internen Prioritäten der Metadaten-Gruppe entsprechen.
Und zuletzt, aber nicht weniger wichtig: Vielen Dank an alle ersten Benutzer von DataHub in der Open-Source-Community, die die Alpha-Versionen von DataHub geschätzt und uns geholfen haben, Probleme zu identifizieren und die Dokumentation zu verbessern.
Quelle: habr.com
