

Anlässlich der Diskussion im Chat
In letzter Zeit entbrennen echte Kämpfe um die Definition der Begriffe DevOps und SRE.
Obwohl die Diskussionen zu diesem Thema schon vielerorts ausgelutscht sind, auch für mich, habe ich beschlossen, meine Sichtweise dem Habr-Community zur Prüfung vorzulegen. Wer interessiert ist, ist herzlich eingeladen, unter den Cut zu gehen. Und lasst uns alles neu beginnen!
Vorgeschichte
In alten Zeiten lebte das Team der Softwareentwickler und die Serveradministratoren getrennt. Die ersten schrieben erfolgreich Code, während die zweiten, die verschiedene warme, liebevolle Worte an die ersten richteten, die Server einrichteten und gelegentlich zu den Entwicklern kamen, um die erschöpfende Antwort "Auf meinem Rechner funktioniert alles" zu erhalten. Das Geschäft wartete auf die Software, alles stand still, stürzte gelegentlich ab, und alle waren nervös. Besonders derjenige, der für das ganze Chaos bezahlte. Die glorreiche analoge Ära. Aber das wisst ihr ja bereits, woher DevOps kommt.
Die Geburt der DevOps-Praktiken
Dann kamen ernsthafte Herren und sagten - das ist keine Industrie, so kann man nicht arbeiten. Und sie brachten Lebenszyklus-Modelle mit. Hier zum Beispiel das V-Modell.
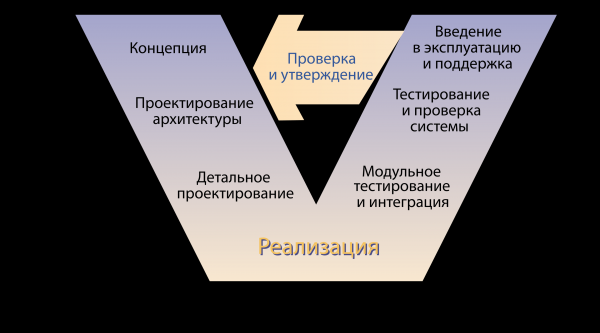
Also, was sehen wir? Das Geschäft kommt mit einem Konzept, Architekten planen Lösungen, Entwickler schreiben Code, danach kommt das Versagen. Jemand testet das Produkt auf die eine oder andere Weise, jemand liefert es irgendwie an den Endbenutzer und irgendwo am Ende dieses Wunder-Modells sitzt ein einsamer Geschäftskunde und wartet auf das versprochene Wetter am Meer. Es wurde festgestellt, dass Methoden benötigt werden, die diesen Prozess optimieren. Und sie beschlossen, Praktiken zu schaffen, die dies umsetzen würden.
Ein lyrischer Einschub darüber, was Praxis ist
Unter Praxis verstehe ich die Verbindung von Technologie und Disziplin. Beispiel - die Praxis der Beschreibung von Infrastruktur mit Code in Terraform. Die Disziplin ist, wie man die Infrastruktur mit Code beschreibt, sie ist im Kopf des Entwicklers, und die Technologie ist das eigentliche Terraform.
Und so beschlossen sie, sie DevOps-Praktiken zu nennen — ich denke, sie hatten von Entwicklung bis Betrieb gemeint. Sie erfanden verschiedene komplizierte Dinge — CI/CD-Praktiken, Praktiken, die auf dem IaC-Prinzip basieren, tausende davon. Und los ging's, die Entwickler schreiben Code, die DevOps-Ingenieure verwandeln die Beschreibung des Systems in Form von Code in funktionierende Systeme (ja, Code ist leider nur eine Beschreibung und keinesfalls die Verkörperung des Systems), die Auslieferung dreht sich, und so weiter. Die früheren Administratoren, die sich mit neuen Praktiken vertraut gemacht hatten, qualifizierten sich stolz zu DevOps-Ingenieuren um, und alles nahm seinen Lauf. Und es war Abend, und es war Morgen... Entschuldigung, das war nicht von dort.
Alles wieder nicht zum Lob Gottes
Gerade als sich alles beruhigt hatte, begannen verschiedene brillante "Methodologen", dicke Bücher über DevOps-Praktiken zu schreiben, es entbrannten leise Streitigkeiten darüber, wer denn nun dieser berüchtigte DevOps-Ingenieur ist und dass DevOps eine Produktionskultur ist, wieder machte sich Unzufriedenheit breit. Plötzlich stellte sich heraus, dass die Softwareauslieferung eine absolut knifflige Aufgabe ist. Jede Entwicklungsinfrastruktur hat ihren eigenen Stack; irgendwo muss man bauen, irgendwo die Umgebung einrichten, hier braucht man Tomcat, dort gibt es einen noch komplizierteren Weg, um zu starten — im Grunde schwirrt einem der Kopf. Und ein weiteres Problem, seltsamerweise, lag hauptsächlich in der Organisation der Prozesse — diese Lieferfunktion, wie ein Flaschenhals, begann, die Prozesse zu blockieren. Auch die Operations wurden nicht abgeschafft. Sie ist in dem V-Modell nicht sichtbar, und dort ist noch der ganze Lebenszyklus auf der rechten Seite. Am Ende muss man die Infrastruktur unterstützen, auf das Monitoring achten, Vorfälle managen und sich auch um die Auslieferung kümmern. Das heißt, man sitzt mit einem Bein sowohl in der Entwicklung als auch in der Betriebstechnik — und plötzlich entstand so etwas wie Development & Operations. Und dann kam auch noch der allgemeine Hype um Microservices. Und damit begann die Entwicklung von lokalen Maschinen in die Cloud umzuziehen — versuche etwas lokal zu debuggieren, wenn es Dutzende und Hunderte von Microservices gibt, da wird die ständige Auslieferung zum Überlebensmittel. Für eine „kleine bescheidene Firma“ mag das noch gehen, aber was ist mit Google?
SRE von Google
Google kam, fraß die größten Kakteen und entschied – das brauchen wir nicht, wir brauchen Zuverlässigkeit. Und Zuverlässigkeit muss gemanagt werden. Also entschied er – wir brauchen Spezialisten, die die Zuverlässigkeit managen. Er nannte sie SR-Ingenieure und sagte, hier habt ihr alles, macht es wie gewohnt, gut. Hier habt ihr SLI, hier habt ihr SLO, hier habt ihr Monitoring. Und zeigte auf die Operationen. Und nannte sein „zuverlässiges DevOps“ SRE. Scheinbar ist alles gut, aber es gibt einen schmutzigen Hack, den sich Google leisten konnte – für die Position der SR-Ingenieure Leute einzustellen, die die Qualifikation von Entwicklern hatten und zudem ein wenig von zu Hause aus die Funktionsweise arbeitender Systeme verstanden. Außerdem hat Google selbst Probleme bei der Einstellung solcher Leute – hauptsächlich, weil er ja auch mit sich selbst konkurriert – schließlich muss irgendjemand die Geschäftslogik beschreiben. Die Auslieferung übertrug er auf die Release-Ingenieure, SR-Ingenieure managen die Zuverlässigkeit (klar, nicht direkt, sondern durch Einfluss auf die Infrastruktur, Änderung der Architektur, Überwachung von Änderungen und Kennzahlen, sowie der Bearbeitung von Vorfällen). Schön, man kann . Was aber tun, wenn man nicht Google ist und die Zuverlässigkeit dennoch ein Anliegen ist?
Entwicklung von DevOps Ideen
Hier kam Docker gerade recht, das aus lxc hervorging, ebenso wie verschiedene Orchestrierungssysteme wie Docker Swarm und Kubernetes, und die DevOps-Ingenieure atmeten auf – die Vereinheitlichung der Praktiken erleichterte die Auslieferung. Sie erleichterte es so sehr, dass es sogar möglich wurde, die Auslieferung den Entwicklern zu überlassen – was ist schon deployment.yaml? Containerisierung löst das Problem. Außerdem ist die Reife der CI/CD-Systeme mittlerweile auf dem Niveau, dass man eine Datei schreibt und alles losgeht – die Entwickler schaffen das selbst. Und hier fangen wir an zu sprechen, wie wir unser eigenes SRE machen, mit… naja, mit irgendjemandem.
SRE nicht bei Google
Nun gut, die Lieferung haben wir übergeben, wir können scheinbar aufatmen und zu den alten guten Zeiten zurückkehren, als die Admins die Prozessorlast überwachten, Systeme optimierten und leise aus Tassen etwas Unverständliches in Stille und Ruhe tranken... Halt. Dafür haben wir das alles nicht gemacht (schade!). Plötzlich stellt sich heraus, dass wir aus dem Ansatz von Google großartige Praktiken übernehmen können — nicht die Prozessorlast ist wichtig, und nicht wie oft wir die Platten dort wechseln oder wie wir im Cloud die Kosten optimieren, sondern die Geschäftskennzahlen — all die berüchtigten SLx. Und das Management der Infrastruktur wurde uns nicht genommen, und Vorfälle müssen gelöst werden, und man muss gelegentlich Dienst schieben und überhaupt in den Geschäftsprozessen auf dem Laufenden sein. Und Jungs, fangt an, schon langsam auf gutem Niveau zu programmieren, Google wartet schon auf euch.
Zusammenfassend. Plötzlich, aber ihr seid schon müde zu lesen und könnt es kaum erwarten, dem Autor einen Kommentar zum Artikel zu schreiben. DevOps als Praktik der Bereitstellung war, ist und wird sein. Und es wird nirgends hingehen. SRE als eine Sammlung von Betriebspraktiken macht diese Bereitstellung erfolgreich.
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish