

Im Sommer sinken traditionell sowohl die Käuferaktivität als auch die Intensität der Änderungen an der Infrastruktur von Webprojekten, sagt uns Captain Offensichtlich. Einfach weil selbst ITler manchmal in den Urlaub fahren. Und auch CTOs. Umso schwieriger ist es für die, die am Posten bleiben, aber darum geht es jetzt nicht: vielleicht ist genau deshalb der Sommer die beste Zeit, um ungestört über das bestehende Reservierungsschema nachzudenken und einen Plan zu seiner Verbesserung zu erstellen. Und dabei wird euch die Erfahrung von Egor Andreev aus , die er auf der Konferenz .
Beim Aufbau von Backup-Plattformen und bei der Reservierung gibt es mehrere Fallen, in die man tappen kann. Und in diese darf man auf keinen Fall tappen. Und es sind uns dabei, wie in vielen anderen Dingen, Perfektionismus und… Faulheit im Weg. Wir versuchen, alles perfekt zu machen, und das muss nicht sein! Wir müssen nur bestimmte Dinge tun, aber sie richtig machen und bis zum Ende bringen, damit sie gut funktionieren.
Failover ist kein lustiges Gadget, „nur damit es vorhanden ist“; es ist etwas, das genau eines tun sollte – die Ausfallzeiten zu minimieren, damit der Dienst, das Unternehmen, weniger Geld verliert. Und bei allen Methoden der Reservierung schlage ich vor, im folgenden Kontext zu denken: Wo ist das Geld?
Die erste Falle: Wenn wir große, zuverlässige Systeme aufbauen und uns mit der Reservierung beschäftigen – verringern wir die Anzahl von Ausfällen. Das ist ein schrecklicher Irrtum. Wenn wir uns mit der Reservierung beschäftigen, erhöhen wir wahrscheinlich die Anzahl der Ausfälle. Und wenn wir alles richtig machen, verringern wir insgesamt die Ausfallzeit. Es wird mehr Ausfälle geben, aber sie werden mit geringeren Kosten eintreten. Denn was ist Reservierung? – Es ist eine Komplikation des Systems. Jede Komplikation ist schlecht: Wir haben mehr Schrauben, mehr Zahnräder, kurz gesagt, mehr Elemente – und damit eine höhere Wahrscheinlichkeit für Fehlfunktionen. Und sie werden wirklich kaputtgehen. Und sie werden häufiger kaputtgehen. Ein einfaches Beispiel: Angenommen, wir haben eine Website mit PHP, MySQL. Und diese muss dringend reserviert werden.
Nun, wir nehmen die zweite Plattform und bauen ein identisches System… Die Komplexität verdoppelt sich — wir haben zwei Entitäten. Darüber hinaus fügen wir eine bestimmte Logik für den Datenübertrag von einer Plattform zur anderen hinzu — also Datenreplikation, das Kopieren von Statischer und so weiter. Die Logik der Replikation ist in der Regel sehr komplex, deshalb kann die gesamte Systemkomplexität nicht nur um das 2-fache, sondern um das 3-, 5- oder 10-fache höher sein.
Die zweite Falle: Wenn wir wirklich große und komplexe Systeme erstellen, träumen wir davon, was wir letztendlich erreichen wollen. Voilà: Wir wollen ein superzuverlässiges System, das überhaupt keine Ausfallzeiten hat, in einer halben Sekunde (oder besser noch sofort) umschaltet, und beginnen, unsere Träume in die Realität umzusetzen. Aber auch hier gibt es einen Unterschied: Je geringer die gewünschte Umschaltzeit, desto komplizierter wird die Systemlogik. Je komplizierter wir diese Logik gestalten, desto häufiger wird das System ausfallen. Und man kann in eine sehr unangenehme Situation geraten: Wir versuchen mit aller Kraft, die Ausfallzeit zu verringern, aber in Wirklichkeit komplizieren wir alles und wenn etwas schiefgeht, wird die Ausfallzeit am Ende länger sein. Oft denkt man sich: Hätte ich doch besser nicht reserviert. Es wäre besser gewesen, wenn es nur eins gegeben hätte, das mit einer klaren Ausfallzeit arbeitet.
Wie kann man dem begegnen? Man muss aufhören, sich selbst zu belügen, aufhören, sich einzureden, dass wir hier jetzt ein Raumschiff bauen werden, und realistisch verstehen, wie lange das Projekt dauern kann. Und nach dieser maximalen Zeit werden wir entscheiden, mit welchen Methoden wir die Zuverlässigkeit unseres Systems erhöhen werden.
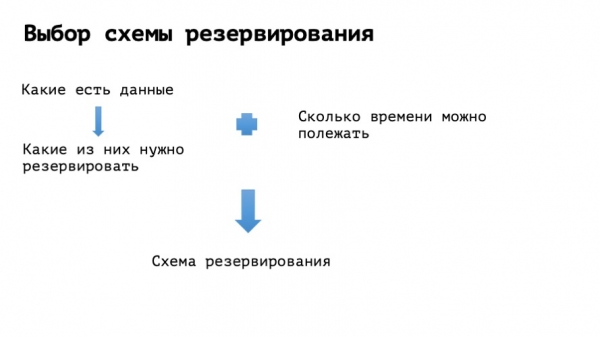
Es ist Zeit für "Geschichten aus dem Leben"… aus dem echten Leben, natürlich.
Beispiel Nummer eins
Stellen Sie sich die Website einer Rohrleitungsfabrik Nr. 1 in der Stadt N vor. In großen Buchstaben steht dort – ROHRLEITUNGSFABRIK Nr. 1. Etwas weiter unten steht der Slogan: „Unsere Rohre sind die rundesten Rohre in N“. Und ganz unten die Telefonnummer des Geschäftsführers und sein Name. Wir verstehen, dass wir reservieren müssen – das ist eine sehr wichtige Angelegenheit! Wir beginnen zu untersuchen, woraus das besteht. HTML-Statik – das heißt, ein paar Bilder, auf denen der Geschäftsführer, wie es scheint, am Tisch in der Sauna mit seinem Partner über einen weiteren Deal diskutiert. Wir beginnen über die Leerzeit nachzudenken. Uns kommt in den Sinn: Man muss da fünf Minuten liegen, nicht mehr. Und dann die Frage: Wie viele Verkäufe gab es von dieser Website überhaupt? Wie viele? Was bedeutet „null“? Es bedeutet: Denn alle vier Geschäfte des letzten Jahres hat der Geschäftsführer am selben Tisch mit denselben Personen gemacht, mit denen sie in die Sauna gehen. Und wir verstehen, dass es nichts Schlimmes sein wird, wenn die Website einen Tag lang liegt.
Aus den Eingaben ergibt sich, dass es einen Tag für die Einführung dieser Geschichte gibt. Wir beginnen, über das Reservierungsschema nachzudenken. Und wählen das idealste Schema für die Reservierung in diesem Beispiel: Wir verwenden keine Reservierung. Das ganze Ding kann von jedem Administrator in einer halben Stunde mit Pausen hochgefahren werden. Einen Webserver aufsetzen, die Dateien hochladen – das war's. Es funktioniert. Man muss nichts überwachen, nichts besonders beachten. Das heißt, die Schlussfolgerung aus Beispiel eins ist ziemlich offensichtlich: Dienste, die nicht reserviert werden müssen – müssen nicht reserviert werden.
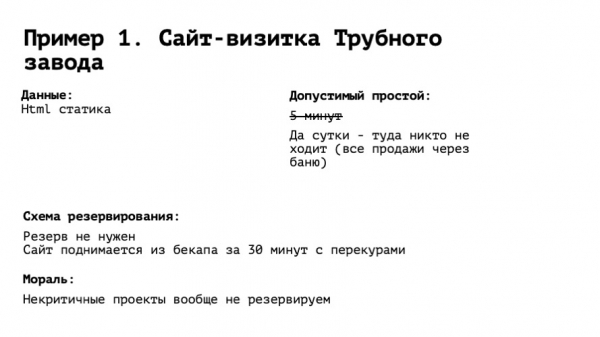
Beispiel Nummer zwei
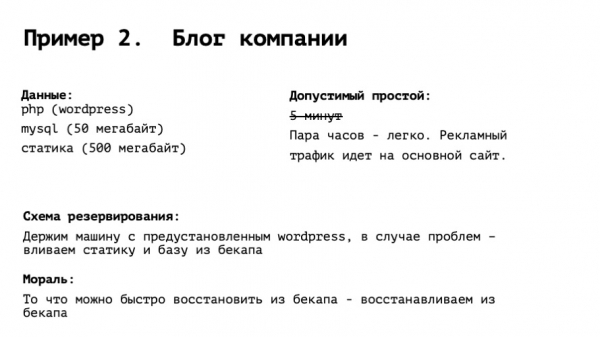
Unternehmensblog: speziell geschulte Personen schreiben dort Nachrichten, hier haben wir an dieser Ausstellung teilgenommen, und hier haben wir ein weiteres neues Produkt herausgebracht und so weiter. Angenommen, es handelt sich um standardmäßiges PHP mit WordPress, eine kleine Datenbank und ein bisschen Statische. Natürlich kommt einem wieder der Gedanke, dass man auf keinen Fall inaktiv bleiben darf – „nicht länger als fünf Minuten!“, all das. Aber lassen Sie uns weiterdenken. Was macht dieser Blog? Er erhält Besucher von Yandex, von Google aufgrund bestimmter Anfragen, organisch. Toll. Und wie stehen die Verkäufe in Zusammenhang damit? Erkenntnis: nicht wirklich. Der Werbe-Traffic fließt auf die Hauptseite, die auf einem anderen Server läuft. Wir fangen an, über ein Schema zur Sicherung des Blogs nachzudenken. Im Idealfall sollte es in ein paar Stunden hochgefahren werden, und es wäre gut, sich darauf vorzubereiten. Es wäre sinnvoll, in einem anderen Rechenzentrum einen Server zu mieten und dort eine Umgebung zu installieren, also Webserver, PHP, WordPress, MySQL, und das Ganze im Leerlauf zu belassen. In dem Moment, in dem wir feststellen, dass alles kaputt ist, müssen wir zwei Dinge tun – ein MySQL-Dump von 50 MB einspielen, das geht in einer Minute, und eine bestimmte Anzahl an Bildern aus dem Backup dort einspielen. Das ist auch nicht viel. So kann in einer halben Stunde alles wieder hochgefahren werden. Keine Replikationen oder, Gott bewahre, automatisches Failover. Fazit: Das, was wir schnell aus dem Backup wiederherstellen können, muss nicht gesichert werden.
Beispiel Nummer drei, etwas komplizierter.
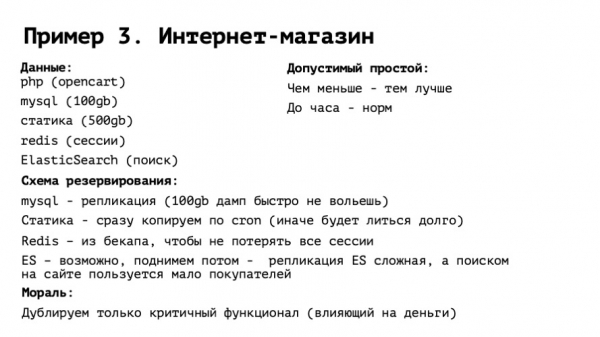
Onlineshop. PHP mit Open Heart, etwas angepasst, MySQL mit einer soliden Datenbasis. Ziemlich viel Statische (denn in einem Onlineshop gibt es schöne HD-Bilder und all das), Redis für die Sitzung und Elasticsearch für die Suche. Wir beginnen, über Ausfallzeiten nachzudenken. Und hier ist es natürlich offensichtlich, dass ein Tag, an dem der Onlineshop keine Einnahmen hat, nicht unproblematisch sein kann. Je länger er liegt, desto mehr Geld verlieren wir. Es wird Zeit, sich zu beeilen. Aber wie viel? Ich denke, wenn wir eine Stunde aussetzen, wird niemand verrückt spielen. Ja, wir werden etwas verlieren, aber wir fangen an, intensiv zu arbeiten – das wird nur schlimmer. Wir definieren das auszuhaltende Maß an Ausfallzeit pro Stunde.
Wie kann man das alles reservieren? Ein Auto wird in jedem Fall benötigt: eine Stunde Zeit ist ziemlich wenig. Mysql: hier ist bereits eine Replikation notwendig, eine echte Replikation, denn in einer Stunde wird wahrscheinlich kein Dump von 100 GB in die Datenbank geladen. Statische Inhalte, Bilder: auch hier könnten in einer Stunde möglicherweise keine 500 GB übertragen werden. Daher ist es besser, die Bilder sofort zu kopieren. Redis: hier wird es interessanter. In Redis liegen die Sessions — wir können sie einfach nicht ablegen. Denn das wäre nicht gut: alle Benutzer würden ausgeloggt werden, die Warenkörbe wären leer usw. Die Leute müssten ihren Benutzernamen und ihr Passwort erneut eingeben, und viele könnten abspringen und den Kauf nicht abschließen. Wiederum würde die Conversion sinken. Auf der anderen Seite ist Redis direkt aktuell, mit den zuletzt angemeldeten Benutzern, wahrscheinlich auch nicht notwendig. Ein guter Kompromiss wäre, Redis zu übernehmen und ihn aus einem Backup wiederherzustellen, von gestern oder, falls es jede Stunde gemacht wird, von vor einer Stunde. Glücklicherweise besteht die Wiederherstellung aus einem einzigen Datei. Und die interessanteste Geschichte ist Elasticsearch. Wer hat jemals die MySQL-Replikation hochgefahren? Wer hat jemals die Elasticsearch-Replikation hochgefahren? Und bei wem hat sie danach normal funktioniert? Ich meine damit: wir sehen in unserem System eine Art Entität. Sie scheint nützlich zu sein — aber sie ist komplex.
Schwierig in dem Sinne, dass unsere Ingenieure keine Erfahrung damit haben. Entweder gibt es negative Erfahrungen oder wir verstehen, dass dies eine ziemlich neue Technologie mit Nuancen oder Unzulänglichkeiten ist. Wir denken... Mist, Elasticsearch ist auch groß, es dauert lange, es aus einem Backup wiederherzustellen, was sollen wir tun? Wir verstehen, dass Elasticsearch in unserem Fall für die Suche verwendet wird. Und wie verkauft unser Online-Shop? Wir gehen zu den Marketing-Leuten und fragen, woher die Leute kommen. Sie antworten: "90 % kommen direkt von Yandex-Markt auf die Produktseite." Und entweder kaufen sie oder nicht. Folglich benötigt nur 10 % der Nutzer die Suche. Und die Replikation von Elasticsearch aufrechtzuerhalten, besonders zwischen verschiedenen Rechenzentren in verschiedenen Zonen, hat wirklich viele Nuancen. Was ist die Lösung? Wir nehmen Elasticsearch auf einer reservierten Fläche und tun nichts damit. Wenn sich die Sache hinzieht, werden wir ihn irgendwann später vielleicht wieder hochfahren, aber das ist nicht sicher. Letztendlich ist das Fazit mehr oder weniger dasselbe: Dienste, die keine finanziellen Auswirkungen haben, reservieren wir, wie gesagt, nicht. Damit das Schema einfacher bleibt.
Beispiel Nummer vier, noch schwieriger.
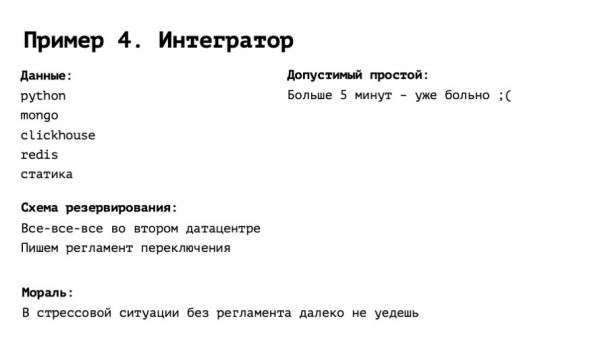
Integrator: Verkauf von Blumen, Taxiruf, Warenverkauf, kurz gesagt, alles Mögliche. Eine ernsthafte Sache, die rund um die Uhr für eine große Anzahl von Nutzern arbeitet. Mit einem vollständigen und interessanten Stack, wo interessante Datenbanken, Lösungen, hohe Lasten vorhanden sind, und das wichtigste, länger als 5 Minuten auszufallen, tut wirklich weh. Nicht nur, weil die Leute nicht kaufen, sondern weil die Leute sehen, dass dieses Ding nicht funktioniert, enttäuscht sind und beim nächsten Mal vielleicht überhaupt nicht zurückkommen.
Okay. Fünf Minuten. Was machen wir damit? In diesem Fall bauen wir ernsthaft, mit vollem Budget, eine echte Backup-Plattform auf, mit Replikationen von allem und jedem, und möglicherweise automatisieren wir auch das Umschalten auf diese Plattform so weit wie möglich. Und zusätzlich dazu sollte man nicht vergessen, eine wichtige Sache zu tun: nämlich ein Umschaltprotokoll zu schreiben. Das Protokoll kann, selbst wenn bei Ihnen alles automatisiert ist, sehr einfach sein. Aus der Reihe „Dieses Ansible-Szenario starten“, „In Route 53 diese Option aktivieren“ und so weiter – es sollte aber eine genaue Liste von Schritten sein.
Und irgendwie ist alles klar. Die Replikation umzuschalten ist eine triviale Aufgabe, oder sie schaltet sich von selbst um. Den Domainnamen im DNS umzuschreiben gehört ebenfalls dazu. Das Problem ist, dass bei einem derartigen Projektversagen Panik ausbricht, und selbst die stärksten, erfahrensten Administratoren können davon betroffen sein. Ohne eine klare Anleitung „Öffnen Sie das Terminal, gehen Sie hierhin, die Adresse unseres Servers bleibt die gleiche“ ist es schwierig, die 5 Minuten, die für die Wiederherstellung vorgesehen sind, einzuhalten. Und dazu kommt, dass es einfach ist, einige Änderungen in der Infrastruktur zu fixieren, während wir diese Vorschrift verwenden, beispielsweise — und die Vorschrift entsprechend zu ändern.
Na ja, und wenn das Reservierungssystem sehr komplex ist und wir an einem bestimmten Punkt einen Fehler gemacht haben, können wir auch unser Backup-System außer Gefecht setzen und darüber hinaus die Daten auf beiden Plattformen verderben – das wäre wirklich traurig.
Beispiel Nummer fünf, völliger Hardcore.
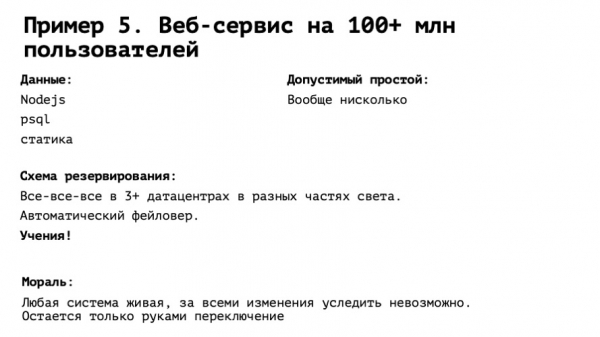
Ein internationaler Service mit Hunderten Millionen Nutzern weltweit. Alle Zeitzonen, die es gibt, Highload auf maximalem Niveau, darf absolut nicht ausfallen. Eine Minute – und es wird traurig. Was tun? Wieder vollständig reservieren. Wir haben alles getan, was im vorherigen Beispiel erwähnt wurde, und noch ein bisschen mehr. Eine ideale Welt, und unsere Infrastruktur – sie ist in jeder Hinsicht DevOps IaaC. Das heißt, alles ist in git, und man muss nur einen Knopf drücken.
Was fehlt? Einzig unser Training. Ohne das geht es nicht. Es scheint, als wäre bei uns alles perfekt, wir haben wirklich alles unter Kontrolle. Wir drücken den Knopf, alles passiert. Selbst wenn es so ist – und wir wissen, dass es so nicht sein kann – interagiert unser System mit anderen Systemen. Zum Beispiel mit DNS von Route 53, S3-Speichersystemen oder der Integration mit bestimmten APIs. Alles in diesem gedanklichen Experiment vorherzusehen, ist uns nicht möglich. Und solange wir nicht wirklich den Hebel umlegen – werden wir nicht wissen, ob es funktioniert oder nicht.
Das wäre wohl alles. Seien Sie fleißig und übertreiben Sie es nicht. Möge der Uptime mit Ihnen sein!
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish