

Am 26. Februar veranstalteten wir das Meetup Apache Ignite GreenSource, bei dem Mitwirkende des Open-Source-Projekts sprachen. . Ein wichtiges Ereignis im Leben dieser Gemeinschaft war die Neugestaltung des Components , das es ermöglicht, benutzerdefinierte Mikrodienste direkt im Ignite-Cluster bereitzustellen. Über diesen anspruchsvollen Prozess sprach beim Meetup , Software-Ingenieur und bereits seit über zwei Jahren Mitwirkender bei Apache Ignite.
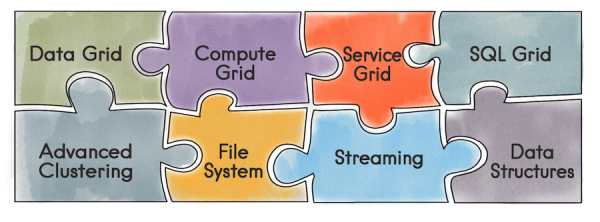
Beginnen wir damit, was Apache Ignite eigentlich ist. Es ist eine Datenbank, die ein verteiltes Key/Value-Speichersystem mit Unterstützung für SQL, Transaktionsfähigkeit und Caching bietet. Darüber hinaus ermöglicht Ignite die Bereitstellung benutzerdefinierter Dienste direkt im Ignite-Cluster. Entwicklern stehen alle Werkzeuge zur Verfügung, die Ignite bereitstellt — verteilte Datenstrukturen, Messaging, Streaming, Compute und Data Grid. Zum Beispiel entfällt bei der Verwendung des Data Grid das Problem mit der Verwaltung einer separaten Infrastruktur für das Datenspeicher, was wiederum die daraus resultierenden Kosten senkt.
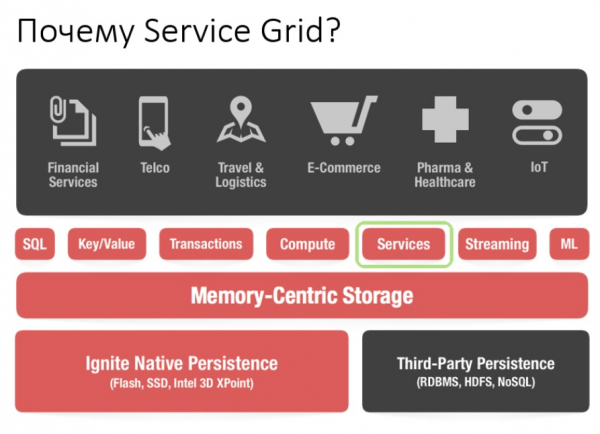
Mit der API von Service Grid kann ein Dienst bereitgestellt werden, indem einfach das Bereitstellungsschema in der Konfiguration angegeben und entsprechend der Dienst selbst definiert wird.
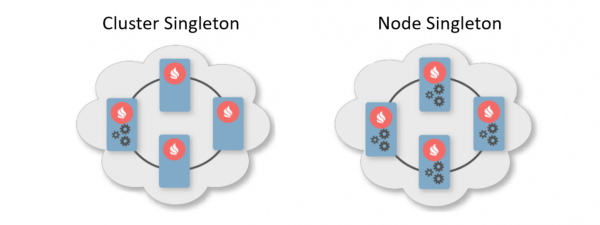
Das Bereitstellungsschema gibt normalerweise die Anzahl der Instanzen an, die auf den Knoten des Clusters bereitgestellt werden sollen. Es gibt zwei typische Bereitstellungsschemata. Das erste ist Cluster Singleton: zu jedem Zeitpunkt wird im Cluster garantiert ein Exemplar des benutzerdefinierten Dienstes verfügbar sein. Das zweite ist Node Singleton: auf jedem Knoten des Clusters wird eine Instanz des Dienstes bereitgestellt.
Außerdem kann der Benutzer die Anzahl der Instanzen des Dienstes im gesamten Cluster angeben und ein Prädikat zur Filterung geeigneter Knoten definieren. In diesem Szenario berechnet das Service Grid selbst die optimale Verteilung für die Bereitstellung der Dienste.
Darüber hinaus gibt es eine Funktion wie den Affinity Service. Affinity ist eine Funktion, die die Beziehung zwischen Schlüsseln und Partitionen sowie die Beziehung zwischen Partitionen und Knoten in der Topologie definiert. Anhand des Schlüssels kann der primäre Knoten bestimmt werden, auf dem die Daten gespeichert sind. So kann Ihr eigener Service mit dem Schlüssel und dem Cache der Affinity-Funktion assoziiert werden. Im Falle einer Änderung der Affinity-Funktion wird ein automatischer Redeployment durchgeführt. Dadurch wird der Service immer in der Nähe der Daten platziert, mit denen er arbeiten soll, und reduziert somit die Betriebskosten für den Zugriff auf Informationen. Ein solches Schema kann als eine Art kollokierte Berechnung bezeichnet werden.
Jetzt, da wir die Vorteile des Service Grids behandelt haben, erzählen wir von seiner Entwicklungsgeschichte.
Was war früher
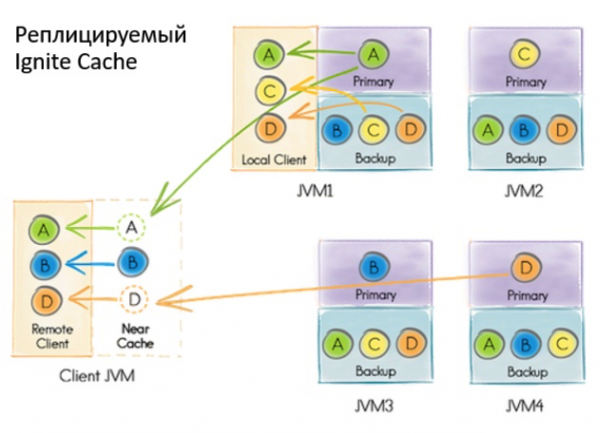
Die vorherige Umsetzung des Service Grids basierte auf einem transaktionalen, replizierten System-Cache Ignite. Unter dem Begriff "Cache" versteht man in Ignite ein Speicher. Das heißt, es handelt sich nicht um etwas Zeitweiliges, wie man vielleicht denken könnte. Obwohl der Cache replizierbar ist und jeder Knoten die gesamte Datensammlung enthält, hat der Cache intern eine partitionierte Darstellung. Dies hängt mit der Optimierung der Speicher zusammen.
Was geschah, wenn ein Benutzer einen Service implementieren wollte?
- Alle Knoten im Cluster abonnierten die Datenaktualisierung im Speicher über den integrierten Mechanismus Continuous Query.
- Der Initiator-Knoten führte unter einer Read-Committed-Transaktion einen Datensatz in die Datenbank ein, der die Konfiguration des Services, einschließlich einer serialisierten Instanz, enthielt.
- Bei Erhalt der Benachrichtigung über den neuen Datensatz berechnete der Koordinator die Verteilung basierend auf der Konfiguration. Das erhaltene Objekt wurde zurück in die Datenbank geschrieben.
- Wenn der Knoten in die Verteilung fiel, musste der Koordinator ihn implementieren.
Was uns nicht gefiel
Irgendwann kamen wir zu dem Schluss: So kann man nicht mit Services arbeiten. Es gab mehrere Gründe dafür.
Wenn während des Deployments ein Fehler auftrat, konnte man nur aus den Protokollen des Knotens, an dem alles passierte, davon erfahren. Es gab nur ein asynchrones Deployment, sodass nach der Rückgabe der Kontrolle an den Benutzer vom Deployment-Methoden einige zusätzliche Zeit für den Start des Services erforderlich war – in dieser Zeit konnte der Benutzer nichts steuern. Um das Service Grid weiterzuentwickeln, neue Funktionen zu implementieren, neue Benutzer zu gewinnen und allen das Leben zu erleichtern, musste etwas geändert werden.
Bei der Planung des neuen Service Grids wollten wir in erster Linie die Garantie für einen synchronen Deployment-Prozess bieten: Sobald der Benutzer von der API die Kontrolle zurückerhält, kann er sofort die Dienste nutzen. Außerdem wollten wir dem Initiator die Möglichkeit geben, Fehler beim Deployment zu behandeln.
Darüber hinaus wollten wir die Implementierung erleichtern, indem wir auf Transaktionen und Rebalancierung verzichten. Trotz der Tatsache, dass der Cache repliziert und keine Balancierung vorhanden ist, traten während eines großen Deployments mit vielen Knoten Probleme auf. Bei Änderungen der Topologie müssen die Knoten Informationen austauschen, und bei einem großen Deployment können diese Daten sehr viel wiegen.
Wenn die Topologie instabil war, musste der Koordinator die Verteilung der Dienste neu berechnen. Im Allgemeinen können beim Arbeiten mit Transaktionen in einer instabilen Topologie schwer vorhersehbare Fehler auftreten.
Probleme
Welche globalen Veränderungen kommen schon ohne begleitende Probleme? Die erste davon war die Veränderung der Topologie. Man muss verstehen, dass jederzeit, auch während eines Service-Deployments, ein Knoten dem Cluster beitreten oder ihn verlassen kann. Darüber hinaus, wenn ein Knoten während des Deployments dem Cluster beitritt, muss alle Informationen über die Dienste konsistent an den neuen Knoten übertragen werden. Dabei geht es nicht nur um das, was bereits bereitgestellt wurde, sondern auch um aktuelle und zukünftige Deployments.
Das ist nur eines der Probleme, die man in eine eigene Liste aufnehmen kann:
- Wie kann man statisch konfigurierte Dienste beim Start eines Knotens bereitstellen?
- Was tun, wenn ein Knoten den Cluster verlässt – was ist, wenn der Knoten Dienste gehostet hat?
- Was tun, wenn der Koordinator gewechselt wurde?
- Was tun, wenn sich der Client erneut mit dem Cluster verbindet?
- Müssen Aktivierungs-/Deaktivierungsanfragen verarbeitet werden und wie?
- Und was, wenn der Cache zerstört wird und wir abhängige Affinitätsdienste haben?
Und das ist bei weitem nicht alles.
Lösung
Als Ziel haben wir den Event-Driven-Ansatz gewählt, der die Kommunikation der Prozesse über Nachrichten realisiert. In Ignite sind bereits zwei Komponenten implementiert, die es den Knoten ermöglichen, Nachrichten untereinander zu versenden – communication-spi und discovery-spi.
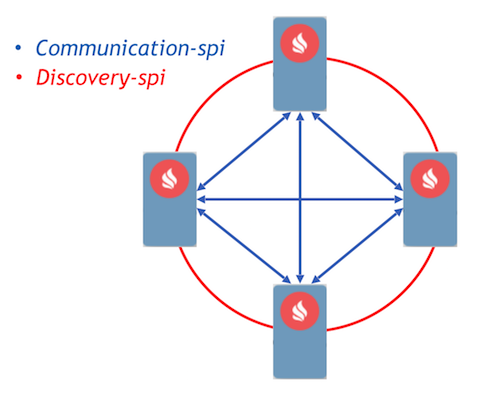
Communication-spi ermöglicht es Knoten, direkt zu kommunizieren und Nachrichten zu senden. Es eignet sich gut für die Übertragung großer Datenmengen. Discovery-spi ermöglicht das Senden einer Nachricht an alle Knoten im Cluster. In der Standardimplementierung erfolgt dies nach der Topologie „Ring“. Außerdem gibt es eine Integration mit Zookeeper, in diesem Fall wird die Topologie „Stern“ verwendet. Ein wichtiger Punkt ist, dass discovery-spi Garantien bietet, dass die Nachricht in der richtigen Reihenfolge an alle Knoten zugestellt wird.
Betrachten wir das Deployment-Protokoll. Alle Benutzeranfragen zum Deployment und Undeployment werden über discovery-spi gesendet. Dies bietet folgende Garantien:
- Die Anfrage wird von allen Knoten im Cluster empfangen. Dies ermöglicht die Fortsetzung der Bearbeitung der Anfrage beim Wechsel des Koordinators. Das bedeutet auch, dass jeder Knoten für eine Nachricht alle erforderlichen Metadaten erhält, wie z.B. die Konfiguration des Dienstes und seine serialisierte Instanz.
- Die strikte Reihenfolge der Zustellung von Nachrichten ermöglicht es, Konflikte bei Konfigurationen und konkurrierenden Anfragen zu lösen.
- Da der Eintritt des Knotens in die Topologie ebenfalls über discovery-spi verarbeitet wird, erhält der neue Knoten alle Daten, die für die Arbeit mit den Diensten erforderlich sind.
Beim Empfang einer Anfrage validieren die Knoten im Cluster diese und erstellen Aufgaben zur Bearbeitung. Diese Aufgaben werden in eine Warteschlange gelegt und dann in einem anderen Thread von einem separaten Worker bearbeitet. Dies ist so implementiert, da das Deployment erheblich Zeit in Anspruch nehmen kann und die teure Discovery-Leitung nicht verzögert werden darf.
Alle Anfragen aus der Warteschlange werden vom Deployment-Manager bearbeitet. Er hat einen speziellen Worker, der eine Aufgabe aus dieser Warteschlange entnimmt und sie initiiert, um das Deployment zu starten. Danach erfolgen die folgenden Schritte:
- Jeder Knoten berechnet eigenständig die Verteilung mithilfe einer neuen deterministischen Zuweisungsfunktion.
- Die Knoten erstellen eine Nachricht mit den Ergebnissen des Deployments und senden sie an den Koordinator.
- Der Koordinator aggregiert alle Nachrichten und erstellt das Ergebnis des gesamten Deploymentprozesses, das über discovery-spi an alle Knoten im Cluster gesendet wird.
- Beim Empfang des Ergebnisses wird der Deploymentprozess abgeschlossen, danach wird die Aufgabe aus der Warteschlange entfernt.
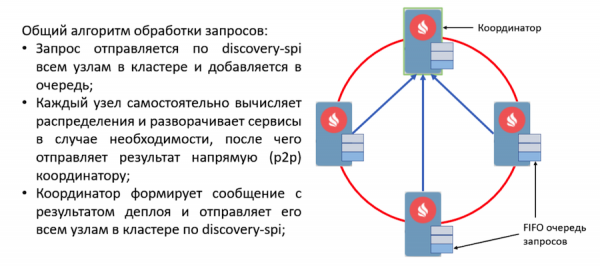
Neues eventgesteuertes Design: org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Wenn beim Bereitstellen ein Fehler auftritt, wird dieser sofort in die Nachricht aufgenommen, die an den Koordinator gesendet wird. Nach der Aggregation der Nachrichten hat der Koordinator Informationen über alle Fehler während des Deployments und sendet diese Nachricht über discovery-spi. Informationen zu den Fehlern sind auf jedem Knoten im Cluster verfügbar.
Nach diesem Arbeitsalgorithmus werden alle wichtigen Ereignisse im Service Grid verarbeitet. Beispielsweise stellt der Wechsel der Topologie ebenfalls eine Nachricht über discovery-spi dar. Insgesamt betrachtet ist das Protokoll im Vergleich zu früheren Versionen recht leichtgewichtig und zuverlässig geworden. So zuverlässig, dass es jede Situation während des Deployments bewältigen kann.
Was kommt als Nächstes
Jetzt zu den Plänen. Jede größere Änderung im Ignite-Projekt wird als Initiative zur Verbesserung von Ignite umgesetzt, der sogenannte IEP. Auch für das Redesign des Service Grids gibt es einen IEP — mit dem humorvollen Titel „Ölwechsel im Service Grid“. Tatsächlich haben wir jedoch nicht nur das Öl im Motor gewechselt, sondern den Motor vollständig.
Die Aufgaben im IEP haben wir in 2 Phasen unterteilt. Die erste - eine große Phase, die die Überarbeitung des Deployment-Protokolls umfasst. Diese ist bereits in den Master integriert, man kann das neue Service Grid ausprobieren, das in Version 2.8 erscheinen wird. Die zweite Phase umfasst viele andere Aufgaben:
- Hot Redeploy
- Versionierung der Dienste
- Erhöhung der Ausfallsicherheit
- Dünner Client
- Überwachungs- und Metriktools
Abschließend empfehlen wir Ihnen das Service Grid zum Aufbau von ausfallsicheren Hochverfügbarkeitssystemen. Außerdem laden wir Sie ein, sich uns anzuschließen bei und um Ihre Erfahrungen zu teilen. Ihre Erfahrungen sind für die Community wirklich wichtig und helfen dabei zu verstehen, in welche Richtung wir uns weiterentwickeln sollten und wie wir die Komponente in Zukunft verbessern können.
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish