

Wie in , es gab ein Problem mit dem verteilten Dienst, nennen wir diesen Dienst Elvin. Dieses Mal habe ich das Problem nicht selbst entdeckt, mir wurde von den Jungs aus dem Kundenbereich berichtet.
Eines Tages wachte ich von einem unzufriedenen Schreiben über hohe Latenzen bei Elvin auf, den wir bald starten wollten. Insbesondere hatte der Kunde eine 99. Perzentil-Latenz von etwa 50 ms, viel höher als unser Latenzbudget. Es war erstaunlich, da ich den Dienst, insbesondere bezüglich der Latenz, gründlich getestet hatte, schließlich ist das ein häufiges Beschwerdethema.
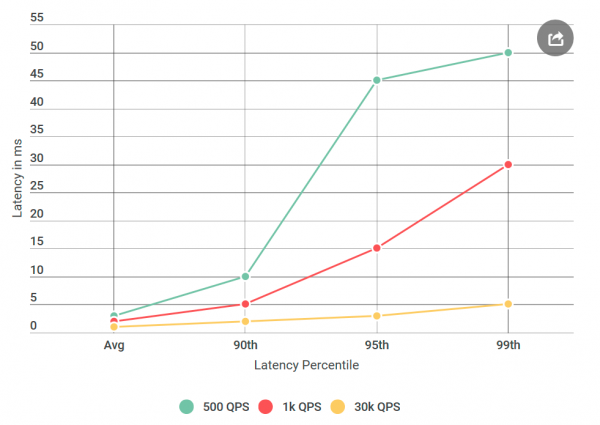
Bevor ich Elvin für Tests freigab, führte ich viele Experimente mit 40.000 Anfragen pro Sekunde (QPS) durch, alle wiesen eine Latenz von weniger als 10 ms auf. Ich war bereit zu behaupten, dass ich mit ihren Ergebnissen nicht einverstanden bin. Aber als ich das Schreiben erneut betrachtete, fiel mir etwas Neues auf: Ich hatte die Bedingungen, die sie erwähnten, definitiv nicht getestet, ihre QPS war viel niedriger als meine. Ich testete bei 40k QPS, sie jedoch nur bei 1k. Ich führte ein weiteres Experiment durch, diesmal mit niedrigerem QPS, nur um sie zu besänftigen.
Da ich darüber in einem Blog schreibe – Sie haben wahrscheinlich schon verstanden: Ihre Zahlen waren korrekt. Ich überprüfte meinen virtuellen Clienten immer wieder, mit dem gleichen Ergebnis: Eine niedrige Anzahl an Anfragen erhöht nicht nur die Latenz, sondern erhöht auch die Anzahl der Anfragen mit einer Latenz von mehr als 10 ms. Mit anderen Worten, wenn bei 40k QPS etwa 50 Anfragen pro Sekunde 50 ms überschritten, waren es bei 1k QPS jede Sekunde 100 Anfragen über 50 ms. Ein Paradoxon!
Die Suche eingrenzen
Wenn man mit einem Latenzproblem in einem verteilten System mit vielen Komponenten konfrontiert ist, sollte man zuerst eine kurze Liste von Verdächtigen erstellen. Lassen Sie uns tiefer in die Architektur von Elvin eintauchen:
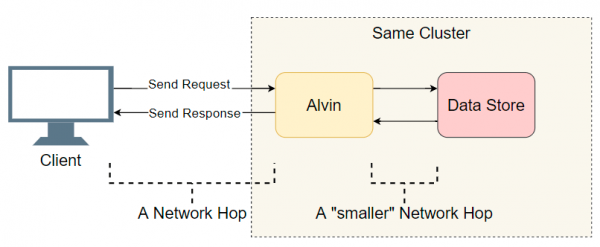
Ein guter Ausgangspunkt ist die Liste der durchgeführten Ein-/Ausgaben (Netzwerkaufrufe / Plattenzugriffe usw.). Versuchen wir herauszufinden, wo die Latenz liegt. Abgesehen von den offensichtlichen Ein-/Ausgaben mit dem Client macht Elvin einen zusätzlichen Schritt: Er fragt ein Datenspeicher ab. Da dieses Speicher jedoch im gleichen Cluster wie Elvin arbeitet, sollte die Latenz dort geringer sein als beim Client. Also die Liste der Verdächtigen:
- Netzwerkaufruf vom Client zu Elvin.
- Netzwerkanruf von Elvin an den Datenspeicher.
- Suche auf der Festplatte im Datenspeicher.
- Netzwerkanruf aus dem Datenspeicher an Elvin.
- Netzwerkanruf von Elvin an den Client.
Lass uns versuchen, einige Punkte auszuschließen.
Der Datenspeicher ist nicht das Problem.
Zuerst habe ich Elvin in einen ping-ping-Server verwandelt, der keine Anfragen bearbeitet. Bei Erhalt einer Anfrage gibt er eine leere Antwort zurück. Wenn die Verzögerung abnimmt, liegt das Problem in Elvins oder des Datenspeichers Implementierung – nichts Ungewöhnliches. Im ersten Experiment erhalten wir folgendes Diagramm:
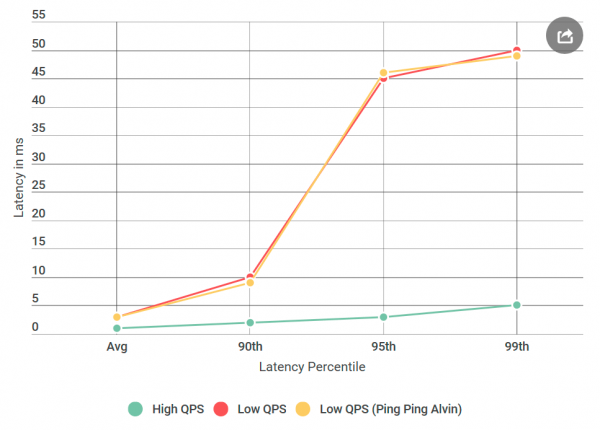
Wie wir sehen, gibt es bei Verwendung des ping-ping-Servers keine Verbesserungen. Das bedeutet, dass der Datenspeicher die Verzögerung nicht erhöht, und die Liste der Verdächtigen halbiert sich:
- Netzwerkaufruf vom Client zu Elvin.
- Netzwerkanruf von Elvin an den Client.
Super! Die Liste wird schnell kürzer. Ich dachte, ich hätte die Ursache fast herausgefunden.
, würden Sie den Port
Jetzt ist es an der Zeit, Ihnen einen neuen Akteur vorzustellen: . Das ist eine Open-Source-Bibliothek von Google für die Interprozesskommunikation . Obwohl , würden Sie den Port gut optimiert und weit verbreitet ist, habe ich es zum ersten Mal in einem System dieser Größenordnung verwendet, und ich erwartete, dass meine Implementierung, um es milde auszudrücken, suboptimal sein würde.
Vorhandensein , würden Sie den Port Im Stack entstand eine neue Frage: Vielleicht ist es meine Implementierung oder die Bibliothek selbst, die das Verzögerungsproblem verursacht? Fügen wir die neue Verdächtige zur Liste hinzu: , würden Sie den Port Der Client ruft die Bibliothek auf.
- auf dem Client führt einen Netzwerkanruf der Bibliothek aus.
, würden Sie den Port - Bibliothek
, würden Sie den PortAuf dem Server, würden Sie den Portwird Elvin angesprochen (keine Operation im Fall des ping-pong-Servers). - Bibliothek
, würden Sie den PortDamit Sie verstehen, wie der Code aussieht, unterscheidet sich meine Implementierung von Client/Elvin nicht wesentlich von client-server
Beispielen für async. .
die Verwendung eines eigenen (schablonisierten?) Thread-Modells ermöglicht, in dem sich der Ausführungsstack und die Benutzimplementierung vermischen. Um es einfach zu halten, werden wir uns an dieses Modell halten.
, würden Sie den PortProfilierung wird alles klären., würden Sie den PortNachdem ich den Datenspeicher ausgeschlossen habe, dachte ich, ich wäre fast fertig: "Jetzt ist es einfach! Wir wenden das Profil an und finden heraus, wo die Verzögerung auftritt." Ich
bin ein großer Fan präziser Profilierung,
denn die CPU ist sehr schnell und oft nicht der Engpass. Die meisten Verzögerungen treten auf, wenn der Prozessor die Verarbeitung anhalten muss, um etwas anderes zu tun. Präzise CPU-Profilierung wurde genau dafür entwickelt: Sie zeichnet alles genau auf. , da CPUs sehr schnell sind und meist nicht der Engpass. Die meisten Verzögerungen treten auf, wenn der Prozessor die Verarbeitung anhalten muss, um etwas anderes zu tun. Präzises CPU-Profiling ist genau dafür gedacht: Es zeichnet alles genau auf. und verdeutlicht, wo Verzögerungen auftreten.
Ich habe vier Profile erstellt: eines für hohe QPS (geringe Verzögerung) und eines mit einem Ping-Pong-Server bei niedriger QPS (hohe Verzögerung), sowohl auf der Client- als auch auf der Serverseite. Und nur für den Fall habe ich auch ein CPU-Profilmuster genommen. Beim Vergleich der Profile suche ich normalerweise nach einem anomalen Call-Stack. Zum Beispiel gibt es auf der schlechten Seite mit hoher Verzögerung viel mehr Kontextwechsel (zehnmal oder mehr). Aber in meinem Fall war die Anzahl der Kontextwechsel nahezu identisch. Zu meinem Entsetzen gab es dort nichts Wesentliches.
Zusätzliche Fehlersuche
Ich war verzweifelt. Ich wusste nicht, welche anderen Werkzeuge ich verwenden sollte, und mein nächster Plan bestand im Wesentlichen darin, Experimente mit verschiedenen Variationen durchzuführen, anstatt das Problem klar zu diagnostizieren.
Was wäre, wenn
Von Anfang an machte ich mir Sorgen über die spezifische Verzögerungszeit von 50 ms. Das ist eine sehr hohe Zeit. Ich beschloss, Teile aus dem Code herauszuschneiden, bis ich genau herausfinden konnte, welcher Teil diesen Fehler verursacht. Dann folgte ein Experiment, das funktionierte.
Wie immer scheint es im Nachhinein offensichtlich zu sein. Ich stellte den Client auf die gleiche Maschine wie Alvin und sendete eine Anfrage an localhost. Und die erhöhte Verzögerung verschwand!
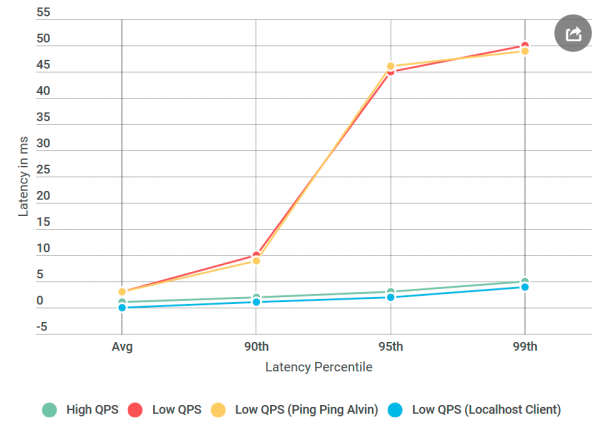
Etwas stimmte mit dem Netzwerk nicht.
Netzwerkingenieur-Fähigkeiten erlernen
Ich muss zugeben: Mein Wissen über Netzwerktechnologie ist schrecklich, besonders wenn man bedenkt, dass ich täglich damit arbeite. Aber das Netzwerk war der Hauptverdächtige, und ich musste lernen, wie man es debuggt.
Glücklicherweise schätzt das Internet diejenigen, die lernen möchten. Die Kombination aus ping und tracert schien ein guter Anfang zur Fehlersuche von Transportnetzwerkproblemen zu sein.
Zunächst startete ich auf Alvins TCP-Port. Ich verwendete die Standardeinstellungen - nichts Besonderes. Von über tausend Pings überschritt keiner 10 ms, mit Ausnahme des ersten zum Aufwärmen. Das steht im Widerspruch zu der beobachteten Verzögerung von 50 ms im 99. Perzentil: dort hätten wir für jede 100 Anfragen etwa eine Anfrage mit einer Verzögerung von 50 ms sehen müssen.
Dann versuchte ich : vielleicht liegt das Problem an einem der Knoten auf dem Weg zwischen Alvin und dem Client. Aber auch der Tracer kam mit leeren Händen zurück.
So war die Verzögerung nicht mein Code, nicht die Implementierung von gRPC und nicht das Netzwerk. Ich begann mir Sorgen zu machen, dass ich das nie verstehen würde.
Jetzt, welches Betriebssystem nutzen wir?
, würden Sie den Port wird häufig in Linux verwendet, aber für Windows ist es exotisch. Ich entschied mich, ein Experiment durchzuführen, das erfolgreich war: Ich erstellte eine virtuelle Linux-Maschine, kompilierte Alvin für Linux und setzte ihn ein.
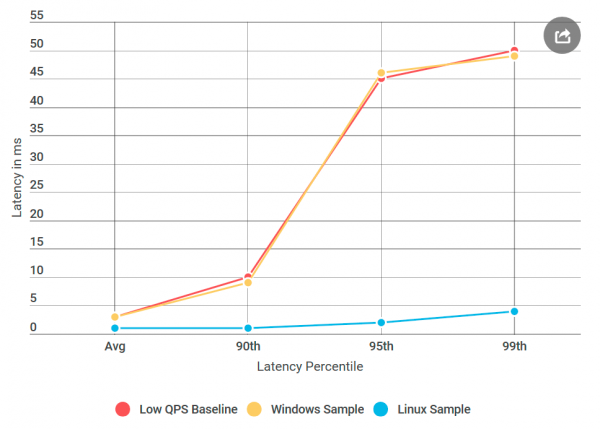
Und das ist das Ergebnis: Auf dem ping-pong Server in Linux gab es nicht die gleichen Verzögerungen wie beim entsprechenden Windows-Knoten, obwohl die Datenquelle identisch war. Es stellt sich heraus, dass das Problem in der gRPC-Implementierung für Windows lag.
Der Nagle-Algorithmus
Ich dachte die ganze Zeit, dass mir ein Flag fehlt , würden Sie den Port. Jetzt habe ich verstanden, dass es in "Windows" fehlt. , würden Sie den Port Ich fand eine interne RPC-Bibliothek, von der ich sicher war, dass sie gut für alle gesetzten Flags funktioniert. . Dann fügte ich all diese Flags in gRPC hinzu und setzte Alvin auf Windows im korrigierten ping-pong Server unter Windows ein!
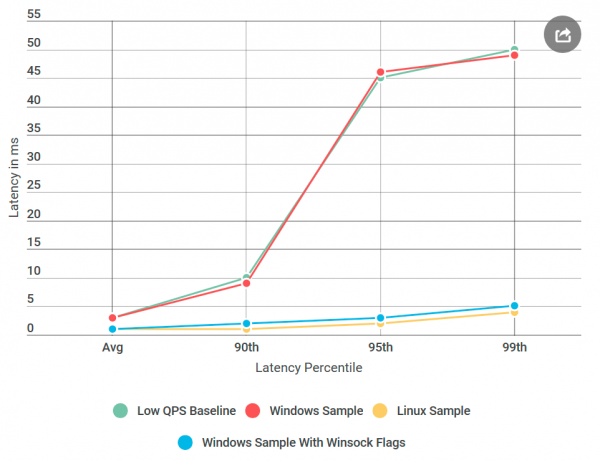
Fast fertig: Ich begann, die hinzugefügten Flags nacheinander zu löschen, bis die Regression zurückkam, sodass ich ihre Ursache genau bestimmen konnte. Es war das berüchtigte , der Schalter des Nagle-Algorithmus.
versucht, die Anzahl der über das Netzwerk gesendeten Pakete zu reduzieren, indem er die Übertragung von Nachrichten verzögert, bis die Paketgröße einen bestimmten Byte-Wert überschreitet. Während dies für den durchschnittlichen Benutzer angenehm sein kann, ist es für Echtzeitserver destruktiv, da das Betriebssystem einige Nachrichten zurückhält und Verzögerungen bei niedrigem QPS verursacht. Auf , würden Sie den Port war dieses Flag in der Linux-Implementierung für TCP-Sockets gesetzt, jedoch nicht für Windows. Das .
Fazit
Hohe Verzögerung bei niedrigem QPS wurde durch die Optimierung des Betriebssystems verursacht. Rückblickend zeigte das Profiling keine Verzögerung, da es im Kernel-Modus und nicht im durchgeführt wurde. Ich weiß nicht, ob man den Nagle-Algorithmus durch ETW-Traces beobachten kann, aber das wäre interessant.
Was das localhost-Experiment betrifft, hatte es wahrscheinlich nichts mit dem tatsächlichen Netzwerkcode zu tun, und der Nagle-Algorithmus wurde nicht aktiviert, sodass die Verzögerungsprobleme verschwanden, als der Client über localhost auf Alvin zugriff.
Das nächste Mal, wenn Sie eine Erhöhung der Verzögerung bei sinkender Anzahl von Anfragen pro Sekunde sehen, sollte der Nagle-Algorithmus auf Ihrer Verdächtigenliste stehen!
Quelle: habr.com
