

Hallo, Habra!
Lieben Sie es, mit dem Flugzeug zu fliegen? Ich liebe es, aber während der Selbstisolierung habe ich auch die Datenanalyse über Flugtickets einer bekannten Ressource – Aviasales – für mich entdeckt.
Heute werden wir die Funktionsweise von Amazon Kinesis analysieren, ein Streaming-System mit Echtzeitanalyse aufbauen, die NoSQL-Datenbank Amazon DynamoDB als Hauptdatenspeicher einrichten und Benachrichtigungen über SMS zu interessanten Tickets einstellen.
Alle Details finden Sie weiter unten! Lassen Sie uns beginnen!
Einführung
Für das Beispiel benötigen wir Zugang zu . Der Zugang ist kostenlos und ohne Einschränkungen, Sie müssen sich nur im Abschnitt "Entwickler" registrieren, um Ihren API-Token für den Zugriff auf die Daten zu erhalten.
Das Hauptziel dieses Artikels ist es, ein allgemeines Verständnis für die Nutzung von Datenstreaming in AWS zu vermitteln. Dabei blenden wir aus, dass die vom verwendeten API zurückgegebenen Daten nicht immer aktuell sind und aus einem Cache stammen, der auf den Suchanfragen von Benutzern der Websites Aviasales.ru und Jetradar.com in den letzten 48 Stunden basiert.
Die über das API erhaltenen Daten zu Flugtickets wird der Kinesis-Agent, der auf der Produktionsmaschine installiert ist, automatisch parsen und in den entsprechenden Stream über Kinesis Data Analytics einspeisen. Die unbearbeitete Version dieses Streams wird direkt im Speicher geschrieben. Das in DynamoDB erstellte 'Raw'-Datenspeicher ermöglicht eine tiefere Analyse der Tickets mithilfe von BI-Tools wie AWS Quick Sight.
Wir werden zwei Optionen für das Deployment der gesamten Infrastruktur betrachten:
- Manuell – über die AWS Management Console;
- Infrastruktur als Code mit Terraform – für die faulen Automatisierer;
Architektur des entwickelten Systems
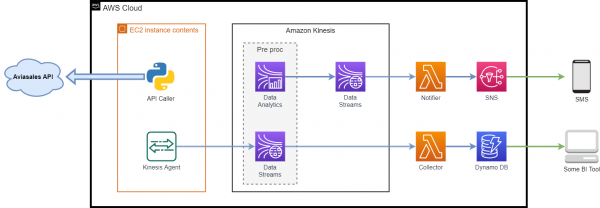
Verwendete Komponenten:
- – die von diesem API zurückgegebenen Daten werden für die gesamte weitere Arbeit verwendet;
- – eine gewöhnliche virtuelle Maschin im Cloud, auf der der Eingangsdatastream generiert wird:
- – eine Java-Anwendung, die lokal auf der Maschine installiert wird und eine einfache Möglichkeit zum Sammeln und Senden von Daten nach Kinesis (Kinesis Data Streams oder Kinesis Firehose) bietet. Der Agent überwacht kontinuierlich eine Reihe von Dateien in den angegebenen Verzeichnissen und sendet neue Daten an Kinesis;
- – ein Python-Skript, das Anfragen an das API stellt und die Antwort in einen Ordner speichert, den der Kinesis Agent überwacht;
- – ein Echtzeit-Datenstreaming-Dienst mit umfangreichen Skalierungsmöglichkeiten;
- — ein serverloser Dienst, der die Analyse von Streaming-Daten in Echtzeit vereinfacht. Amazon Kinesis Data Analytics konfiguriert Ressourcen für die Ausführung von Anwendungen und skaliert automatisch, um beliebige Mengen an eingehenden Daten zu verarbeiten;
- — ein Dienst, der das Ausführen von Code ohne Reservierung und Konfiguration von Servern ermöglicht. Alle Rechenressourcen skalieren automatisch für jeden Aufruf;
- — eine Datenbank für „Schlüssel-Wert“-Paare und Dokumente, die eine Latenz von weniger als 10 Millisekunden bei jedem Maßstab gewährleistet. Bei der Nutzung von DynamoDB müssen keine Server verteilt, keine Patches installiert oder verwaltet werden. DynamoDB skaliert Tabellen automatisch, indem es das Volumen verfügbarer Ressourcen anpasst und eine hohe Leistung aufrechterhält. Es sind keine Systemverwaltungsaktionen erforderlich;
- — ein vollständig verwalteter Nachrichtenversanddienst nach dem Modell „Publisher-Subscriber“ (Pub/Sub), mit dem Mikrodienste, verteilte Systeme und serverlose Anwendungen isoliert werden können. SNS kann verwendet werden, um Informationen an Endbenutzer über mobile Push-Benachrichtigungen, SMS und E-Mails zu versenden.
Erste Vorbereitung
Um einen Datenstrom zu emulieren, habe ich beschlossen, Informationen über Flugtickets zu verwenden, die von der API Aviasales zurückgegeben werden. In einer recht umfangreichen Liste verschiedenster Methoden werden wir eine davon nehmen – „Preiskalender für den Monat“, die die Preise für jeden Tag des Monats zurückgibt, gruppiert nach Anzahl der Umstiege. Wenn kein Monat im Suchantrag angegeben wird, werden Informationen für den Monat zurückgegeben, der auf den aktuellen folgt.
Also registrieren wir uns und erhalten unser Token.
Ein Beispielantrag ist unten:
http://api.travelpayouts.com/v2/prices/month-matrix?currency=rub&origin=LED&destination=HKT&show_to_affiliates=true&token=TOKEN_APIDie oben beschriebene Methode zur Abfrage von Daten von der API unter Angabe des Tokens im Antrag funktioniert, aber ich ziehe es vor, das Zugriffstoken über den Header zu übermitteln, deshalb verwenden wir in dem Skript api_caller.py genau diese Methode.
Beispielantwort:
{{
   "success":true,
   "data":[{
      "show_to_affiliates":true,
      "trip_class":0,
      "origin":"LED",
      "destination":"HKT",
      "depart_date":"2015-10-01",
      "return_date":"",
      "number_of_changes":1,
      "value":29127,
      "found_at":"2015-09-24T00:06:12+04:00",
      "distance":8015,
      "actual":true
   }]
}
Im obigen Beispiel der API-Antwort ist ein Ticket von St. Petersburg nach Phuket gezeigt… Ach, was träumen…
Da ich aus Kasan komme und Phuket zurzeit nur ein Traum ist, suchen wir nach Flügen von Sankt Petersburg nach Kasan.
Es wird angenommen, dass Sie bereits ein AWS-Konto haben. Ich möchte besonders darauf hinweisen, dass Kinesis und das Versenden von Benachrichtigungen über SMS nicht im Jahr enthalten sind. . Aber selbst wenn man ein paar Dollar im Kopf hat, kann man das vorgeschlagene System aufbauen und damit experimentieren. Und natürlich sollte man nicht vergessen, alle Ressourcen zu löschen, nachdem sie nicht mehr benötigt werden.
Glücklicherweise werden DynamoDb und Lambda-Funktionen für uns bedingt kostenlos sein, wenn wir innerhalb der monatlichen kostenlosen Kontingente bleiben. Zum Beispiel für DynamoDB: 25 GB Speicher, 25 WCU/RCU und 100 Millionen Anfragen. Und eine Million Aufrufe von Lambda-Funktionen pro Monat.
Manuelle Bereitstellung des Systems
Einrichtung von Kinesis Data Streams
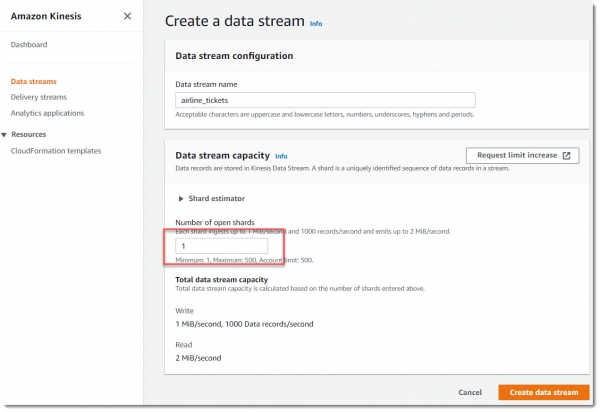
Gehen wir zum Dienst Kinesis Data Streams und erstellen zwei neue Streams mit jeweils einem Shard.
Was ist ein Shard?
Ein Shard ist die grundlegende Einheit zur Datenübertragung im Amazon Kinesis-Stream. Ein Segment ermöglicht den Eingang von Daten mit einer Rate von 1 MB/s und den Ausgang von Daten mit einer Rate von 2 MB/s. Ein Segment unterstützt bis zu 1000 PUT-Anfragen pro Sekunde. Bei der Erstellung eines Datenstreams muss die benötigte Anzahl von Segments angegeben werden. Beispielsweise kann ein Datenstream mit zwei Segmenten erstellt werden. Dieser Datenstream ermöglicht den Eingang von Daten mit einer Rate von 2 MB/s und den Ausgang von Daten mit einer Rate von 4 MB/s bei Unterstützung von bis zu 2000 PUT-Anfragen pro Sekunde.
Je mehr Shards Ihr Stream hat, desto höher ist seine Durchsatzkapazität. Im Grunde genommen skalieren Streams durch das Hinzufügen von Shards. Aber je mehr Shards Sie haben, desto höher sind auch die Kosten. Jeder Shard kostet 1,5 Cent pro Stunde und zusätzlich 1,4 Cent für jede Million PUT-Betriebsanfragen (PUT Payload Units).
Erstellen wir einen neuen Stream mit dem Namen airline_tickets, er benötigt dafür durchaus nur 1 Shard:
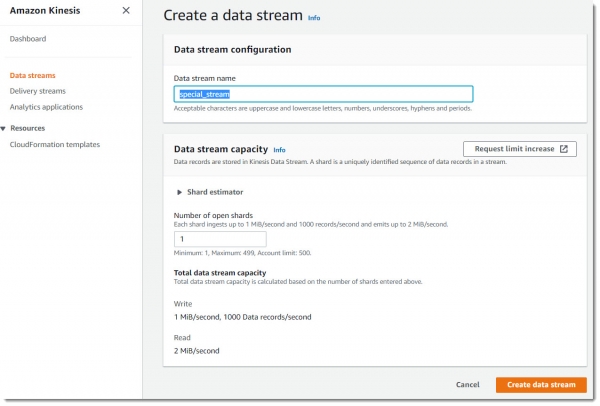
Jetzt erstellen wir einen weiteren Stream mit dem Namen special_stream:
Einrichtung des Producers
Für die Datenproduktion zur Analyse der Aufgabe reicht es aus, eine gewöhnliche EC2-Instanz zu verwenden. Es muss nicht eine leistungsstarke, teure virtuelle Maschine sein, ein t2.micro Spot-Instance reicht aus.
Wichtiger Hinweis: Für das Beispiel sollte das Image - Amazon Linux AMI 2018.03.0 verwendet werden, da es weniger Konfigurationen für den schnellen Start des Kinesis Agent benötigt.
Wir wechseln zum EC2-Dienst, erstellen eine neue virtuelle Maschine und wählen das gewünschte AMI vom Typ t2.micro, das im Free Tier enthalten ist:
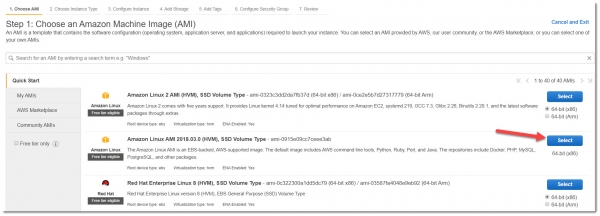
Damit die neu erstellte virtuelle Maschine mit dem Kinesis-Dienst interagieren kann, müssen ihr die entsprechenden Berechtigungen erteilt werden. Der beste Weg, dies zu tun, ist die Zuweisung einer IAM-Rolle. Daher wählen Sie auf dem Bildschirm Schritt 3: Instanzdetails konfigurieren Neue IAM-Rolle erstellen:
Erstellung einer IAM-Rolle für EC2
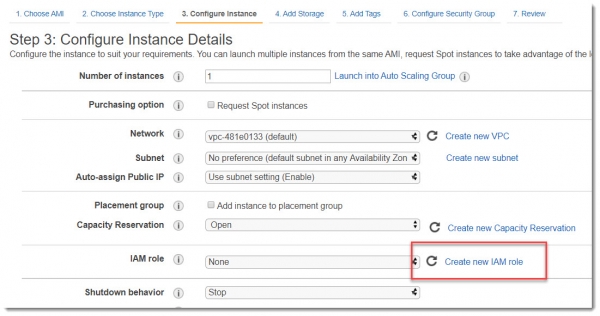
Im sich öffnenden Fenster wählen wir aus, dass die neue Rolle für EC2 erstellt wird und gehen zum Abschnitt Berechtigungen:
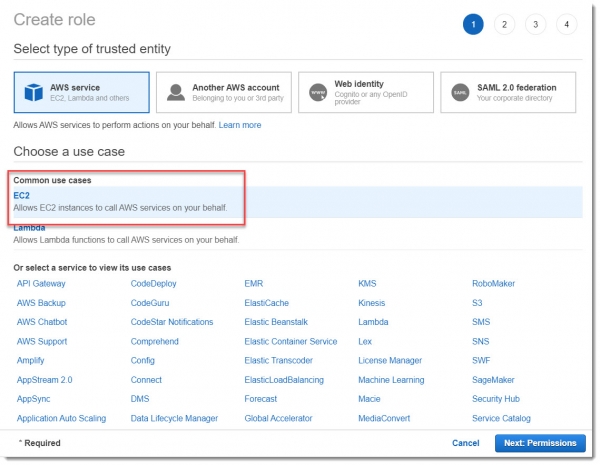
Im Lehrbeispiel müssen wir nicht auf alle Feinheiten der granularen Berechtigungseinstellungen auf Ressourcen eingehen, daher wählen wir die von Amazon vordefinierten Richtlinien: AmazonKinesisFullAccess und CloudWatchFullAccess.
Wir geben der Rolle einen sinnvollen Namen, zum Beispiel: EC2-KinesisStreams-FullAccess. Das Ergebnis sollte dasselbe sein wie auf dem Bild unten:
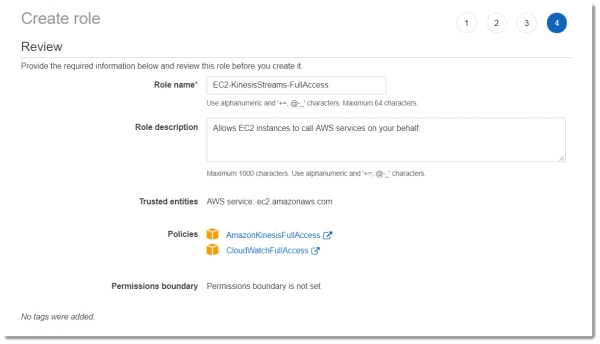
Nach der Erstellung dieser neuen Rolle vergessen Sie nicht, sie der zu erstellenden Instanz der virtuellen Maschine zuzuweisen:
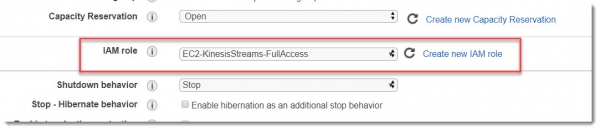
An diesem Bildschirm ändern wir sonst nichts und gehen zu den nächsten Fenstern.
Die Festplattendefinitionen können auf den Standardwerten belassen werden, die Tags ebenfalls (obwohl es eine gute Praxis ist, Tags zu verwenden, mindestens um der Instanz einen Namen zu geben und die Umgebung anzugeben).
Jetzt befinden wir uns im Bereich Schritt 6: Sicherheitsgruppe konfigurieren, wo wir eine neue Sicherheitsgruppe erstellen oder eine bestehende angeben müssen, die den Zugriff über SSH (Port 22) auf die Instanz erlaubt. Wählen Sie dort Quelle -> Meine IP und Sie können die Instanz starten.
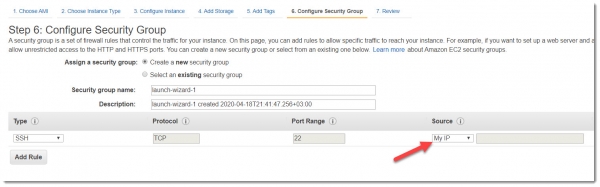
Sobald sie den Status "running" erreicht, können Sie versuchen, sich über SSH zu verbinden.
Um mit dem Kinesis-Agenten arbeiten zu können, müssen Sie nach dem erfolgreichen Verbindungsaufbau zur Maschine die folgenden Befehle im Terminal eingeben:
sudo yum -y update
sudo yum install -y python36 python36-pip
sudo /usr/bin/pip-3.6 install --upgrade pip
sudo yum install -y aws-kinesis-agent
Erstellen Sie einen Ordner zur Speicherung der API-Antworten:
sudo mkdir /var/log/airline_ticketsBevor Sie den Agenten starten, müssen Sie seine Konfiguration einrichten:
sudo vim /etc/aws-kinesis/agent.jsonDer Inhalt der Datei agent.json sollte wie folgt aussehen:
{
  "cloudwatch.emitMetrics": true,
  "kinesis.endpoint": "",
  "firehose.endpoint": "",

  "flows": [
    {
      "filePattern": "/var/log/airline_tickets/*log",
      "kinesisStream": "airline_tickets",
      "partitionKeyOption": "RANDOM",
      "dataProcessingOptions": [
         {
            "optionName": "CSVTOJSON",
            "customFieldNames": ["cost","trip_class","show_to_affiliates",
                "return_date","origin","number_of_changes","gate","found_at",
                "duration","distance","destination","depart_date","actual","record_id"]
         }
      ]
    }
  ]
}
Wie aus der Konfigurationsdatei ersichtlich ist, wird der Agent Dateien mit der Endung .log im Verzeichnis /var/log/airline_tickets/ überwachen, sie parsen und an den Datenstrom airline_tickets weiterleiten.
Wir starten den Dienst neu und stellen sicher, dass er läuft:
sudo service aws-kinesis-agent restartNun laden wir das Python-Skript herunter, das Daten von der API abfragt:
REPO_PATH=https://raw.githubusercontent.com/igorgorbenko/aviasales_kinesis/master/producer

wget $REPO_PATH/api_caller.py -P /home/ec2-user/
wget $REPO_PATH/requirements.txt -P /home/ec2-user/
sudo chmod a+x /home/ec2-user/api_caller.py
sudo /usr/local/bin/pip3 install -r /home/ec2-user/requirements.txt
Das Skript api_caller.py fragt Daten von Aviasales ab und speichert die erhaltene Antwort in dem Verzeichnis, das der Kinesis-Agent scannt. Die Implementierung dieses Skripts ist ziemlich standardmäßig, es gibt die Klasse TicketsApi, die es ermöglicht, die API asynchron abzufragen. In diese Klasse übergeben wir den Header mit dem Token und die Abfrageparameter:
class TicketsApi:
    """API-Caller-Klasse."""

    def __init__(self, headers):
        """Init-Methode."""
        self.base_url = BASE_URL
        self.headers = headers

    async def get_data(self, data):
        """Holt die Daten von der API-Abfrage."""
        response_json = {}
        async with ClientSession(headers=self.headers) as session:
            try:
                response = await session.get(self.base_url, data=data)
                response.raise_for_status()
                LOGGER.info('Antwortstatus %s: %s',
                            self.base_url, response.status)
                response_json = await response.json()
            except HTTPError as http_err:
                LOGGER.error('Ups! HTTP-Fehler aufgetreten: %s', str(http_err))
            except Exception as err:
                LOGGER.error('Ups! Ein Fehler ist aufgetreten: %s', str(err))
            return response_json


def prepare_request(api_token):
    """Gibt die Header und die Abfrage für die API-Anfrage zurück."""
    headers = {'X-Access-Token': api_token,
               'Accept-Encoding': 'gzip'}

    data = FormData()
    data.add_field('currency', CURRENCY)
    data.add_field('origin', ORIGIN)
    data.add_field('destination', DESTINATION)
    data.add_field('show_to_affiliates', SHOW_TO_AFFILIATES)
    data.add_field('trip_duration', TRIP_DURATION)
    return headers, data


async def main():
    """Lässt den Code ausführen."""
    if len(sys.argv) != 2:
        print('Verwendung: api_caller.py ')
        sys.exit(1)
        return
    api_token = sys.argv[1]
    headers, data = prepare_request(api_token)

    api = TicketsApi(headers)
    response = await api.get_data(data)
    if response.get('success', None):
        LOGGER.info('Die API hat %s Elemente zurückgegeben', len(response['data']))
        try:
            count_rows = log_maker(response)
            LOGGER.info('%s Zeilen wurden in %s gespeichert',
                        count_rows,
                        TARGET_FILE)
        except Exception as e:
            LOGGER.error('Ups! Das Ergebnis der Anfrage wurde nicht in die Datei gespeichert. %s',
                         str(e))
    else:
        LOGGER.error('Ups! Die API-Anfrage war erfolglos %s!', response)
Zum Testen der Konfiguration und der Funktionsfähigkeit des Agenten führen wir einen Testlauf des Skripts api_caller.py durch:
sudo ./api_caller.py TOKEN 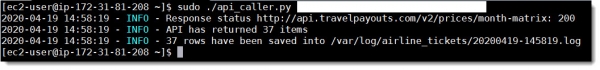
Und wir schauen uns die Ergebnisse in den Logs des Agenten und im Monitoring-Tab des Datenstroms airline_tickets an:
tail -f /var/log/aws-kinesis-agent/aws-kinesis-agent.log 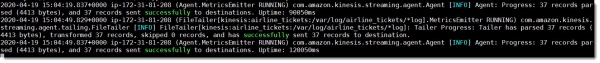
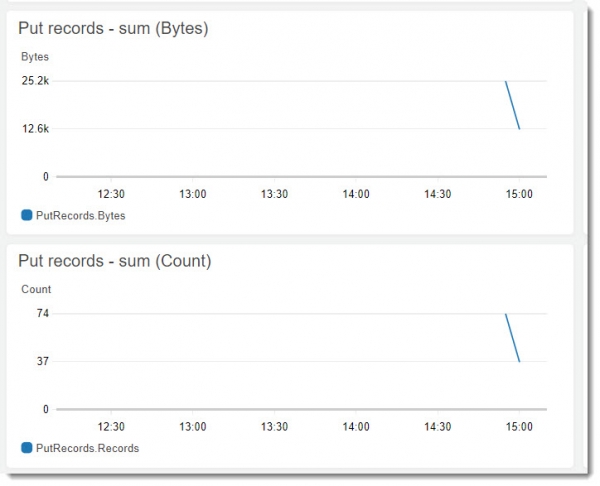
Wie Sie sehen können, funktioniert alles und der Kinesis-Agent sendet erfolgreich Daten in den Stream. Lassen Sie uns nun den Consumer einrichten.
Einrichtung von Kinesis Data Analytics
Kommen wir zur zentralen Komponente des gesamten Systems – wir erstellen eine neue Anwendung in Kinesis Data Analytics mit dem Namen kinesis_analytics_airlines_app:
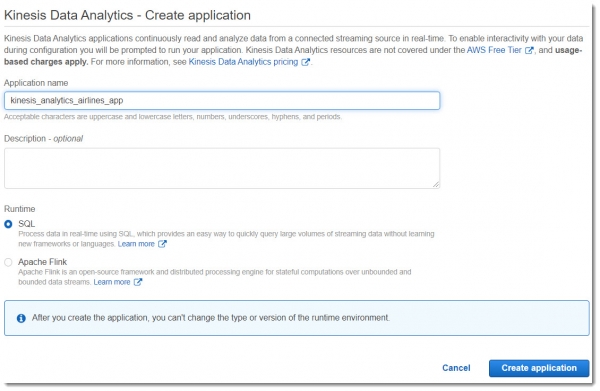
Kinesis Data Analytics ermöglicht die Echtzeitanalyse von Daten aus Kinesis Streams mit SQL. Es handelt sich um einen vollständig automatisierten Dienst (im Gegensatz zu Kinesis Streams), der:
- die Erstellung neuer Streams (Output Stream) basierend auf Abfragen der Quelldaten ermöglicht;
- einen Fehlerstream bereitstellt, der während der Ausführung der Anwendungen aufgetretene Fehler enthält (Error Stream);
- automatisch das Schema der Eingabedaten erkennt (dies kann bei Bedarf manuell überschrieben werden).
Es handelt sich um einen nicht günstigen Dienst – 0,11 USD pro Stunde. Daher sollte er vorsichtig verwendet und nach Abschluss der Arbeit entfernt werden.
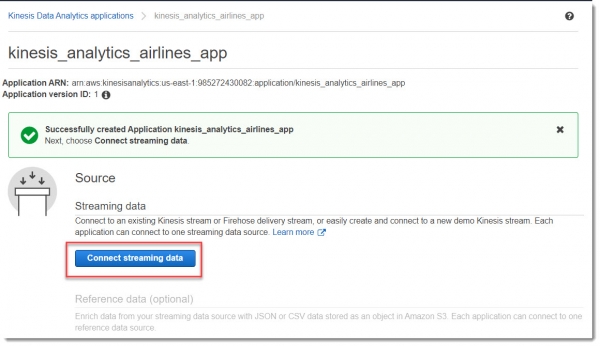
Wir verbinden die Anwendung mit der Datenquelle:
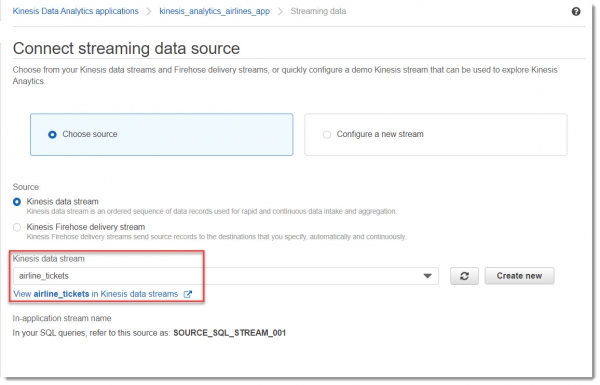
Wir wählen den Stream aus, mit dem wir uns verbinden möchten (airline_tickets):
Als nächstes müssen wir eine neue IAM-Rolle anheften, damit die Anwendung aus dem Stream lesen und in den Stream schreiben kann. Dazu muss im Block Access permissions nichts geändert werden:
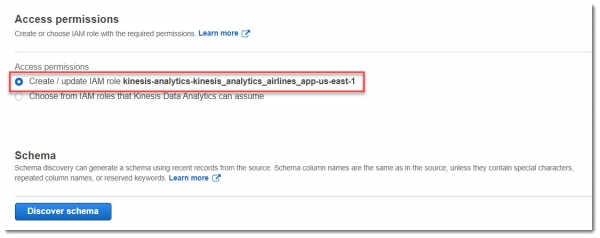
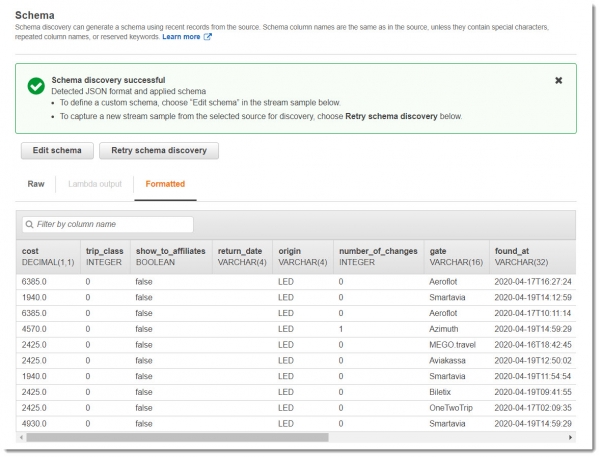
Jetzt fordern wir die Entdeckung des Datenschemas im Stream an, indem wir auf die Schaltfläche „Discover schema“ klicken. Daraufhin wird eine neue IAM-Rolle aktualisiert (erstellt) und die Schemaentdeckung für die bereits in den Stream geflossenen Daten gestartet:
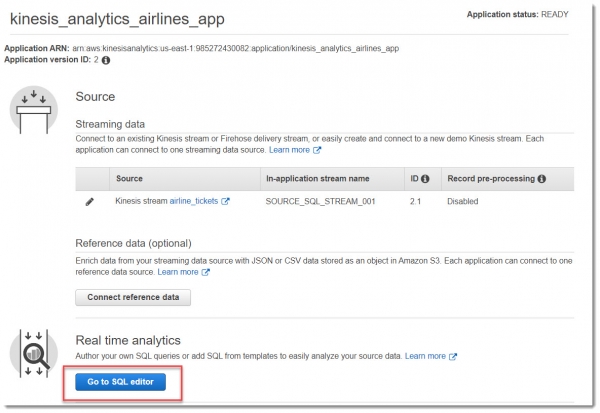
Jetzt müssen wir in den SQL-Editor wechseln. Wenn wir auf diese Schaltfläche klicken, öffnet sich ein Fenster mit der Frage, ob das Programm gestartet werden soll – wir wählen aus, was wir starten möchten:
Im SQL-Editor fügen wir die folgende einfache Abfrage ein und klicken auf Save and Run SQL:
CREATE OR REPLACE STREAM "DESTINATION_SQL_STREAM" ("cost" DOUBLE, "gate" VARCHAR(16));

CREATE OR REPLACE PUMP "STREAM_PUMP" AS INSERT INTO "DESTINATION_SQL_STREAM"
SELECT STREAM "cost", "gate"
FROM "SOURCE_SQL_STREAM_001"
WHERE "cost" < 5000
    and "gate" = 'Aeroflot';
In relationalen Datenbanken arbeiten Sie mit Tabellen, verwenden INSERT-Befehle, um Datensätze hinzuzufügen, und SELECT-Befehle, um Daten abzufragen. In Amazon Kinesis Data Analytics arbeiten Sie mit Streams (STREAM) und Pumpen (PUMP) – kontinuierlichen Einfügeabfragen, die Daten von einem Stream in der Anwendung in einen anderen Stream einfügen.
In der oben dargestellten SQL-Abfrage wird nach Tickets von Aeroflot gesucht, deren Preis unter fünftausend Rubel liegt. Alle Datensätze, die unter diese Bedingungen fallen, werden in den Stream DESTINATION_SQL_STREAM eingefügt.
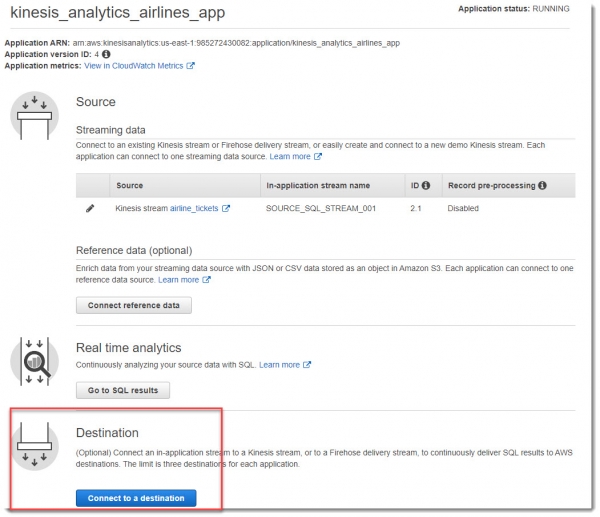
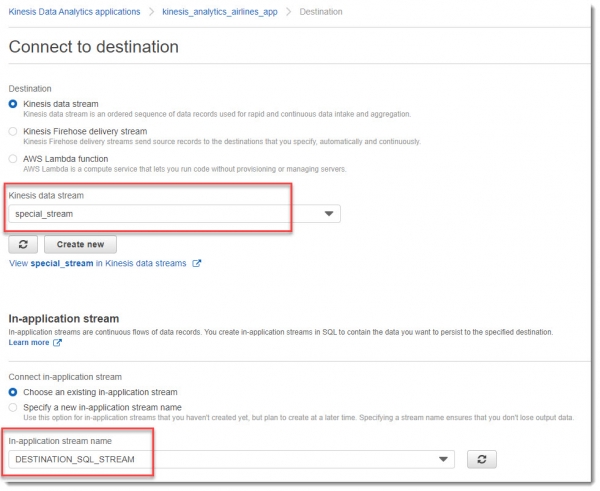
Im Abschnitt Destination wählen wir den Stream special_stream aus, und im Dropdown-Menü In-application stream name DESTINATION_SQL_STREAM:
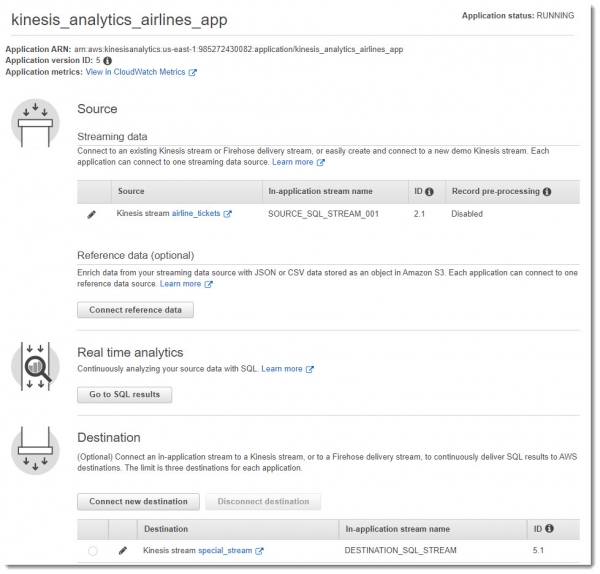
Das Ergebnis aller Manipulationen sollte ungefähr wie das Bild unten aussehen:
Erstellung und Abonnierung eines SNS-Themas
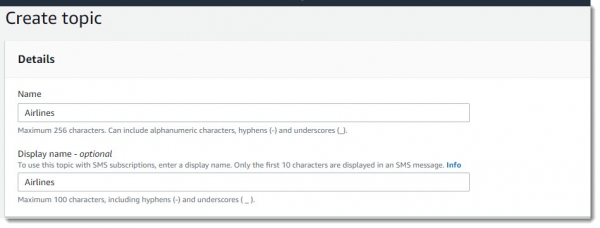
Wir wechseln zum Service Simple Notification Service und erstellen dort ein neues Thema mit dem Namen Airlines:
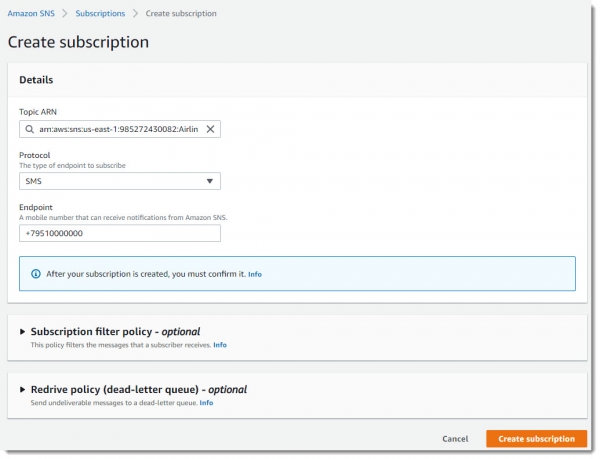
Wir richten das Abonnement für dieses Thema ein, indem wir die Handynummer angeben, an die die SMS-Benachrichtigungen gesendet werden:
Erstellung einer Tabelle in DynamoDB
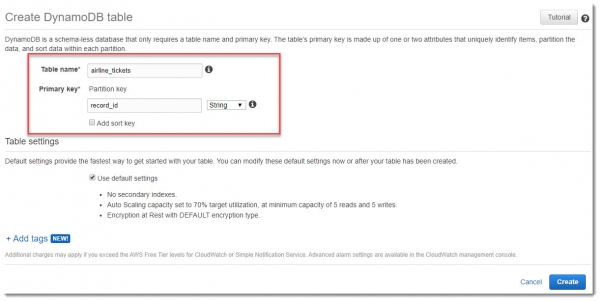
Zur Speicherung der nicht verarbeiteten Daten aus dem Stream airline_tickets erstellen wir eine Tabelle in DynamoDB mit demselben Namen. Wir verwenden record_id als Primärschlüssel:
Erstellung der Lambda-Funktion collector
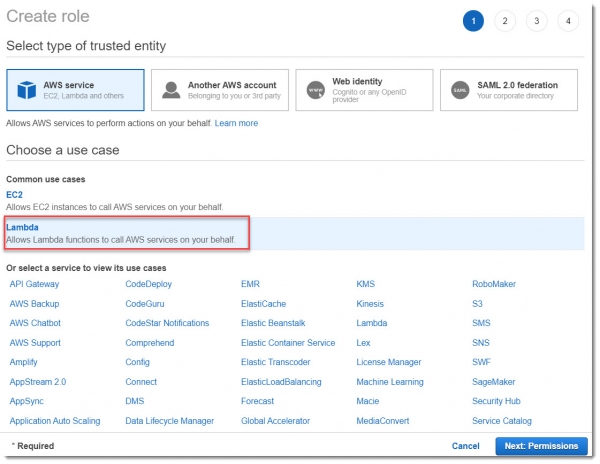
Wir erstellen die Lambda-Funktion mit dem Namen Collector, deren Aufgabe es ist, den Stream airline_tickets abzufragen und, falls neue Einträge gefunden werden, diese in die DynamoDB-Tabelle einzufügen. Offensichtlich benötigt diese Lambda neben den Standardrechten auch Lesezugriff auf den Kinesis-Datenstream und Schreibzugriff auf DynamoDB.
Erstellung der IAM-Rolle für die Lambda-Funktion collector
Zunächst erstellen wir eine neue IAM-Rolle für die Lambda mit dem Namen Lambda-TicketsProcessingRole:
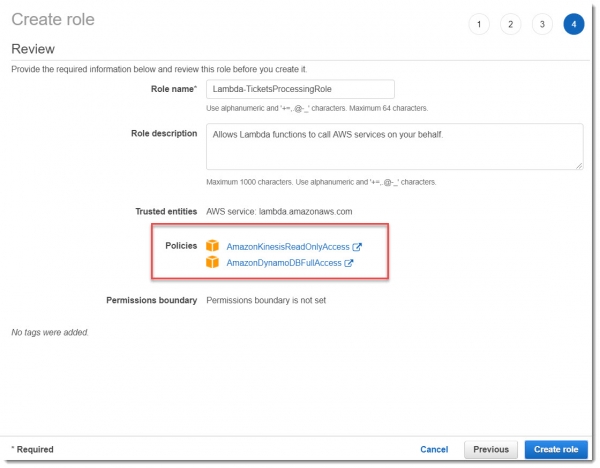
Für dieses Testbeispiel sind die vordefinierten Richtlinien AmazonKinesisReadOnlyAccess und AmazonDynamoDBFullAccess gut geeignet, wie im Bild unten gezeigt:
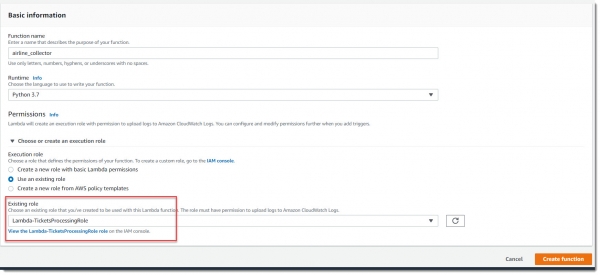
Diese Lambda sollte durch einen Trigger von Kinesis aktiviert werden, wenn neue Einträge in den Stream airline_stream gelangen, daher müssen wir einen neuen Trigger hinzufügen:
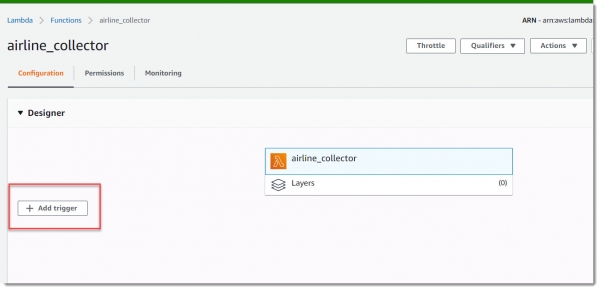
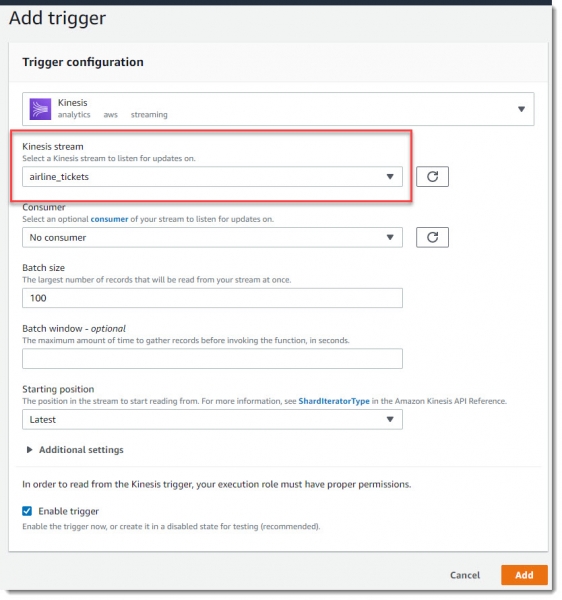
Es bleibt nur noch, den Code einzufügen und die Lambda zu speichern.
"""Daten aus dem Stream analysieren und in die DynamoDB-Tabelle einfügen."""
import base64
import json
import boto3
from decimal import Decimal

DYNAMO_DB = boto3.resource('dynamodb')
TABLE_NAME = 'airline_tickets'

class TicketsParser:
    """Informationen aus dem Stream analysieren."""

    def __init__(self, table_name, records):
        """Initialisierungsmethode."""
        self.table = DYNAMO_DB.Table(table_name)
        self.json_data = TicketsParser.get_json_data(records)

    @staticmethod
    def get_json_data(records):
        """Gibt die deserialisierten Daten aus dem Stream zurück."""
        decoded_record_data = ([base64.b64decode(record['kinesis']['data'])
                                for record in records])
        json_data = ([json.loads(decoded_record)
                      for decoded_record in decoded_record_data])
        return json_data

    @staticmethod
    def get_item_from_json(json_item):
        """Vorverarbeitung der JSON-Daten."""
        new_item = {
            'record_id': json_item.get('record_id'),
            'cost': Decimal(json_item.get('cost')),
            'trip_class': json_item.get('trip_class'),
            'show_to_affiliates': json_item.get('show_to_affiliates'),
            'origin': json_item.get('origin'),
            'number_of_changes': int(json_item.get('number_of_changes')),
            'gate': json_item.get('gate'),
            'found_at': json_item.get('found_at'),
            'duration': int(json_item.get('duration')),
            'distance': int(json_item.get('distance')),
            'destination': json_item.get('destination'),
            'depart_date': json_item.get('depart_date'),
            'actual': json_item.get('actual')
        }
        return new_item

    def run(self):
        """Batcheinfügen in die Tabelle."""
        with self.table.batch_writer() as batch_writer:
            for item in self.json_data:
                dynamodb_item = TicketsParser.get_item_from_json(item)
                batch_writer.put_item(dynamodb_item)

        print('Es wurden ', len(self.json_data), 'Artikel hinzugefügt')

def lambda_handler(event, context):
    """Stream analysieren und in die DynamoDB-Tabelle einfügen."""
    print('Ereignis erhalten:', event)
    parser = TicketsParser(TABLE_NAME, event['Records'])
    parser.run()
Erstellen der Lambda-Funktion notifier
Die zweite Lambda-Funktion, die den zweiten Stream (special_stream) überwacht und eine Benachrichtigung an SNS sendet, wird ähnlich erstellt. Daher muss diese Lambda-Funktion Lesezugriff auf Kinesis und die Berechtigung zum Senden von Nachrichten an das angegebene SNS-Thema haben, das dann vom SNS-Dienst an alle Abonnenten dieses Themas (E-Mail, SMS usw.) gesendet wird.
Erstellung einer IAM-Rolle
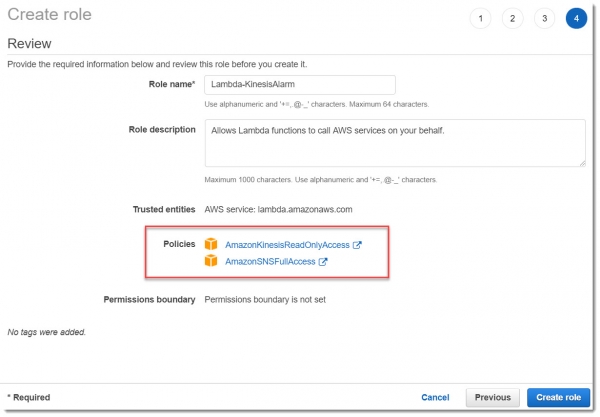
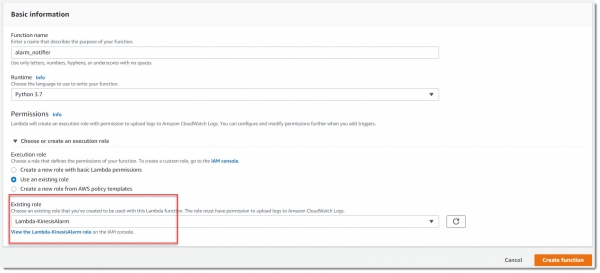
Zuerst erstellen wir die IAM-Rolle Lambda-KinesisAlarm für diese Lambda-Funktion und weisen dann diese Rolle der zu erstellenden Lambda-Funktion alarm_notifier zu:
Diese Lambda-Funktion soll durch einen Trigger auf neue Einträge im Stream special_stream arbeiten, daher ist es notwendig, den Trigger ähnlich zu konfigurieren, wie wir es für die Lambda-Funktion Collector getan haben.
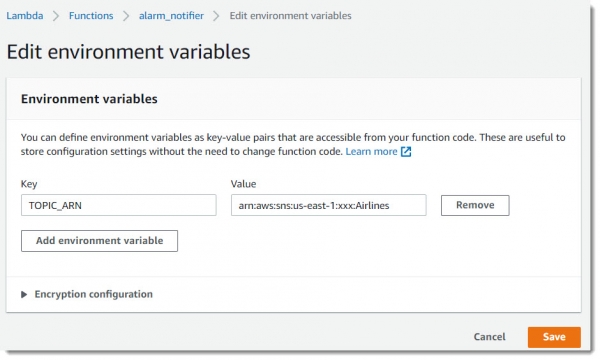
Zur Erleichterung der Konfiguration dieser Lambda-Funktion führen wir eine neue Umgebungsvariable ein — TOPIC_ARN, in die wir den ARN (Amazon Resource Name) des Themas Airlines einfügen:
Und fügen den Code der Lambda-Funktion ein, der ganz einfach ist:
import boto3
import base64
import os

SNS_CLIENT = boto3.client('sns')
TOPIC_ARN = os.environ['TOPIC_ARN']


def lambda_handler(event, context):
    try:
        SNS_CLIENT.publish(TopicArn=TOPIC_ARN,
                           Message='Hallo! Ich habe etwas Interessantes gefunden!',
                           Subject='Alarm für Flugtickets')
        print('Alarmnachricht wurde erfolgreich zugestellt')
    except Exception as err:
        print('Zustellungsfehler', str(err))
Es scheint, dass die manuelle Konfiguration des Systems hier endet. Es bleibt nur noch, zu testen und sicherzustellen, dass wir alles richtig eingerichtet haben.
Deployment aus dem Terraform-Code
Erforderliche Vorbereitung
— ein sehr praktisches Open-Source-Tool zum Bereitstellen von Infrastrukturen aus Code. Es hat seine eigene Syntax, die leicht zu erlernen ist, sowie viele Beispiele dafür, was und wie man bereitstellt. In den Editoren Atom oder Visual Studio Code gibt es viele nützliche Plugins, die die Arbeit mit Terraform erleichtern.
Den Download des Distributionspakets finden Sie . Eine detaillierte Analyse aller Möglichkeiten von Terraform sprengt den Rahmen dieses Artikels, daher beschränken wir uns auf die wichtigsten Punkte.
Wie man startet
Der vollständige Code des Projekts befindet sich . Klonen Sie das Repository. Vor dem Start sollten Sie sicherstellen, dass AWS CLI installiert und konfiguriert ist, da Terraform nach Anmeldeinformationen in der Datei ~\/ .aws\/credentials sucht.
Es ist eine gute Praxis, vor dem Deployment der gesamten Infrastruktur den Befehl plan auszuführen, um zu sehen, was Terraform jetzt in der Cloud erstellen wird:
terraform.exe planEs wird vorgeschlagen, die Telefonnummer einzugeben, um Benachrichtigungen an diese zu senden. An diesem Punkt ist die Eingabe nicht zwingend erforderlich.
Nachdem wir den Arbeitsplan des Programms analysiert haben, können wir die Erstellung von Ressourcen starten:
terraform.exe applyNach dem Senden dieses Befehls wird erneut nach der Telefonnummer gefragt, geben Sie «yes» ein, wenn die Frage nach der tatsächlichen Durchführung von Aktionen angezeigt wird. Dies ermöglicht es, die gesamte Infrastruktur in Betrieb zu nehmen, alle erforderlichen Einstellungen für EC2 vorzunehmen, Lambda-Funktionen bereitzustellen usw.
Nachdem alle Ressourcen erfolgreich über den Terraform-Code erstellt wurden, müssen wir die Einzelheiten der Kinesis Analytics-Anwendung aufrufen (leider habe ich nicht herausgefunden, wie man dies direkt aus dem Code macht).
Wir starten die Anwendung:
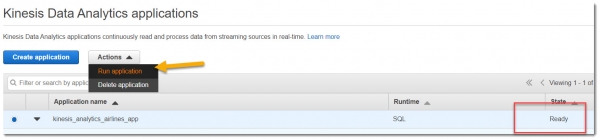
Danach müssen Sie ausdrücklich den Stream-Namen in der Anwendung angeben, indem Sie ihn aus der Dropdown-Liste auswählen:
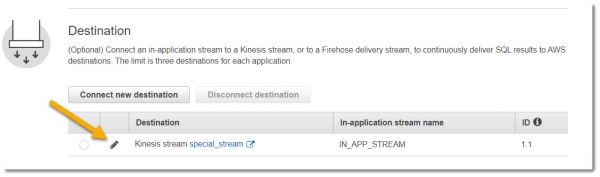
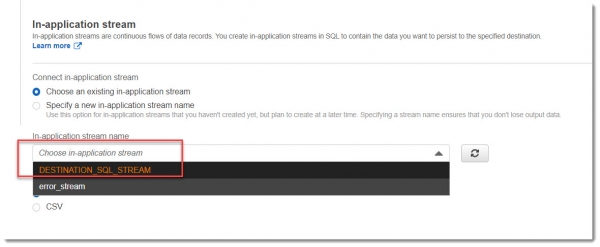
Jetzt ist alles bereit zur Arbeit.
Testen der Funktionsweise der Anwendung
Unabhängig davon, wie Sie das System bereitgestellt haben, manuell oder über den Terraform-Code, wird es gleich funktionieren.
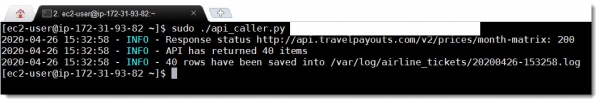
Wir verbinden uns per SSH mit der EC2-Instanz, auf der der Kinesis Agent installiert ist, und starten das Skript api_caller.py.
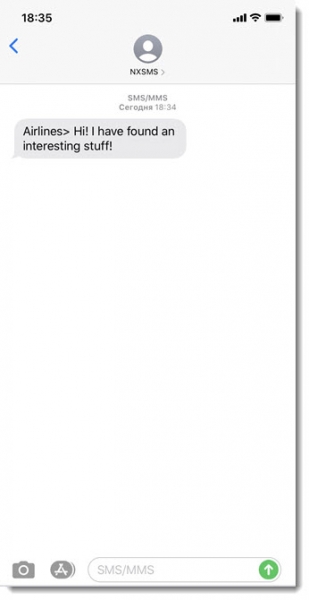
sudo ./api_caller.py TOKENEs bleibt nur noch, auf die SMS an Ihre Nummer zu warten:
Die SMS – die Nachricht kommt praktisch innerhalb von 1 Minute auf das Telefon:
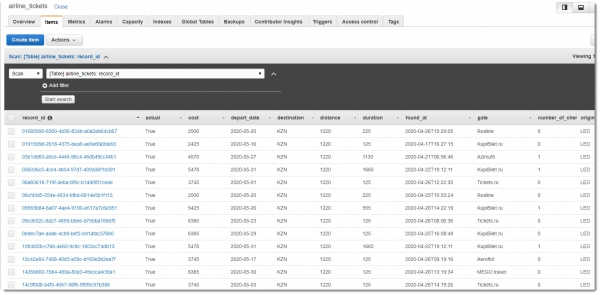
Es bleibt zu überprüfen, ob die Einträge in der DynamoDB-Datenbank für eine spätere, detailliertere Analyse erhalten geblieben sind. Die Tabelle airline_tickets enthält etwa folgende Daten:
Fazit
Im Rahmen der durchgeführten Arbeiten wurde ein Online-Datenauswertungssystem auf Basis von Amazon Kinesis aufgebaut. Es wurden Optionen zur Verwendung des Kinesis Agent in Verbindung mit Kinesis Data Streams und der Echtzeitanalyse mit Kinesis Analytics mittels SQL-Befehlen sowie die Interaktion von Amazon Kinesis mit anderen AWS-Diensten betrachtet.
Das oben beschriebene System haben wir auf zwei Arten implementiert: einer relativ langen manuellen Methode und schnell über den Terraform-Code.
Der gesamte Quellcode des Projekts ist verfügbar , ich lade Sie ein, sich damit vertraut zu machen.
Ich bin gerne bereit, den Artikel zu diskutieren und freue mich auf Ihre Kommentare. Ich hoffe auf konstruktive Kritik.
Ich wünsche Ihnen viel Erfolg!
Quelle: habr.com
