

Ich bin mir sicher, dass die Überschrift eine gesunde Reaktion ausgelöst hat – "Nun, es geht wieder los..." Aber lassen Sie mich Ihre Aufmerksamkeit für 5-10 Minuten in Anspruch nehmen, und ich werde versuchen, Ihre Erwartungen nicht zu enttäuschen.
Die Struktur des Artikels wird folgendermaßen sein: Es wird eine stereotype Behauptung genommen und die "Natur" der Entstehung dieses Stereotyps wird erläutert. Ich hoffe, dass dies ermöglicht, die Wahl der Paradigmen für den Datenaustausch in Ihren Projekten aus einer neuen Perspektive zu betrachten.
Um Klarheit darüber zu schaffen, was RPC ist, schlage ich vor, den Standard zu betrachten . Bei REST gibt es keine Klarheit. Und das sollte es auch nicht. Alles, was man über REST wissen muss – es ist nicht von .
RPC-Anfragen schneller und effizienter, weil sie Batch-Anfragen ermöglichen.
Es geht darum, dass man mit RPC in einer Anfrage mehrere Prozeduren aufrufen kann. Zum Beispiel einen Benutzer erstellen, ihm ein Avatar hinzufügen und ihn in derselben Anfrage für einige Themen anmelden. Nur eine Anfrage, aber wie viel Nutzen!
Tatsächlich wird es schneller erscheinen, wenn Sie nur einen Node im Backend haben, bei einer Batch-Anfrage. Denn drei REST-Anfragen werden dreimal mehr Ressourcen von einem Node für die Verbindungen benötigen.
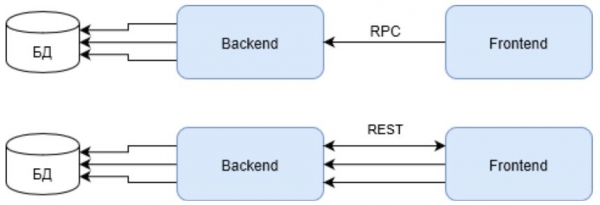
Beachten Sie, dass die erste Anfrage im Fall von REST die Benutzer-ID zurückgeben muss, um die nachfolgenden Anfragen auszuführen. Dies wirkt sich ebenfalls negativ auf das Gesamtergebnis aus.
Solche Infrastrukturen findet man höchstens in internen Lösungen und im Enterprise-Bereich. Im schlimmsten Fall in kleinen WEB-Projekten. Vollwertige WEB-Lösungen, die als HighLoad bezeichnet werden, sollten jedoch nicht so konstruiert werden. Ihre Infrastruktur muss den Kriterien für hohe Verfügbarkeit und Belastbarkeit entsprechen. Und das Bild ändert sich.
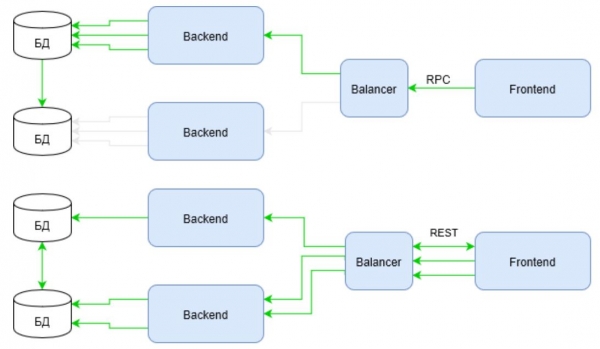
Die grünen Bereiche markieren die Aktivitäten der Infrastruktur unter demselben Szenario. Achten Sie darauf, wie sich RPC jetzt verhält. Die Anfrage nutzt die Infrastruktur nur über eine Verbindung vom Lastverteiler zum Backend. Während REST im ersten Anfrage immer noch zurückfällt, holt es die verlorene Zeit auf, indem es die gesamte Infrastruktur nutzt.
Es reicht, im Szenario nicht zwei Anfragen zur Anreicherung einzuführen, sondern sagen wir fünf oder zehn… und die Antwort auf die Frage "Wer gewinnt jetzt?" wird unklar.
Ich schlage vor, das Problem noch umfassender zu betrachten. In der Grafik sieht man, wie die Infrastrukturkanäle genutzt werden, aber die Infrastruktur beschränkt sich nicht nur auf diese Kanäle. Ein wichtiger Bestandteil einer hochbelasteten Infrastruktur sind Caches. Lassen Sie uns nun ein Benutzerartefakt erstellen. Mehrmals. Sagen wir 32 Mal.
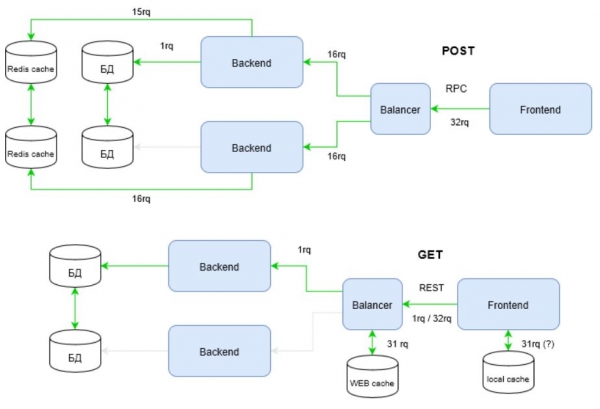
Sehen Sie, wie deutlich sich die Infrastruktur bei RPC verbessert hat, um den Anforderungen an hohe Last gerecht zu werden. Der Grund dafür ist, dass REST die gesamte Leistungsfähigkeit des HTTP-Protokolls nutzt, im Gegensatz zu RPC. In der angezeigten Grafik wird diese Leistung durch die Anfrage-Methode - GET - umgesetzt.
HTTP-Methoden haben nebenbei auch Caching-Strategien. Sie können sich mit ihnen in der Dokumentation unter vertraut machen. Für RPC werden POST-Anfragen verwendet, die nicht als idempotent gelten, das heißt, die wiederholte Ausführung derselben POST-Anfragen kann unterschiedliche Ergebnisse liefern (zum Beispiel wird nach jeder Absendung eines Kommentars eine weitere Kopie dieses Kommentars erstellt) ().
Daher kann RPC die infrastrukturellen Caches nicht effektiv nutzen. Dies führt dazu, dass zeitaufwendige Software-Caches implementiert werden müssen. In der Grafik spielt Redis diese Rolle. Der Software-Cache wiederum erfordert vom Entwickler eine zusätzliche Code-Ebene und signifikante Änderungen in der Architektur.
Lassen Sie uns nun zählen, wie viele Anfragen REST und RPC in der betrachteten Infrastruktur „generiert“ haben.
Anfragen
Eingehende
zu Backend
zu DBMS
zum Software-Cache (Redis)
GESAMT
REST
1/32*
1
1
0
3 / 35
RPC
32
32
1
31
96
[*] Im besten Fall (wenn der lokale Cache genutzt wird) 1 Anfrage (eine!), im schlimmsten Fall 32 eingehende Anfragen.
Im Vergleich zur ersten Grafik ist der Unterschied beträchtlich. Jetzt wird der Vorteil von REST offensichtlich. Aber ich schlage vor, nicht dabei stehen zu bleiben. Eine entwickelte Infrastruktur umfasst CDN. Oft löst es auch das Problem der Abwehr von DDoS- und DoS-Angriffen. Wir erhalten:
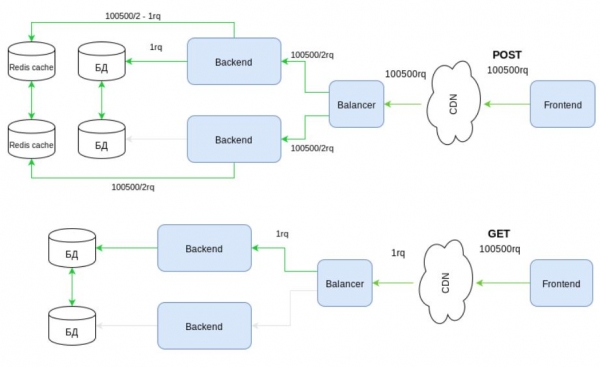
Hier sieht es für RPC ganz düster aus. RPC ist einfach nicht in der Lage, die Arbeit mit der Last des CDN zu delegieren. Es bleibt nur auf Systeme zur Abwehr von Angriffen zu hoffen.
Kann man hiermit abschließen? Und erneut, nein. Die HTTP-Methoden haben, wie bereits erwähnt, ihre eigene „Magie“. Und es ist kein Zufall, dass die GET-Methode in Internet weit verbreitet ist. Beachten Sie, dass diese Methode in der Lage ist, auf Teile des Inhalts zuzugreifen, Bedingungen festzulegen, die die Infrastrukturselemente noch vor der Übergabe der Kontrolle an Ihren Code interpretieren können, usw. All dies ermöglicht es, flexible, verwaltbare Infrastrukturen zu schaffen, die wirklich große Anfragenmengen verarbeiten können. Und in RPC wird diese Methode… ignoriert.
Warum hält sich der Mythos, dass Batch-Anfragen (RPC) schneller sind? Mir scheint, dass die meisten Projekte einfach nicht das Entwicklungsniveau erreichen, auf dem REST seine Stärke zeigen kann. Darüber hinaus zeigt es in kleinen Projekten eher seine Schwächen.
Die Wahl zwischen REST oder RPC ist keine willkürliche Entscheidung eines Einzelnen im Projekt. Diese Entscheidung sollte den Anforderungen des Projekts entsprechen. Wenn das Projekt in der Lage ist, alles aus REST herauszuholen, was es tatsächlich kann, und dies wirklich erforderlich ist, dann wird REST eine ausgezeichnete Wahl sein.
Aber wenn es erforderlich ist, um die Vorteile von REST zu nutzen, DevOps für die schnelle Skalierung der Infrastruktur, Administratoren für das Management der Infrastruktur, einen Architekten für die Planung aller Schichten des Webdienstes zu engagieren… und das Projekt gleichzeitig drei Packungen Margarine pro Tag verkauft… würde ich mich für RPC entscheiden, da dieses Protokoll utilitaristischer ist. Es erfordert keine tiefen Kenntnisse über Caches und Infrastruktur und konzentriert den Entwickler auf einfache und verständliche Aufrufe der benötigten Prozeduren. Das Geschäft wird zufrieden sein.
RPC-Anfragen sind zuverlässiger, da sie Batch-Anfragen im Rahmen einer Transaktion durchführen können.
Dieses Merkmal von RPC ist ein unbestreitbarer Vorteil, da es einfach ist, die Datenbank in einem konsistenten Zustand zu halten. Mit REST wird das jedoch komplizierter. Anfragen können unregelmäßig an verschiedene Back-End-Knoten gesendet werden.
Dieser „Nachteil“ von REST ist die Kehrseite seines oben beschriebenen Vorteils – die Fähigkeit, alle Ressourcen der Infrastruktur effizient zu nutzen. Wenn die Infrastruktur schlecht entworfen ist, insbesondere wenn die Architektur des Projekts und die Datenbank schlecht konzipiert sind, ist das wirklich ein großes Problem.
Aber sind Batch-Anfragen wirklich so zuverlässig, wie sie scheinen? Lassen Sie uns einen Fall betrachten: Wir erstellen einen Benutzer, bereichern sein Profil mit einer Beschreibung und senden ihm eine SMS mit einem Geheimnis, um die Registrierung abzuschließen. Das heißt, drei Aufrufe in einer Batch-Anfrage.
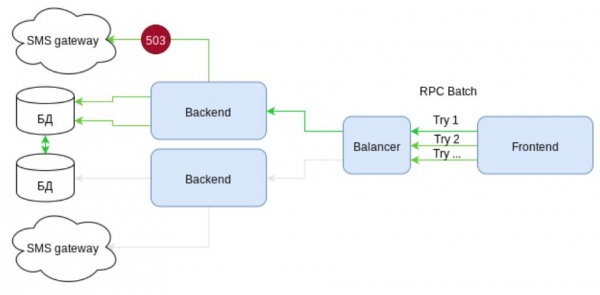
Betrachten wir das Schema. Es zeigt die Infrastruktur mit Elementen hoher Verfügbarkeit. Es gibt zwei unabhängige Kommunikationskanäle zu SMS-Gateways. Aber… was sehen wir? Bei der SMS-Versendung tritt der Fehler 503 auf – der Dienst ist vorübergehend nicht verfügbar. Da die SMS-Versendung in eine Batch-Anfrage verpackt ist, muss die gesamte Anfrage zurückgerollt werden. Die Aktionen in der DB werden annulliert. Der Kunde erhält einen Fehler.
Der nächste Versuch ist ein Glücksspiel. Entweder trifft die Anfrage erneut denselben Knoten und gibt wieder einen Fehler zurück, oder wir haben Glück und sie wird ausgeführt. Aber das Wichtigste ist, dass unsere Infrastruktur bereits mindestens einmal vergeblich gearbeitet hat. Die Belastung war da, aber der Gewinn fehlt.
Gut, stellen wir uns vor, dass wir uns angestrengt haben (!) und eine Option durchdacht haben, bei der die Anfrage teilweise erfolgreich ausgeführt werden kann. Den Rest werden wir erneut nach einer gewissen Zeit versuchen (Welche? Das entscheidet das Frontend?). Aber das Glücksspiel bleibt bestehen. Die Anfrage zum Versenden der SMS könnte mit einer Wahrscheinlichkeit von 50/50 erneut scheitern.
Stimmen Sie zu, aus Sicht des Kunden erscheint der Dienst nicht so zuverlässig, wie man sich das wünschen würde… und wie steht es um REST?
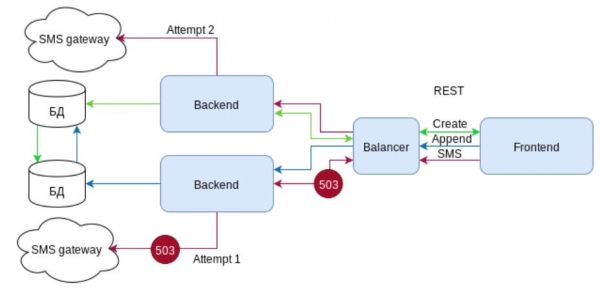
REST nutzt erneut die „Magie“ von HTTP, dies Mal jedoch mit Antwortcodes. Im Falle eines Fehlers 503 am SMS-Gateway übersetzt der Backend diesen Fehler an den Lastverteiler. Der Lastverteiler, der diesen Fehler empfängt, unterbricht die Verbindung zum Kunden nicht und leitet die Anfrage an einen anderen Knoten weiter, der die Anfrage erfolgreich bearbeitet. Das heißt, der Kunde erhält das erwartete Ergebnis, und die Infrastruktur bestätigt ihren hohen Status als „hochverfügbar“. Der Benutzer ist glücklich.
Und das ist noch nicht alles. Der Lastverteiler hat nicht nur den Antwortcode 503 erhalten. Nach dem Standard sollte dieser Code bei der Antwort idealerweise mit dem Header „Retry-After“ versehen werden. Der Header signalisiert dem Lastverteiler, dass er diesen Knoten in diesem Routing für eine bestimmte Zeit nicht belästigen sollte. Die nächsten Anfragen zum Versenden von SMS werden direkt an den Knoten gesendet, der keine Probleme mit dem SMS-Gateway hat.
Wie wir sehen, ist die Zuverlässigkeit von JSON-RPC überschätzt. Tatsächlich ist es einfacher, Konsistenz in der DB zu organisieren. Aber in diesem Fall wird die Zuverlässigkeit des Systems als Ganzes beeinträchtigt.
Die Ausgabe ist im Wesentlichen ähnlich wie die vorherige. Wenn die Infrastruktur einfach ist, ist die Evidenz von JSON-RPC sicherlich ein Pluspunkt. Wenn das Projekt jedoch hohe Verfügbarkeit mit hoher Belastung erfordert, erscheint REST als die geeignetere, wenn auch komplexere Lösung.
Die Eintrittsbarriere für REST ist niedriger.
Ich denke, die obige Analyse, die die festgefahrenen Stereotypen über RPC widerlegt, hat deutlich gezeigt, dass die Eintrittsbarriere für REST definitiv höher ist als für RPC. Dies hängt mit der Notwendigkeit zusammen, das Funktionieren von HTTP tiefgehend zu verstehen, sowie mit der Notwendigkeit, ausreichende Kenntnisse über die bestehenden infrastrukturellen Elemente zu haben, die man in WEB-Projekten anwenden kann und sollte.
Warum denken dann viele, dass REST einfacher sein wird? Persönlich glaube ich, dass diese vermeintliche Einfachheit aus den Manifesten von REST selbst stammt. Das heißt, REST ist kein Protokoll, sondern ein Konzept... REST hat keinen Standard, es gibt einige Empfehlungen... REST ist nicht komplizierter als HTTP. Die vermeintliche Freiheit und Anarchie zieht "freie Künstler" an.
Zweifellos ist REST nicht komplizierter als HTTP. Aber HTTP selbst ist ein gut durchdachtes Protokoll, das sich über Jahrzehnte bewährt hat. Wenn es kein tiefes Verständnis von HTTP gibt, kann man auch nicht über REST urteilen.
Aber bei RPC kann man urteilen. Es reicht, seine Spezifikation zu nehmen. Brauchen Sie also? ? Или все же хитрый REST? Решать вам.
Ich hoffe aufrichtig, dass ich Ihre Zeit nicht umsonst verschwendet habe.
Quelle: habr.com
