

Die Cloud ähnelt einer magischen Schatzkiste – du gibst an, was du brauchst, und die Ressourcen erscheinen einfach aus dem Nichts. Virtuelle Maschinen, Datenbanken, Netzwerke – all das gehört nur dir. Es gibt auch andere Cloud-Tenants, aber in deinem Universum bist du der alleinige Herrscher. Du bist dir sicher, dass du immer die benötigten Ressourcen bekommst, ohne Rücksicht auf andere und bestimmst selbst, wie das Netzwerk aussehen wird. Wie funktioniert diese Magie, die die Cloud dazu bringt, Ressourcen flexibel zuzuteilen und die Tenants vollständig voneinander zu isolieren?
Die AWS-Cloud ist ein mega-super-komplexes System, das sich seit 2006 evolutionär entwickelt. Ein Teil dieser Entwicklung wurde Wassili Pantuchin – Architekt von Amazon Web Services. Als Architekt sieht er nicht nur das Endergebnis, sondern auch die Herausforderungen, die AWS bewältigt. Je mehr Verständnis für die Funktionsweise des Systems, desto mehr Vertrauen. Daher wird Wassili die Geheimnisse der AWS-Cloud-Services teilen. Im Folgenden wird die Struktur der physischen AWS-Server, die elastische Skalierbarkeit von Datenbanken, die benutzerdefinierte Amazon-Datenbank und Methoden zur Leistungssteigerung virtueller Maschinen bei gleichzeitiger Senkung der Kosten behandelt. Das Wissen über die Architekturansätze von Amazon hilft, die AWS-Services effizienter zu nutzen und möglicherweise neue Ideen zur Entwicklung eigener Lösungen zu finden.
Über den Sprecher: Wassili Pantuchin () begann als Unix-Admin in .ru-Unternehmen, arbeitete 6 Jahre mit großen Systemen von Sun Microsystem und lehrte 11 Jahre lang die Datenzentrum-Orientierung der Welt bei EMC. Naturgemäß entwickelte er sich zu privaten Clouds, und 2017 wechselte er zu öffentlichen. Heute gibt er technische Ratschläge, um das Leben in der AWS-Cloud zu unterstützen und zu fördern.
Haftungsausschluss: Alles, was im Folgenden steht, ist die persönliche Meinung von Wassili und könnte von der Position von Amazon Web Services abweichen. des Vortrags, auf dessen Basis der Artikel erstellt wurde, ist auf unserem YouTube-Kanal verfügbar.
Warum ich über die Struktur von Amazon spreche
Mein erstes Auto hatte einen „Schalthebel“ – mit einem manuellen Getriebe. Das war großartig, weil ich das Gefühl hatte, dass ich das Auto steuern und vollständig kontrollieren kann. Außerdem gefiel mir, dass ich zumindest ungefähr das Prinzip seiner Funktionsweise verstand. Natürlich stellte ich mir den Aufbau des Getriebes eher primitiv vor – etwa wie ein Fahrradgetriebe.
Alles war großartig, bis auf eines – das Stehen im Stau. Man sitzt scheinbar und macht nichts, aber man schaltet ständig die Gänge, drückt die Kupplung, das Gas, die Bremse – das macht wirklich müde. Das Stauproblem hat sich teilweise gelöst, als in der Familie ein Automatikauto hinzukam. Am Steuer hatte ich Zeit, über etwas nachzudenken und ein Hörbuch zu hören.
In meinem Leben gab es noch ein Rätsel, denn ich verstand überhaupt nicht mehr, wie mein Auto funktioniert. Ein modernes Auto ist ein komplexes Gerät. Es passt sich gleichzeitig an Dutzende verschiedener Parameter an: Gaspedal, Bremse, Fahrstil, Straßenzustand. Ich verstehe nicht mehr, wie das funktioniert.
Als ich anfing, mich mit der Amazon Cloud zu beschäftigen, war das für mich ebenfalls ein Rätsel. Nur war dieses Rätsel um ein Vielfaches größer, denn im Auto gibt es einen Fahrer, und in AWS gibt es Millionen. Alle Nutzer steuern gleichzeitig, drücken das Gas und die Bremse. Es ist erstaunlich, dass sie dorthin fahren, wo sie wollen – für mich ist das ein Wunder! Das System passt sich automatisch an, skaliert und passt sich flexibel an jeden Benutzer an, sodass es ihm so vorkommt, als wäre er der einzige in diesem Universum.
Die Magie schwand etwas, als ich später begann, als Architekt bei Amazon zu arbeiten. Ich sah, mit welchen Problemen wir konfrontiert sind, wie wir sie lösen, wie wir die Dienste entwickeln. Mit wachsendem Verständnis für die Funktionsweise des Systems wächst das Vertrauen in den Dienst. Deshalb möchte ich die Mechanismen hinter der AWS Cloud teilen.
Worüber werden wir sprechen
Ich habe einen diversifizierten Ansatz gewählt – ich habe vier interessante Dienste ausgewählt, über die es sich lohnt zu sprechen.
Serveroptimierung. Ephemeral Clouds mit physischer Manifestation: Physische Rechenzentren, in denen physische Server stehen, die summen, Wärme erzeugen und mit Lichtern blitzen.
Serverless-Funktionen (Lambda) – wahrscheinlich der skalierbarste Dienst in der Cloud.
Datenbank-Skalierung. Ich werde erzählen, wie wir unsere eigenen skalierbaren DBs aufbauen.
Netzwerkskalierung. Der letzte Teil, in dem ich die Struktur unseres Netzwerks enthülle. Es ist eine wunderbare Sache – jeder Cloud-Nutzer glaubt, dass er alleine in der Cloud ist und überhaupt keine anderen Tenants sieht.
Hinweis. In diesem Artikel geht es um die Optimierung von Servern und das Skalieren von Datenbanken. Die Skalierung von Netzwerken wird im nächsten Artikel behandelt. Wo bleiben die serverlosen Funktionen? Darüber gibt es eine separate Aufschlüsselung.Darüber wird über verschiedene Ansätze zur Skalierung berichtet und die Lösung Firecracker im Detail besprochen – eine Symbiose der besten Eigenschaften von virtuellen Maschinen und Containern.
Die Server
Die Cloud ist vergänglich. Aber diese Vergänglichkeit hat dennoch eine physische Verkörperung – die Server. Ursprünglich war ihre Architektur klassisch. Standard-x86-Chipsatz, Netzwerkkarten, Linux, Hypervisor Xen, auf dem die virtuellen Maschinen liefen.
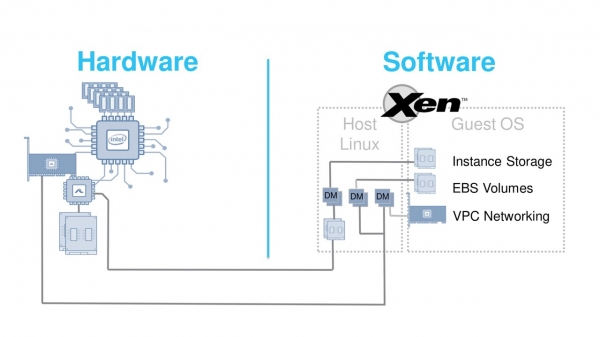
Im Jahr 2012 kam diese Architektur ihren Aufgaben durchaus nach. Xen ist ein ausgezeichneter Hypervisor, hat jedoch einen gravierenden Nachteil. Es gibt erhebliche Overheadkosten bei der Geräteemulation.Mit dem Aufkommen neuer, schnellerer Netzwerkkarten oder SSDs werden diese Kosten jedoch zu hoch. Wie lässt sich dieses Problem lösen? Wir entschieden uns, an zwei Fronten gleichzeitig zu arbeiten – Sowohl die Hardware als auch den Hypervisor zu optimieren.Die Herausforderung ist sehr ernst.
Optimierung von Hardware und Hypervisor
Alles gleichzeitig und gut zu machen, ist nicht möglich. Was „gut“ bedeutet, war anfänglich auch unklar.
Wir entschieden uns für einen evolutionären Ansatz – wir ändern ein wichtiges Element der Architektur und bringen es in die Produktion.
Wir treten auf alle Rechen weiter, hören Beschwerden und Vorschläge. Dann ändern wir eine andere Komponente. So ändern wir schrittweise die gesamte Architektur basierend auf dem Feedback von Benutzern und Support.
Die Transformation begann 2013 mit dem schwierigsten – dem Netzwerk. In den C3 Instanzen wurde zur Standard-Netzwerkkarte eine spezielle Network Accelerator-Karte hinzugefügt. Sie wurde buchstäblich mit einem kurzen Loopback-Kabel an der Vorderseite verbunden. Nicht schön, aber in der Cloud sieht man es nicht. Dafür hat die direkte Interaktion mit der Hardware das Jitter und die Bandbreite des Netzwerks grundlegend verbessert.
Anschließend beschlossen wir, den Zugriff auf den Elastic Block Storage (EBS) zu verbessern – eine Kombination aus Netzwerk und Speicher. Die Herausforderung bestand darin, dass es zwar Network Accelerator-Karten auf dem Markt gab, aber keine Möglichkeit, Hardware für Storage Accelerator zu kaufen. Daher wandten wir uns an das Start-up Annapurna Labs., der spezielle ASIC-Chips für uns entwickelt hat. Diese ermöglichten es, entfernte EBS-Volumes als NVMe-Geräte anzuschließen.
In den Instanzen C4 haben wir zwei Aufgaben gelöst. Erstens haben wir die Grundlage für zukünftige, vielversprechende, aber zu diesem Zeitpunkt neue NVMe-Technologie geschaffen. Zweitens haben wir die zentrale Verarbeitungseinheit erheblich entlastet, indem wir die Verarbeitung von Anfragen an EBS auf die neue Karte verlagert haben. Es hat gut funktioniert, deshalb ist Annapurna Labs jetzt Teil von Amazon.
Bis November 2017 hatten wir das Gefühl, dass es an der Zeit war, auch den Hypervisor zu ändern.
Der neue Hypervisor wurde auf der Grundlage überarbeiteter KVM-Kernmodule entwickelt.
Er ermöglichte es, die Overheads der Gerätesimulation erheblich zu reduzieren und direkt mit den neuen ASICs zu arbeiten. Die Instanzen C5 waren die ersten virtuellen Maschinen, unter deren Haube der neue Hypervisor lief. Wir haben ihn genannt Nitro.
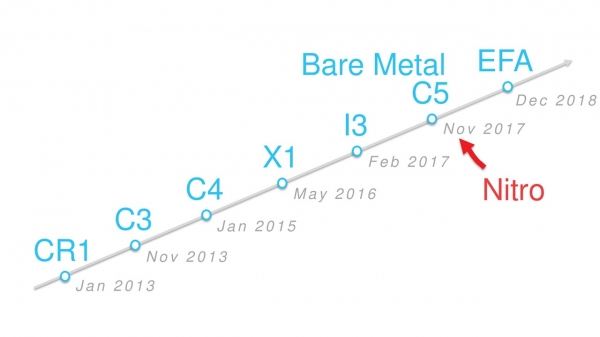 Die Evolution der Instanzen auf der Zeitachse.
Alle neuen Typen virtueller Maschinen, die seit November 2017 erschienen sind, funktionieren auf diesem Hypervisor. Physische Bare Metal-Instanzen haben keinen Hypervisor, werden aber ebenfalls Nitro genannt, da sie spezialisierte Nitro-Karten verwenden.
In den folgenden zwei Jahren hat sich die Anzahl der Nitro-Instanztypen auf mehrere Dutzend erhöht: A1, C5, M5, T3 und andere.
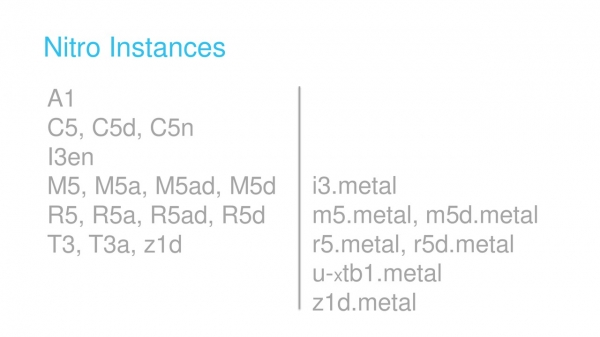
Instanztypen.
Wie moderne Nitro-Maschinen aufgebaut sind
Sie bestehen aus drei Hauptkomponenten: dem Nitro-Hypervisor (darüber wurde bereits gesprochen), dem Sicherheitsschip und den Nitro-Karten.
Das Sicherheitsschip ist direkt in das Motherboard integriert. Es kontrolliert viele wichtige Funktionen, beispielsweise die Kontrolle des Bootens des Host-Betriebssystems.
Die Nitro-Karten — es gibt vier Typen. Alle wurden von Annapurna Labs entwickelt und basieren auf gemeinsamen ASICs. Ein Teil ihrer Firmware ist ebenfalls gemeinsam.
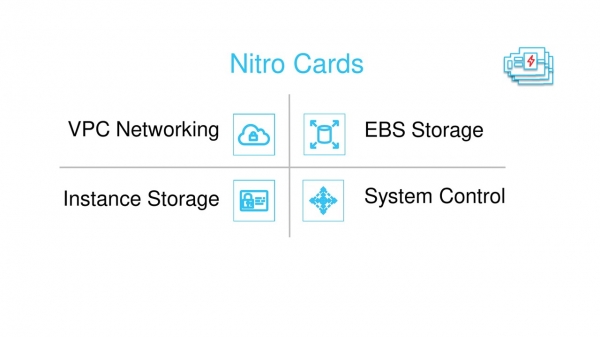
Vier Typen von Nitro-Karten.
Eine der Karten ist für die Arbeit mit dem NetzwerkVPC. Diese erscheint in virtuellen Maschinen als Netzwerkadapter ENA — Elastic Network Adaptor. Sie kapselt auch den Datenverkehr beim Übertragen über das physische Netzwerk (darüber sprechen wir im zweiten Teil des Artikels), kontrolliert die Firewall der Sicherheitsgruppen, ist verantwortlich für das Routing und andere Netzwerkaufgaben.
Einzelne Karten arbeiten mit blockbasierter Speicherung EBS und mit in den Server integrierten Festplatten. Sie werden der Gast-VM als NVMe-Adapterpräsentiert. Sie sind auch für die Verschlüsselung der Daten und die Überwachung der Festplatten verantwortlich.
Das System aus Nitro-Karten, Hypervisor und Sicherheitsschip ist in einem SDN-Netzwerk oder Software Defined Network. Die Verwaltung dieses Netzwerks (Control Plane) obliegt der Kartenkontroller.
Natürlich arbeiten wir weiterhin an der Entwicklung neuer ASICs. Beispielsweise haben wir Ende 2018 den Inferentia-Chip veröffentlicht, der eine effizientere Bearbeitung von Aufgaben im Bereich des maschinellen Lernens ermöglicht.
Inferentia Machine Learning Prozessor.
Skalierbare Datenbank
Eine traditionelle Datenbank hat eine schichtartige Struktur. Wenn man es stark vereinfacht, ergeben sich folgende Ebenen.
- SQL — darauf arbeiten die Client- und Anfrage-Dispatcher.
- Sicherheiten Transaktionen — hier ist alles klar, ACID und so weiter.
- Caching, das durch Pufferpools gewährleistet wird.
- Protokollierung — sorgt für die Arbeit mit Redo-Logs. In MySQL heißen sie Bin Logs, in PostgreSQL — Write Ahead Logs (WAL).
- Speicherung – zeichnet direkt auf die Festplatte.
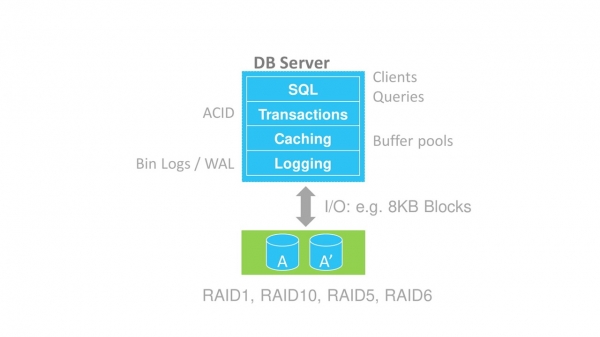
Schichtstruktur der Datenbank.
Es gibt verschiedene Möglichkeiten zur Skalierung von Datenbanken: Sharding, Shared-Nothing-Architektur, gemeinsam genutzte Festplatten.
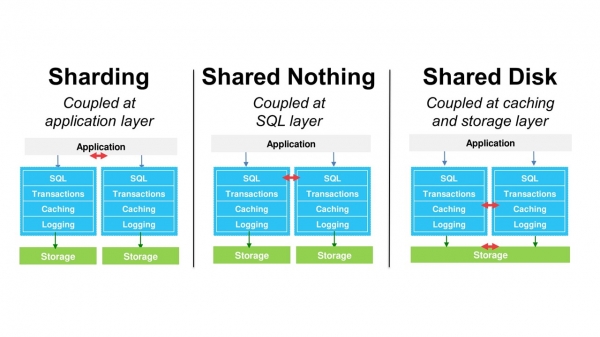
Allerdings bleibt bei all diesen Methoden die monolithische Struktur der Datenbank erhalten. Das schränkt die Skalierung erheblich ein. Um dieses Problem zu lösen, haben wir unsere eigene DB entwickelt — Amazon Aurora. Sie ist mit MySQL und PostgreSQL kompatibel.
Amazon Aurora
Die grundlegende architektonische Idee besteht darin, die Speicher- und Protokollebene von der Hauptdatenbank zu trennen.
Um vorwegzunehmen, dass die Caching-Ebene ebenfalls unabhängig ist. Die Architektur hört auf, monolithisch zu sein, und wir erhalten zusätzliche Freiheitsgrade bei der Skalierung einzelner Blöcke.
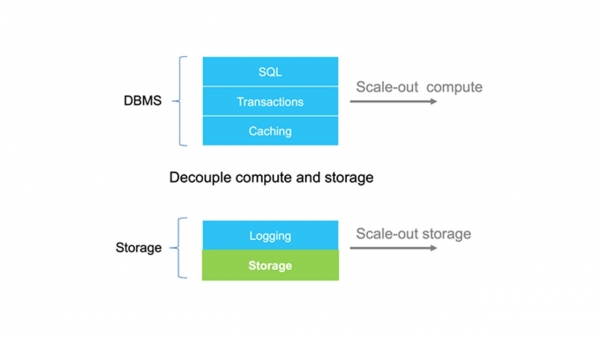
Die Protokoll- und Speicherebenen sind von der Datenbank getrennt.
Eine traditionelle DBMS speichert Daten in Form von Blöcken im Speichersystem. In Amazon Aurora haben wir einen "intelligenten" Speicher erstellt, der in der Sprache der Redo-Logs. Innerhalb wandelt der Speicher die Protokolle in Datenblöcke um, überwacht deren Integrität und sichert sie automatisch.
Dieser Ansatz ermöglicht es, interessante Dinge wie Klone. Es funktioniert grundsätzlich schneller und kostengünstiger, da es keine vollständige Kopie aller Daten erfordert.
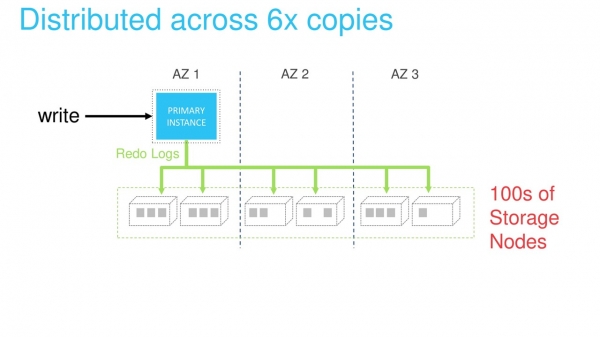
Die Speicherebene wird als verteiltes System implementiert. Sie besteht aus einer sehr großen Anzahl physischer Server. Jeder Redo-Log wird simultan verarbeitet und gespeichert von sechs Knoten. Dies gewährleistet den Datenschutz und die Lastverteilung.
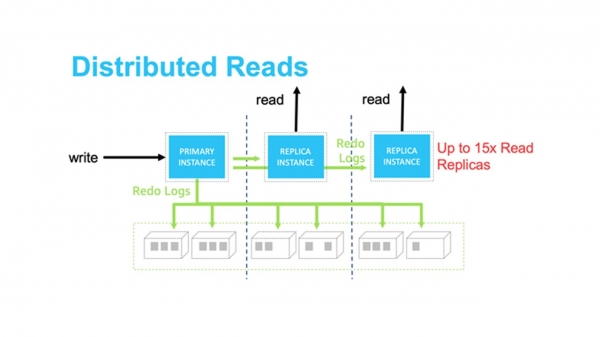
Die Skalierung beim Lesen kann durch geeignete Replikate sichergestellt werden. Ein verteiltes Speichersystem beseitigt die Notwendigkeit der Synchronisierung zwischen der Hauptdatenbankinstanz, über die wir Daten schreiben, und den anderen Replikaten. Aktuelle Daten sind für alle Replikate garantiert verfügbar.
Das einzige Problem ist das Caching alter Daten auf den Lese-Replikaten. Aber dieses Problem wird gelöst durch die Übertragung aller Redo-Logs an die Replikate über das interne Netzwerk. Wenn das Log im Cache ist, wird es als ungültig markiert und überschrieben. Wenn es nicht im Cache ist, wird es einfach verworfen.
Mit dem Speichersystem haben wir uns auseinandergesetzt.
Wie man die Ebenen der DBMS skalieren kann
Hier ist horizontale Skalierung viel schwieriger zu bewerkstelligen. Daher gehen wir den bereits bewährten Weg der klassischen vertikalen Skalierung.
Nehmen wir an, wir haben eine Anwendung, die über einen Master-Knoten mit dem DBMS kommuniziert.
Bei vertikaler Skalierung weisen wir einen neuen Knoten zu, der über mehr Prozessoren und Speicher verfügt.
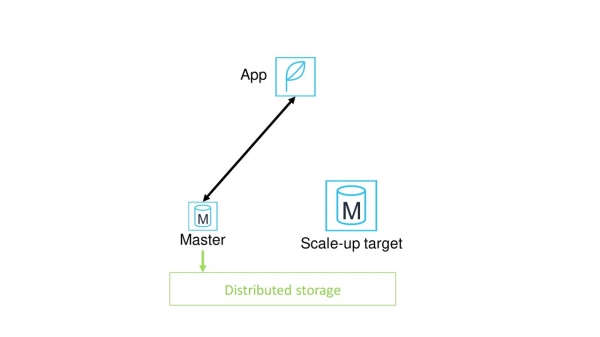
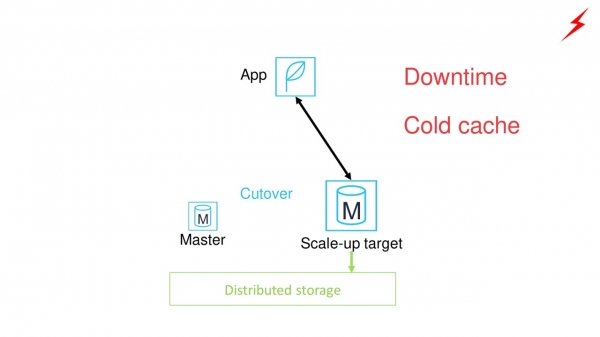
Dann schalten wir die Anwendung vom alten Master-Knoten auf den neuen um. Es treten Probleme auf.
- Dies erfordert eine merkliche Ausfallzeit der Anwendung.
- Der neue Master-Knoten hat einen kalten Cache. Die Leistung der DB wird nur nach dem Aufwärmen des Caches maximal sein.
Wie kann man die Situation verbessern? Einen Proxy zwischen der Anwendung und dem Master-Knoten setzen.
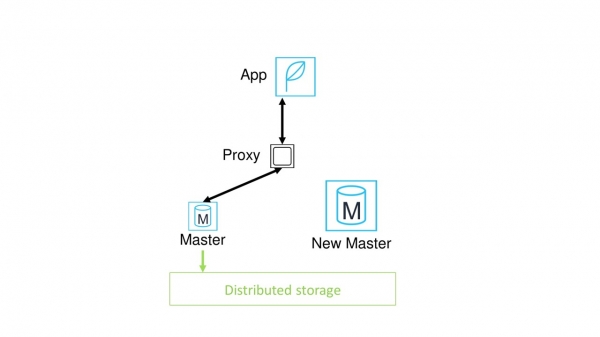
Was bringt uns das? Jetzt müssen alle Anwendungen nicht manuell auf den neuen Knoten umgeleitet werden. Die Umschaltung kann unter dem Proxy erfolgen und ist dabei grundsätzlich schneller.
Es scheint, als wäre das Problem gelöst. Aber nein, wir leiden immer noch unter der Notwendigkeit, den Cache aufzuwärmen. Außerdem ist ein neues Problem aufgetaucht - jetzt ist der Proxy ein potenzieller Ausfallpunkt.
Die endgültige Lösung mit Amazon Aurora serverless
Wie haben wir diese Probleme gelöst?
Wir haben den Proxy behalten. Es handelt sich nicht um eine separate Instanz, sondern um eine ganze verteilte Flotte von Proxys, über die Anwendungen mit der DB verbunden werden. Jede der Knoten kann im Falle eines Ausfalls nahezu sofort ersetzt werden.
Wir haben einen Pool von warmen Knoten unterschiedlicher Größe hinzugefügt. Daher ist ein neuer Knoten, der größer oder kleiner ist, bei Bedarf sofort verfügbar. Es muss nicht gewartet werden, bis er geladen ist.
Der gesamte Skalierungsprozess wird von einem speziellen Überwachungssystem kontrolliert. Die Überwachung verfolgt kontinuierlich den Zustand des aktuellen Master-Nodes. Wenn sie beispielsweise feststellt, dass die CPU-Auslastung einen kritischen Wert erreicht hat, informiert sie den Pool der warmen Instanzen über die Notwendigkeit, einen neuen Node bereitzustellen.
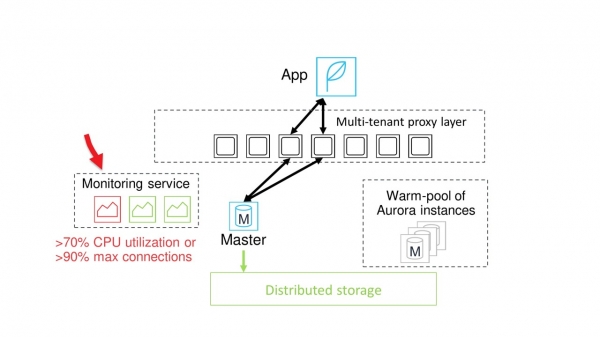
Verteilte Proxys, warme Instanzen und Überwachung.
Ein Node mit der erforderlichen Leistung ist verfügbar. Die Pufferpools werden darauf kopiert, und das System beginnt, auf einen sicheren Moment für den Umschaltvorgang zu warten.
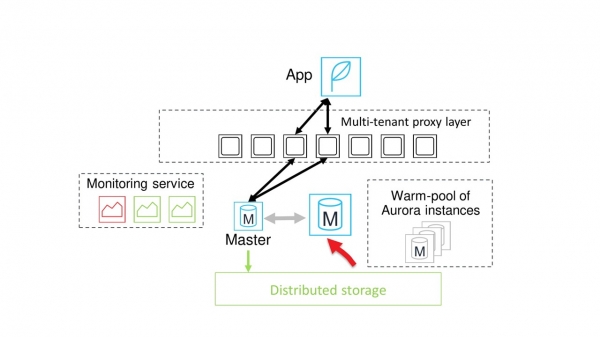
Normalerweise tritt der Moment für den Umschaltvorgang ziemlich schnell ein. Dann wird die Kommunikation zwischen dem Proxy und dem alten Master-Node unterbrochen, und alle Sitzungen werden auf den neuen Node umgeschaltet.
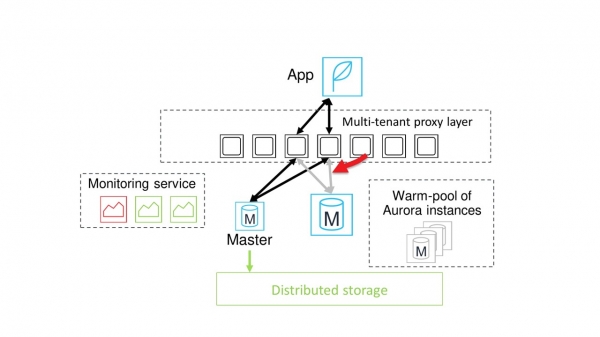
Die Arbeit mit der Datenbank wird wieder aufgenommen.
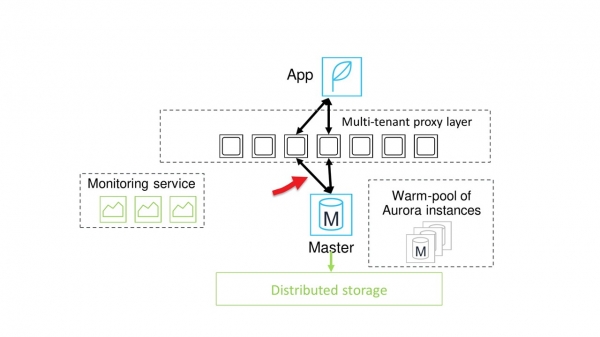
Auf dem Diagramm ist zu sehen, dass die Pause tatsächlich sehr kurz ist. Auf dem blauen Diagramm ist die Last zu sehen, und auf den roten Stufen die Skalierungsmomente. Die kurzzeitigen Einbrüche im blauen Diagramm sind genau die kurze Verzögerung.
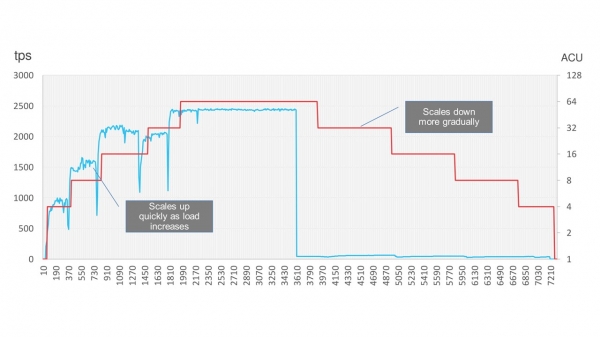
Übrigens ermöglicht Amazon Aurora eine erhebliche Einsparung und das Abschalten der DB, wenn sie nicht verwendet wird, zum Beispiel am Wochenende. Nach dem Stoppen verringert die DB nach und nach ihre Leistung und wird für einige Zeit abgeschaltet. Wenn die Last zurückkehrt, steigt sie wieder stetig an.
Im nächsten Teil unseres Berichts über Amazon-Geräte sprechen wir über die Netzwerkskalierung. Abonnieren Sie und bleiben Sie auf dem Laufenden, um den Artikel nicht zu verpassen.
Auf Vasily Pantyukhin wird mit dem Vortrag "" auftreten. Welche Entwurfsmuster für verteilte Systeme verwenden die Entwickler von Amazon, welche Gründe können zu Dienstausfällen führen, was ist Cell-based Architecture, Constant Work, Shuffle Sharding – es wird interessant werden. Weniger als ein Monat bis zur Konferenz – . Am 24. Oktober erfolgt die endgültige Preiserhöhung.
Quelle: habr.com
