

Einführung
Es ist Zeit, ein SAN zu kaufen. Welches soll ich wählen, wem soll ich zuhören? Anbieter A spricht über Anbieter B, und es gibt auch Integrator C, der das Gegenteil erzählt und Anbieter D empfiehlt. In einer solchen Situation kann selbst ein erfahrener Architekt für Speicherlösungen den Überblick verlieren, besonders mit all den neuen Anbietern und den derzeit angesagten SDS und Hyperkonvergenzen.
Wie kann man da nur durchblicken und sich nicht dumm vorkommen? Wir ( Anton Shbankov und Evgeny Elizarov) werden versuchen, dies auf einfache Weise zu erklären.
Der Artikel korreliert stark und ist faktisch eine Erweiterung des “” in Bezug auf die Auswahl von Datenspeicherlösungen und eine Übersicht über Speichertechnologien. Wir werden die grundlegende Theorie kurz betrachten, empfehlen jedoch, sich auch mit dem genannten Artikel vertraut zu machen.
Warum
Man kann häufig beobachten, wie eine neue Person in ein Forum oder einen spezialisierten Chat wie etwa Storage Discussions kommt und die Frage stellt: „Mir werden zwei Varianten von SANs angeboten — ABC SuperStorage S600 und XYZ HyperOcean 666v4, was empfehlen Sie?“
Und schon beginnt das Vergleichen, bei welchem Anbieter welche besonderen und unverständlichen Merkmale realisiert wurden, die für einen Ungeübten wie Chinesisch wirken.
Die entscheidende und erste Frage, die man sich lange vor dem Vergleich der Spezifikationen in den Angeboten stellen sollte, lautet — WARUM? Warum wird dieses SAN benötigt?
Die Antwort wird überraschend und ganz im Stil von Tony Robbins sein — um Daten zu speichern. Danke, Kapitän! Und dennoch vertiefen wir uns manchmal so sehr in den Vergleich der Details, dass wir vergessen, warum wir das Ganze überhaupt tun.
Die Aufgabe eines Datenspeichersystems besteht darin, DIE DATEN mit einer bestimmten Leistung zu speichern und den Zugriff darauf bereitzustellen. Mit diesen Daten fangen wir an.
Daten
Datentyp
Welche Daten planen wir zu speichern? Eine sehr wichtige Frage, die viele Speichersysteme sogar aus der Betrachtung ausschließen kann. Zum Beispiel ist die Speicherung von Videoaufzeichnungen und Fotos vorgesehen. Systeme, die für zufällige Zugriffe auf kleine Blöcke ausgelegt sind, oder Systeme mit speziellen Software-Funktionen in der Kompression/Deduplizierung können sofort ausgeschlossen werden. Das können einfach hervorragende Systeme sein, wir möchten nichts Schlechtes darüber sagen. Aber in diesem Fall werden ihre Stärken entweder zu Schwächen (da Video und Foto nicht komprimiert werden können) oder erhöhen einfach die Kosten des Systems erheblich.
Und umgekehrt: Wenn die Zielnutzung eine stark belastete transaktionale Datenbank ist, dann werden hervorragende Streams für Multimedia, die Gigabytes pro Sekunde liefern können, eine schlechte Wahl sein.
Datenvolumen
Wie viele Daten planen wir zu speichern? Die Menge wird immer zur Qualität, das sollte man niemals vergessen, insbesondere in unserer Zeit des exponentiellen Wachstums des Datenvolumens. Systeme der Petabyte-Klasse sind bereits keine Seltenheit, aber je mehr Petabyte an Volumen, desto spezifischer wird das System, und damit wird die gewohnte Funktionalität von Systemen mit zufälligem Zugriff kleiner und mittlerem Volumen weniger verfügbar. Einfach, weil allein die Statistiken zum Zugriffsverhalten nach Blöcken größer werden als das verfügbare Volumen des Arbeitsspeichers auf den Controllern. Ganz zu schweigen von Kompression/Deduplizierung. Nehmen wir an, wir möchten den Kompressionsalgorithmus auf einen leistungsfähigeren wechseln und 20 Petabyte Daten verdichten. Wie lange wird das dauern: ein halbes Jahr, ein Jahr?
Andererseits, warum viel Aufwand betreiben, wenn wir 500 GB Daten speichern und verarbeiten müssen? Nur 500. Haushalt SSDs (mit niedrigem DWPD) in einem solchen Volumen kosten fast nichts. Warum eine Fiber-Channel-Fabrik bauen und ein externes, hochwertiges Speichersystem kaufen, das so viel kostet wie eine Eisenbahnbrücke?
Welcher Prozentsatz des gesamten Datenvolumens sind heiße Daten? Wie ungleichmäßig ist die Last im Hinblick auf das Datenvolumen verteilt? Hier kann die Technologie der mehrstufigen Speicherung oder Flash Cache sehr hilfreich sein, wenn das Volumen der heißen Daten im Vergleich zum Gesamtvolumen minimal ist. Umgekehrt werden solche Technologien bei einer gleichmäßigen Lastverteilung im gesamten Volumen, wie sie häufig in Streaming-Systemen (Videoüberwachung, einige Analytiksysteme) vorkommt, nichts bringen und lediglich die Kosten/Komplexität des Systems erhöhen.
IS
Die Kehrseite der Daten ist das Informationssystem, das diese Daten nutzt. IS hat eine Reihe von Anforderungen, die von den Daten geerbt werden. Mehr dazu im „Design eines virtualisierten Rechenzentrums“.
Anforderungen an Ausfallsicherheit / Verfügbarkeit
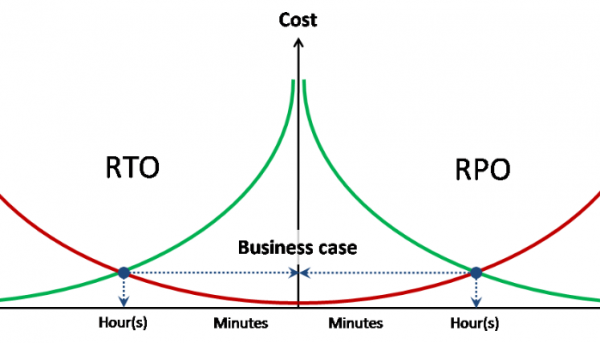
Die Anforderungen an die Ausfallsicherheit / Verfügbarkeit von Daten leiten sich von dem sie nutzenden IS ab und werden in drei Zahlen ausgedrückt - RPO, RTO, Verfügbarkeit.
Verfügbarkeit – der Anteil über einen bestimmten Zeitraum, während dessen die Daten verfügbar sind. Dies wird normalerweise in der Anzahl der Neun ausgedrückt. Zum Beispiel bedeutet zwei Neunen im Jahr, dass die Verfügbarkeit 99 % beträgt oder anders gesagt, es sind 95 Stunden Nichtverfügbarkeit pro Jahr erlaubt. Drei Neunen – 9,5 Stunden pro Jahr.
RPO / RTO sind Zahlen, die nicht kumulativ, sondern für jedes Ereignis (Panne) gelten, im Gegensatz zur Verfügbarkeit.
RPO – das Volumen der bei einem Vorfall verlorenen Daten (in Stunden). Wenn beispielsweise täglich ein Backup durchgeführt wird, beträgt RPO = 24 Stunden. Das bedeutet, dass bei einem Vorfall und dem vollständigen Verlust des Speichernetzes Daten in Höhe von bis zu 24 Stunden (ab dem Zeitpunkt des Backups) verloren gehen können. Aus dem für IS festgelegten RPO wird zum Beispiel eine Backup-Richtlinie erstellt. Auch aus dem RPO kann abgeleitet werden, wie wichtig eine synchrone / asynchrone Datenreplikation ist.
RTO – die Wiederherstellungszeit des Dienstes (Zugriff auf Daten) nach einem Vorfall. Anhand des festgelegten Wertes für RTO können wir verstehen, ob ein Metrocluster erforderlich ist oder ob eine unidirektionale Replikation ausreicht. Auch die Frage, ob ein Multi-Controller-Speicherungssystem der High-End-Klasse benötigt wird, stellt sich.
Anforderungen an die Leistung
Obwohl dies eine durchaus offensichtliche Frage ist, treten gerade hierbei die meisten Schwierigkeiten auf. Je nachdem, ob Sie bereits über eine Infrastruktur verfügen oder nicht, werden Wege zur Erfassung der notwendigen Statistiken aufgebaut.
Sie haben bereits ein SAN und suchen nach einem Ersatz oder möchten ein weiteres zur Erweiterung erwerben. Hier ist alles einfach. Sie wissen, welche Dienste Sie bereits haben und welche Sie in naher Zukunft implementieren möchten. Basierend auf den aktuellen Diensten haben Sie die Möglichkeit, Statistiken zur Leistung zu sammeln. Bestimmen Sie die aktuelle Anzahl der IOPS und die aktuellen Latenzen – wie wirken sich diese Kennzahlen aus und reichen sie für Ihre Aufgaben aus? Dies kann sowohl auf dem Speichergerät selbst als auch von den Hosts aus, die daran angeschlossen sind, erfolgen.
Dabei sollte man nicht nur die aktuelle Belastung betrachten, sondern über einen bestimmten Zeitraum (am besten einen Monat). Überprüfen Sie, welche maximalen Spitzen zu bestimmten Tageszeiten auftreten, welche Last durch Backup-Vorgänge erzeugt wird usw. Wenn Ihr SAN oder die dazugehörige Software Ihnen nicht alle diese Daten bereitstellt, können Sie das kostenlose RRDtool verwenden, das mit den meisten der beliebtesten SANs und Switches arbeitet und Ihnen detaillierte Leistungsstatistiken liefern kann. Auch die Last auf den Hosts, die mit diesem SAN arbeiten, sollte betrachtet werden, speziell je nach virtuellen Maschinen oder was genau auf diesem Host läuft.
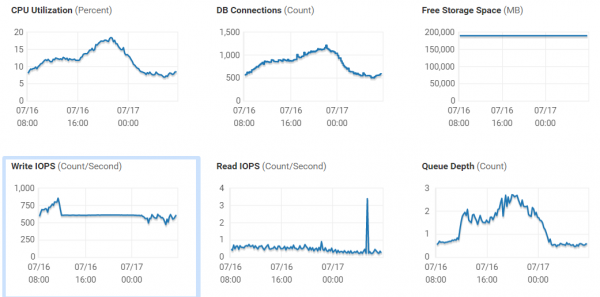
Es ist wichtig zu beachten, dass, wenn die Latenzen auf dem Volume und im Datenspeicher, der sich auf diesem Volume befindet, stark variieren, Sie Ihrer SAN-Netzwerk Aufmerksamkeit schenken sollten. Es besteht eine hohe Wahrscheinlichkeit, dass es dort Probleme gibt, und bevor Sie ein neues System erwerben, sollten Sie dieses Problem klären, da die Wahrscheinlichkeit hoch ist, dass die Leistung des aktuellen Systems steigen kann.
Sie bauen eine Infrastruktur von Grund auf neu oder erwerben ein System für einen neuen Dienst, dessen Lasten Ihnen unbekannt sind. Hier gibt es mehrere Optionen: Sprechen Sie mit Kollegen auf fachspezifischen Plattformen, um zu versuchen, die Last zu erfahren und vorherzusagen, oder wenden Sie sich an einen Integrator, der Erfahrung mit der Implementierung solcher Dienste hat und die Last für Sie berechnen kann. Die dritte Option (normalerweise die schwierigste, insbesondere wenn es sich um maßgeschneiderte oder seltene Anwendungen handelt) besteht darin, die Leistungsanforderungen bei den Entwicklern des Systems zu ermitteln.
Und, Achtung, die sinnvollste Variante aus praktischer Sicht ist ein Pilot auf der aktuellen Ausrüstung oder auf Ausrüstung, die vom Anbieter / Integrator für Tests bereitgestellt wird.
Spezielle Anforderungen
Spezielle Anforderungen sind all das, was nicht unter die Anforderungen an Leistung, Ausfallsicherheit und Funktionalität bei der direkten Datenverarbeitung und -bereitstellung fällt.
Eine der einfachsten speziellen Anforderungen an ein Datenspeichersystem sind "entfremdbare Speichermedien". Und es wird sofort klar, dass dieses Datenspeichersystem eine Bandbibliothek oder einfach ein Streamer beinhalten muss, auf den ein Backup gespeichert wird. Danach unterschreibt eine speziell geschulte Person das Band und trägt es stolz in einen speziellen Safe.
Ein weiteres Beispiel für spezielle Anforderungen ist eine stoßgeschützte Ausführung.
Wo
Ein weiterer Hauptfaktor bei der Auswahl eines bestimmten Speichersystems ist die Information darüber, WO dieses System stehen wird. Von der Geographie oder den klimatischen Bedingungen bis hin zum Personal.
Auftraggeber
Für wen wird dieses Speichersystem geplant? Die Frage hat folgende Grundlagen:
Staatlicher Auftraggeber / kommerziell.
Ein kommerzieller Auftraggeber hat keine Einschränkungen und ist nicht einmal verpflichtet, Ausschreibungen durchzuführen, außer nach den eigenen internen Richtlinien.
Ein staatlicher Auftraggeber ist eine andere Sache. 44 FZ und andere Aspekte bezüglich Ausschreibungen und Pflichtenheften, die angefochten werden können.
Auftraggeber unter Sanktionen
Nun, hier ist die Frage sehr einfach – die Auswahl beschränkt sich nur auf die für diesen Auftraggeber verfügbaren Angebote.
Interne Richtlinien / zugelassene Anbieter / Modelle
Die Frage ist ebenfalls recht einfach, aber man sollte daran denken.
Wo physisch
In diesem Abschnitt betrachten wir alle Fragen zur Geographie, zu Kommunikationskanälen und zum Mikroklima im Raum.
Personal
Wer wird mit diesem Speichersystem arbeiten? Das ist nicht weniger wichtig als das, was das Speichersystem tatsächlich kann.
So vielversprechend, cool und toll das Speichersystem des Anbieters A auch sein mag, es macht wahrscheinlich wenig Sinn, es zu installieren, wenn das Personal nur mit Anbieter B arbeiten kann und weitere Einkäufe sowie eine dauerhafte Zusammenarbeit mit A nicht geplant sind.
Und natürlich ist die Rückseite der Frage, wie verfügbar das geschulte Personal in diesem geografischen Standort direkt im Unternehmen und potenziell auf dem Arbeitsmarkt ist. Für Regionen kann die Auswahl einer Speicherlösung mit einfachen Schnittstellen oder der Möglichkeit zur zentralen Fernverwaltung von erheblichem Nutzen sein. Andernfalls kann es irgendwann sehr schmerzhaft werden. Das Internet ist voll von Geschichten darüber, wie ein neuer Mitarbeiter, ein frischgebackener Absolvent, alles falsch konfiguriert hat, sodass die gesamte Firma lahmgelegt wurde.
Umgebung
Und natürlich ist eine nicht unwichtige Frage, in welchem Umfeld diese Speicherlösung arbeiten wird.
- Was ist mit Stromversorgung / Kühlung?
- Welche Verbindung
- Wo wird sie installiert
- Und so weiter.
Oft gelten diese Fragen als selbstverständlich und werden nicht besonders betrachtet, aber manchmal können genau sie alles ins Gegenteil verkehren.
Was
Anbieter
Heute (Mitte 2019) kann der russische Markt für Speicherlösungen in fünf Kategorien unterteilt werden:
- Oberste Liga – renommierte Unternehmen mit einem breiten Sortiment von den einfachsten Festplattensystemen bis hin zu High-End-Lösungen (HPE, DellEMC, Hitachi, NetApp, IBM / Lenovo)
- Zweite Liga – Unternehmen mit einem begrenzten Sortiment, Nischenanbieter, ernsthafte Anbieter von SDS oder aufstrebende Neulinge (Fujitsu, Datacore, Infinidat, Huawei, Pure usw.)
- Dritte Liga – Nischenlösungen im Low-End-Bereich, kostengünstige SDS, Handgemachtes auf Basis von Ceph und anderen Open-Source-Projekten (Infortrend, Starwind usw.)
- SOHO-Segment – kleine und sehr kleine Speichersysteme auf Heimbüro-/Kleinbüro-Niveau (Synology, QNAP usw.)
- Importsubstituierte Speichersysteme – dazu gehören sowohl Hardware der ersten Liga mit neuen Etiketten als auch seltene Vertreter der zweiten (RAIDIX, geben wir ihnen vorab die zweite Liga), aber hauptsächlich handelt es sich um die dritte Liga (Aerodisk, Baum, Depo usw.)
Die Einteilung ist ziemlich willkürlich und bedeutet keineswegs, dass die dritte Liga oder das SOHO-Segment schlecht sind und nicht genutzt werden können. In spezifischen Projekten mit klar definiertem Datensatz und Lastprofil können sie sehr gut abschneiden und die erste Liga im Preis-Leistungs-Verhältnis weit übertreffen. Es ist wichtig, sich zuerst über die Aufgaben, Wachstumschancen und erforderliche Funktionalität klar zu werden – und dann wird Synology Ihnen treu dienen, während Ihre Haare weich und seidig werden.
Einer der nicht unwichtigen Faktoren bei der Auswahl eines Anbieters ist die aktuelle Umgebung. Wie viele und welche Speicherlösungen haben Sie bereits, mit welchen Speicherlösungen können die Ingenieure arbeiten? Benötigen Sie noch einen weiteren Anbieter, einen weiteren Kontaktpunkt, werden Sie die gesamte Last schrittweise von Anbieter A auf Anbieter B migrieren?
Man sollte nicht mehr Entitäten schaffen, als unbedingt notwendig.
iSCSI / FC / Datei
Was die Zugriffsprotokolle betrifft, gibt es unter den Ingenieuren keine einheitliche Meinung, und die Debatten erinnern mehr an theologische Diskussionen als an ingenieurtechnische. Aber insgesamt können folgende Punkte hervorgehoben werden:
FCoE ist eher tot als lebendig.
FC vs iSCSI. Ein entscheidender Vorteil von FC im Jahr 2019 gegenüber IP-Speichern, eine dedizierte Fabrik für den Datenzugriff, wird durch ein dediziertes IP-Netzwerk ausgeglichen. Es gibt keine globalen Vorteile für FC gegenüber IP-Netzen, und auf IP können Speicherlösungen für jede Laststufe aufgebaut werden, bis hin zu Systemen für leistungsintensive Datenbanken für ABS großer Banken. Auf der anderen Seite wird dem Tod von FC seit Jahren prophezeit, aber immer gibt es Hindernisse. Heute beispielsweise entwickeln einige Marktakteure aktiv den Standard NVMEoF. Ob es FCoE das gleiche Schicksal bescheren wird, wird die Zeit zeigen.
Dateizugriff ist ebenfalls nichts, was die Aufmerksamkeit nicht verdienen würde. NFS / CIFS zeigen sich in produktiven Umgebungen hervorragend, und bei richtiger Planung sind sie nicht mehr zu beanstanden als Blockprotokolle.
Hybride / All Flash Array
Klassische Speicherlösungen gibt es in 2 Arten:
- AFA (All Flash Array) — Systeme, die für den Einsatz von SSDs optimiert sind.
- Hybrid — ermöglichen die Verwendung sowohl von HDDs als auch von SSDs oder deren Kombination.
Der Hauptunterschied besteht in den unterstützten Speichertechnologien und dem maximalen Leistungsniveau (hohe IOPS-Werte und niedrige Latenz). Beide Systeme (außer im Low-End-Segment, das hier nicht betrachtet wird) können sowohl als Blockgeräte als auch als Dateisysteme arbeiten. Der Funktionsumfang hängt vom Systemlevel ab, und bei den einfacheren Modellen ist dieser häufig auf ein Minimum reduziert. Dies sollte beachtet werden, wenn Sie die Eigenschaften eines bestimmten Modells untersuchen, anstatt lediglich die Möglichkeiten der gesamten Produktlinie zu betrachten. Auch die technischen Spezifikationen, wie Prozessor, RAM, Cache, Anzahl und Typen der Ports usw., variieren je nach Systemlevel. Aus Sicht des Managements unterscheiden sich AFA nur in der Implementierung der Mechanismen zur Arbeit mit SSD-Speichern von hybriden (Festplatten-)Systemen, und selbst wenn Sie SSDs in einem hybriden System verwenden, bedeutet dies nicht, dass Sie die Leistung eines AFA-Systems erreichen können. In den meisten Fällen sind außerdem die Inline-Mechanismen für effizientes Speichern in hybriden Systemen deaktiviert, und deren Aktivierung führt zu einem Leistungsabfall.
Spezielle Speicherlösungen
Neben allgemeinen Speicherlösungen, die sich hauptsächlich auf die Echtzeit-Datenverarbeitung konzentrieren, gibt es spezielle Speicherlösungen mit grundlegenden Prinzipien, die sich grundlegend von den gewohnten unterscheiden (niedrige Latenz, viele IOPS):
Medien.
Diese Systeme sind für die Speicherung und Verarbeitung von Mediendateien mit großem Umfang konzipiert. Daher wird die Latenz nahezu unwichtig, während die Fähigkeit, Daten mit einer breiten Bandbreite in vielen parallel verlaufenden Streams zu senden und zu empfangen, in den Vordergrund rückt.
Deduplizierende Speicherlösungen für Backups.
Da Backups in normalen Situationen nur selten einander ähneln (ein durchschnittliches Backup unterscheidet sich nur um 1-2 % von dem vom Vortag), packt diese Klasse von Systemen die gespeicherten Daten äußerst effektiv auf einer vergleichsweise geringen Anzahl physischer Medien. In einigen Fällen können die Kompressionsfaktoren für Daten bis zu 200 zu 1 erreichen.
Objektspeicherlösungen.
In diesen Speichersystemen gibt es keine gewohnten Volumes mit blockweisem Zugriff oder Dateispeichern; sie ähneln vielmehr einer riesigen Datenbank. Der Zugang zu einem Objekt, das in einem solchen System gespeichert ist, erfolgt über eine eindeutige Kennung oder über Metadaten (zum Beispiel alle Objekte im JPEG-Format, mit einem Erstellungsdatum zwischen XX-XX-XXXX und YY-YY-YYYY).
Compliance-Systeme.
Sie sind heute in Russland nicht sehr häufig anzutreffen, aber erwähnenswert. Der Zweck solcher Speichersysteme ist die garantierte Datenspeicherung zur Einhaltung von Sicherheitsrichtlinien oder regulatorischen Anforderungen. In einigen Systemen (wie zum Beispiel EMC Centera) wurde die Funktion implementiert, das Löschen von Daten zu verbieten – sobald der Schlüssel umgedreht wird und das System in diesen Modus wechselt, kann weder der Administrator noch jemand anderes physisch bereits aufgezeichnete Daten löschen.
Markenspezifische Technologien
Flash-Cache
Flash-Cache ist eine allgemeine Bezeichnung für alle markenspezifischen Technologien zur Nutzung von Flash-Speicher als Cache der zweiten Stufe. Bei der Verwendung von Flash-Cache wird das Speichersystem in der Regel für die vorhandene Last von magnetischen Festplatten ausgelegt, während die Spitzenlast von dem Cache bewältigt wird.
Dabei ist es notwendig, das Lastprofil und das Maß der Lokalisation von Anfragen an die Speicherblöcke zu verstehen. Flash-Cache ist eine Technologie für Arbeitslasten mit hoher Lokalisierung von Anfragen und ist nahezu nicht anwendbar für gleichmäßig belastete Volumes (wie beispielsweise bei Analysesystemen).
Auf dem Markt sind zwei Implementierungen von Flash-Cache verfügbar:
- Read Only. In diesem Fall werden nur die zugreifenden Daten zwischengespeichert, während die Schreibvorgänge direkt auf die Festplatten erfolgen. Einige Hersteller, wie beispielsweise NetApp, sind der Meinung, dass die Schreibvorgänge auf ihren Speichersystemen ohnehin optimal erfolgen und der Cache dabei nicht hilfreich ist.
- Read/Write. Es wird nicht nur das Lesen, sondern auch das Schreiben zwischengespeichert, was es ermöglicht, den Datenstrom zu puffern und den RAID-Strafaufwand zu reduzieren, was wiederum die Gesamtleistung für Speichersysteme mit einem weniger optimalen Schreibmechanismus erhöht.
Tiering
Das mehrstufige Speichern (Tiering) ist eine Technologie, bei der Ebenen mit unterschiedlicher Leistung, wie SSD und HDD, in einem einzigen Festplattenspeicherpool zusammengeführt werden. Bei ausgeprägter Unregelmäßigkeit der Zugriffe auf Datenblöcke kann das System automatisch die Datenblöcke ausbalancieren, indem es die stark belasteten auf die leistungsstärkere Ebene verschiebt und die kalten Blöcke umgekehrt auf eine langsamere.
Hybride Systeme der unteren und mittleren Klasse verwenden mehrstufige Speicherung mit einer Datenbewegung nach Zeitplan. Dabei beträgt die Blockgröße der mehrstufigen Speicherung bei den besten Modellen 256 MB. Diese Eigenschaften lassen nicht zu, die Technologie der mehrstufigen Speicherung als technologie zur Leistungssteigerung zu betrachten, wie viele fälschlicherweise annehmen. Die mehrstufige Speicherung in Systemen der unteren und mittleren Klasse ist eine Technologie zur Optimierung der Speicherkosten für Systeme mit ausgeprägter ungleichmäßiger Last.
Snapshot
So sehr wir auch über die Zuverlässigkeit von Speichersystemen sprechen, gibt es zahlreiche Möglichkeiten, Daten zu verlieren, die nicht von Hardwareproblemen abhängig sind. Dazu können Viren, Hacker oder auch unbeabsichtigtes Löschen/Verändern von Daten gehören. Aus diesem Grund ist die Sicherung von Produktionsdaten ein wesentlicher Bestandteil der Arbeit eines Ingenieurs.
Ein Snapshot ist ein Abbild eines Volumes zu einem bestimmten Zeitpunkt. Bei der Arbeit mit den meisten Systemen, wie Virtualisierung, Datenbanken usw., müssen wir einen solchen Snapshot erstellen, aus dem wir Daten für die Sicherung kopieren, während unsere Informationssysteme weiterhin mit diesem Volume arbeiten können. Es ist jedoch zu beachten, dass nicht alle Snapshots gleichermaßen nützlich sind. Verschiedene Anbieter haben unterschiedliche Ansätze zur Erstellung von Snapshots, die mit ihrer Architektur verbunden sind.
CoW (Copy-On-Write). Bei dem Versuch, einen Datenblock zu schreiben, wird der originale Inhalt in einen speziellen Bereich kopiert, bevor die Schreiboperation normal durchgeführt wird. Dadurch wird eine Beschädigung der Daten innerhalb des Snapshots verhindert. Natürlich führen all diese „parasitären“ Manipulationen mit den Daten zu einer zusätzlichen Belastung des Speichersystems und aus diesem Grund empfehlen Anbieter mit dieser Implementierung, nicht mehr als zehn Snapshots zu verwenden, und auf stark belasteten Volumes sollten sie überhaupt nicht verwendet werden.
RoW (Redirect-on-Write). In diesem Fall wird das ursprüngliche Volume natürlich eingefroren, und beim Versuch, einen Datenblock zu schreiben, schreibt das Speichersystem die Daten in einen speziellen Bereich im freien Speicher, wodurch die Position dieses Blocks in der Metadaten-Tabelle geändert wird. Dies trägt dazu bei, die Anzahl der Schreibvorgänge zu reduzieren, wodurch letztendlich Leistungseinbußen ausgeglichen und Einschränkungen für Snapshots und deren Anzahl aufgehoben werden.
Snapshots können auch in zwei Typen in Bezug auf Anwendungen unterteilt werden:
Application consistent. Zum Zeitpunkt der Erstellung des Snapshots fordert das Speichersystem den Agenten im Betriebssystem des Clients auf, der gezwungen wird, die Datencaches aus dem Speicher auf die Festplatte zu entladen und sicherzustellen, dass die Anwendung dies ebenfalls tut. In diesem Fall werden die Daten beim Wiederherstellen aus dem Snapshot konsistent sein.
Crash consistent. In diesem Fall passiert nichts Derartiges und der Snapshot wird so erstellt, wie er ist. Bei der Wiederherstellung aus einem solchen Snapshot ist das Bild identisch, als ob plötzlich die Stromversorgung unterbrochen worden wäre, und es kann zu einem gewissen Datenverlust kommen, die in Caches hängen geblieben sind und nicht auf die Festplatte gelangt sind. Solche Snapshots sind einfacher umzusetzen und verursachen keinen Leistungsabfall in den Anwendungen, sind jedoch weniger zuverlässig.
Warum sind Snapshots in Datenspeichersystemen notwendig?
- Agentenfreies Backup direkt vom SAN
- Erstellung von Testumgebungen basierend auf echten Daten
- Im Fall von Dateispeichersystemen kann es verwendet werden, um VDI-Umgebungen durch die Verwendung von SAN-Snapshots anstelle eines Hypervisors zu erstellen.
- Gewährleistung niedriger RPO durch das Erstellen von Snapshots nach einem Zeitplan mit einer Frequenz, die deutlich höher ist als die Backup-Frequenz.
Klonen
Das Klonen eines Volumes funktioniert nach einem ähnlichen Prinzip wie Snapshots, dient jedoch nicht nur dem Lesen von Daten, sondern auch der vollwertigen Nutzung derselben. Wir haben die Möglichkeit, eine exakte Kopie unseres Volumes mit allen Daten darauf zu erhalten, ohne eine physische Kopie zu erstellen, was Speicherplatz spart. Normalerweise wird das Klonen von Volumes entweder für Test & Entwicklung oder für die Überprüfung der Funktionsfähigkeit von Updates in Ihrem IS verwendet. Klonen ermöglicht es, dies so schnell und ressourcenschonend wie möglich zu tun, da nur die geänderten Datenblöcke aufgezeichnet werden.
Replikation / Journaling
Replikation ist ein Mechanismus zur Erstellung einer Kopie von Daten auf einem anderen physischen SAN. Normalerweise gibt es eine proprietäre Technologie bei jedem Anbieter, die nur innerhalb ihrer eigenen Produktlinie funktioniert. Es gibt jedoch auch Drittanbieter-Lösungen, die auf Hypervisorebene arbeiten, wie beispielsweise VMware vSphere Replication.
Die Funktionalität proprietärer Technologien und die Benutzerfreundlichkeit übertreffen in der Regel stark universelle Lösungen, sind jedoch nicht anwendbar, wenn zum Beispiel eine Replikation von NetApp auf HP MSA erforderlich ist.
Replikation wird in zwei Unterkategorien unterteilt:
Synchron. Bei synchroner Replikation wird der Schreibvorgang sofort auf das zweite Storage-System (SCSI) übertragen und die Ausführung wird nicht bestätigt, bis das entfernte SCSI bestätigt. Dadurch steigt die Zugriffsverzögerung, aber wir haben eine exakte Spiegelkopie der Daten. D.h. RPO = 0 im Falle eines Ausfalls des primären SCSI.
Asynchron. Schreibvorgänge werden nur auf dem primären SCSI ausgeführt und sofort bestätigt, während sie parallel im Puffer für die batchweise Übertragung auf das entfernte SCSI gespeichert werden. Diese Art der Replikation ist für weniger wertvolle Daten oder für Verbindungen mit geringer Bandbreite oder hoher Verzögerung geeignet (typisch für Distanzen über 100 km). Dementsprechend entspricht RPO der Häufigkeit der batchweisen Übertragung.
Oftmals gibt es zusammen mit der Replikation einen Mechanismus für das Journaling von Festplattenoperationen. In diesem Fall wird ein spezieller Bereich für das Journaling reserviert, in dem Schreibvorgänge bis zu einer bestimmten Tiefe im zeitlichen Verlauf oder nach der Größe des Journals gespeichert werden. Für bestimmte proprietäre Technologien, wie z.B. EMC RecoverPoint, gibt es eine Integration mit der Systemsoftware, die es ermöglicht, bestimmte Markierungen mit einem bestimmten Eintrag im Journal zu verknüpfen. Dadurch ist es möglich, den Zustand des Volumes (oder einen Klon zu erstellen) nicht nur auf den 23. April um 11 Uhr 59 Minuten 13 Millisekunden, sondern zu einem Zeitpunkt vor „DROP ALL TABLES; COMMIT“ zurückzusetzen.
Metro-Cluster
Ein Metro-Cluster ist eine Technologie, die eine bidirektionale synchrone Replikation zwischen zwei SCSI ermöglicht, sodass diese PAAR-Seite wie ein einziges SCSI aussieht. Sie wird verwendet, um Cluster mit geografisch verteilten Standorten über Metro-Distanzen (weniger als 100 km) zu erstellen.
Am Beispiel der Nutzung in einer Virtualisierungsumgebung ermöglicht es der Metro-Cluster, einen Datenspeicher mit virtuellen Maschinen zu erstellen, der sofort aus zwei Rechenzentren beschreibbar ist. In diesem Fall wird ein Cluster auf Hypervisor-Ebene erstellt, der aus Hosts in verschiedenen physischen Rechenzentren besteht, die mit diesem Datenspeicher verbunden sind. Dadurch wird Folgendes ermöglicht:
- Vollständige Automatisierung des Wiederherstellungsprozesses nach dem Ausfall eines der Rechenzentren. Ohne zusätzliche Mittel werden alle VMs, die im ausgefallenen Rechenzentrum arbeiteten, automatisch im verbleibenden neu gestartet. RTO = Ausfallzeit des Clusters für hohe Verfügbarkeit (15 Sekunden für VMware) + Bootzeit des Betriebssystems und Start der Dienste.
- Disaster Avoidance oder, auf Russisch, Vermeidung von Katastrophen. Wenn Wartungsarbeiten an der Stromversorgung im Rechenzentrum 1 geplant sind, haben wir die Möglichkeit, die gesamte wichtige Last vor Beginn der Arbeiten nonstop in das Rechenzentrum 2 zu migrieren.
Virtualisierung
Virtualisierung von SAN — das technische Konzept der Nutzung von Volumes eines anderen SAN als Festplatten. Der SAN-Virtualisierer kann einfach ein fremdes Volume an den Verbraucher weiterleiten, während es gleichzeitig auf ein weiteres SAN gespiegelt wird, oder sogar ein RAID aus externen Volumes erstellen.
Klassische Vertreter im Bereich der SAN-Virtualisierung sind EMC VPLEX und IBM SVC. Und natürlich SANs mit Virtualisierungsfunktion — NetApp, Hitachi, IBM / Lenovo Storwize.
Wozu kann das benötigt werden?
- Reservierung auf der SAN-Ebene. Es wird ein Spiegel zwischen Volumes erstellt, wobei die eine Hälfte auf HP 3Par und die andere auf NetApp liegen kann. Und der Virtualisierer von EMC.
- Datenmigration mit minimaler Ausfallzeit zwischen SAN verschiedener Hersteller. Angenommen, die Daten müssen von einem alten 3Par, das außer Betrieb genommen wird, auf einen neuen Dell migriert werden. In diesem Fall werden die Verbraucher von 3Par getrennt, die Volumes werden über VPLEX neu zugewiesen und den Verbrauchern erneut präsentiert. Da sich an dem Volume nichts geändert hat, läuft die Arbeit weiter. Im Hintergrund wird der Spiegelungsprozess auf den neuen Dell gestartet, und nach Abschluss wird der Spiegel aufgelöst und 3Par abgeschaltet.
- Organisation von Metroclustern.
Kompression / Deduplication
Kompression und Deduplication — das sind Technologien, die Ihnen helfen, Speicherplatz auf Ihrem SAN zu sparen. Zu erwähnen ist, dass nicht alle Daten prinzipiell für Kompression und / oder Deduplication geeignet sind, wobei einige Datentypen besser komprimiert und dedupliziert werden als andere.
Kompression und Deduplication kommen in 2 Varianten vor:
Inline — Die Kompression und Deduplizierung von Datenblöcken erfolgt, bevor diese Daten auf die Festplatte geschrieben werden. So berechnet das System nur den Hash des Blocks und vergleicht ihn mit der bereits vorhandenen Tabelle. Erstens geschieht dies schneller als das bloße Schreiben auf die Festplatte, und zweitens verbrauchen wir keinen unnötigen Speicherplatz.
Post — wenn diese Operationen bereits auf den gespeicherten Daten durchgeführt werden, die sich auf den Festplatten befinden. Entsprechend werden die Daten zunächst auf die Festplatte geschrieben, und erst dann wird der Hash berechnet und es erfolgt die Löschung redundanter Blöcke und die Freigabe von Speicherressourcen.
Es ist zu erwähnen, dass die meisten Anbieter beide Arten verwenden, was es ermöglicht, diese Prozesse zu optimieren und damit ihre Effizienz zu steigern. Die meisten Anbieter von Speichersystemen bieten Tools an, mit denen Sie Ihre Datensätze analysieren können. Diese Tools arbeiten nach derselben Logik, die auch in den Speichersystemen implementiert ist, sodass das geschätzte Effizienzniveau übereinstimmen wird. Außerdem sollte nicht vergessen werden, dass viele Anbieter Programme zur Effizienzg Garantie anbieten, die versprechen, dass das Niveau für bestimmte (oder alle) Datentypen nicht unter dem angegebenen liegt. Es wäre unklug, dieses Programm zu ignorieren, denn wenn man das System auf die eigenen Anforderungen unter Berücksichtigung des Effizienzzuflusses des spezifischen Systems konzipiert, kann man bei der Kapazität sparen. Zudem sollte man bedenken, dass diese Programme für AFA-Systeme ausgelegt sind, jedoch durch den Kauf eines kleineren Volumens an SSD im Vergleich zu HDD in klassischen Systemen die Kosten gesenkt werden können, sodass man, auch wenn man nicht die Kosten einer Speichersystemlösung erreicht, ihnen doch erheblich näher kommen kann.
Modell
Und hier kommen wir zu der richtig gestellten Frage.
„Hier werden mir zwei Optionen für Speichersysteme angeboten – ABC SuperStorage S600 und XYZ HyperOcean 666v4, was raten Sie?“
Verwandelt sich in „Hier werden mir zwei Optionen für Speichersysteme angeboten – ABC SuperStorage S600 und XYZ HyperOcean 666v4, was raten Sie?
Die Zielanwendung sind gemischte virtuelle Maschinen VMware aus Produktions- / Test- / Entwicklungsumgebungen. Test = Produktion. 150 TB für jede mit einer Spitzenleistung von 80.000 IOPS bei 8-kb-Blöcken mit 50 % zufälligen Zugriffen und 80/20 Lese-/Schreibverhältnissen. 300 TB für die Entwicklung, dort reichen 50.000 IOPS aus, 80 % zufällig, 80 % Schreiben.
Produktion voraussichtlich im Metrocluster RPO = 15 Minuten RTO = 1 Stunde, Entwicklung in asynchroner Replikation RPO = 3 Stunden, Test an einem Standort.
Es wird 50TB DBMS geben, eine Protokollierung wäre für sie nicht schlecht.
Wir haben überall Dell-Server, die alten Hitachi-Speichersysteme kommen kaum mit der geplanten 50%-Steigerung der Last in Bezug auf Volumen und Leistung zurecht.
Wie man sagt, die richtige Formulierung der Frage enthält 80% der Antwort.
Zusätzliche Informationen
Was sollten die Autoren zufolge zusätzlich betrachtet werden?
Bücher
- Olifer und Olifer „Computernetzwerke“. Das Buch hilft, zu systematisieren und möglicherweise besser zu verstehen, wie die Datenübertragungsumgebung für IP / Ethernet-Speichersysteme funktioniert.
- „EMC Information Storage and Management“. Ein hervorragendes Buch zu den Grundlagen von Speichersystemen, warum, wie und weshalb.
Foren und Chats
Allgemeine Empfehlungen
Preise
Nun, was die Preise angeht – bei Speichersystemen findet man, wenn überhaupt, in der Regel nur Listenpreise, von denen jeder Kunde einen individuellen Rabatt erhält. Die Höhe des Rabatts setzt sich aus einer Vielzahl von Parametern zusammen, sodass es einfach unmöglich ist, vorherzusagen, welchen Endpreis genau Ihr Unternehmen ohne Anfrage beim Distributor erhält. In letzter Zeit sind jedoch Low-End-Modelle in normalen Computerläden aufgetaucht, wie zum Beispiel oder . Dort kann man sofort das gewünschte System zu einem festgelegten Preis, wie jede Computerkomponente, erwerben.
Ich möchte jedoch gleich darauf hinweisen, dass ein direkter Vergleich nach TB/$ nicht korrekt ist. Betrachtet man dies aus dieser Perspektive, wäre die kostengünstigste Lösung ein einfaches JBOD + Server, was jedoch weder die Flexibilität noch die Zuverlässigkeit bietet, die ein vollwertiges, dual-controller Speichersystem gewährleistet. Das bedeutet nicht, dass JBOD die schlechteste Wahl ist; man muss einfach sehr genau verstehen, wie und für welche Zwecke man diese Lösung verwenden wird. Oft hört man, dass es in einem JBOD nichts gibt, was kaputt gehen kann, da es nur ein Backplane ist. Aber auch Backplanes können ausfallen. Alles geht irgendwann kaputt.
Insgesamt
Systeme sollten nicht nur nach Preis oder nur nach Leistung miteinander verglichen werden, sondern nach einer Gesamtheit aller Parameter.
Kaufen Sie HDDs nur, wenn Sie sich sicher sind, dass Sie HDDs benötigen. Für niedrige Lasten und nicht komprimierbare Datentypen lohnt es sich, auf die Speichereffizienzgarantien von SSDs zu achten, die derzeit von den meisten Anbietern angeboten werden (und sie funktionieren tatsächlich, sogar in Russland), aber alles hängt von den Anwendungen und Daten ab, die auf diesem Speicherbereich liegen werden.
Jagen Sie nicht nach der Billigkeit. Manchmal verbergen sich darunter viele unangenehme Aspekte, einer davon wurde von Jewgeni Elizarov in seinen Artikeln über . Und was letztendlich aus dieser Billigkeit für Sie herauskommen kann. Vergessen Sie nicht — "der Geizige zahlt zweimal."
Quelle: habr.com
