

Es heißt, im Leben sollte man alles mindestens einmal ausprobieren. Und wenn Sie daran gewöhnt sind, mit relationalen DBMS zu arbeiten, dann ist es besonders für die allgemeine Entwicklung sinnvoll, sich praktisch mit NoSQL vertraut zu machen. Aufgrund der schnellen Entwicklung dieser Technologie gibt es viele kontroverse Meinungen und hitzige Debatten zu diesem Thema, was das Interesse daran besonders anheizt.
Wenn man sich mit dem Wesen all dieser Debatten beschäftigt, erkennt man, dass sie aus falscher Herangehensweise entstehen. Diejenigen, die NoSQL-Datenbanken genau dort einsetzen, wo sie benötigt werden, sind zufrieden und nutzen alle Vorteile dieser Lösung. Experimentatoren, die auf diese Technologie als Panazee an Orten setzen, wo sie überhaupt nicht anwendbar ist, erleben hingegen Enttäuschungen, da sie die Stärken relationaler Datenbanken verlieren, ohne dafür nennenswerte Vorteile zu gewinnen.
Ich werde über unsere Erfahrungen mit der Implementierung einer Lösung berichten, die auf der DBMS Cassandra basiert: Mit welchen Herausforderungen wir konfrontiert wurden, wie wir aus schwierigen Situationen herausgekommen sind, ob es uns gelungen ist, Vorteile durch die Nutzung von NoSQL zu erzielen und wo wir zusätzliche Anstrengungen/Mittel investieren mussten.
Die ursprüngliche Aufgabe besteht darin, ein System zu schaffen, das Anrufe in einem bestimmten Speicher aufzeichnet.
Das Prinzip des Systems funktioniert folgendermaßen: Eingehende Dateien haben eine bestimmte Struktur, die den Anruf beschreibt. Die Anwendung sorgt dann dafür, dass diese Struktur in die entsprechenden Spalten gespeichert wird. Später werden die gespeicherten Anrufe genutzt – zur Anzeige der Informationen über den Datenverbrauch der Abonnenten (Belastungen, Anrufe, Verlaufsinformationen zum Konto).
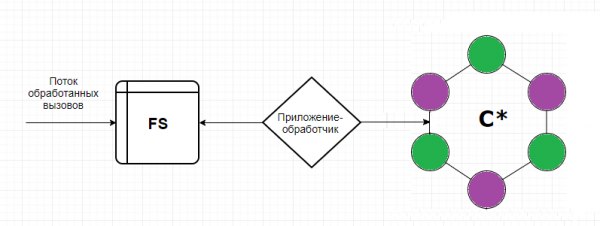
Warum wir uns für Cassandra entschieden haben, ist vollkommen nachvollziehbar — sie schreibt wie ein Maschinengewehr, ist leicht skalierbar und ausfallsicher.
So, das hat uns die Erfahrung geschenkt
Ja, ein ausgefallener Knoten ist keine Tragödie. Darin liegt die Essenz der Ausfallsicherheit von Cassandra. Aber ein Knoten kann aktiv sein und trotzdem in der Leistung nachlassen. Wie sich herausstellte, wirkt sich das sofort auf die Leistung des gesamten Clusters aus.
Cassandra wird dort nicht absichern, wo Oracle mit seinen Constraints geholfen hat. Und wenn der Autor der Anwendung das im Voraus nicht verstanden hat, ist das eingegangene Duplikat für Cassandra nicht schlechter als das Original. Wenn es bereits angekommen ist, fügen wir es einfach ein.
Die kostenlose Cassandra „out of the box“ hat der IKT schlagartig nicht gefallen: Es gibt keine Protokollierung von Benutzeraktionen, auch keine Rechteeinschränkungen.. Informationen über Anrufe gelten als personenbezogene Daten, was bedeutet, dass alle Versuche, diese in irgendeiner Weise anzufordern oder zu ändern, protokolliert werden müssen, um später geprüft zu werden. Außerdem muss man sich der Notwendigkeit bewusst sein, die Rechte auf verschiedene Ebenen für unterschiedliche Benutzer zu trennen. Ein einfacher Betriebstechniker und ein Superadministrator, der problemlos den gesamten Keyspace löschen kann, sind unterschiedliche Rollen mit unterschiedlicher Verantwortung und Kompetenz. Ohne diese Rechteeinschränkung wird der Wert und die Integrität der Daten schneller in Frage gestellt als bei einem Konsistenzlevel von ANY.
Wir haben nicht berücksichtigt, dass für Anrufe sowohl ernsthafte Analysen als auch regelmäßige Abfragen unter verschiedenen Bedingungen erforderlich sind. Da die gewählten Datensätze später gelöscht und überschrieben werden sollen (im Rahmen der Aufgabe müssen wir den Prozess der Datenaktualisierung unterstützen, wenn uns von Anfang an falsche Daten zugeführt wurden), ist Cassandra hierfür nicht geeignet. Cassandra ist wie ein Sparschwein – man kann bequem Dinge hineingeben, aber man kann nicht darin zählen.
Wir haben ein Problem mit der Datenmigration in Testumgebungen. (5 Knoten im Test gegenüber 20 in der Produktion). In solch einem Fall kann kein Dump verwendet werden.
Das Problem mit den Aktualisierungen des Datenbankschemas der Anwendung, die in Cassandra schreibt. Ein Rollback würde eine große Anzahl an Tombstones erzeugen, was auf unvorhersehbare Weise die Leistung beeinträchtigen kann.. Cassandra ist für das Schreiben optimiert und denkt vor dem Schreiben nicht viel nach. Jede Operation mit bestehenden Daten darin ist ebenfalls ein Schreibvorgang. Das heißt, wenn wir Überflüssiges löschen, erzeugen wir einfach noch mehr Datensätze, und nur ein Teil davon wird mit Tombstones markiert.
Timeouts beim Einfügen. Cassandra ist beim Schreiben großartig, aber manchmal kann der eingehende Datenstrom sie erheblich verwirren.. Dies geschieht, wenn die Anwendung beginnt, mehrere Datensätze im Kreis zu befördern, die aus irgendeinem Grund nicht eingefügt werden können. Und wir benötigen einen echten DBA, der die gc.log, die System- und Debug-Logs auf langsame Abfragen und Metriken zum Kompaktieren überwacht.
Mehrere Rechenzentren im Cluster. Woher lesen und wohin schreiben?
Kann man vielleicht zwischen Lesen und Schreiben unterscheiden? Und wenn ja, sollte sich der DC zum Schreiben oder Lesen näher an der Anwendung befinden? Und wird es nicht zu einem echten Split-Brain kommen, wenn wir den falschen Konsistenzgrad wählen? Es gibt viele Fragen, viele unerforschte Einstellungen und Optionen, die wir so gerne ausprobieren würden.
Wie wir das gelöst haben
Um zu verhindern, dass der Knoten eingestürzt, haben wir SWAP deaktiviert.. Und jetzt sollte der Knoten bei Gedächtnismangel ausfallen und keine langen gc-Pausen erzeugen.
Also setzen wir nicht mehr auf die Logik in der Datenbank. Die Entwickler der Anwendung erlernen neue Strategien und fangen an, in ihrem eigenen Code aktiv Vorsichtsmaßnahmen zu treffen. Eine ideale klare Trennung von Speicherung und Verarbeitung der Daten.
Wir haben Unterstützung von DataStax gekauft. Die Box-Version von Cassandra wird nicht mehr weiterentwickelt (der letzte Commit war im Februar 2018). Gleichzeitig bietet Datastax einen hervorragenden Service und eine große Anzahl von überarbeiteten und an bestehende IS-Lösungen angepassten Lösungen an.
Ich möchte auch hervorheben, dass Cassandra nicht besonders benutzerfreundlich für Abfragen ist. Natürlich ist CQL ein großer Schritt in Richtung Benutzerfreundlichkeit (im Vergleich zu Trift). Aber wenn man ganze Abteilungen hat, die an solch bequemen Joins, freier Filterung nach jedem Feld und Möglichkeiten zur Optimierung der Abfrage gewöhnt sind und diese Abteilungen daran arbeiten, Ansprüche und Notfälle zu bewältigen, dann erscheint ihnen die Entscheidung für Cassandra feindlich und dumm. Und wir begannen, das Problem zu lösen, wie unsere Kollegen Abfragen durchführen können.
Wir haben zwei Optionen betrachtet. In der ersten Option schreiben wir die Aufrufe nicht nur in C*, sondern auch in die Archivdatenbank Oracle. Aber im Gegensatz zu C* werden in dieser Datenbank nur die Aufrufe des aktuellen Monats gespeichert (eine ausreichende Speichertiefe für Re-Rate-Fälle). Hier zeigte sich sofort das nächste Problem: Wenn wir synchron schreiben, verlieren wir alle Vorteile von C*, die mit schneller Einfügung verbunden sind; bei asynchronem Schreiben gibt es keine Garantie, dass alle benötigten Aufrufe überhaupt in Oracle gelangen. Es gab jedoch einen großen Vorteil: Für die Nutzung bleibt der gewohnte PL/SQL Developer, d.h. wir setzen praktisch das Muster „Fassade“ um. Alternative Option: Wir implementieren einen Mechanismus, der die Aufrufe aus C* ausgibt, einige Daten zur Anreicherung aus den entsprechenden Tabellen in Oracle zieht, die erhaltenen Abfragen zusammenführt und uns das Ergebnis liefert, das wir danach in irgendeiner Weise verwenden (rückgängig machen, wiederholen, analysieren, bewundern). Nachteile: Der Prozess stellt sich als ziemlich mehrstufig heraus und zudem fehlt eine Schnittstelle für die Mitarbeiter im Betrieb.
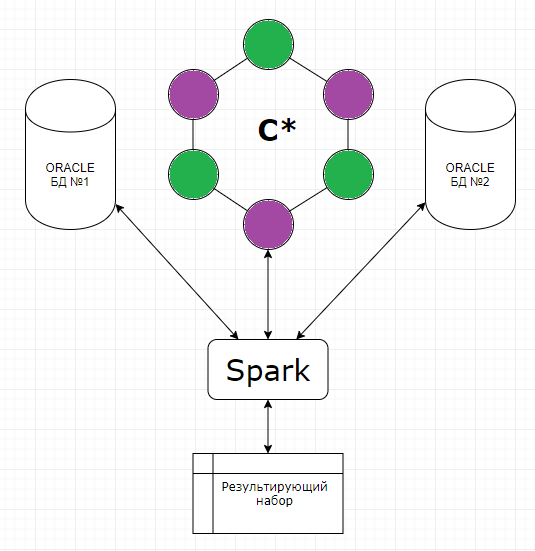
Letztendlich haben wir uns doch für die zweite Option entschieden. Für die Abfragen aus verschiedenen Datenbanken haben wir Apache Spark verwendet. Der Kernmechanismus bestand aus Java-Code, der anhand der angegebenen Schlüssel (Abonnent, Zeitpunkt des Anrufs – Schlüssel des Abschnitts) Daten aus C* abruft sowie die benötigten Daten für die Anreicherung aus einer anderen Datenbank. Danach hat er sie im Speicher zusammengeführt und das Ergebnis in eine Ergebnistabelle ausgegeben. Über Spark haben wir eine Web-Oberfläche erstellt, die ganz gut für den Betrieb geeignet ist.
Bei der Lösung des Problems mit der Datenaktualisierung hat das Team erneut mehrere Lösungsansätze in Betracht gezogen. Sowohl die Übertragung über Sstloader als auch die Möglichkeit, den Cluster im Testbereich in zwei Teile zu splitten, von denen jeder abwechselnd mit einem Cluster mit produktiven Daten verbunden wird, wodurch er sich somit von diesem speist. Bei der Aktualisierung des Tests war geplant, die beiden Teile zu tauschen: der Teil, der im Test gearbeitet hat, wird gelöscht und in die Produktion eingegeben, während der andere mit den Daten separat beginnt. Nachdem wir jedoch noch einmal darüber nachgedacht haben, bewerteten wir die Daten, die übertragen werden sollten, als rationaler und erkannten, dass die Anfragen an sich eine inkonsistente Entität für Tests sind, die im Bedarfsfall schnell erzeugt werden und dass der produktive Datensatz keinen Wert für die Übertragung in den Test hat. Es gibt einige Speicherobjekte, die es wert sind, übertragen zu werden, aber es sind buchstäblich nur ein paar Tabellen, die zudem nicht sehr schwer sind. Daher kam als Lösung erneut Spark zur Hilfe, mit dem wir ein Skript zur Datenübertragung zwischen den Tabellen von Produktion und Test erstellt und aktiv verwendet haben.
Unsere aktuelle Deployment-Politik erlaubt es uns, ohne Rollbacks zu arbeiten. Vor der Produktion erfolgt stets ein obligatorisches Rollout im Test, wo Fehler nicht so kostspielig sind. Im Falle eines Misserfolgs kann man immer den Keyspace löschen und das gesamte Schema von Anfang an neu aufspielen.
Um die kontinuierliche Verfügbarkeit von Cassandra sicherzustellen, wird ein Database Administrator benötigt, und das ist nicht alles. Alle, die mit der Anwendung arbeiten, müssen verstehen, wo und wie sie die aktuelle Situation überwachen und Probleme rechtzeitig diagnostizieren können. Zu diesem Zweck nutzen wir aktiv DataStax OpsCenter (Verwaltung und Überwachung von Workloads), die systemmetrischen Daten des Cassandra Drivers (Anzahl der Zeitüberschreitungen beim Schreiben in C*, Anzahl der Zeitüberschreitungen beim Lesen aus C*, maximale Latenz usw.), und überwachen die Funktionalität der Anwendung, die mit Cassandra arbeitet.
Als wir über die vorherige Frage nachdachten, erkannten wir, wo das Haupt risiko verborgen sein könnte. Es handelt sich um die Formen der Datenanzeige, die Daten aus mehreren voneinander unabhängigen Abfragen an das Speichersystem abrufen. Dadurch können wir recht inkonsistente Informationen erhalten. Aber dieses Problem wäre ebenso relevant, wenn wir nur mit einem Rechenzentrum arbeiten würden. Daher ist es hier am sinnvollsten, eine Batch-Lese operation in einer externen Anwendung zu erstellen, die die Daten zu einem einheitlichen Zeitpunkt abruft. Was die Trennung von Lese- und Schreibvorgängen hinsichtlich der Leistung betrifft, so hielt uns hier das Risiko davon ab, dass wir bei einem gewissen Verlust der Verbindung zwischen den Rechenzentren zwei völlig inkonsistente Cluster erhalten könnten.
Insgesamt sind wir derzeit auf einer Konsistenzebene für die Schreiboperationen von EACH_QUORUM und für die Lesevorgänge von LOCAL_QUORUM stehen geblieben.
Kurze Eindrücke und Schlussfolgerungen
Um die entstandene Lösung hinsichtlich des operativen Supports und der Perspektiven für die weitere Entwicklung zu bewerten, haben wir überlegt, wo diese Entwicklung noch angewendet werden kann.
Zur schnellen Erwähnung könnten Daten-Scoring für Programme wie „Zahle, wann es dir passt“ (Laden von Informationen in C*, Berechnungen auf Spark-Skripten), die Erfassung von Reklamationen mit Aggregation nach Richtungen, die Speicherung von Rollen und die Berechnung nach der Rollenmatrix von Benutzerzugriffsrechten sein.
Wie wir sehen, ist das Repertoire breit und vielfältig. Und wenn wir im Lager der Befürworter/Gegner von NoSQL wählen müssten, würden wir uns den Befürwortern anschließen, da wir die Vorteile erhalten haben, genau dort, wo wir es erwartet hatten.
Sogar die Cassandra-Standardlösung ermöglicht eine horizontale Skalierung in Echtzeit, wobei das Problem der Datenwachstums im System völlig schmerzlos gelöst wird. Uns ist es gelungen, einen sehr stark belasteten Mechanismus zur Berechnung von Aggregaten basierend auf Anrufen in einen separaten Kontur zu extrahieren und gleichzeitig das Schema und die Logik der Anwendung zu teilen, indem wir die schädliche Praxis des Schreibens von benutzerdefinierten Jobs und Objekten in der Datenbank aufgegeben haben. Wir haben die Möglichkeit erhalten, auszuwählen und anzupassen, in welchen Rechenzentren wir Berechnungen durchführen und wo wir Daten speichern, und uns bezüglich Ausfällen sowohl einzelner Knoten als auch des gesamten Rechenzentrums abzusichern.
Bei der Anwendung unserer Architektur auf neue Projekte und bereits mit einigem Erfahrung im Gepäck möchten wir die oben beschriebenen Nuancen sofort berücksichtigen und einige Fehler vermeiden, sowie scharfe Kanten entschärfen, die wir anfänglich nicht umgehen konnten.
Zum Beispiel, aktuellen Updates von Cassandra rechtzeitig folgen, denn viele Probleme, die wir gehabt haben, waren bereits bekannt und haben sich als lösbar erwiesen.
Die Datenbank und Spark nicht auf denselben Knoten setzen oder strikte Trennung nach der zulässigen Ressourcennutzung, da Spark mehr RAM konsumieren kann als erlaubt, und wir schnell Problem Nummer 1 auf unserer Liste erhalten würden.
Das Monitoring und die Betriebskompetenz bereits in der Testphase des Projekts zu verbessern. Von Anfang an alle potenziellen Nutzer unserer Lösung maximal berücksichtigen, denn letztendlich wird davon die Struktur der Datenbank abhängen.
Die entstandene Struktur mehrmals auf mögliche Optimierungen überprüfen. Bestimmen, welche Felder serialisiert werden können. Überlegen, welche zusätzlichen Tabellen wir erstellen sollten, um die benötigten Informationen auf die korrekte und optimale Weise zu berücksichtigen und sie dann auf Anfrage bereitzustellen (zum Beispiel, indem wir davon ausgehen, dass wir dieselben Daten in verschiedenen Tabellen speichern können, unter Berücksichtigung unterschiedlicher Aufteilungen nach verschiedenen Kriterien, wodurch wir erheblich CPU-Zeit bei Leseanfragen sparen können).
Nicht schlecht von Anfang an TTL und die Bereinigung veralteter Daten einzuplanen.
Beim Export von Daten aus Cassandra soll die Logik der Anwendung nach dem FETCH-Prinzip arbeiten, damit nicht alle Zeilen auf einmal in den Speicher geladen werden, sondern in Batches ausgewählt werden.
Es ist wünschenswert, vor der Migration des Projekts zu der beschriebenen Lösung die Ausfallsicherheit des Systems zu überprüfen, indem eine Reihe von Stresstests durchgeführt wird, wie etwa Datenverluste in einem Rechenzentrum, die Wiederherstellung beschädigter Daten über einen bestimmten Zeitraum, Netzwerkausfälle zwischen Rechenzentren. Solche Tests ermöglichen es nicht nur, die Vor- und Nachteile der vorgeschlagenen Architektur zu bewerten, sondern bieten auch eine gute Aufwärmpraxis für die Ingenieure, die sie durchführen, und die erlernten Fähigkeiten werden nicht überflüssig sein, falls Systemausfälle im Produkt auftreten.
Wenn wir mit kritischen Informationen (wie Daten für die Abrechnung oder die Berechnung von Kundenschulden) arbeiten, sollten wir auch auf Werkzeuge achten, die helfen, die Risiken zu minimieren, die aufgrund der Eigenschaften von DBMS entstehen. Zum Beispiel, nutzen Sie das Tool nodesync (Datastax) und entwickeln Sie eine optimale Strategie für seine Nutzung, um für die Konsistenz keine übermäßige Belastung für Cassandra zu erzeugen. und verwenden Sie es nur für bestimmte Tabellen in bestimmten Zeiträumen.
Wie steht es also seit einem halben Jahr mit Cassandra? Insgesamt gibt es keine ungelösten Probleme. Es gab auch keine ernsthaften Störungen oder Datenverluste. Ja, wir mussten uns Gedanken über die Kompensation einiger zuvor nicht aufgetretener Probleme machen, aber letztlich hat dies unsere architektonische Entscheidung nicht stark getrübt. Wenn Sie bereit sind, etwas Neues auszuprobieren und keine Angst haben, dabei enttäuscht zu werden, sollten Sie sich darauf vorbereiten, dass nichts umsonst ist. Sie müssen mehr recherchieren, sich mit der Dokumentation vertrautmachen und Ihre individuellen Stolpersteine sammeln als bei einer alten Legacy-Lösung, und keine Theorie kann Ihnen im Voraus sagen, welche Stolpersteine genau auf Sie warten.
Quelle: habr.com
