

Hallo, ich heiße Dmitrij Krasnov. Seit mehr als fünf Jahren beschäftige ich mich mit der Verwaltung von Kubernetes-Clustern und dem Aufbau komplexer Mikroservice-Architekturen. Zu Beginn dieses Jahres haben wir einen Service zur Verwaltung von Kubernetes-Clustern auf Basis von Containerum gestartet. Ich möchte die Gelegenheit nutzen, um zu erzählen, was Kubernetes ist und wie sich die Integration mit einem Anbieter von Open Source unterscheidet.
Zunächst, was ist ? Es ist ein System zur Verwaltung von Containern auf vielen Hosts. Übrigens wird es aus dem Griechischen als „Steuermann“ oder „Pilot“ übersetzt. Ursprünglich von Google entwickelt, wurde es dann als technologischer Beitrag an die Cloud Native Computing Foundation übergeben, eine internationale gemeinnützige Organisation, die führende Entwickler, Endbenutzer und Anbieter von ContainTechnologien vereint.
Um viele Container zu steuern,
Jetzt schauen wir uns an, was das für Container sind. Dies sind Anwendungen mit ihrer gesamten Umgebung – hauptsächlich den Bibliotheken, von denen die Programmausführung abhängt. All das ist in Archiven verpackt und liegt in Form eines Abbilds vor, das unabhängig vom Betriebssystem ausgeführt und getestet werden kann. Aber es gibt ein Problem – die Verwaltung von Containern auf vielen Hosts ist sehr schwierig. Deshalb wurde Kubernetes geschaffen.
Ein Containerabbild stellt eine Anwendung plus ihre Abhängigkeiten dar. Die Anwendung, ihre Abhängigkeiten und das Abbild des Dateisystems des Betriebssystems sind in verschiedenen Teilen des Abbilds, den sogenannten Schichten, untergebracht. Schichten können für verschiedene Container wiederverwendet werden. Zum Beispiel kann für alle Anwendungen im Unternehmen die Basisschicht Ubuntu verwendet werden. Beim Starten von Containern ist es nicht notwendig, zahlreiche Kopien einer Basisschicht auf dem Host zu speichern. Dies optimiert die Speicherung und Lieferung von Abbilden.
Wenn wir eine Anwendung aus einem Container starten möchten, stapeln sich die erforderlichen Schichten übereinander und bilden ein Overlay-Dateisystem. Oben wird eine Schreibschicht hinzugefügt, die beim Stoppen des Containers gelöscht wird. Dies stellt sicher, dass die Anwendung beim Starten des Containers immer die gleiche Umgebung hat, die nicht verändert werden kann. Dies gewährleistet die Reproduzierbarkeit der Umgebung auf verschiedenen Host-Betriebssystemen. Egal ob Ubuntu oder CentOS – die Umgebung ist immer gleich. Außerdem ist der Container durch Mechanismen, die in den Linux-Kernel eingebaut sind, vom Host isoliert. Anwendungen im Container sehen die Dateien und Prozesse des Hosts sowie benachbarter Container nicht. Diese Isolation von Anwendungen vom Host-Betriebssystem bietet eine zusätzliche Sicherheitsebene.
Es gibt viele Werkzeuge zur Verwaltung von Containern auf dem Host. Das beliebteste unter ihnen ist Docker. Es ermöglicht den vollständigen Lebenszyklus der Containerverwaltung. Allerdings funktioniert es nur auf einem einzigen Host. Wenn es darum geht, Container auf mehreren Hosts zu verwalten, kann Docker das Leben der Ingenieure zur Hölle machen. Daher wurde Kubernetes geschaffen.
Die Nachfrage nach Kubernetes beruht genau auf der Möglichkeit, Gruppen von Containern auf mehreren Hosts als einheitliche Entitäten zu steuern. Die Beliebtheit des Systems wird durch die Möglichkeit sichergestellt, DevOps oder Development Operations aufzubauen, in denen Kubernetes verwendet wird, um die Prozesse des besagten DevOps zu starten.
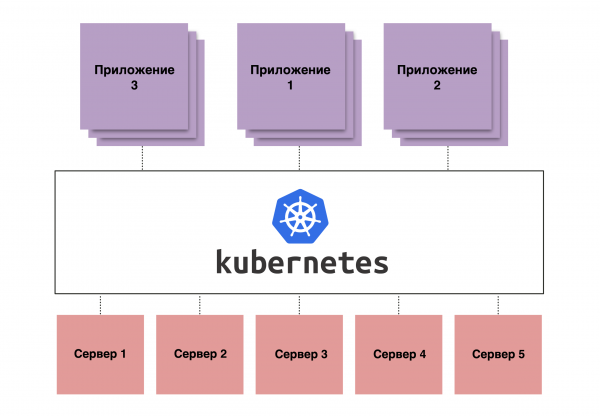
Abbildung 1. Schematische Darstellung des Funktionsprinzips von Kubernetes
Vollständige Automatisierung
DevOps stellt grundsätzlich die Automatisierung des Entwicklungsprozesses dar. Grob gesagt, schreiben Entwickler Code, der in ein Repository hochgeladen wird. Dieser Code kann dann automatisch in einen Container mit allen Bibliotheken gebaut, getestet und in die nächste Phase – Staging – eingesetzt werden, und anschließend direkt auch in die Produktionsumgebung.
Zusammen mit Kubernetes ermöglicht DevOps die Automatisierung dieses Prozesses, sodass er nahezu ohne das Mitwirken der Entwickler selbst abläuft. Dadurch wird der Build-Prozess erheblich beschleunigt, da der Entwickler sich nicht selbst am Computer darum kümmern muss – er schreibt einfach einen Codeabschnitt, pusht diesen in das Repository, woraufhin eine Pipeline gestartet wird, die den Build-, Test- und Deployment-Prozess umfassen kann. Und das geschieht mit jedem Commit, weshalb das Testen kontinuierlich erfolgt.
Die Verwendung von Containern gewährleistet, dass die gesamte Umgebung dieser Anwendung genau in der Form in die Produktion geht, in der sie getestet wurde. Es treten also keine Probleme auf wie "In der Testumgebung waren andere Versionen, in der Produktion andere, und nach dem Deployment ist alles abgestürzt". Da wir heute jedoch einen Trend zur Mikrodienstarchitektur haben, bei dem statt einer großen Anwendung Hunderte von kleinen existieren, wäre es erforderlich, eine große Anzahl von Mitarbeitern zu beschäftigen, um diese manuell zu verwalten. Deshalb nutzen wir Kubernetes.
Vorteile, Vorteile, Vorteile
Wenn wir über die Vorteile von Kubernetes als Plattform sprechen, hat es bedeutende Vorzüge im Hinblick auf das Management von Mikrodienstarchitekturen.
- Verwaltung vieler Replikate. Das wichtigste ist die Verwaltung von Containern auf mehreren Hosts. Noch wichtiger ist die Verwaltung eines großen Kontingents an Anwendungsreplikaten in Containern als einer einzigen Entität. Dadurch müssen sich die Ingenieure nicht um jeden einzelnen Container kümmern. Wenn einer der Container ausfällt, wird Kubernetes dies bemerken und ihn neu starten.
- Cluster-Netzwerk. Kubernetes verfügt auch über ein sogenanntes Cluster-Netzwerk mit einem eigenen Adressraum. Dies ermöglicht es jedem Pod, seine eigene Adresse zu haben. Ein Pod ist die kleinste strukturelle Einheit eines Clusters, in der die Container direkt ausgeführt werden. Darüber hinaus verfügt Kubernetes über Funktionen, die einen Lastenausgleich und eine Service Discovery kombinieren. Dies ermöglicht die Eliminierung der manuellen Verwaltung der IP-Adressen und überträgt diese Aufgabe auf Kubernetes. Automatische Health Checks helfen zudem, Probleme zu entdecken und den Verkehr auf funktionierende Pods umzuleiten.
- Konfigurationsmanagement. Beim Verwalten einer großen Anzahl von Anwendungen wird es schwierig, die Anwendungs-Konfiguration zu steuern. Dafür gibt es in Kubernetes spezielle Ressourcen namens ConfigMaps. Sie ermöglichen die zentrale Speicherung von Konfigurationen und deren Einfügung in Pods beim Start von Anwendungen. Dieser Mechanismus gewährleistet die Konsistenz der Konfiguration, egal ob in zehn oder hundert Replikaten von Anwendungen.
- Persistente Volumes. Container sind von Natur aus unveränderlich und beim Stoppen eines Containers gehen alle Daten, die im Dateisystem gespeichert sind, verloren. Doch einige Anwendungen speichern Daten direkt auf der Festplatte. Um dieses Problem zu lösen, bietet Kubernetes eine Funktion zur Verwaltung des Speicherplatzes – die persistenten Volumes. Dieser Mechanismus nutzt externen Speicher für Daten und kann persistenten Speicher, blockbasiert oder dateibasiert, in Container weiterleiten. Diese Lösung ermöglicht es, Daten getrennt von den Workern zu speichern, was sie bei einem Ausfall dieser Worker schützt.
- Lastenausgleich. Obwohl wir in Kubernetes abstrakte Entitäten wie Deployment, StatefulSet usw. verwalten, werden letztendlich Container auf herkömmlichen virtuellen Maschinen oder physischen Servern gestartet. Diese sind nicht perfekt und können jederzeit ausfallen. Kubernetes erkennt dies und leitet den internen Traffic auf andere Replikate um. Doch was ist mit dem Traffic, der von außen kommt? Wenn der Traffic einfach auf einen der Worker geleitet wird, was passiert, wenn dieser ausfällt? Der Service wäre dann nicht mehr erreichbar. Um dieses Problem zu lösen, gibt es in Kubernetes Dienste wie den Lastenausgleich. Sie sind dafür konzipiert, einen externen Cloud-Lastenausgleich für alle Worker im Cluster automatisch zu konfigurieren. Dieser externe Lastenausgleicher leitet den externen Traffic auf die Worker und überwacht deren Status. Wenn einer oder mehrere Worker nicht mehr verfügbar sind, wird der Traffic auf andere umgeleitet. Dies ermöglicht die Bereitstellung hochverfügbarer Dienste mit Kubernetes.
Kubernetes entfaltet sein volles Potenzial insbesondere beim Einsatz von Mikrodiensten. Es ist möglich, das System in eine klassische Architektur zu integrieren, aber es macht wenig Sinn. Wenn eine Anwendung nicht in mehreren Replikaten arbeiten kann, was ist dann der Unterschied – ob in Kubernetes oder nicht?
Open Source Kubernetes
Open Source Kubernetes – eine großartige Sache: installiert und es funktioniert. Man kann es auf eigenen Servern, in der eigenen Infrastruktur bereitstellen, einen Master und Worker installieren, auf denen alle Anwendungen laufen. Das Beste daran – alles ist kostenlos. Es gibt jedoch einige Nuancen.
- Erstens – die Anforderungen an das Wissen und die Erfahrung von Administratoren und Ingenieuren, die alles bereitstellen und betreuen werden. Da der Kunde vollständige Handlungsfreiheit im Cluster hat, trägt er die Verantwortung für die Funktionsfähigkeit des Clusters selbst. Es ist sehr einfach, hier alles zu brechen.
- Zweitens – das Fehlen von Integrationen. Wenn man Kubernetes ohne eine populäre Virtualisierungsplattform startet, erhält man nicht alle Vorteile des Programms. Dazu gehören die Nutzung von Persistent Volumes und Load Balancer-Diensten.
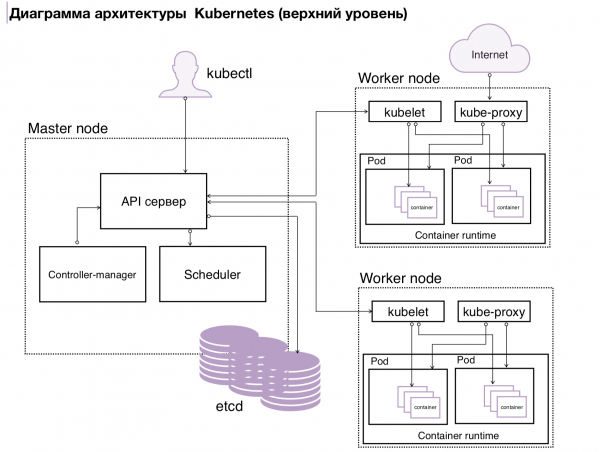
Abbildung 2. Architektur von k8s
Kubernetes vom Anbieter
Die Integration mit einem Cloud-Anbieter bietet zwei Möglichkeiten:
- Erstens kann der Nutzer einfach auf die Schaltfläche „Cluster erstellen“ klicken und ein bereits konfiguriertes und betriebsbereites Cluster erhalten.
- Zweitens installiert der Anbieter selbst das Cluster und konfiguriert die Integration mit der Cloud.
So funktioniert es bei uns. Der Ingenieur, der das Cluster startet, gibt an, wie viele Worker er benötigt und mit welchen Parametern (zum Beispiel 5 Worker, jeder mit 10 CPU, 16 GB RAM und sagen wir 100 GB Speicherplatz). Danach erhält er Zugang zu dem bereits gebildeten Cluster. Dabei werden die Worker, auf denen die Last läuft, vollständig dem Kunden überlassen, während der gesamte Management-Bereich in der Verantwortung des Anbieters bleibt (falls der Dienst im Rahmen eines Managed Services angeboten wird).
Jedoch hat dieses Modell seine Nachteile. Da der Management-Bereich beim Anbieter bleibt, gewährt dieser dem Kunden keinen vollständigen Zugang, was die Flexibilität im Umgang mit Kubernetes verringert. Manchmal möchte der Kunde spezielle Funktionen an Kubernetes anpassen, zum Beispiel die Authentifizierung über LDAP, aber die Konfiguration des Management-Bereichs lässt das nicht zu.
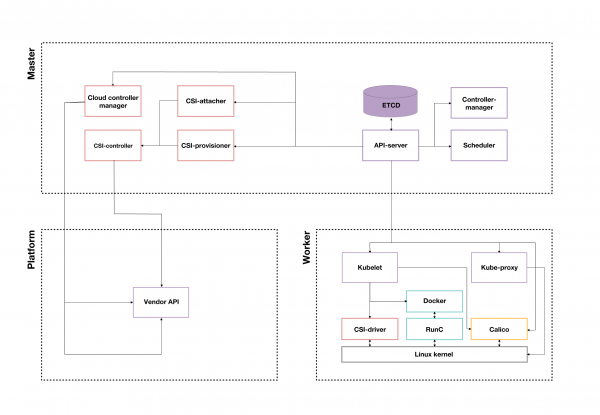
Abbildung 3. Beispiel eines Kubernetes-Clusters eines Cloud-Anbieters
Was wählen: Open Source oder Anbieter-Lösung
Also, Open Source Kubernetes oder vendor-basiert? Bei Open Source Kubernetes kann der Benutzer machen, was er will, aber es besteht ein großes Risiko, sich selbst ins Bein zu schießen. Mit der vendor-basierten Lösung ist es komplizierter, da alles im Unternehmen durchdacht und eingerichtet ist. Der größte Nachteil von Open Source Kubernetes ist der Bedarf an Fachkräften. Bei der vendor-basierten Lösung hat das Unternehmen diesen Kopfzerbruch nicht, muss aber entscheiden: Zahle ich meinen Fachkräften oder dem Anbieter?
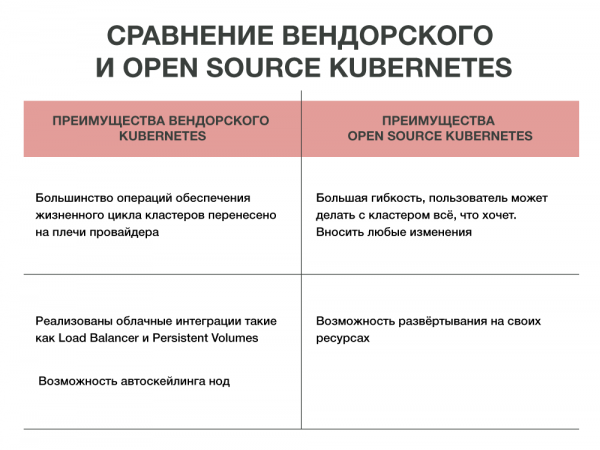
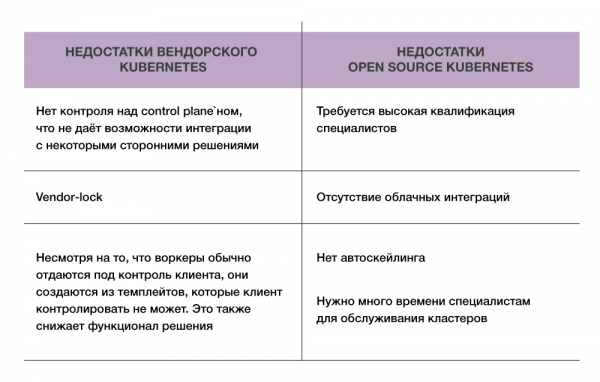
Nun, die Vorteile sind offensichtlich, die Nachteile sind auch bekannt. Eines bleibt unverändert: Kubernetes löst viele Probleme, indem es das Management einer Vielzahl von Containern automatisiert. Welche Wahl jeder treffen sollte, ob Open Source oder vendor-basiert, muss jeder selbst entscheiden.
Der Artikel wurde von Dmitrij Krasnov, dem leitenden Architekten des Containerum-Dienstes des Anbieters #CloudMTS, vorbereitet.
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish