

Quelle:
Lineare Regression ist einer der grundlegenden Algorithmen für viele Bereiche der Datenanalyse. Der Grund dafür ist offensichtlich. Es ist ein sehr einfacher und verständlicher Algorithmus, der seit vielen Jahrzehnten, wenn nicht Jahrhunderten, weit verbreitet ist. Die Idee besteht darin, dass wir eine lineare Abhängigkeit einer Variablen von einer Menge anderer Variablen annehmen und dann versuchen, diese Abhängigkeit zu rekonstruieren.
Aber dieser Artikel handelt nicht von der Anwendung der linearen Regression zur Lösung praktischer Probleme. Hier werden interessante Aspekte der Implementierung verteilter Algorithmen zu ihrer Rekonstruktion betrachtet, mit denen wir beim Schreiben des Moduls für maschinelles Lernen in . Ein wenig Grundmathematik, die Grundlagen des maschinellen Lernens und der verteilten Berechnungen helfen zu verstehen, wie man die lineare Regression rekonstruiert, selbst wenn die Daten über Tausende von Knoten verteilt sind.
Worum geht es?
Vor uns steht die Aufgabe, eine lineare Abhängigkeit zu rekonstruieren. Als Eingabedaten wird eine Menge von Vektoren angeblicher unabhängiger Variablen bereitgestellt, von denen jeder einem bestimmten Wert der abhängigen Variablen zugeordnet wird. Diese Daten können in Form von zwei Matrizen dargestellt werden:

Jetzt, da eine Abhängigkeit angenommen wird, und zudem eine lineare, drücken wir unsere Annahme in Form eines Matrizenprodukts aus (zur Vereinfachung der Darstellung wird hier und im Folgenden angenommen, dass das konstante Glied der Gleichung verborgen ist hinter  , und die letzte Spalte der Matrix
 enthält Einsen):

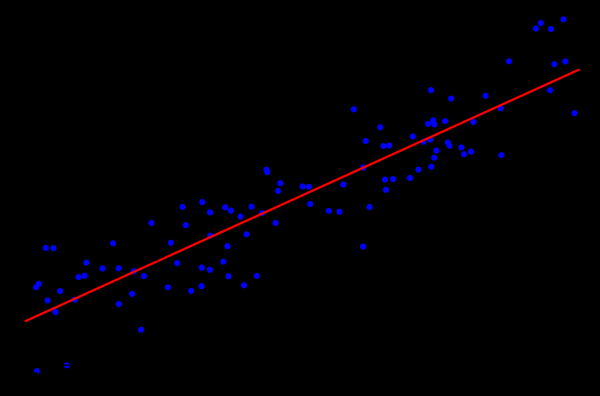
Sieht sehr nach einem System linearer Gleichungen aus, nicht wahr? Es scheint so, aber für ein solches Gleichungssystem wird es wahrscheinlich keine Lösungen geben. Der Grund dafür sind die Störungen, die in praktisch allen realen Daten vorhanden sind. Auch das Fehlen einer linearen Abhängigkeit selbst könnte der Grund sein, gegen die man versuchen kann, durch Einführung zusätzlicher Variablen vorzugehen, die nichtlinear von den Ursprünglichen abhängen. Betrachten wir das folgende Beispiel:
Quelle:
Dies ist ein einfaches Beispiel für lineare Regression, das die Abhängigkeit einer Variablen (auf der Achse  ) von einer anderen Variablen (auf der Achse
 ). Damit das dem Beispiel entsprechende System linearer Gleichungen eine Lösung hat, müssen alle Punkte genau auf einer Linie liegen. Aber das ist nicht der Fall. Und sie liegen nicht auf einer Linie genau wegen des Rauschens (oder weil die Annahme einer linearen Abhängigkeit fehlerhaft war). Um also die lineare Abhängigkeit aus realen Daten wiederherzustellen, ist es normalerweise erforderlich, eine weitere Annahme einzuführen: die Eingabedaten enthalten Rauschen, und dieses Rauschen hat . Man kann auch Annahmen über andere Arten von Rauschverteilungen treffen, aber in den überwiegenden Fällen wird tatsächlich die normale Verteilung betrachtet, über die wir im Folgenden sprechen werden.
Die Maximum-Likelihood-Methode
Also haben wir das Vorhandensein von zufällig normalverteiltem Rauschen angenommen. Was tun wir in einer solchen Situation? Für diesen Fall gibt es in der Mathematik ein weit verbreitetes Konzept. . Kurz gesagt, es besteht darin, und dann diese zu maximieren.
Kehren wir zur Wiederherstellung der linearen Abhängigkeit bei Daten mit normalem Rauschen zurück. Beachten wir, dass die angenommene lineare Abhängigkeit den mathematischen Erwartungswert  der vorhandenen normalen Verteilung darstellt. Gleichzeitig ist die Wahrscheinlichkeit, dass
 einen bestimmten Wert annimmt, unter der Bedingung, dass beobachtbare
 , sieht folgendermaßen aus:

Jetzt setzen wir anstelle von  und
 die benötigten Variablen ein:

Es bleibt nur noch, den Vektor  zu finden, bei dem diese Wahrscheinlichkeit maximal ist. Um eine solche Funktion zu maximieren, ist es praktisch, sie zuerst zu logarithmieren (der Logarithmus der Funktion erreicht sein Maximum an derselben Stelle wie die Funktion selbst):

Was wiederum auf die Minimierung der folgenden Funktion hinausläuft:

Übrigens wird dies als Methode bezeichnet. Oft werden alle vorangegangenen Überlegungen übersprungen und es wird einfach diese Methode verwendet.
QR-Zerlegung
Das Minimum der oben genannten Funktion kann gefunden werden, wenn der Punkt gefunden wird, an dem der Gradient dieser Funktion gleich null ist. Der Gradient wird wie folgt dargestellt:

ist eine matrizenbasierte Methode zur Lösung von Minimierungsproblemen, die in der Methode der kleinsten Quadrate verwendet wird. In diesem Zusammenhang schreiben wir die Gleichung in matrixform um:

Also zerlegen wir die Matrix  in Matrizen
 und
 und führen eine Reihe von Transformationen durch (der Algorithmus der QR-Zerlegung wird hier nicht betrachtet, sondern nur seine Anwendung für die gestellte Aufgabe):

Die Matrix  ist orthogonal. Das ermöglicht es uns, das Produkt zu eliminieren
 :

Wenn wir ersetzen  auf
 , ergibt sich
 . Unter Berücksichtigung, dass
 eine obere Dreiecksmatrix ist, sieht das folgendermaßen aus:

Das kann durch das Ersatzverfahren gelöst werden. Das Element  wird gefunden als
 , das vorhergehende Element
 wird gefunden als
 und so weiter.
Hier sei darauf hingewiesen, dass die Komplexität des erhaltenen Algorithmus durch die Verwendung der QR-Zerlegung gleich ist  . Obwohl die Matrixmultiplikation gut parallelisierbar ist, ist es nicht möglich, eine effektive verteilte Version dieses Algorithmus zu schreiben.
Gradientenabstieg
Wenn wir über die Minimierung einer bestimmten Funktion sprechen, sollte man immer an die Methode (stochastischer) Gradientabstieg denken. Dies ist eine einfache und effektive Methode zur Minimierung, die auf der iterativen Berechnung des Gradienten der Funktion an einem Punkt und der anschließenden Verschiebung in die entgegengesetzte Richtung des Gradienten basiert. Jeder solche Schritt bringt die Lösung näher an das Minimum. Der Gradient sieht dabei wie folgt aus:

Diese Methode lässt sich ebenfalls gut parallelisieren und verteilen aufgrund der linearen Eigenschaften des Gradientenoperators. Beachten Sie, dass in der obigen Formel unter dem Summenzeichen unabhängige Summanden stehen. Mit anderen Worten, wir können den Gradient unabhängig für alle Indizes  von eins bis
 , parallel dazu den Gradient für Indizes von
 bis
 berechnen. Dann summieren wir die erhaltenen Gradienten. Das Ergebnis dieser Summierung wird dasselbe sein, als hätten wir sofort den Gradient für die Indizes von eins bis
 berechnet. Somit, wenn die Daten auf mehrere Datenteile verteilt sind, kann der Gradient unabhängig auf jedem Teil berechnet werden, und die Ergebnisse dieser Berechnungen können dann zusammengefasst werden, um das endgültige Ergebnis zu erhalten:

Aus Implementierungssicht passt dies in das Paradigma . Bei jedem Schritt des Gradientabstiegs wird jedem Dataknoten eine Aufgabe zum Berechnen des Gradienten zugewiesen, dann werden die berechneten Gradienten gesammelt, und das Ergebnis ihrer Summierung wird verwendet, um das Ergebnis zu verbessern.
Trotz der einfachen Implementierung und der Möglichkeit der Ausführung im MapReduce-Paradigma hat der Gradientensprung auch seine Nachteile. Insbesondere ist die Anzahl der Schritte, die zur Erreichung der Konvergenz erforderlich sind, im Vergleich zu anderen, spezialisierteren Methoden erheblich höher.
LSQR
ist eine weitere Methode zur Lösung der gestellten Aufgabe, die sowohl für die Wiederherstellung der linearen Regression als auch zur Lösung von linearen Gleichungssystemen geeignet ist. Ihr Hauptmerkmal besteht darin, dass sie die Vorteile von Matrixmethoden und iterativen Ansätzen vereint. Implementierungen dieser Methode sind sowohl in Bibliotheken zu finden , als auch in . Eine Beschreibung dieser Methode wird hier nicht gegeben (sie kann in dem Artikel gefunden werden ). Stattdessen wird ein Ansatz demonstriert, der es ermöglicht, LSQR an die Ausführung in einer verteilten Umgebung anzupassen.
Die Grundlage der LSQR-Methode bildet . Dies ist ein iteratives Verfahren, bei dem jede Iteration aus den folgenden Schritten besteht:
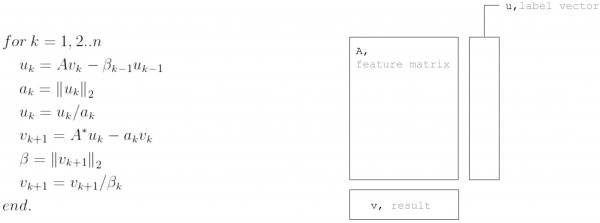
Wenn man jedoch davon ausgeht, dass die Matrix  horizontal partitioniert ist, kann jede Iteration als zwei MapReduce-Schritte dargestellt werden. Dadurch lässt sich der Datenversand während jeder Iteration minimieren (nur Vektoren der Länge, die der Anzahl der Unbekannten entspricht):
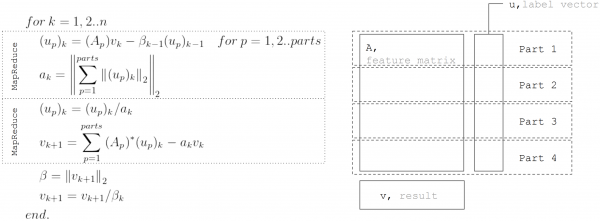
Genau dieser Ansatz wird bei der Implementierung der linearen Regression in .
Fazit
verwendet. Es gibt viele Algorithmen zur Wiederherstellung der linearen Regression, aber nicht alle können unter allen Bedingungen angewendet werden. So ist die QR-Zerlegung hervorragend für exakte Lösungen auf kleinen Datenmengen geeignet. Der Gradientensprung lässt sich einfach umsetzen und ermöglicht es, schnell eine Näherungslösung zu finden. LSQR vereint die besten Eigenschaften der beiden vorherigen Algorithmen, da es verteilt werden kann, schneller konvergiert als der Gradientensprung und auch eine vorzeitige Beendigung des Algorithmus ermöglicht, im Gegensatz zur QR-Zerlegung zur Suche nach einer Näherungslösung.
Quelle: habr.com
