

Monitoring ist ein äußerst wichtiger Bestandteil der wachsenden Cloud-Lösungen, da die Komplexität verteilte Systeme zunimmt. Es ist notwendig, ihr Verhalten zu verstehen. Skalierbare Tools sind erforderlich, um Daten aus allen Diensten zu sammeln und Fachleuten eine einheitliche Schnittstelle für Performance-Analysen, Fehlermeldungen, Verfügbarkeit und Protokolle bereitzustellen.
Diese Tools müssen effizient und leistungsstark sein. In diesem Artikel werden wir zwei beliebte Technologiestacks untersuchen: EFK (Elasticsearch) und PLG (Loki) sowie ihre Architekturen und Unterschiede erläutern.
EFK-Stack
Vielleicht haben Sie bereits von dem sehr beliebten ELK oder EFK gehört. Der Stack besteht aus mehreren einzelnen Komponenten: Elasticsearch (Objektspeicher), Logstash oder FluentD (Sammlung und Aggregation von Protokollen) und Kibana zur Visualisierung.
Ein typisches Arbeitsdiagramm sieht so aus:
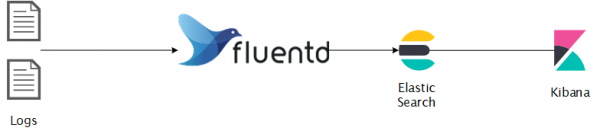
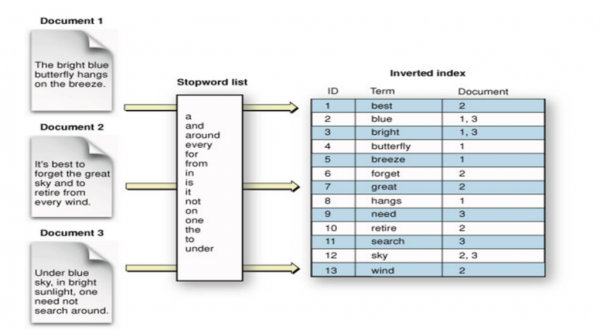
Elasticsearch — ein verteiltes Objektspeicher mit Echtzeit-Suche und -Analyse. Eine hervorragende Lösung für teilweise strukturierte Daten, wie Protokolle. Informationen werden in Form von JSON-Dokumenten gespeichert, in Echtzeit indexiert und über die Knoten des Clusters verteilt. Es wird ein invertierter Index verwendet, der alle einzigartigen Wörter und die entsprechenden Dokumente für die Volltextsuche enthält, die wiederum auf der Suchmaschine Apache Lucene basiert.
FluentD — ist ein Datensammler, der die Daten bei ihrer Sammlung und Nutzung vereinheitlicht. Er versucht, die Daten so weit wie möglich in JSON zu strukturieren. Seine Architektur ist erweiterbar, es gibt mehr als , die von der Community für alle Lebenslagen unterstützt werden.
Kibana — ein Visualisierungstool für Daten in Elasticsearch mit verschiedenen zusätzlichen Funktionen, wie Zeitreihenanalysen, Grafiken, maschinellem Lernen und mehr.
Architektur von Elasticsearch
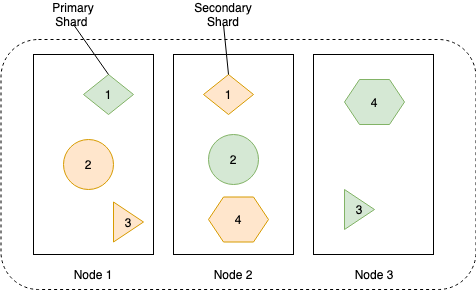
Die Daten des Elasticsearch-Clusters werden über alle seine Knoten verteilt gespeichert. Der Cluster besteht aus mehreren Knoten zur Verbesserung der Verfügbarkeit und Stabilität. Jeder Knoten kann alle Rollen des Clusters ausführen, aber in großen und skalierbaren Bereitstellungen werden den Knoten in der Regel spezifische Aufgaben zugewiesen.
Typen von Clusterknoten:
- Master-Knoten — verwaltet den Cluster, mindestens drei nötig, wobei einer immer aktiv ist;
- Datenknoten — speichert indexierte Daten und führt verschiedene Aufgaben damit aus;
- Ingest-Knoten — organisiert Pipelines zur Datenverarbeitung vor der Indizierung;
- Koordinierende Knoten — Routing von Anfragen, Reduzierung der Suchverarbeitungsphase, Koordination der massenhaften Indizierung;
- Alarmierungsknoten — Start von Benachrichtigungsaufgaben;
- Machine-Learning-Knoten — Verarbeitung von Aufgaben des maschinellen Lernens.
Im folgenden Diagramm ist dargestellt, wie Daten gespeichert und zwischen Knoten repliziert werden, um eine höhere Datenverfügbarkeit zu erreichen.
Die Daten jeder Replik werden in einem invertierten Index gespeichert, das folgende Schema zeigt, wie das geschieht:
Installation
Die Details können hier eingesehen werden , ich werde das Helm-Chart verwenden:
$ helm install efk-stack stable/elastic-stack --set logstash.enabled=false --set fluentd.enabled=true --set fluentd-elasticsPLG-Stack
Es ist nicht überraschend, wenn Sie dieses Akronym nicht finden können, denn es ist besser bekannt als Grafana Loki. Jedenfalls gewinnt dieser Stack an Popularität, da er durch technische Lösungen überzeugt. Möglicherweise haben Sie bereits von Grafana gehört, dem beliebten Visualisierungstool. Ihre Entwickler haben, inspiriert von Prometheus, Loki entwickelt, ein horizontal skalierbares, leistungsstarkes Protokollaggregationssystem. Loki indiziert nur die Metadaten, nicht die Protokolle selbst, was es einfach zu bedienen und wirtschaftlich macht.
Promtail — Agent zur Übermittlung von Protokollen aus dem Betriebssystem an den Loki-Cluster. Grafana — Visualisierungstool basierend auf den Daten aus Loki.
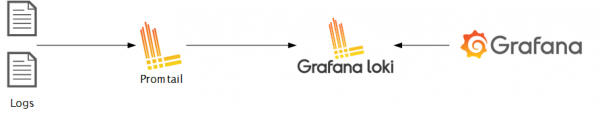
Loki ist nach den gleichen Prinzipien wie Prometheus aufgebaut und eignet sich daher hervorragend zur Speicherung und Analyse von Kubernetes-Protokollen.
Architektur von Loki
Loki kann sowohl im Modus eines einzelnen Prozesses als auch in Form mehrerer Prozesse betrieben werden, was horizontales Scaling ermöglicht.
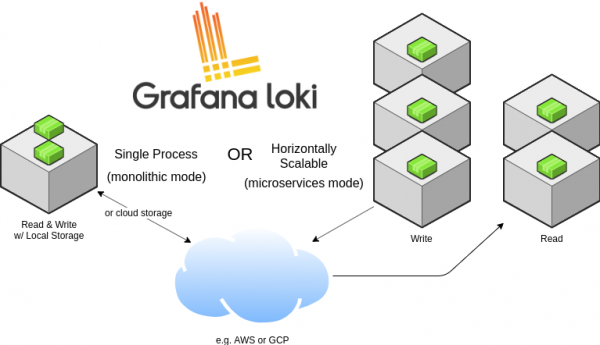
Es kann sowohl als monolithische Anwendung als auch als Mikrodienst betrieben werden. Der Betrieb in einem einzigen Prozess kann nützlich sein für die lokale Entwicklung oder für geringfügiges Monitoring. Für industrielle Implementierungen und skalierbare Lasten wird empfohlen, die Mikrodienstarbeit zu verwenden. Die Wege für das Schreiben und Lesen von Daten sind getrennt, sodass es für spezifische Anforderungen fein abgestimmt und skaliert werden kann.
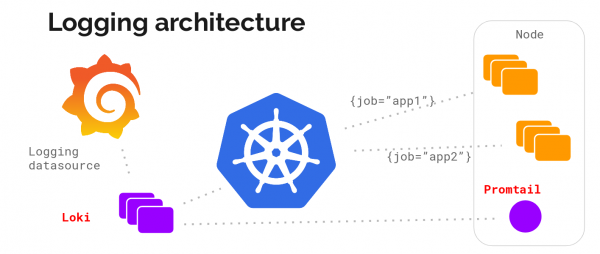
Lassen Sie uns die Architektur des Protokollsammlungssystems ohne Detailierungsgrad ansehen:
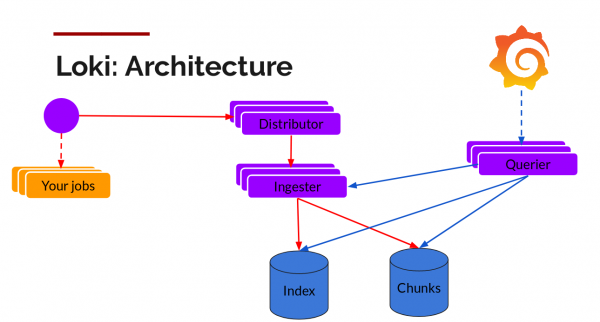
Und hier ist die Beschreibung (Mikrodienstarbeit):
Bausteine:
Promtail — ein Agent, der an Knoten (in Form von Dienstpaketen) installiert wird. Er erfasst Protokolle von Aufgaben und ruft die Kubernetes-API auf, um Metadaten zu erhalten, mit denen die Protokolle gekennzeichnet werden. Anschließend sendet er das Protokoll an den Hauptdienst Loki. Für die Zuordnung von Metadaten gelten die gleichen Regeln für die Kennzeichnung wie in Prometheus.
Distributor — ein Verteilungsdienst, der als Puffer arbeitet. Um Millionen von Datensätzen zu verarbeiten, bündelt er eingehende Daten und komprimiert sie blockweise, während sie ankommen. Mehrere Datenempfänger arbeiten gleichzeitig, aber Protokolle, die zu einem einzigen Eingabestrom gehören, müssen für alle seine Blöcke nur in einem von ihnen erscheinen. Dies ist in Form eines Empfänger-Rings und sequenzieller Hashierung organisiert. Zur Fehlertoleranz und Redundanz geschieht dies n Mal (3, wenn nicht konfiguriert).
Ingester — ein Empfangsdienst. Datenblöcke kommen komprimiert mit hinzugefügten Protokollen. Sobald ein Block eine ausreichende Größe erreicht hat, wird der Block in die Datenbank zurückgeschrieben. Die Metadaten gehen in den Index, während die Daten des Blocks mit den Protokollen in Chunks gelangen (normalerweise ist dies ein objektiertes Speichersystem). Nach dem Zurückschreiben erstellt der Empfänger einen neuen Block, in den neue Datensätze hinzugefügt werden.
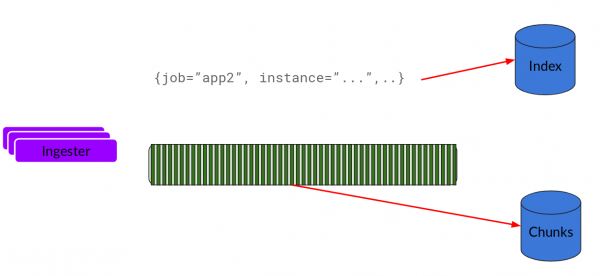
Index — Datenbanken wie DynamoDB, Cassandra, Google BigTable usw.
Chunks — komprimierte Protokollblöcke, die normalerweise in einem Objektspeicher wie S3 gespeichert werden.
Querier — der Leseweg, der die gesamte Arbeit im Hintergrund erledigt. Er betrachtet den Zeitbereich und die Labels, schaut dann in den Index, um Übereinstimmungen zu finden. Danach liest er die Datenblöcke und filtert sie, um ein Ergebnis zu erhalten.
Und jetzt sehen wir uns alles in Aktion an.
Installation
Um es in Kubernetes zu installieren, ist es am einfachsten, helm zu verwenden. Wir gehen davon aus, dass Sie es bereits installiert und konfiguriert haben ( Anm. des Übersetzers)
Wir fügen das Repository hinzu und installieren den Stack.
$ helm repo add loki https://grafana.github.io/loki/charts
$ helm repo update
$ helm upgrade --install loki loki/loki-stack --set grafana.enabled=true,prometheus.enabled=true,prometheus.alertmanager.persistentVolume.enabled=false,prometheus.server.persistentVolume.enabled=false
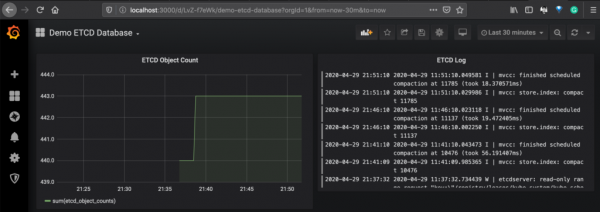
Nachfolgend ein Beispiel für ein Dashboard, das Daten aus Prometheus für die Metriken Etcd und Loki für die Protokolle von Etcd-Pods anzeigt.
Und jetzt lassen Sie uns die Architektur beider Systeme besprechen und ihre Funktionen vergleichen.
Vergleich
Abfragesprache
In Elasticsearch wird Query DSL und die Lucene-Abfragesprache verwendet, die die Möglichkeit einer Volltextsuche bietet. Dies ist eine etablierte, leistungsstarke Suchmaschine mit umfassender Unterstützung für Operatoren. Damit kann nach Kontext gesucht und nach Relevanz sortiert werden.
Auf der anderen Seite des Rings steht LogQL, das in Loki verwendet wird und der Nachfolger von PromQL (Prometheus-Abfragesprache) ist. Es nutzt Protokoll-Tags zur Filterung und Auswahl von Protokolldaten. Einige Operatoren und Arithmetik können wie beschrieben verwendet werden , aber in Bezug auf Möglichkeiten hinkt es hinter der Elastic-Sprache hinterher.
Da die Abfragen in Loki mit Tags verbunden sind, lassen sie sich leicht mit Metriken verknüpfen, was die Organisation des operativen Monitorings erleichtert.
Skalierbarkeit
Beide Stacks sind horizontal skalierbar, aber bei Loki ist das einfacher, da er separate Lese- und Schreibpfade für Daten hat und eine Microservice-Architektur verwendet. Loki kann an Ihre Besonderheiten angepasst werden und kann für sehr große Mengen an Protokolldaten verwendet werden.
Multi-Tenancy
Die Multi-Tenancy des Clusters ist ein allgemeines Thema zur Reduzierung der OPEX, beide Stacks bieten Multi-Tenancy. Für Elasticsearch gibt es mehrere zur Trennung von Kunden: ein separater Index für jeden Kunden, clientbasierte Routing, einzigartige Kundenfelder, Suchfilter. In Loki gibt es in Form des HTTP-Headers X-Scope-OrgID.
Kosten
Loki ist wirtschaftlich sehr effizient, da er keine Daten, sondern nur Metadaten indiziert. Dadurch wird und Arbeitsspeicher (Cache) eingespart, da Objektspeicher günstiger ist als Blockspeicher, der in Elasticsearch-Clustern verwendet wird.
Fazit
Der EFK-Stack kann für verschiedene Zwecke eingesetzt werden und bietet eine maximale Flexibilität sowie eine multifunktionale Benutzeroberfläche in Kibana für Analysen, Visualisierungen und Abfragen. Er kann zusätzlich durch Funktionen des maschinellen Lernens verbessert werden.
Der Loki-Stack ist in der Kubernetes-Ecosystem aufgrund des Mechanismus zur Erkennung von Metadaten nützlich. Es ist einfach möglich, Daten für die zeitbasierte Überwachung in Grafana und Protokollen zuzuordnen.
Wenn es um Kosten und langfristige Speicherung von Protokollen geht, ist Loki eine hervorragende Wahl für den Einstieg in Cloud-Lösungen.
Es gibt mehr Alternativen auf dem Markt — einige davon könnten besser für Sie sein. Zum Beispiel gibt es für GKE die Stackdriver-Integration, die eine hervorragende Lösung für das Monitoring bietet. Wir haben sie in dieser Analyse nicht berücksichtigt.
Links:
Der Artikel wurde für Habr von Mitarbeitern — Intensivkurse, Video-Kurse und betriebliche Schulungen von praktizierenden Fachleuten (Kubernetes, DevOps, Docker, Ansible, Ceph, SRE, Agile)
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish