

Ehrlich gesagt, Ivan lachte oft über die vergeblichen Bemühungen seiner Kollegen aus der Überwachungsabteilung. Sie machten enorme Anstrengungen, um die Kennzahlen, die das Management des Unternehmens bestellte, umzusetzen. Sie waren so beschäftigt, dass sie nichts anderes mehr tun wollten.
Und dem Management war das nicht genug – es bestellte ständig neue Kennzahlen und hörte sehr schnell auf, die bereits erstellten zu nutzen.
In letzter Zeit sprach jeder nur über LeadTime – die Lieferzeit für Geschäftsfeatures. Die Kennzahl zeigte eine verrückte Zahl – 200 Tage für die Lieferung einer Aufgabe. Wie alle stöhnten, seufzten und ihre Hände gen Himmel erhoben!
Nach einiger Zeit verebbte der Lärm allmählich, und das Management gab einen Auftrag zur Erstellung einer weiteren Kennzahl.
Ivan war vollkommen klar, dass auch die neue Kennzahl genau so still und leise im dunklen Winkel sterben würde.
In der Tat dachte Ivan, die Kenntnis einer Zahl sagt niemandem etwas. 200 Tage oder 2 Tage – es gibt keinen Unterschied, weil man aus den Zahlen nicht die Ursache erkennen und verstehen kann, ob es gut oder schlecht ist.
Das ist die typische Falle der Kennzahlen: Es scheint, als würde die neue Kennzahl das Wesen des Seins erzählen und irgendein geheimes Geheimnis erklären. Alle hoffen darauf, aber aus irgendeinem Grund passiert nichts. Und das, weil das Geheimnis nicht in den Kennzahlen gesucht werden sollte!
Für Ivan war das ein durchlaufener Schritt. Er verstand, dass für Messungen, und alle Geheimnisse müssen in , d.h. dem, was diese Kennzahl formt, gesucht werden.
Für einen Online-Shop wäre das Einflussobjekt seine Kunden, die Geld bringen, und für DevOps – die Teams, die Distributionen mit Hilfe der Pipeline erstellen und bereitstellen.
Eines Tages, als er sich in einer bequemen Sessel in der Lobby niederließ, entschloss sich Ivan, gründlich zu überlegen, wie er die DevOps-Kennzahlen sehen möchte, wobei das Einflussobjekt die Teams sind.
Ziel der DevOps-Kennzahlen
Es ist klar, dass jeder die Lieferzeit reduzieren möchte. 200 Tage sind natürlich nicht akzeptabel.
Aber wie, darum geht es?
Im Unternehmen arbeiten hunderte von Teams, und täglich durchlaufen Tausende von Distributionen die DevOps-Pipeline. Die tatsächliche Lieferzeit wird als Verteilung aussehen. Jedes Team hat seine eigene Zeit und seine eigenen Besonderheiten. Wie kann man in diesem Durcheinander irgendetwas finden?
Die Antwort kam von selbst – wir müssen die problematischen Teams finden und herausfinden, was bei ihnen passiert und warum es so lange dauert, und von den "guten" Teams lernen, wie man alles schnell macht. Dazu müssen wir die Zeit messen, die die Teams an jedem der DevOps-Stände verbringen:
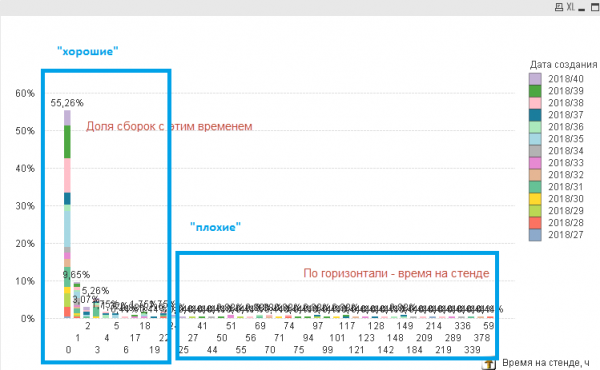
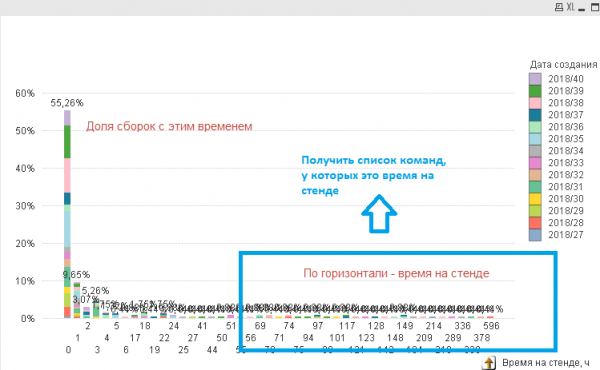
„Ziel des Systems wird die Auswahl der Teams nach der Zeit sein, die sie an den Ständen verbringen, d.h. letztendlich müssen wir eine Liste von Teams mit der ausgewählten Zeit und nicht nur eine Zahl erhalten.
Wenn wir erfahren, wie viel Zeit insgesamt für den Stand aufgewendet wurde und wie viel Zeit für die Stillstände zwischen den Ständen aufgewendet wurde, können wir die Teams finden, sie anrufen und genauer die Gründe verstehen und diese beseitigen“, dachte Ivan.
Wie man die Lieferzeit für DevOps berechnet
Für die Berechnung war es notwendig, tiefer in den DevOps-Prozess und dessen Wesen einzutauchen.
Im Unternehmen werden nur eine begrenzte Anzahl von Systemen verwendet, und Informationen können nur aus diesen bezogen werden und sonst von nirgendwo.
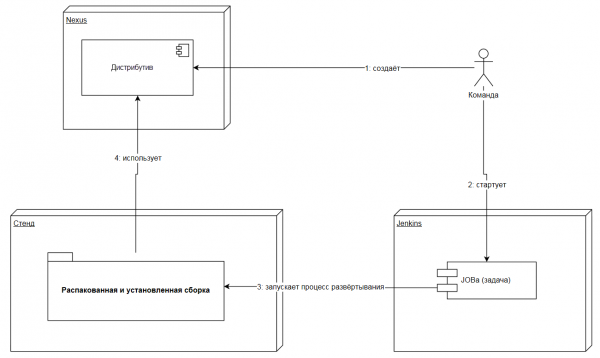
Alle Aufgaben im Unternehmen wurden in Jira erfasst. Wenn eine Aufgabe in Arbeit genommen wurde, wurde ein Branch dafür erstellt, und nach der Implementierung wurde ein Commit in BitBucket und ein Pull Request gemacht. Bei der Annahme des PR (Pull Request) wurde automatisch ein Paket erstellt und im Nexus gespeichert.

Anschließend wurde das Paket auf mehreren Ständen mit Hilfe von Jenkins ausgerollt, um die Richtigkeit des Rollouts, die automatische und manuelle Tests zu überprüfen:
Ivan skizzierte aus welchen Systemen welche Informationen entnommen werden können, um die Zeit an den Ständen zu berechnen:
- Aus Nexus – Erstellungszeit des Pakets und der Name des Ordners, in dem der Code des Teams enthalten war.
- Aus Jenkins – Startzeit, Dauer und Ergebnis der Ausführung jeder Job, der Name des Stands (in den Jobparametern), Stages (Schritte des Jobs), Link zum Paket in Nexus.
- Jira und BitBucket entschied Ivan, nicht in die Pipeline einzubeziehen, da sie mehr zur Entwicklungsphase und nicht zum Rollout des fertigen Pakets an den Ständen gehörten.
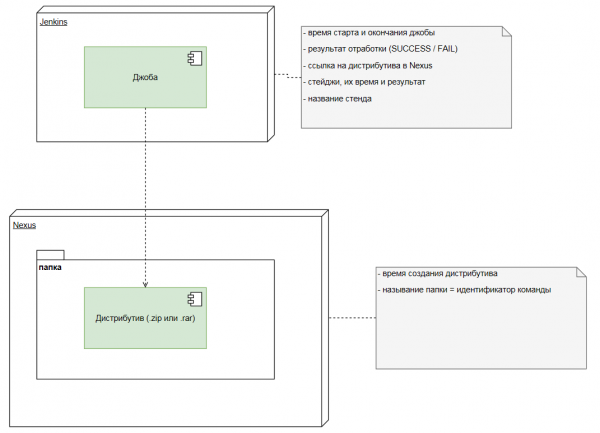
Auf der Grundlage der vorhandenen Informationen wurde folgendes Schema skizziert:
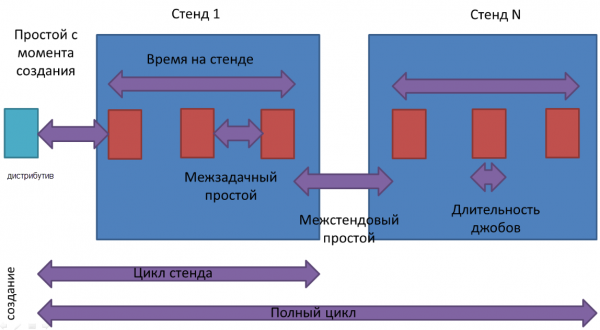
Wenn man weiß, wie lange die Pakete erstellt werden und wie viel Zeit für jedes von ihnen aufgewendet wird, kann man die Gesamtkosten für den gesamten DevOps-Pipeline-Prozess (den vollständigen Zyklus) leicht berechnen.
Das sind die DevOps-Metriken, die Ivan letztendlich erhalten hat:
- Anzahl der erstellten Pakete
- Anteil der Pakete, die auf den Stand "gegangen" sind und den Stand "bestanden" haben
- Zeit, die an dem Stand verbracht wurde (Standzyklus)
- Der vollständige Zyklus (Gesamtzeit über alle Stände)
- Dauer der Jobs
- Leerlauf zwischen den Ständen
- Leerlauf zwischen den Starts von Jobs an einem Stand
Einerseits haben die Metriken die DevOps-Pipeline in Bezug auf die Zeit sehr gut charakterisiert, andererseits wurden sie als sehr einfach angesehen.
Zufrieden mit seiner gut geleisteten Arbeit stellte Ivan eine Präsentation zusammen und ging, um sie der Geschäftsleitung vorzustellen.
Auf dem Rückweg war er düster und mit gesenkten Händen.
„Das ist ein Fiasko, Bruder“ – lächelte der ironische Kollege…
Die Fortsetzung lesen Sie im Artikel „».
Quelle: habr.com
