

Hallo zusammen.
Ich bin Linux-Administrator und bin 2015 mit einem unabhängigen Arbeitsvisum aus Russland nach Australien gezogen, aber der Artikel wird nicht darüber handeln, wie ein Schwein einen Traktor bekommt. Solche Artikel gibt es schon genug (wenn es ein Interesse gibt, schreibe ich auch darüber), deshalb möchte ich erzählen, wie ich in meiner Arbeit in Australien als Linux-Ops-Ingenieur der Initiator der Migration von einem Überwachungssystem zu einem anderen war. Konkret – Nagios => Icinga2.
Der Artikel ist teilweise technisch und teilweise über die Kommunikation mit Menschen und die Probleme, die mit den Unterschieden in Kultur und Arbeitsmethoden verbunden sind.
Leider hebt das Tag „code“ den Puppet- und YAML-Code nicht hervor, also musste ich „plaintext“ verwenden.
Nichts deutete am Morgen des 21. Dezember 2016 auf Probleme hin. Wie gewohnt las ich die Habr-Webseite als nicht registrierter Anonymer in den ersten halben Stunden des Arbeitstags, während ich Kaffee konsumierte und auf .
Da in meiner Firma gerade Nagios verwendet wurde, erstellte ich kurzerhand ein Ticket in Redmine und teilte den Link im Gruppenchats, da ich dies für wichtig hielt. Initiative kann auch in Australien bestraft werden, sodass der leitende Ingenieur dieses Problem mir zuwies, da ich es entdeckt hatte.
Screenshot aus Redmine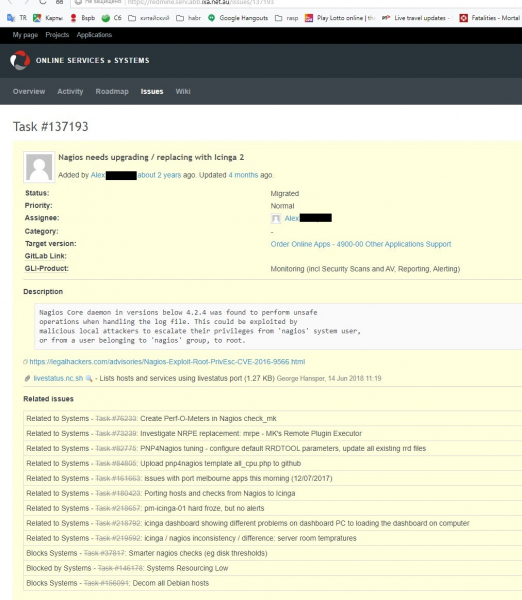
In unserer Abteilung ist es üblich, vor der Äußerung seiner Meinung mindestens eine Alternative vorzuschlagen, selbst wenn die Wahl offensichtlich ist, also begann ich mit der Google-Suche, welche Überwachungssysteme derzeit aktuell sind, da ich in Russland an meinem letzten Arbeitsplatz ein eigenes, sehr primitives, aber dennoch funktionierendes und alle ihm übertragenen Aufgaben erfüllendes System hatte. Python, die Technische Universität St. Petersburg und die U-Bahn sind der Schlüssel. Nein, die U-Bahn ist schlecht. Das ist persönlich (11 Jahre Arbeit) und verdient einen eigenen Artikel, aber nicht jetzt.
Ein wenig über die Regeln zur Änderung der Infrastrukturkonfiguration an meinem aktuellen Arbeitsplatz. Wir verwenden Puppet, GitLab und das Prinzip Infrastructure as Code, also:
- Keine manuelle Änderung über SSH durch manuelles Ändern von Dateien auf virtuellen Maschinen. In drei Jahren Arbeit habe ich dafür schon oft Ärger bekommen, zuletzt vor einer Woche, und ich glaube nicht, dass es das letzte Mal war. Wirklich — eine Zeile in der Konfiguration zu ändern, den Dienst neu zu starten und zu sehen, ob das Problem gelöst ist — 10 Sekunden. Einen neuen Branch in Gitlab zu erstellen, die Änderungen zu pushen, zu warten, bis r10k auf dem Puppetmaster ausgeführt wurde, Puppet mit --environment=mybranch zu starten und noch ein paar Minuten zu warten, bis all dies abgearbeitet ist — mindestens 5 Minuten.
- Alle Änderungen erfolgen durch das Erstellen eines Merge Requests in Gitlab und es ist notwendig, die Genehmigung von mindestens einem Teammitglied zu erhalten. Wichtige Änderungen, die vom Teamleiter entschieden werden, erfordern zwei oder drei Genehmigungen.
- Alle Änderungen sind in irgendeiner Weise textlich (da die Puppet-Manifestdateien, Skripte und Hiera-Daten Text sind), binäre Dateien werden stark abgelehnt, und es bedarf triftiger Gründe, um solche Dateien zu genehmigen.
Also, die Optionen, die ich in Betracht gezogen habe:
- Munin — wenn es in der Infrastruktur mehr als 10 Server gibt, wird die Verwaltung zur Qual (laut . Ich hatte nicht das große Verlangen, das zu überprüfen, also habe ich es geglaubt).
- Zabbix — ich habe es schon lange im Auge, noch in Russland, aber damals war es für meine Aufgaben übertrieben. Hier musste ich es aufgrund der Nutzung von Puppet als Konfigurationsmanager und Gitlab als Versionskontrollsystem ablegen. Zu diesem Zeitpunkt, wie ich verstanden habe, speichert Zabbix die gesamte Konfiguration in einer Datenbank, was unklar machte, wie man die Konfiguration unter den gegebenen Bedingungen verwalten und Änderungen nachverfolgen kann.
- Prometheus — das, wohin wir letztendlich kommen werden, judging by the sentiment in the department, aber damals konnte ich das nicht bewältigen und konnte kein tatsächlich funktionierendes Beispiel (Proof of Concept) zeigen, also musste ich darauf verzichten.
- Es gab noch einige andere Optionen, die entweder eine vollständige Überarbeitung des Systems erforderten oder sich in einem frühen Entwicklungsstadium befanden / aufgegeben wurden und aus demselben Grund abgelehnt wurden.
Letztendlich habe ich mich aus drei Gründen für Icinga2 entschieden:
1 — Kompatibilität mit Nrpe (der Client-Dienst, der Prüfungen auf Befehl von Nagios ausführt). Das war sehr wichtig, denn zu diesem Zeitpunkt hatten wir 135 (jetzt 2019 sind es 165) virtuelle Maschinen mit einer Menge selbstgeschriebener Dienste/Überprüfungen, und das alles neu zu machen wäre ein echter Albtraum gewesen.
2 — Alle Konfigurationsdateien sind im Textformat, was es einfach macht, diese zu bearbeiten und Merge-Requests zu erstellen, um zu sehen, was hinzugefügt oder entfernt wurde.
3 — Es ist ein lebendiges und sich entwickelndes OpenSource-Projekt. Wir schätzen OpenSource sehr und leisten unseren Teil, indem wir Pull Requests und Issues zur Problemlösung erstellen.
Also, los geht's mit Icinga2.
Das erste, womit ich konfrontiert wurde, war die Trägheit der Kollegen. Alle waren an Nagios/Nagios gewöhnt (obwohl wir selbst hier keinen Kompromiss finden konnten, wie man es ausspricht) und an die CheckMK-Oberfläche. Die Oberfläche von Icinga sieht ganz anders aus (das war ein Nachteil), aber es gibt die Möglichkeit, flexibel anzuzeigen, was man durch Filter nach nahezu jedem Parameter sehen möchte (das war ein Vorteil, für den ich jedoch hart gekämpft habe).
Filter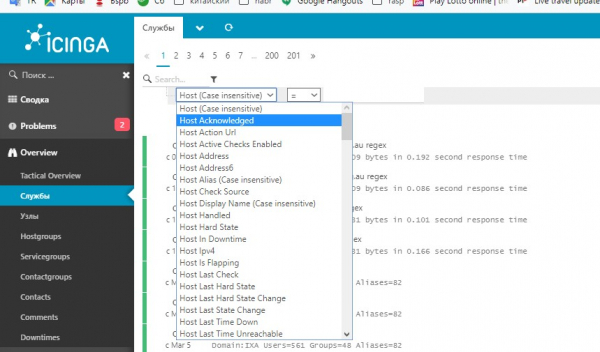
Bewerten Sie das Verhältnis der Größe der Scrollbar zur Größe des Scrollfeldes.
Zweitens — alle waren es gewohnt, die gesamte Infrastruktur auf einem Monitor zu sehen, da CheckMk die Arbeit mit mehreren Nagios-Hosts ermöglichte, aber die Icinga-Oberfläche konnte das nicht (sie konnte es tatsächlich, aber dazu später mehr). Eine Alternative war etwas namens Thruk, aber dessen Design erregte bei allen Teammitgliedern, bis auf einen – denjenigen, der es vorgeschlagen hatte (nicht ich) – Brechreiz.
Thruk soll weg — einstimmige Entscheidung des Teams.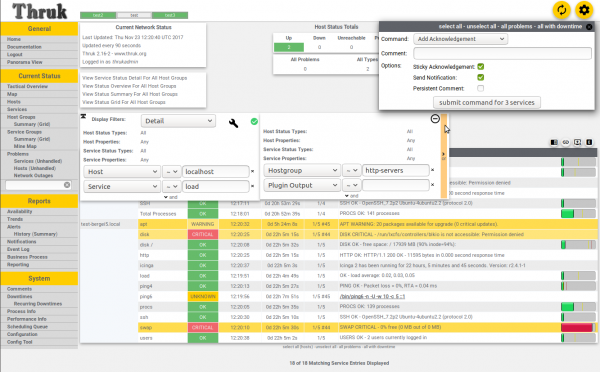
Nach ein paar Tagen Brainstorming schlug ich die Idee des Clustermonitorings vor, bei dem es einen Master-Host in der Produktionszone und zwei untergeordnete Hosts gibt – einen in der Dev/Test-Umgebung und einen externen Host, der bei einem anderen Anbieter untergebracht ist, um unsere Dienste aus der Sicht des Kunden oder eines externen Beobachters zu überwachen. Diese Konfiguration ermöglichte es, alle Probleme in einem Webinterface zu sehen und funktionierte ganz gut, aber Puppet... Das Problem mit Puppet war, dass der Master-Host jetzt über alle Hosts und Dienste/Überprüfungen im System Bescheid wissen musste und diese zwischen den Zonen (dev-test, staging-prod, ext) aufteilen musste. Das Senden von Änderungen über die Icinga-API dauert ein paar Sekunden, während das Kompilieren des Puppet-Katalogs aller Dienste für alle Hosts ein paar Minuten in Anspruch nimmt. Das wird mir bis heute vorgeworfen, obwohl ich schon mehrmals erklärt habe, wie alles funktioniert und warum es so lange dauert.
Drittens – eine Menge SnowFlakes (Schneeflocken) – Dinge, die aus dem Gesamtsystem herausfallen, weil sie etwas Besonderes enthalten, sodass die allgemeinen Regeln nicht auf sie anwendbar sind. Das wurde durch einen direkte Angriff gelöst – wenn es Alarm gibt, aber in Wirklichkeit alles in Ordnung ist, muss man tiefer graben und herausfinden, warum es bei mir Alarm schlägt, obwohl das nicht der Fall sein sollte. Oder andersherum – warum Nagios in Panik gerät, während Icinga nicht reagiert.
Viertens – Nagios hatte hier vor mir drei Jahre gearbeitet, und ihm wurde von Anfang an mehr Vertrauen entgegengebracht als meinem modernen hipsterhaften System. Jedes Mal, wenn Icinga Alarm schlug, tat niemand etwas, bis auch Nagios sich zu demselben Problem äußerte. Aber sehr selten gab Icinga echte Alarme aus, bevor Nagios das tat, und ich halte das für einen ernsthaften Fehler, den ich im Abschnitt 'Fazit' ansprechen werde.
Letztendlich zog sich die Inbetriebnahme über fünf Monate hinaus (geplant war der 28. Juni 2018, tatsächlich wurde es der 3. Dezember 2018), hauptsächlich wegen des 'Parity Checks' – dieser Mist, wenn es mehrere Dienste in Nagios gibt, von denen seit Jahren niemand etwas gehört hat, sie aber JETZT plötzlich kritische Alarme ohne jeden erkennbaren Grund auslösen, und ich musste erklären, warum sie nicht auf meinem Dashboard angezeigt werden, und ich musste sie in Icinga hinzufügen, um 'Parity Check abgeschlossen' zu erreichen (alle Dienste/Überprüfungen in Nagios entsprechen den Diensten/Überprüfungen in Icinga).
Einführung:
Erstens — der Krieg zwischen Code und Daten, im Puppet-Stil. Alle Daten, wirklich alle, müssen in Hiera und sonst nirgendwo sein. Der ganze Code ist in .pp-Dateien. Variablen, Abstraktionen, Funktionen — alles gehört in pp.
Insgesamt haben wir eine Menge virtueller Maschinen (165 zum Zeitpunkt des Schreibens dieses Artikels) und 68 Webanwendungen, die auf ihre Funktionsfähigkeit und die Gültigkeit der SSL-Zertifikate überwacht werden müssen. Aufgrund historischer Probleme stammen die Informationen zur Überwachung der Anwendungen jedoch aus einem separaten GitLab-Repository, und das Datenformat hat sich seit der Zeit von Puppet 3 nicht geändert, was zusätzliche Schwierigkeiten bei der Konfiguration mit sich bringt.
Puppet-Code für Anwendungen, schont die Augen
definiere profiles::services::monitoring::docker_apps(
  Hash $app_list,
  Hash $apps_accessible_from,
  Hash $apps_access_list,
  Hash $webhost_defaults,
  Hash $webcheck_defaults,
  Hash $service_overrides,
  Hash $targets,
  Hash $app_checks,
  )
{
#### APPS ####
  $zone = $name
  $app_list.each | String $app_name, Hash $app_data |
  {

    $notify_group = { 'notify_group' => ($webcheck_defaults[$zone]['notify_group'] + pick($app_data['notify_group'], {} )) } # fügt Benachrichtigungen für die Standardgruppe (Systeme) hinzu + jede in int/pm_docker_apps.eyaml definierte Gruppe.

    $data = merge($webhost_defaults, $apps_accessible_from, $app_data)

    $site_domain = $app_data['site_domain']

    $regexp = pick($app_data['check_regex'], 'html')        # Wähle einen Regex zur Überprüfung

    $check_url = $app_data['check_url'] ? {
      undef   => { 'http_uri' => '\/ ' },
      default => { 'http_uri' => $app_data['check_url'] }
    }

    $check_regex = $regexp ?{
      'absent' => {},
      default  => {'http_expect_body_regex' => $regexp}
    }

    $site_domain.each | String $vhost, Hash $vdata | {        # Teile eine App nach Domains, wenn es zwei oder mehr gibt
      $vhost_name = {'http_vhost' => $vhost}

      $vars = $data['vars'] + $vhost_name + $check_regex + $check_url

      $web_ipaddress = is_array($vdata['web_ipaddress']) ? {  # Mache die IP-Adresse ein Array, wenn sie es nicht ist, denn askizzy hat 2 IPs und es ist ein Array
        true  => $vdata['web_ipaddress'],
        false => [$vdata['web_ipaddress']],
      }

      $access_from_zones = [$zone] + $apps_access_list[$data['accessible_from']] # Kombiniere die Standardzone (wo die App definiert ist) und zusätzliche Zonen, wenn sie existieren
      $web_ipaddress.each | String $ip_address | {            # Für jede IP (wenn wir mehrere haben)
        $suffix = length($web_ipaddress) ? {                  # Wenn wir mehr als eine haben - füge die IP als Suffix zu diesem Hostnamen hinzu, um Duplikate zu vermeiden
          1       => '',
          default => "_${ip_address}"
        }
        $octets = split($ip_address, '.')
        $ip_tag = "${octets[2]}.${octets[3]}" # Nur den letzten Oktet zu verwenden, führt zu Kollisionen zwischen nginx-vip 203.15.70.94 und ext. ip 49.255.194.94

        $access_from_zones.each | $zone_prefix |{
          $zone_target = $targets[$zone_prefix]

          $nginx_vip_name = "${zone_prefix}_nginx-vip-${ip_tag}" # Wenn es ein Host für ext ist - wird das Präfix 'ext_' (ext_nginx-vip...)
          $nginx_host_vip = {
            $nginx_vip_name => {
              ensure        => present,
              target        => $zone_target,
              address       => $ip_address,
              check_command => 'hostalive',
              groups        => ['nginx_vip',],
            }
          }

          $ssl_vars = $app_checks['ssl']
          $regex_vars = $app_checks['http'] + $vars + $webcheck_defaults[$zone] + $notify_group

          if !defined( Profiles::Services::Monitoring::Host[$nginx_vip_name] ) {
          ensure_resources('profiles::services::monitoring::host', $nginx_host_vip)
          }

          if !defined( Icinga2::Object::Service["${nginx_vip_name}_ssl"] ) {
            icinga2::object::service {"${nginx_vip_name}_ssl":
              ensure         => $data['ensure'],
              assign         => ["host.name == $nginx_vip_name",],
              groups         => ['webchecks',],
              check_command  => 'ssl',
              check_interval => $service_overrides['ssl']['check_interval'],
              target         => $targets['services'],
              apply          => true,
              vars           => $ssl_vars
            }
          }
          if $regexp != 'absent'{
            if !defined(Icinga2::Object::Service["${vhost}${$suffix} regex"]){
              icinga2::object::service {"${vhost}${$suffix} regex":
                ensure          => $data['ensure'],
                assign          => ["match(*_nginx-vip-${ip_tag}, host.name)",],
                groups          => ['webchecks',],
                check_command   => 'http',
                check_interval  => $service_overrides['regex']['check_interval'],
                target          => $targets['services'],
                enable_flapping => true,
                apply           => true,
                vars            => $regex_vars
              }
            }
          }
        }
      }
    }
  }
}
Der Konfigurationscode für Hosts und Dienste sieht ebenfalls schrecklich aus:
monitoring/config.pp
class profiles::services::monitoring::config(
  Array $default_config,
  Array $hostgroups,
  Hash $hosts = {},
  Hash $host_defaults,
  Hash $services,
  Hash $service_defaults,
  Hash $service_overrides,
  Hash $webcheck_defaults,
  Hash $servicegroups,
  String $servicegroup_target,
  Hash $user_defaults,
  Hash $users,
  Hash $oncall,
  Hash $usergroup_defaults,
  Hash $usergroups,
  Hash $notifications,
  Hash $notification_defaults,
  Hash $notification_commands,
  Hash $timeperiods,
  Hash $webhost_defaults,
  Hash $apps_access_list,
  Hash $check_commands,
  Hash $hosts_api = {},
  Hash $targets = {},
  Hash $host_api_defaults = {},
)
{

  # Profiles::Services::Monitoring::Hostgroup <> # wird aktiviert, wenn wir vollständig auf Icinga umstellen
#### APPS ####
  case $location {
    'int', 'ext': {
      $apps_by_zone = {}
    }
    'pm': {
      $int_apps         = hiera('int_docker_apps')
      $int_app_defaults = hiera('int_docker_app_common')

      $st_apps          = hiera('staging_docker_apps')
      $srs_apps         = hiera('pm_docker_apps_srs')
      $pm_apps          = hiera('pm_docker_apps') + $st_apps + $srs_apps
      $pm_app_defaults  = hiera('pm_docker_app_common')

      $apps_by_zone = {
        'int' => $int_apps,
        'pm'  => $pm_apps,
      }

      $app_access_by_zone = {
        'int' => {'accessible_from' => $int_app_defaults['accessible_from']},
        'pm'  => {'accessible_from' => $pm_app_defaults['accessible_from']},
      }
    }

    default: {
      fail('Bitte stellen Sie sicher, dass das Knoten-Fact $location gesetzt ist (int, pm, ext)')
    }
  }

  file { '/etc/icinga2/conf.d/':
    ensure  => directory,
    recurse => true,
    purge   => true,
    owner   => 'icinga',
    group   => 'icinga',
    mode    => '0750',
    notify  => Service['icinga2'],
  }

  $default_config.each | String $file_name |{
    file {"/etc/icinga2/conf.d/${file_name}":
      ensure => present,
      source => "puppet:///modules/profiles/services/monitoring/default_config/${file_name}",
      owner  => 'icinga',
      group  => 'icinga',
      mode    => '0640',
    }
  }

  $app_checks = {
    'ssl' => $services['webchecks']['checks']['ssl']['vars'],
    'http' => $services['webchecks']['checks']['http_regexp']['vars']
  }

  $apps_by_zone.each | String $zone, Hash $app_list | {
    profiles::services::monitoring::docker_apps{$zone:
      app_list             => $app_list,
      apps_accessible_from => $app_access_by_zone[$zone],
      apps_access_list     => $apps_access_list,
      webhost_defaults     => $webhost_defaults,
      webcheck_defaults    => $webcheck_defaults,
      service_overrides    => $service_overrides,
      targets              => $targets,
      app_checks           => $app_checks,
    }
  }

####    HOSTS    ####

  # Profiles::Services::Monitoring::Host <> # Dies ist für die Raumschiff-Invasion, wenn sie bereit ist.
  $hosts_has_large_disks = query_nodes('mountpoints.*.size_bytes >= 1099511627776')

  $hosts.each | String $hostgroup, Hash $list_of_hosts_with_settings | {           # Aufteilung der Site-Listen nach Hostgruppen - docker_host/gluster_host/etc
    $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
    $hostgroup_settings     = $list_of_hosts_with_settings['settings']
    $merged_hostgroup_settings = deep_merge($host_defaults, $list_of_hosts_with_settings['settings'])
    $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{  # Aufteilung der Gruppenlisten nach Hosts
      # Ist dieser Host im Array $hosts_has_large_disks? Wenn ja, setze host.vars.has_large_disks
      if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
        $vars_has_large_disks = { 'has_large_disks' => true }
      } else {
        $vars_has_large_disks = {}
      }
      $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
      $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})
      $host_settings_vars = pick($host_settings['vars'], {})
      $host_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
      $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_notify_group}, $vars_has_large_disks)) # Variablen getrennt zusammenführen

      $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

      profiles::services::monitoring::host{$host_name:
        ensure             => $host_data['ensure'],
        display_name       => $host_data['display_name'],
        address            => $host_data['address'],
        groups             => $hostgroups,
        target             => $host_data['target'],
        check_command      => $host_data['check_command'],
        check_interval     => $host_data['check_interval'],
        max_check_attempts => $host_data['max_check_attempts'],
        vars               => $host_data_vars,
        template           => $host_data['template'],
      }
    }
  }
  if !empty($hosts_api){                                                                # Alle Hosts, die von der API verwaltet werden
    $hosts_api.each | String $zone, Hash $hosts_api_zone | {                            # API-Hosts nach Zonen aufteilen
      $hosts_api_zone.each | String $hostgroup, Hash $list_of_hosts_with_settings | {   # Aufteilung der Site-Listen nach Hostgruppen - docker_host/gluster_host/etc
        $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
        $hostgroup_settings     = $list_of_hosts_with_settings['settings']
        $merged_hostgroup_settings = deep_merge($host_api_defaults, $list_of_hosts_with_settings['settings'])
        $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{        # Aufteilung der Gruppenlisten nach Hosts
          # Ist dieser Host im Array $hosts_has_large_disks? Wenn ja, setze host.vars.has_large_disks
          if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
            $vars_has_large_disks = { 'has_large_disks' => true }
          } else {
            $vars_has_large_disks = {}
          }
          $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
          $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})

          $host_settings_vars = pick($host_settings['vars'], {})
          $host_api_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
          $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_api_notify_group}, $vars_has_large_disks))
          $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

          if defined(Profiles::Services::Monitoring::Host[$host_name]){
            $hostname = "${host_name}_from_${zone}"
          }
          else
          {
            $hostname = $host_name
          }
          profiles::services::monitoring::host{$hostname:
            ensure             => $host_data['ensure'],
            display_name       => $host_data['display_name'],
            address            => $host_data['address'],
            groups             => $hostgroups,
            target             => "${host_data['target_base']}/${zone}/hosts.conf",
            check_command      => $host_data['check_command'],
            check_interval     => $host_data['check_interval'],
            max_check_attempts => $host_data['max_check_attempts'],
            vars               => $host_data_vars,
            template           => $host_data['template'],
          }
        }
      }
    }
  }

#### ENDE DER HOSTS ####

####   SERVICES   ####

  $services.each | String $service_group, Hash $s_list |{             # Servicegruppe und Liste der Dienste in dieser Gruppe
    $service_list = $s_list['checks']                                 # Liste der tatsächlichen Checks, getrennt von den SG-Einstellungen
    $service_list.each | String $service_name, Hash $data |{

      $merged_defaults = merge($service_defaults, $s_list['settings']) # globale Standarddienste + Dienstgruppeneinstellungen
      $merged_data = merge($merged_defaults, $data)

      $settings_vars = pick($s_list['settings']['vars'], {})
      $this_service_vars = pick($data['vars'], {})
      $all_service_vars = delete_undef_values($service_defaults['vars'] + $settings_vars + $this_service_vars)

      # Wenn wir den Standard-check_timeout überschreiben, aber nicht nrpe_timeout, setzen Sie nrpe_timeout auf den Wert von check_timeout
      if ( $merged_data['check_timeout'] and ! $this_service_vars['nrpe_timeout'] ) {
        # NB: Icinga wird 1m automatisch in 60 umwandeln!
        $nrpe = { 'nrpe_timeout' => $merged_data['check_timeout'] }
      } else {
        $nrpe = {}
      }

      # Standardmäßig verwenden wir nrpe und alle Befehle werden über nrpe ausgeführt. Daher ist vars.nrpe_command = $service_name ein Standardwert
      # Wenn es sich um einen serverseitigen Icinga-Befehl handelt - benötigen wir „nrpe_command“ nicht
      # aber es ist nicht schädlich, diese Variable zu haben, und der Code ist kürzer

      if $merged_data['check_command'] == 'nrpe'{
        $check_command = $merged_data['vars']['nrpe_command'] ? {
          undef   => { 'nrpe_command' => $service_name },
          default => { 'nrpe_command' => $merged_data['vars']['nrpe_command'] }
        }
      }else{
        $check_command = {}
      }

      # Zusammensetzen von $vars aus den globalen Standardeinstellungen für Dienste, Dienstgruppeneinstellungen, diesen speziellen Check-Einstellungen und vergessen wir nicht die nrpe-Einstellungen.
      if $all_service_vars['graphite_template'] {
        $graphite_template = {'check_command' => $all_service_vars['graphite_template']}
      }else{
        $graphite_template = {'check_command' => $service_name}
      }
      $service_notify = [] + pick($settings_vars['notify_group'], []) + pick($this_service_vars['notify_group'], []) # pick ist überall erforderlich, sonst wird er "Der Wert '' kann nicht in numerisch umgewandelt werden"

      $service_notify_group = $service_notify ? {
        []      => $service_defaults['vars']['notify_group'],
        default => $service_notify
      } # Standardmittlere Gruppe (Systeme) zuweisen, wenn keine anderen Gruppen definiert sind

      $vars = $all_service_vars + $nrpe + $check_command + $graphite_template + {'notify_group' => $service_notify_group}

      # Diese müssen separat zusammengeführt werden, da eine Zusammenführung im Rahmen von MERGED_DATA Arrays überschreibt, anstatt sie zu kombinieren, sodass wir einige "Zuweisung" und "Ignorieren"-Werte verlieren

      $assign = delete_undef_values($service_defaults['assign'] + $s_list['settings']['assign'] + $data['assign'])
      $ignore = delete_undef_values($service_defaults['ignore'] + $s_list['settings']['ignore'] + $data['ignore'])

      icinga2::object::service {$service_name:
        ensure             => $merged_data['ensure'],
        apply              => $merged_data['apply'],
        enable_flapping    => $merged_data['enable_flapping'],
        assign             => $assign,
        ignore             => $ignore,
        groups             => [$service_group],
        check_command      => $merged_data['check_command'],
        check_interval     => $merged_data['check_interval'],
        check_timeout      => $merged_data['check_timeout'],
        check_period       => $merged_data['check_period'],
        display_name       => $merged_data['display_name'],
        event_command      => $merged_data['event_command'],
        retry_interval     => $merged_data['retry_interval'],
        max_check_attempts => $merged_data['max_check_attempts'],
        target             => $merged_data['target'],
        vars               => $vars,
        template           => $merged_data['template'],
      }
    }
  }
#### ENDE DER SERVICES ####

#### ANDERE LANGWEILIGE DINGE ####

  $servicegroups.each | $servicegroup, $description |{
    icinga2::object::servicegroup{ $servicegroup:
      target       => $servicegroup_target,
      display_name => $description
    }
  }

  $hostgroups.each| String $hostgroup |{
    profiles::services::monitoring::hostgroup { $hostgroup:}
  }

  $notifications.each | String $name, Hash $settings |{

    $assign = pick($notification_defaults['assign'], []) + $settings['assign']
    $ignore = pick($notification_defaults['ignore'], []) + $settings['ignore']

    $merged_settings = $settings + $notification_defaults

    icinga2::object::notification{$name:
      target       => $merged_settings['target'],
      apply        => $merged_settings['apply'],
      apply_target => $merged_settings['apply_target'],
      command      => $merged_settings['command'],
      interval     => $merged_settings['interval'],
      states       => $merged_settings['states'],
      types        => $merged_settings['types'],
      assign       => delete_undef_values($assign),
      ignore       => delete_undef_values($ignore),
      user_groups  => $merged_settings['user_groups'],
      period       => $merged_settings['period'],
      vars         => $merged_settings['vars'],
    }
  }

  # Zusammenführen der Benachrichtigungseinstellungen für Benutzer mit anderen Einstellungen
  $users_oncall = deep_merge($users, $oncall)
  # Magie. Fassen Sie nicht an.
  create_resources('icinga2::object::user', $users_oncall, $user_defaults)
  create_resources('icinga2::object::usergroup', $usergroups, $usergroup_defaults)
  create_resources('icinga2::object::timeperiod',$timeperiods)
  create_resources('icinga2::object::checkcommand', $check_commands)
  create_resources('icinga2::object::notificationcommand', $notification_commands)

  profiles::services::sudoers { 'icinga_runs_ping_l2':
    ensure            => present,
    sudoersd_template => 'profiles/os/redhat/centos7/sudoers/icinga.erb',
  }

}
Ich arbeite immer noch an diesem Krimskrams und verbessere ihn nach Möglichkeit. Doch genau dieser Code ermöglichte die Verwendung einer einfachen und verständlichen Syntax in Hiera:
Daten
profiles::services::monitoring::config::services:
  perf_checks:
    settings:
      check_interval: '2m'
      assign:
        - 'host.vars.type == linux'
    checks:
      procs: {}
      load: {}
      memory: {}
      disk:
        check_interval: '5m'
        vars:
          notification_period: '24x7'
      disk_iops:
        vars:
          notifications:
            - 'silent'
      cpu:
        vars:
          notifications:
            - 'silent'
      dns_fqdn:
        check_interval: '15m'
        ignore:
          - 'xenserver in host.groups'
        vars:
          notifications:
            - 'silent'
      iftraffic_nrpe:
        vars:
          notifications:
            - 'silent'
  logging:
    settings:
      assign:
        - 'logserver in host.groups'
    checks:
       rsyslog: {}
      nginx_limit_req_other: {}
      nginx_limit_req_s2s: {}
      nginx_limit_req_s2x: {}
      nginx_limit_req_srs: {}
     logstash: {}
      logstash_api:
        vars:
          notifications:
            - 'silent'
Alle Prüfungen sind in Gruppen unterteilt, jede Gruppe hat Standardkonfigurationen, wie und wie oft diese Prüfungen ausgeführt werden, welche Benachrichtigungen gesendet werden und an wen.
In jeder Prüfung können beliebige Optionen überschrieben werden, und all dies wird letztendlich auch mit den Standardkonfigurationen aller Prüfungen insgesamt kombiniert. Daher ist so eine Krimskrams in config.pp geschrieben – es findet eine Zusammenführung aller Standardkonfigurationen mit den Gruppeneinstellungen und dann auch mit jeder einzelnen Prüfung statt.
Eine sehr wichtige Änderung war auch die Möglichkeit, Funktionen in den Einstellungen zu verwenden, zum Beispiel die Funktion zum Ersetzen von Ports, Adressen und URLs für die http_regex-Prüfung.
http_regexp:
  assign:
    - 'host.vars.http_regex'
    - 'static_sites in host.groups'
  check_command: 'http'
  check_interval: '1m'
  retry_interval: '20s'
  max_check_attempts: 6
  http_port: '{{ if(host.vars.http_port) { return host.vars.http_port } else { return 443 } }}'
  vars:
    notification_period: 'host.vars.notification_period'
    http_vhost: '{{ if(host.vars.http_vhost) { return host.vars.http_vhost } else { return host.name } }}'
    http_ssl: '{{ if(host.vars.http_ssl) { return false } else { return true } }}'
    http_expect_body_regex: 'host.vars.http_regex'
    http_uri: '{{ if(host.vars.http_uri) { return host.vars.http_uri } else { return "\/" } }}'
    http_onredirect: 'follow'
    http_warn_time: 8
    http_critical_time: 15
    http_timeout: 30
    http_sni: true
Das bedeutet – wenn im Host-Definition eine Variable existiert http_port – verwende sie, andernfalls 443. Zum Beispiel hängt das Web-Interface von Jabber an 9090 und Unifi an 7443.
http_vhost bedeutet, DNS zu ignorieren und diese Adresse zu verwenden.
Wenn im Host ein URI angegeben ist – folge ihm, andernfalls verwende „\/“.
Mit http_ssl gab es eine amüsante Geschichte – dieses Mistding wollte sich auf Anforderung einfach nicht ausschalten lassen. Ich habe lange über dieser Zeile nachgedacht, bis mir klar wurde, dass es eine Variable in der Host-Definition ist:
http_ssl: falseWird in den Ausdruck eingesetzt
if(host.vars.http_ssl) { return false } else { return true }als false und am Ende ergibt es sich
if(false) { return false } else { return true }das heißt, die SSL-Prüfung ist immer aktiv. Es wurde durch eine Änderung der Syntax gelöst:
http_ssl: neinDas DBMS Tarantool ist ein attraktives, zukunftsträchtiges Produkt zur Erstellung von hochbelasteten Anwendungen.:
Vorteile:
- Jetzt haben wir ein Überwachungssystem, nicht zwei, wie in den letzten 7-8 Monaten, oder eines, das veraltet und anfällig ist.
- Die Datenstruktur der Hosts / Dienste (Überprüfungen) ist jetzt (meiner Meinung nach) viel lesbarer und verständlicher. Für andere war es nicht so offensichtlich, also musste ich ein paar Seiten in der lokalen Wiki erstellen, um zu erklären, wie es funktioniert und was wo geändert werden muss.
- Es gibt die Möglichkeit der flexiblen Konfiguration von Prüfungen mithilfe von Variablen und Funktionen, zum Beispiel können das gesuchte Muster, der Rückgabecode, die URL und der Port für die http_regexp-Prüfung in den Host-Einstellungen festgelegt werden.
- Es gibt mehrere Dashboards, für jedes von ihnen kann eine eigene Liste angezeigter Alarme definiert und alles über Puppet und Merge-Requests verwaltet werden.
Nachteile:
- Trägheit der Teammitglieder — Nagios arbeitete, arbeitete und arbeitete, während dein Icinga ständig hakt und verzögert. Wie sieht man hier die Geschichte? Ach, Mist, sie wird ja nicht aktualisiert... (Echtes Problem — die Alarmhistorie wird nicht automatisch aktualisiert, nur manuell über F5)
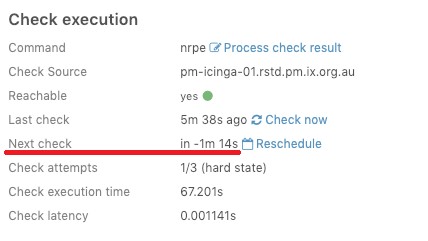
- Trägheit des Systems — wenn ich im Web-Interface auf „aktualisieren“ (jetzt überprüfen) klicke, hängt das Ergebnis von den Wetterbedingungen auf dem Mars ab, besonders bei komplexen Diensten, die mehrere Sekunden zur Ausführung benötigen. Ein solches Ergebnis ist völlig normal.

- Insgesamt hat Nagios in der sechsmonatigen Statistik der parallelen Verwendung der beiden Systeme immer schneller gearbeitet als Icinga, was mich sehr genervt hat. Meiner Meinung nach gibt es da ein Problem mit den Timern und die Überprüfung alle fünf Minuten erfolgt tatsächlich alle 5:30 oder so.
- Wenn der Dienst zu irgendeinem Zeitpunkt neu gestartet wird (systemctl restart icinga2), geben alle Prüfungen, die zu diesem Zeitpunkt ausgeführt werden, den Alarm critical aus, und von außen sieht es so aus, als ob alles abgestürzt ist ().
Aber insgesamt — es funktioniert.
Quelle: habr.com
