

19. September in Moskau das erste thematische Meetup der HUG (Highload++ User Group), das den Mikroservices gewidmet war. Auf diesem wurde der Vortrag "Betrieb von Mikroservices: Die Größe spielt eine Rolle, selbst wenn Sie Kubernetes haben" gehalten, in dem wir umfangreiche Erfahrungen der Firma "Flant" im Bereich des Betriebs von Projekten mit mikroservicebasierter Architektur geteilt haben. Insbesondere wird es allen Entwicklern nützlich sein, die darüber nachdenken, diesen Ansatz in ihrem aktuellen oder zukünftigen Projekt anzuwenden.
Wir präsentieren (50 Minuten, deutlich informativer als der Artikel), sowie die Hauptinhalte in Textform.
NB: Video und Präsentation sind auch am Ende dieser Veröffentlichung verfügbar.
Einführung
Normalerweise hat eine gute Geschichte einen Anfang, einen Hauptplot und ein Ende. Dieser Vortrag ähnelt eher einem Anfang, und zwar einem tragischen. Es ist auch wichtig zu beachten, dass er einen Blick auf Mikroservices aus der Perspektive von der Ausnutzung.
Ich beginne mit einem solchen Diagramm, dessen Autor (im Jahr 2015) Martin Fowler:
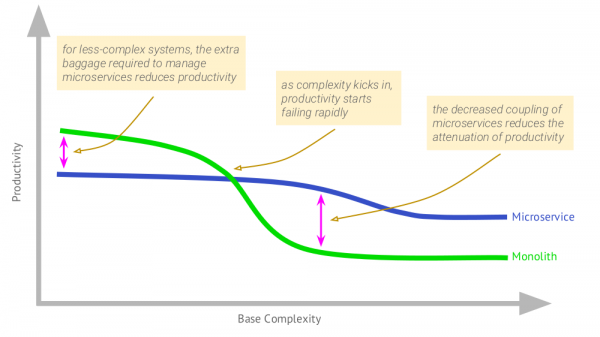
Man sieht, dass in einem monolithischen Anwendungsszenario, das eine bestimmte Größe erreicht hat, die Produktivität zu sinken beginnt. Mikroservices unterscheiden sich darin, dass die anfängliche Produktivität damit niedriger ist, aber mit zunehmender Komplexität weniger auffällig ist die Effizienzdegradation.
Ich werde dieses Diagramm für den Fall der Verwendung von Kubernetes ergänzen:
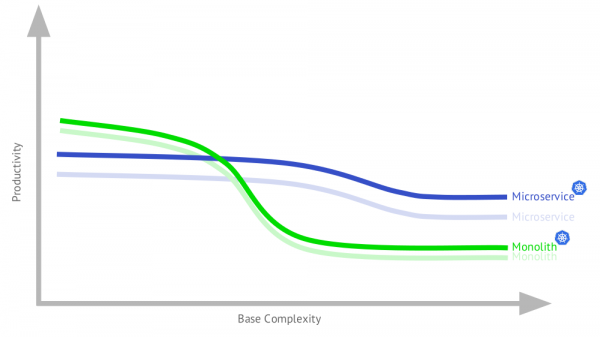
Warum ist es einer Anwendung mit Mikroservices besser geworden? Weil eine solche Architektur ernsthafte Anforderungen an die Architektur stellt, die ihrerseits hervorragend durch die Möglichkeiten von Kubernetes erfüllt werden. Auf der anderen Seite wird ein Teil dieser Funktionalität auch für Monolithen nützlich sein, insbesondere aus dem Grund, dass ein typischer Monolith heutzutage kein echter Monolith ist (Details werden später im Vortrag behandelt).
Wie man sieht, unterscheidet sich das endgültige Diagramm (wenn sowohl monolithische als auch mikroservicebasierte Anwendungen in einer Infrastruktur mit Kubernetes betrieben werden) nicht wesentlich von dem ursprünglichen. Im Folgenden wird es um Anwendungen gehen, die mit Kubernetes betrieben werden.
Nützliche und schädliche Mikroservicestruktur
Und hier ist der Hauptgedanke:
Was ist eigentlich eine normale Mikroservicearchitektur? Sie sollte Ihnen einen echten Nutzen bringen, indem sie die Effizienz Ihrer Arbeit erhöht. Wenn man zum Diagramm zurückkehrt, dann sieht man das hier:
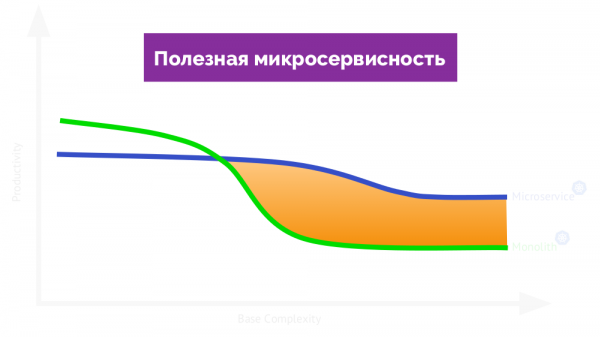
Wenn man sie nützlichnennt, dann wird auf der anderen Seite des Diagramms schädliche Mikroservicestruktur (behindert die Arbeit):
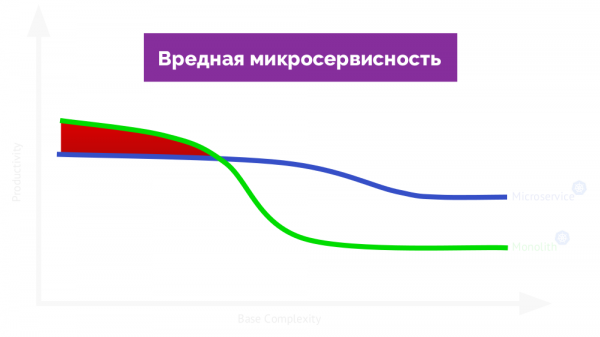
Zurück zur „Hauptidee“: Kann man meiner Erfahrung überhaupt vertrauen? Seit Beginn dieses Jahres habe ich 85 Projektegesehen. Nicht alle waren mikroservices (diese Architektur hatten ungefähr ein Drittel bis die Hälfte davon), aber es ist dennoch eine große Zahl. Uns (der Firma „Flant“) als Outsourcern gelingt es, eine große Vielfalt an Anwendungen zu sehen, die sowohl in kleinen Unternehmen (mit 5 Entwicklern) als auch in großen (~500 Entwicklern) entwickelt werden. Ein zusätzlicher Vorteil ist, dass wir sehen, wie diese Anwendungen über viele Jahre leben und sich entwickeln.
Warum Mikroservices?
Auf die Frage nach dem Nutzen von Mikroservices gibt es von dem bereits erwähnten Martin Fowler:
- klare Modulgrenzen;
- unabhängiges Deployment;
- Freiheit bei der Technologiewahl.
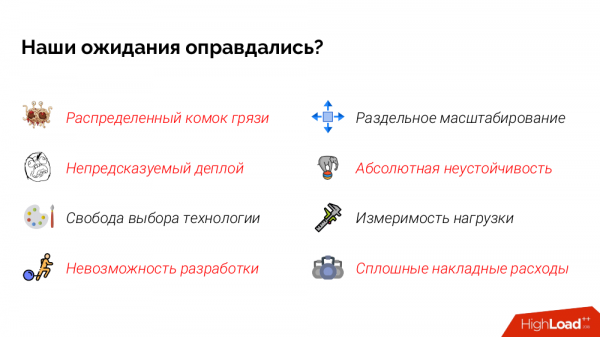
Ich habe viel mit Architekten und Softwareentwicklern gesprochen und gefragt, warum sie Mikroservices benötigen. Und habe meine eigene Liste ihrer Erwartungen zusammengestellt. Das ist das Ergebnis:
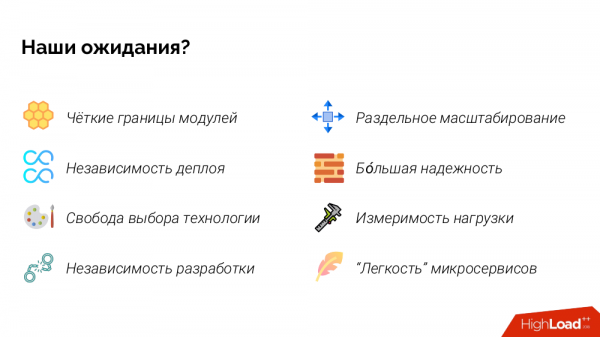
Wenn ich einige Punkte „gefühlsmäßig“ beschreiben sollte:
- klare Modulgrenzen: hier haben wir ein schreckliches Monolith, und jetzt wird alles ordentlich in Git-Repositories aufgeteilt, in denen alles „ordnungsgemäß“ ist, nicht warm mit weich vermischt;
- unabhängiges Deployment: wir können Dienste unabhängig ausrollen, sodass die Entwicklung schneller voranschreiten kann (parallel neue Funktionen veröffentlichen);
- unabhängige Entwicklung: wir können diesen Mikroservice an ein Team/Entwickler abgeben, und die andere an einen anderen, was uns ermöglicht, schneller zu entwickeln;
- bogrößere Zuverlässigkeit: Wenn es zu einer teilweisen Degradation kommt (wenn ein Mikroservice von 20 ausfällt), wird nur ein Knopf nicht mehr funktionieren, während das System insgesamt weiterhin funktioniert.
Typische (schädliche) Mikroservice-Architektur
Um zu erklären, warum in der Realität alles nicht so ist, wie wir es erwarten, werde ich ein sammelnder Bild der Mikroservice-Architektur vorstellen, das auf Erfahrungen aus zahlreichen verschiedenen Projekten basiert.
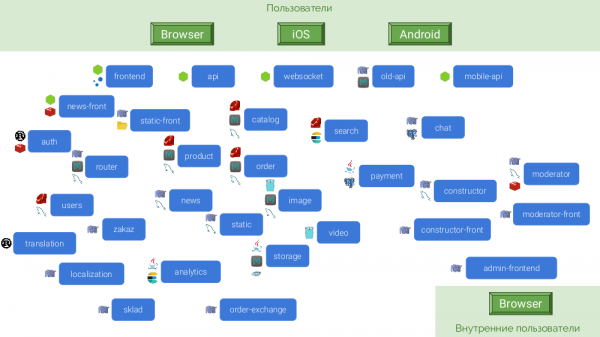
Als Beispiel dient ein abstrakter Online-Shop, der plant, mit Amazon oder zumindest OZON zu konkurrieren. Seine Mikroservice-Architektur sieht folgendermaßen aus:
Aus einer Vielzahl von Gründen sind diese Mikroservices auf unterschiedlichen Plattformen geschrieben worden:

Da jeder Mikroservice Autonomie haben muss, benötigen viele von ihnen eine eigene Datenbank und einen Cache. Die finale Architektur sieht folgendermaßen aus:
Was sind die Folgen?
Bei Fowler gibt es dazu – über die "Preise" für die Nutzung von Mikrodiensten:
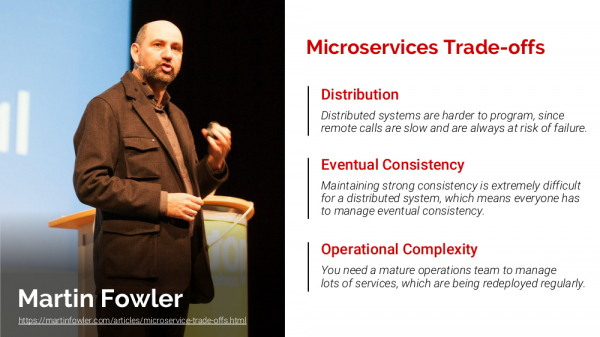
Wir werden sehen, ob unsere Erwartungen erfüllt wurden.
Klare Grenzen der Module…
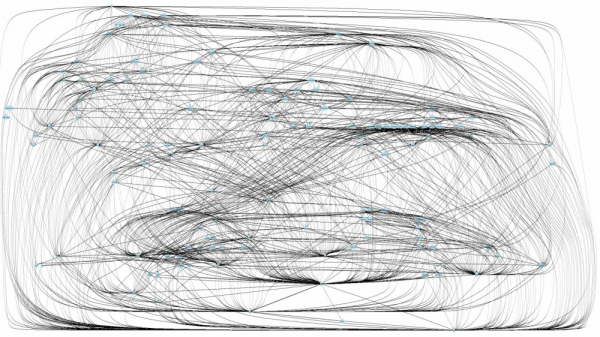
Aber wie viele Mikrodienste tatsächlich angepasst werden müssen, um eine Änderung auszurollen? Können wir überhaupt nachvollziehen, wie alles funktioniert, ohne einen verteilten Tracer (denn jede Anfrage wird von der Hälfte der Mikrodienste verarbeitet)?
Es gibt ein Muster von "", und hier haben wir es sogar mit einem verteilten Klumpen Dreck zu tun. Zur Bestätigung – hier ist eine grobe Illustration, wie Anfragen verlaufen:
Unabhängigkeit beim Deployment…
Technisch ist sie erreicht: wir können jeden Mikrodienst separat ausrollen. In der Praxis ist jedoch zu berücksichtigen, dass immer viele Mikrodienste, und wir müssen die Reihenfolge ihres Rolloutberücksichtigen. Im Idealfall sollten wir sogar in einem separaten Workflow testen, ob wir das Release in der richtigen Reihenfolge ausrollen.
Freiheit in der Technologieauswahl…
Die gibt es. Man sollte jedoch daran denken, dass Freiheit oft an Chaos grenzt. Es ist wichtig, Technologien nicht nur auszuwählen, um damit "zu spielen".
Unabhängigkeit in der Entwicklung…
Wie erstellen wir einen Testablauf für die gesamte Anwendung (aus so vielen Komponenten)? Und zugleich muss er aktuell gehalten werden. Das führt dazu, dass die tatsächliche Anzahl der Testabläufe, die wir prinzipiell aufrechterhalten können, minimal bleibt.
Und alles lokal einzurichten? Es scheint, dass der Entwickler häufig unabhängig arbeitet, aber "ins Blaue hinein", weil er darauf warten muss, dass ein Testablauf frei wird.
Getrenntes Skalieren…
Ja, aber es ist in Bezug auf die verwendeten DBMS eingeschränkt. In dem gegebenen Architekturbeispiel wird es bei Cassandra keine Probleme geben, aber bei MySQL und PostgreSQL schon.
Bogrößere Zuverlässigkeit…
Abgesehen davon, dass die Ausfallzeit eines Mikrodienstes oft das ordnungsgemäße Funktionieren des gesamten Systems stört, gibt es ein neues Problem: jeden Mikrodienst ausfallsicher zu machen, ist sehr schwierig. Denn in Mikrodiensten werden unterschiedliche Technologien verwendet (memcache, Redis usw.), und für jeden muss alles durchdacht und implementiert werden, was natürlich möglich ist, aber enorme Ressourcen erfordert.
Messbarkeit der Last…
Damit ist wirklich alles in Ordnung.
Die "Leichtigkeit" von Microservices…
Wir haben nicht nur enorme Netzwerküberheadkosten (Anfragen an DNS usw. nehmen zu), sondern auch wegen zahlreicher Subanfragen haben wir begonnen, Daten zu replizieren (Caches zu speichern), was zu erheblichem Speicherbedarf geführt hat.
Und so sieht das Ergebnis im Vergleich zu unseren Erwartungen aus:
Das ist aber noch nicht alles!
Denn:
- Wahrscheinlich benötigen wir eine Nachrichtenbus.
- Wie macht man ein konsistentes Backup zu einem bestimmten Zeitpunkt? Die einzige realistische Lösung ist, den Verkehr dafür abzuschalten. Aber wie macht man das in der Produktion?
- Wenn es um die Unterstützung mehrerer Regionen geht, ist es eine sehr aufwendige Aufgabe, die Stabilität in jeder von ihnen zu organisieren.
- Es entsteht das Problem der zentralisierten Änderungen. Zum Beispiel, wenn wir die PHP-Version aktualisieren müssen, müssen wir einen Commit in jedes Repository machen (von denen es Dutzende gibt).
- Das Wachstum der operativen Komplexität scheint exponentiell zu sein.
Was ist mit all dem zu tun?
Beginnen Sie mit einer monolithischen Anwendung. Die Erfahrung von Fowler zeigt, dass fast alle erfolgreichen Microservice-Anwendungen mit einem Monolithen begonnen haben, der zu groß geworden ist, und danach aufgeteilt wurde. Gleichzeitig hatten praktisch alle Systeme, die von Anfang an als Microservices konzipiert wurden, früher oder später ernsthafte Probleme.
Ein weiterer wertvoller Gedanke – damit ein Projekt mit Mikrodienstarchitektur erfolgreich ist, müssen Sie sowohl die Fachdomäne als auch die Erstellung von Microservices sehr gut verstehen.Und der beste Weg, die Fachdomäne zu erlernen, ist, ein Monolith zu erstellen.
Aber was ist zu tun, wenn wir uns bereits in einer solchen Situation befinden?
Der erste Schritt zur Lösung eines Problems besteht darin, es zu akzeptieren und zu verstehen, dass es ein Problem ist, und dass wir nicht länger leiden wollen.
Wenn wir bei einem gewachsenen Monolithen (wenn wir nicht mehr in der Lage sind, Ressourcen dafür hinzuzufügen) ihn aufteilen, ergibt sich in diesem Fall eine umgekehrte Situation: Wenn übermäßige Mikroservice-Architektur nicht hilft, sondern hindert – schneiden Sie das Überflüssige ab und vergrößern Sie!
Zum Beispiel für das oben beschriebene zusammenfassende Bild…
Befreien Sie sich von den fragwürdigsten Microservices:
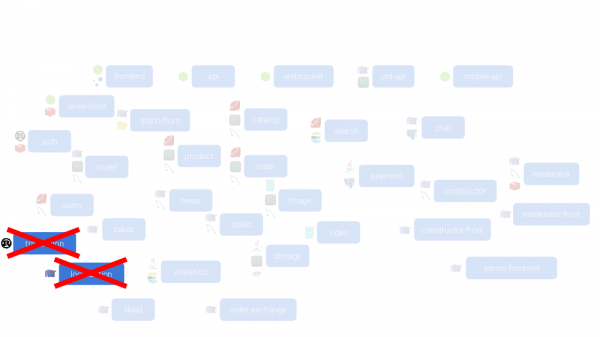
Kombinieren Sie alle Microservices, die für die Frontend-Generierung verantwortlich sind:
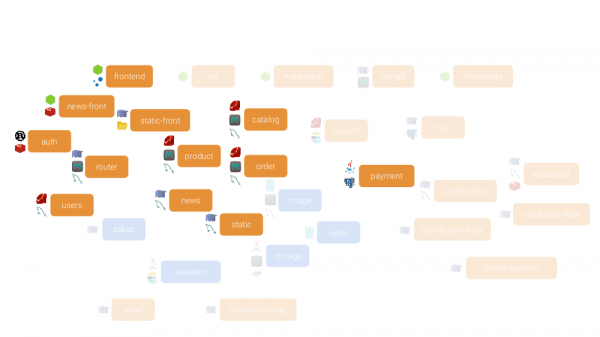
… in einen Mikrodienst, der in einer (modernen und akzeptablen, wie Sie selbst finden) Sprache/Framework geschrieben ist:
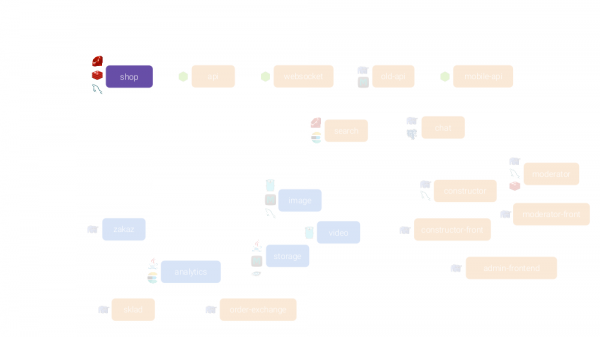
Er wird ein einziges ORM (eine DBMS) und zunächst einige Anwendungen haben:
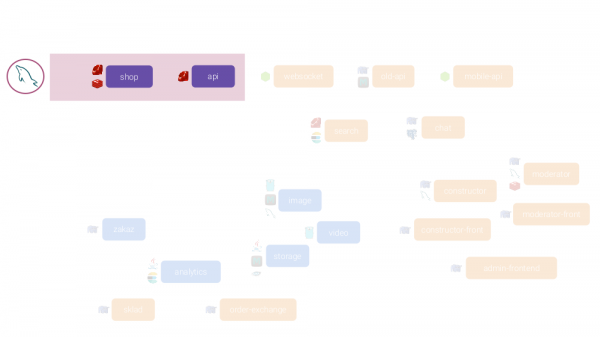
… tatsächlich kann man viel mehr dorthin übertragen und dabei folgendes Ergebnis erzielen:
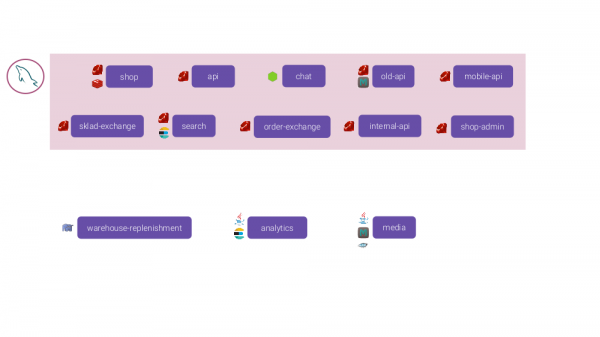
In Kubernetes starten wir all dies mit separaten Instanzen, was bedeutet, dass wir die Last immer noch messen und sie separat skalieren können.
Zusammenfassend
Betrachten Sie das Bild aus einer breiteren Perspektive. Häufig entstehen all diese Probleme mit Mikrodiensten, weil jemand seine eigene Aufgabe genommen hat, aber 'Mikrodienste spielen' wollte.
Im Wort 'Mikrodienste' ist der Teil 'mikro' überflüssig.Sie sind 'mikro' nur, weil sie kleiner als ein riesiges Monolith sind. Aber man sollte nicht denken, dass sie etwas Kleines sind.
Und um zum abschließenden Gedanken zurückzukehren, kommen wir zum ursprünglichen Diagramm:
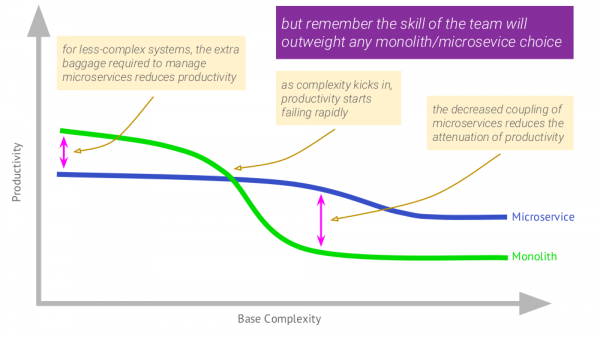
Die dazugehörige Anmerkung (rechts oben) lässt sich darauf reduzieren, dass die Fähigkeiten des Teams, das Ihr Projekt umsetzt, immer primär sind. Sie spielen entscheidend eine Rolle bei Ihrer Entscheidung zwischen Mikrodiensten und Monolith. Wenn dem Team die Fähigkeiten fehlen, aber es beginnt, Mikrodienste zu erstellen, wird die Geschichte mit Sicherheit fatal sein.
Videos und Folien
Das Video der Präsentation (~50 Minuten; leider vermittelt es nicht die zahlreichen Emotionen der Teilnehmer, die das Klima des Vortrags maßgeblich geprägt haben, aber wie es ist):
Präsentation des Berichts:
P.S.
Weitere Präsentationen in unserem Blog:
- «» (Dmitri Stolyarov; 28. Mai 2018 auf RootConf);
- «» (Dmitri Stolyarov; 7. November 2017 auf HighLoad++);
- «» (Dmitri Stolyarov; 6. Juni 2017 auf RootConf);
- «» (Dmitrij Stoljarov; 8. November 2016 auf HighLoad++);
- «» (Dmitrij Stoljarov; 31. Mai 2016 auf RootConf).
Vielleicht interessieren Sie sich auch für folgende Veröffentlichungen:
- «»;
- «»;
- «».
Quelle: habr.com
