

Unser Unternehmen beschäftigt sich seit 2008 überwiegend mit dem Management von Infrastrukturen und der 24/7 technischen Unterstützung von Webprojekten: Wir haben über 400 Kunden, was etwa 15 % des elektronischen Geschäfts in Russland ausmacht. Entsprechend ist die Architektur der Unterstützung sehr vielfältig. Wenn etwas abstürzt, sind wir verpflichtet, es innerhalb von 15 Minuten zu reparieren. Aber um zu verstehen, dass ein Vorfall eingetreten ist, muss man das Projekt überwachen und auf Vorfälle reagieren. Und wie macht man das?
Ich denke, dass im Rahmen der Organisation eines richtigen Monitoring-Systems etwas schiefgeht. Wäre dies nicht der Fall, würde meine Rede aus einem einzigen Punkt bestehen: „Bitte installieren Sie Prometheus + Grafana sowie die Plugins 1, 2, 3“. Leider funktioniert es jetzt so nicht. Das Hauptproblem besteht darin, dass alle weiterhin an etwas glauben, das es 2008 gab, was die Softwarekomponenten betrifft.
Was die Organisation des Monitoring-Systems angeht, wage ich zu behaupten, dass… es keine Projekte mit richtigem Monitoring gibt. Und die Situation ist so schlecht, dass, wenn etwas ausfällt, die Gefahr besteht, dass es unbemerkt bleibt — schließlich sind alle überzeugt, dass „alles überwacht wird“.
Vielleicht wird alles überwacht. Aber wie?
Wir alle haben ähnliche Situationen erlebt: Ein DevOps oder ein Administrator erhält von einem Entwicklerteam die Rückmeldung — „wir haben uns veröffentlicht, jetzt überwache bitte“. Was soll ich überwachen? Wie funktioniert das?
Okay. Wir überwachen auf die alte Art. Doch es hat sich bereits geändert, und es stellt sich heraus, dass du den Dienst A überwacht hast, der zu Dienst B geworden ist, der mit Dienst C interagiert. Aber das Entwicklerteam sagt dir: „Installiere die Software, die sollte doch alles überwachen!“
Was hat sich also geändert? — Alles hat sich geändert!
2008. Alles ist wunderbar.
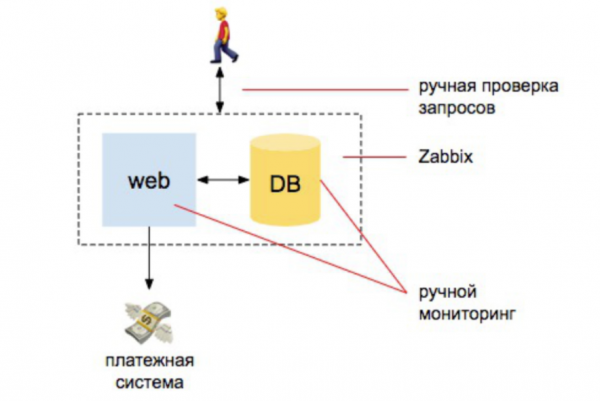
Es gibt ein paar Entwickler, einen Server, einen Datenbankserver. Von hier aus fängt alles an. Wir haben einige Informationen, wir installieren Zabbix, Nagios, Cacti. Und dann stellen wir verständliche Alarme für die CPU, die Festplatte und den Speicherplatz auf den Festplatten ein. Außerdem führen wir ein paar manuelle Überprüfungen durch, um sicherzustellen, dass die Website reagiert und dass Bestellungen in die Datenbank eingehen. Und das war's — wir sind mehr oder weniger geschützt.
Wenn man das Arbeitsvolumen vergleicht, das der Administrator damals für die Überwachung geleistet hat, war es zu 98 % automatisiert: Die Person, die die Überwachung übernimmt, muss verstehen, wie man Zabbix installiert, es konfiguriert und die Alarme einstellt. Und 2 % entfallen auf externe Prüfungen: ob die Website antwortet und eine Abfrage an die Datenbank sendet, ob neue Bestellungen eingegangen sind.
2010. Die Last steigt.
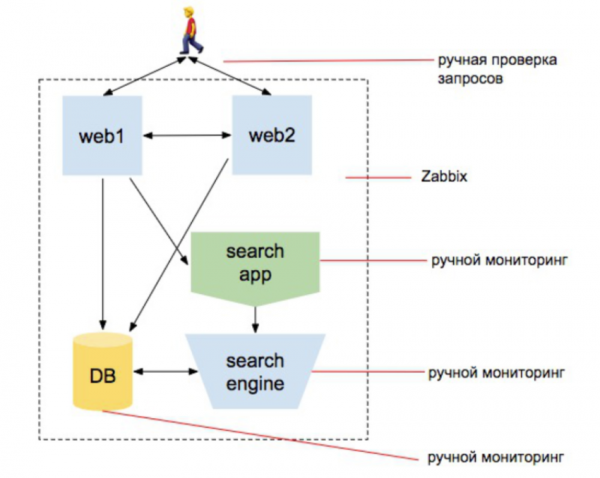
Wir beginnen, die Webservices zu skalieren, fügen eine Suchmaschine hinzu. Wir wollen sicherstellen, dass der Produktkatalog alle Produkte enthält. Und dass die Produktsuche funktioniert. Dass die Datenbank funktioniert, Bestellungen gemacht werden, die Website extern antwortet und mit zwei Server und dass der Benutzer nicht von der Website geworfen wird, während er auf einen anderen Server umgeschaltet wird, usw. Die Anzahl der Entitäten wächst.
Die mit der Infrastruktur verbundene Entität bleibt nach wie vor die größte in den Köpfen der Manager. Es bleibt die Idee im Kopf, dass die Person, die die Überwachung macht, diejenige ist, die Zabbix installiert und konfigurieren kann.
Gleichzeitig entstehen Aufgaben für externe Prüfungen, für die Erstellung eines Sets von Skripten für die Abfragen des Suchindex, eines Sets von Skripten zur Überprüfung, dass sich die Suche während der Indizierung ändert, eines Sets von Skripten, die überprüfen, dass die Produkte an den Lieferservice übermittelt werden, usw.
Beachten Sie: Ich habe dreimal „Set von Skripten“ geschrieben. Das bedeutet, dass die Person, die für die Überwachung verantwortlich ist, nicht mehr nur diejenige ist, die Zabbix installiert. Es ist jemand, der anfängt zu programmieren. Aber in den Köpfen des Teams hat sich bisher nichts geändert.
Dafür verändert sich die Welt und wird immer komplexer. Eine Schicht Virtualisierung wird hinzugefügt, mehrere neue Systeme. Sie beginnen, miteinander zu interagieren. Wer hat gesagt, dass es nach Mikrodiensten riecht? Aber jeder Dienst sieht immer noch für sich allein wie eine Website aus. Wir können darauf zugreifen und verstehen, dass er die notwendigen Informationen bereitstellt und von selbst funktioniert. Und wenn du ein Administrator bist, der ein Projekt betreut, das seit 5-7-10 Jahren wächst, sammelst du dieses Wissen: Es entsteht eine neue Ebene – du hast sie erkannt, dann entsteht eine weitere Ebene – du hast sie erkannt…
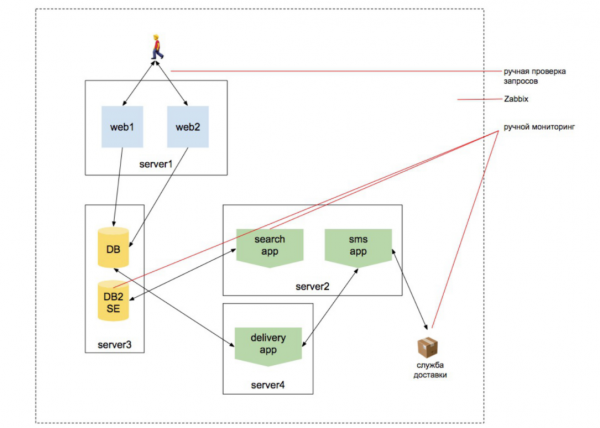
Aber selten begleitet jemand ein Projekt 10 Jahre lang.
Zusammenfassung des Überwachungsexperten
Angenommen, Sie sind in ein neues Startup gekommen, das sofort 20 Entwickler eingestellt und 15 Mikrodienste geschrieben hat, und Sie sind der Administrator, dem gesagt wird: „Baue bitte CI/CD.“ Sie haben CI/CD aufgebaut und plötzlich hören Sie: „Es ist schwierig für uns, im Produktionsbetrieb im ‚Kubik‘ zu arbeiten, ohne zu verstehen, wie die Anwendung darin funktioniert. Mach uns eine Sandbox in diesem ‚Kubik‘.“
Sie erstellen eine Sandbox in diesem Kubik. Sofort wird Ihnen gesagt: „Wir möchten eine Staging-Datenbank, die jeden Tag mit der Produktionsdatenbank aktualisiert wird, um zu verstehen, dass alles auf der Datenbank funktioniert, aber die Produktionsdatenbank nicht zu beschädigen.“
Sie leben in all dem. Es bleiben noch 2 Wochen bis zur Veröffentlichung, und Ihnen wird gesagt: „Jetzt sollten wir das alles überwachen…“ Das heißt, die Clusterinfrastruktur überwachen, die Mikrodienste überwachen, die Arbeit mit externen Diensten überwachen…
Und die Kollegen ziehen eine vertraute Struktur aus dem Kopf und sagen: „Hier ist doch alles klar! Stelle ein Programm ein, das das alles überwacht.“ Ja, ja: Prometheus + Grafana + Plugins.
Und sie fügen hinzu: „Du hast zwei Wochen Zeit, sorge dafür, dass alles zuverlässig ist.“
In vielen Projekten, die wir sehen, wird für die Überwachung eine Person abgestellt. Stellen Sie sich vor, wir möchten für 2 Wochen jemanden einstellen, der sich mit der Überwachung beschäftigt, und wir erstellen seinem Lebenslauf. Über welche Fähigkeiten sollte diese Person verfügen, wenn man alles vorher Gesagte berücksichtigt?
- Er oder sie sollte die Überwachung und die Besonderheiten der Hardwareinfrastruktur verstehen.
- Er oder sie sollte die Besonderheiten der Überwachung von Kubernetes verstehen (alle wollen in den ‚Kubik‘, weil man sich von allem abstrahieren kann, sich verstecken kann, denn um den Rest kümmert sich der Administrator) – sowohl die Plattform selbst als auch die Infrastruktur und verstehen, wie Anwendungen darin überwacht werden.
- Er oder sie muss verstehen, dass die Dienste auf besondere Weise miteinander kommunizieren und die Besonderheiten der Interaktion zwischen den Diensten wissen. Es ist durchaus möglich, ein Projekt zu sehen, in dem einige Dienste synchron kommunizieren, weil es nicht anders geht. Zum Beispiel über REST, über gRPC mit dem Katalogdienst, um eine Liste von Produkten zu erhalten und diese zurückzugeben. Hier kann man nicht warten. Mit anderen Diensten funktioniert er oder sie asynchron. Eine Bestellung an den Lieferservice übermitteln, einen Brief senden usw.
Haben Sie sich wahrscheinlich schon von all dem überwältigt gefühlt? Der Administrator, der das überwachen muss, fühlt sich noch mehr overwhelmed. - Er muss planen können und dies richtig tun – da die Arbeiten immer mehr werden.
- Daher muss er eine Strategie aus dem erstellten Service entwickeln, um zu verstehen, wie man dies konkret überwacht. Er benötigt ein Verständnis der Projektarchitektur und deren Entwicklung sowie der Technologien, die in der Entwicklung verwendet werden.
Erinnern wir uns an einen ganz normalen Fall: Ein Teil der Services läuft auf PHP, ein Teil auf Go, ein Teil auf JS. Sie arbeiten irgendwie zusammen. Daher kam der Begriff 'Mikroservice': Es gibt so viele separate Systeme, dass die Entwickler das Projekt als Ganzes nicht verstehen können. Ein Teil des Teams schreibt Services in JS, die für sich allein arbeiten und nicht wissen, wie der Rest des Systems funktioniert. Ein anderer Teil schreibt Services in Python und kümmert sich nicht darum, wie andere Services arbeiten, sie sind in ihrem Bereich isoliert. Der dritte Teil schreibt Services in PHP oder etwas anderem.
All diese 20 Personen sind auf 15 Services verteilt, und es gibt nur einen Administrator, der das alles verstehen muss. Halt! Wir haben gerade das System in 15 Mikroservices unterteilt, weil 20 Personen das gesamte System nicht verstehen können.
Es muss jedoch irgendwie überwacht werden...
Was bleibt zu sagen? Am Ende gibt es eine Person, in deren Kopf alles Platz hat, was ein ganzes Team von Entwicklern nicht verstehen kann, und gleichzeitig muss sie auch das Wissen und die Fähigkeiten haben, die wir oben angegeben haben – die Hardware-Infrastruktur, die Kubernetes-Infrastruktur usw.
Was soll man dazu sagen… Houston, wir haben ein Problem.
Das Monitoring eines modernen Softwareprojekts ist an sich ein Softwareprojekt.
Aus der falschen Überzeugung, dass Monitoring Software ist, entsteht der Glaube an Wunder. Doch Wunder gibt es leider nicht. Man kann Zabbix nicht einfach installieren und erwarten, dass alles funktioniert. Es macht keinen Sinn, Grafana zu installieren und zu hoffen, dass alles gut wird. Der größte Teil der Zeit wird für die Organisation von Überprüfungen der Funktionsweise der Services und deren Interaktion miteinander sowie für die Überprüfungen, wie externe Systeme funktionieren, aufgewendet. Tatsächlich werden 90 % der Zeit nicht für das Schreiben von Skripten, sondern für die Entwicklung von Software aufgewendet. Und das sollte ein Team tun, das das Projekt versteht.
Wenn in dieser Situation eine Person für das Monitoring eingesetzt wird, wird es zu Problemen kommen. Und das passiert überall.
Zum Beispiel gibt es mehrere Dienste, die über Kafka miteinander kommunizieren. Eine Bestellung kommt herein, wir haben die Bestellnachricht an Kafka gesendet. Es gibt einen Dienst, der Informationen über die Bestellung hört und die Warenlieferung durchführt. Es gibt einen Dienst, der Informationen über die Bestellung hört und eine E-Mail an den Benutzer sendet. Und dann tauchen noch viele weitere Dienste auf, und wir beginnen, uns zu verwirren.
Und wenn Sie dies auch noch an den Administrator und die Entwickler in der Phase abgeben, in der bis zur Veröffentlichung nur wenig Zeit bleibt, muss die Person das gesamte Protokoll verstehen. Das heißt, ein Projekt dieser Größenordnung benötigt erhebliche Zeit, und das muss in die Systementwicklung eingeplant werden.
Aber sehr oft, besonders in der Gründung, sehen wir, wie das Monitoring aufgeschoben wird. "Jetzt machen wir einen Proof of Concept, starten damit, lassen ihn abstürzen – wir sind bereit, Opfer zu bringen. Und dann werden wir alles überwachen." Wenn (oder falls) das Projekt beginnt, Geld zu bringen, möchte das Geschäft noch mehr Funktionen entwickeln – denn es fängt an zu funktionieren, also muss man weiter anpassen! Aber Sie befinden sich an dem Punkt, an dem man zuerst alles frühere überwachen muss, was nicht 1% der Zeit in Anspruch nimmt, sondern deutlich mehr. Und übrigens werden für das Monitoring Entwickler benötigt, und es ist einfacher, diese für neue Funktionen zu nutzen. Am Ende werden neue Funktionen geschrieben, alles wird angepasst, und Sie stecken in einem endlosen Deadlock.
Wie also können Sie ein Projekt von Anfang an überwachen, und was tun, wenn Sie ein Projekt erhalten haben, das überwacht werden muss, und Sie nicht wissen, wo Sie anfangen sollen?
Zunächst einmal müssen Sie planen.
Ein lyrischer Einschub: Häufig beginnt man mit der Überwachung der Infrastruktur. Zum Beispiel haben wir Kubernetes. Lassen Sie uns damit beginnen, dass wir Prometheus mit Grafana installieren und Plugins für die Überwachung des "Kubik" setzen. Nicht nur bei den Entwicklern, sondern auch bei den Administratoren gibt es die bedauerliche Praxis: "Wir installieren dieses Plugin, und das Plugin weiß wahrscheinlich, wie man das macht." Die Leute beginnen gerne mit einfachen und verständlichen Dingen statt mit wichtigen Maßnahmen. Und die Überwachung der Infrastruktur ist einfach.
Zuerst müssen Sie entscheiden, was und wie Sie überwachen möchten, und dann das passende Werkzeug auswählen, denn andere Leute können nicht für Sie nachdenken. Und sollten sie das? Andere Leute dachten über sich selbst, über das universelle System — oder dachten gar nicht nach, als dieses Plugin geschrieben wurde. Und die Tatsache, dass dieses Plugin 5000 Benutzer hat, bedeutet nicht, dass es irgendeinen Nutzen bringt. Möglicherweise werden Sie der 5001. sein, nur weil dort zuvor schon 5000 Leute waren.
Wenn Sie mit der Überwachung der Infrastruktur begonnen haben und der Backend Ihres Anwendungsprogramms nicht mehr reagiert, verlieren alle Benutzer die Verbindung zur mobilen Anwendung. Es wird ein Fehler auftreten. Sie werden zu Ihnen kommen und sagen: „Die Anwendung funktioniert nicht, was machen Sie hier?“ — „Wir überwachen.“ — „Wie können Sie überwachen, wenn Sie nicht sehen, dass die Anwendung nicht funktioniert?!“
- Ich denke, dass man mit der Überwachung unbedingt am Einstiegspunkt des Benutzers beginnen sollte. Wenn der Benutzer nicht sieht, dass die Anwendung funktioniert — das ist ein Fehlschlag. Und das Überwachungssystem sollte in erster Linie darüber informieren.
- Und erst danach können wir die Infrastruktur überwachen. Oder wir können das parallel machen. Mit der Infrastruktur ist es einfacher — hier können wir endlich einfach Zabbix installieren.
- Und jetzt müssen wir in die Wurzeln der Anwendung gehen, um zu verstehen, wo es nicht funktioniert.
Mein Hauptgedanke ist, dass die Überwachung parallel zum Entwicklungsprozess erfolgen sollte. Wenn Sie das Überwachungsteam auf andere Aufgaben (Erstellung von CI/CD, Sandbox, Umstrukturierung der Infrastruktur) ablenken, wird die Überwachung ins Hintertreffen geraten und Sie werden wahrscheinlich niemals die Entwicklung einholen (oder irgendwann werden Sie sie stoppen müssen).
Alles nach Ebenen
So sehe ich die Organisation des Überwachungssystems.
1) Anwendungsebene:
- Überwachung der Geschäftslogik der Anwendung;
- Überwachung der Gesundheitsmetriken der Dienste;
- Integrationsüberwachung.
2) Infrastrukturebene:
- Überwachung der Orchestrierungsebene;
- Überwachung der Systemsoftware;
- Überwachung der Hardwareebene.
3) Wieder Anwendungsebene — aber bereits als Ingenieurdokument:
- Sammlung und Beobachtung der Protokolle der Anwendung;
- APM;
- Tracing.
4) Alarmierung:
- Organisation des Benachrichtigungssystems;
- Organisation des Bereitschaftssystems;
- Organisation einer „Wissensbasis“ und Workflow zur Bearbeitung von Vorfällen.
Wichtig: Wir gehen direkt zum Alerting über, nicht später, sondern sofort! Es ist nicht nötig, das Monitoring zu starten und sich dann »irgendwie später« zu überlegen, wer die Alarme erhalten soll. Schließlich besteht die Aufgabe des Monitorings darin, zu verstehen, wo im System etwas nicht funktioniert, und die entsprechenden Personen darüber zu informieren. Wenn man das bis zum Ende aufschiebt, erfahren die benötigten Personen nur durch einen Anruf »bei uns funktioniert nichts« davon, dass etwas schiefgeht.
Anwendungsebene – Monitoring der Geschäftslogik
Hier geht es um die Überprüfung, ob die Anwendung für den Benutzer tatsächlich funktioniert.
Diese Ebene sollte in der Entwicklungsphase erstellt werden. Zum Beispiel haben wir einen hypothetischen Prometheus: Er greift auf einen Server zu, der die Überprüfungen durchführt, zieht einen Endpoint und dieser Endpoint prüft die API.
Wenn häufig gebeten wird, die Startseite zu monitoren, um sicherzustellen, dass die Website funktioniert, geben die Programmierer einen Handgriff, den man jedes Mal ziehen kann, wenn man überprüfen möchte, ob die API funktioniert. Und in diesem Moment schreiben die Programmierer auch /api/test/helloworld.
Der einzige Weg zu überprüfen, ob alles funktioniert? – Nein!
- Die Erstellung solcher Überprüfungen ist im Wesentlichen die Aufgabe der Entwickler. Unit-Tests sollten von den Programmierern geschrieben werden, die den Code schreiben. Denn wenn Sie das einem Administrator überlassen: »Hey, hier ist die Liste der API-Protokolle aller 25 Funktionen, bitte monitoren Sie alles!« – wird das nichts werden.
- Wenn Sie »hello world« drucken, wird niemand jemals erfahren, dass die API funktionieren sollte und tatsächlich funktioniert. Jede Änderung der API sollte eine Änderung der Überprüfungen nach sich ziehen.
- Wenn Sie bereits ein Problem haben – stoppen Sie die Funktionen und weisen Sie Entwickler zu, die diese Überprüfungen schreiben, oder akzeptieren Sie die Verluste, akzeptieren Sie, dass nichts überprüft wird und es zu Ausfällen kommen wird.
Technische Tipps:
- Organisieren Sie unbedingt einen externen Server für die Durchführung von Überprüfungen – Sie müssen sicherstellen, dass Ihr Projekt für die Außenwelt zugänglich ist.
- Organisieren Sie die Überprüfung über das gesamte API-Protokoll und nicht nur über einzelne Endpoints.
- Erstellen Sie einen Prometheus-Endpoint mit den Ergebnissen der Überprüfungen.
Anwendungsebene – Monitoring der Gesundheitsmetriken
Jetzt geht es um externe Gesundheitsmetriken der Dienste.
Wir haben beschlossen, dass wir alle "Handles" der Anwendung über externe Prüfungen überwachen, die wir aus einem externen Überwachungssystem aufrufen. Aber es sind genau diese "Handles", die der Benutzer "sieht". Wir möchten jedoch sicher sein, dass die Dienste selbst funktionieren. Hier sieht es besser aus: In K8s gibt es Health-Checks, damit sich zumindest der "Pod" vergewissert, dass der Dienst funktioniert. Aber die Hälfte der Checks, die ich gesehen habe, sind einfach nur der gleiche Print "hello world". D.h. er wird einmal nach dem Deployment aufgerufen, ihm wurde geantwortet, dass alles in Ordnung ist – und das war's. Ein Dienst hat, wenn er über REST seinen API ausgibt, eine riesige Anzahl an Einstiegspunkten des API, die ebenfalls überwacht werden müssen, denn wir möchten wissen, ob er funktioniert. Und wir überwachen ihn bereits intern.
Wie kann man das technisch richtig umsetzen: Jeder Dienst veröffentlicht einen Endpoint über seine aktuelle Betriebsbereitschaft, und in den Grafiken von Grafana (oder einer anderen Anwendung) sehen wir den Status aller Dienste.
- Jede Änderung der API muss eine Änderung der Checks nach sich ziehen.
- Erstellen Sie neue Dienste sofort mit Health-Metriken.
- Der Administrator kann zu den Entwicklern kommen und sie bitten: "Fügen Sie mir ein paar Funktionen hinzu, damit ich alles verstehe und diese Informationen in mein Überwachungssystem integrieren kann." Aber die Entwickler antworten normalerweise: "Zwei Wochen vor dem Release werden wir nichts mehr hinzufügen."
Lassen Sie die Entwicklungsmanager wissen, dass solche Verluste auftreten werden, und lassen Sie das Management der Entwicklungsmanager ebenfalls informiert sein. Denn wenn alles ausfällt, wird trotzdem jemand anrufen und verlangen, den "ständig abstürzenden Dienst" (c) zu überwachen. - Übrigens, stellen Sie Entwickler für die Erstellung von Plugins für Grafana ein – das wird eine große Hilfe für die Administratoren sein.
Anwendungsebene – Integrationsüberwachung
Die Integrationsüberwachung konzentriert sich auf die Überwachung der Kommunikation zwischen geschäftskritischen Systemen.
Zum Beispiel gibt es 15 Dienste, die miteinander kommunizieren. Das sind keine separaten Websites mehr. D.h. wir können den Dienst nicht isoliert aufrufen, um /helloworld zu erhalten und zu verstehen, dass der Dienst funktioniert. Denn der Webdienst zur Auftragsbearbeitung muss Informationen über den Auftrag an den Bus senden – der Bus muss diese Nachricht empfangen und weiterverarbeiten, und die E-Mail-Versanddienst muss dies ebenfalls weiterverarbeiten, usw.
Daher können wir nicht verstehen, indem wir uns in jeden einzelnen Dienst tasten, dass alles funktioniert. Denn wir haben eine Art Bus, über den alles kommuniziert und interagiert.
Daher sollte dieser Schritt die Phase der Dienstetestung im Zusammenhang mit anderen Diensten kennzeichnen. Man kann, nachdem man einen Nachrichtenbroker überwacht hat, kein Monitoring der Kommunikation organisieren. Wenn es einen Dienst gibt, der Daten bereitstellt, und einen Dienst, der sie empfängt, sehen wir beim Monitoring des Brokers nur die Daten, die hin und her fliegen. Selbst wenn wir es irgendwie schaffen, die Interaktion dieser Daten intern zu überwachen – dass ein Producer Daten veröffentlicht, die jemand liest, und dieser Strom weiter in Kafka fließt – wird uns das nicht helfen, wenn ein Dienst die Nachricht in einer Version gesendet hat, der andere Dienst jedoch diese Version nicht erwartet hat und sie übersprungen hat. Davon erfahren wir nichts, da die Dienste uns sagen, dass alles funktioniert.
Wie ich empfehle:
- Für synchrone Kommunikation: Der Endpoint führt Anfragen an die verknüpften Dienste aus. Das heißt, wir nehmen diesen Endpoint, rufen ein Skript innerhalb des Dienstes auf, das alle Punkte durchläuft und sagt: „Ich kann dort anfragen, und dort anfragen, ich kann dort anfragen…“
- Für asynchrone Kommunikation: Eingehende Nachrichten – der Endpoint überprüft den Bus auf Testnachrichten und gibt den Verarbeitungsstatus aus.
- Für asynchrone Kommunikation: Ausgehende Nachrichten – der Endpoint sendet Testnachrichten an den Bus.
Wie das normalerweise funktioniert: Wir haben einen Dienst, der Daten in den Bus einspeist. Wir gehen zu diesem Dienst und bitten ihn, uns von seinem Integrationszustand zu berichten. Wenn der Dienst eine Nachricht irgendwo weiterproduzieren soll (WebApp), dann produziert er diese Testnachricht. Wenn wir den Dienst auf der Seite OrderProcessing anstoßen, veröffentlicht er zuerst, was er unabhängig veröffentlichen kann, und wenn es abhängige Elemente gibt, liest er eine Reihe von Testnachrichten aus dem Bus, erkennt, dass er diese verarbeiten kann, meldet das und, falls nötig, veröffentlicht er sie weiter, und darüber informiert er uns – alles in Ordnung, ich bin am Leben.
Sehr oft hören wir die Frage: „Wie können wir das mit echten Daten testen?“ Zum Beispiel geht es um denselben Bestellservice. Eine Bestellung sendet Nachrichten an das Lager, wo Produkte abgebucht werden: Wir können das nicht mit echten Daten testen, denn „ich werde Produkte abbuchen!“ Die Lösung: Planen Sie diesen Test von Anfang an. Sie haben Unit-Tests, die Mocks erstellen. Machen Sie dies auf einer tieferen Ebene, wo Sie einen Kommunikationskanal haben, der den Geschäftsbetrieb nicht stört.
Infrastrukturebene
Monitoring der Infrastruktur – das, was seit langem als das Monitoring an sich betrachtet wird.
- Monitoring der Infrastruktur kann und sollte als ein separater Prozess gestartet werden.
- Man sollte nicht mit dem Monitoring der Infrastruktur in einem laufenden Projekt beginnen, auch wenn man es unbedingt möchte. Das ist ein Schmerzpunkt für alle DevOps. „Zuerst mache ich das Cluster- und Infrastruktur-Monitoring“ – das heißt, zuerst wird das, was unten liegt, überwacht, und die Anwendung wird ignoriert. Denn die Anwendung ist ein unverständliches Ding für den DevOps. Ihm wurde das übergeben, und er versteht nicht, wie es funktioniert. Aber die Infrastruktur versteht er und beginnt damit. Doch nein – man muss immer zuerst die Anwendung überwachen.
- Übertreiben Sie es nicht mit der Anzahl der Benachrichtigungen. Angesichts der Komplexität moderner Systeme kommen ständig Warnmeldungen, und man muss mit diesem Berg von Warnungen irgendwie umgehen. Und die Person im Bereitschaftsdienst wird, wenn sie auf einhundert neue Warnungen schaut, entscheiden: „Ich will nicht darüber nachdenken.“ Warnungen sollten nur über kritische Dinge informieren.
Anwendungsebene als Geschäftseinheit
Schlüsselpunkte:
- ELK. Dies ist der Industriestandard. Wenn Sie aus irgendeinem Grund keine Protokolle aggregieren, beginnen Sie dringend damit.
- APM. Externe APMs als Möglichkeit, das Monitoring der Anwendung schnell zu schließen (NewRelic, BlackFire, Datadog). Sie können vorübergehend dieses Tool einsetzen, um irgendwie zu verstehen, was bei Ihnen passiert.
- Tracing. In Dutzenden von Mikrodiensten müssen Sie alles nachverfolgen, denn die Anfrage lebt nicht mehr für sich allein. Später nachzutragen ist sehr schwierig, daher ist es besser, Tracing von Anfang an in die Entwicklung einzuplanen – das ist die Aufgabe und das Werkzeug der Entwickler. Falls es noch nicht implementiert wurde – implementieren Sie es! Siehe Jaeger/Zipkin
Alerting
- Organisation des Alarmierungssystems: In einer Situation, in der eine Vielzahl von Dingen überwacht wird, muss es ein einheitliches System zur Versendung von Alarmen geben. Das kann in Grafana erfolgen. Im Westen verwenden alle PagerDuty. Die Benachrichtigungen sollten verständlich sein (zum Beispiel, woher sie stammen…). Und es wäre wünschenswert, zu kontrollieren, dass die Benachrichtigungen überhaupt ankommen.
- Organisation des Bereitschaftsdienstes: Alarme sollten nicht an alle gesendet werden (ansonsten reagieren alle in Scharen oder niemand reagiert). Oncall sollte auch für Entwickler bestehen: Definieren Sie unbedingt die Verantwortungsbereiche, erstellen Sie eine klare Anleitung und schreiben Sie dort auf, wen man konkret am Montag und Mittwoch anruft und wen am Dienstag und Freitag (ansonsten wird niemand sogar im Falle eines großen Notfalls anrufen — sie haben Angst, jemanden zu wecken oder zu stören: Menschen wehren sich generell gegen Anrufe, besonders nachts). Erklären Sie, dass die Bitte um Hilfe kein Zeichen von Unkompetenz ist ("Ich bitte um Hilfe — das bedeutet, ich bin ein schlechter Mitarbeiter"), und ermutigen Sie, um Hilfe zu bitten.
- Organisation der Wissensdatenbank und des Workflows zur Bearbeitung von Vorfällen: Für jeden ernsthaften Vorfall sollte ein Postmortem eingeplant werden, und als temporäre Maßnahme sollten die Maßnahmen festgehalten werden, die den Vorfall lösen. Und etablieren Sie die Praxis, dass wiederholte Alarme ein Fehler sind; sie müssen im Code oder in der Infrastruktur behoben werden.
Technologischer Stack
Nehmen wir an, dass unser Stack folgendermaßen aussieht:
- Datensammlung — Prometheus + Grafana;
- Protokollanalyse — ELK;
- für APM oder Tracing — Jaeger (Zipkin).

Die Auswahl der Optionen ist nicht kritisch. Denn wenn Sie zu Beginn verstanden haben, wie Sie das System überwachen und einen Plan ausgearbeitet haben, wählen Sie später die Werkzeuge entsprechend Ihren Anforderungen. Die Frage ist, was Sie zu Beginn überwacht haben. Denn möglicherweise ist das Werkzeug, das Sie zu Beginn gewählt haben, überhaupt nicht geeignet für Ihre Anforderungen.
Einige technische Punkte, die ich in letzter Zeit überall sehe:
Prometheus wird in Kubernetes integriert — wer hat sich das ausgedacht?! Wenn Ihr Cluster ausfällt, was werden Sie tun? Wenn Sie einen komplexen Cluster haben, sollte es ein Monitoring-System innerhalb des Clusters geben, und eines außerhalb, das Daten aus dem Inneren des Clusters sammelt.
Innerhalb des Clusters sammeln wir Logs und alles andere. Aber das Überwachungssystem sollte sich außerhalb befinden. Sehr oft in einem Cluster, in dem Prometheus installiert ist, befinden sich dort auch Systeme, die externe Überprüfungen der Website durchführen. Und was passiert, wenn Ihre Verbindungen zur Außenwelt ausfallen und die Anwendung nicht funktioniert? Es ist alles gut bei Ihnen innen, aber den Benutzern bringt das nichts.
Das DBMS Tarantool ist ein attraktives, zukunftsträchtiges Produkt zur Erstellung von hochbelasteten Anwendungen.
- Die Entwicklung von Monitoring ist nicht die Installation von Tools, sondern die Entwicklung eines Softwareprodukts. 98 % des heutigen Monitorings bestehen aus Programmierung. Programmierung in Diensten, Programmierung von externen Überprüfungen, Überprüfungen externer Dienste und so weiter.
- Verschwenden Sie keine Zeit der Entwickler für das Monitoring: Es kann bis zu 30 % ihrer Arbeit in Anspruch nehmen, aber es lohnt sich.
- DevOps, macht euch keine Sorgen, wenn es euch nicht gelingt, etwas zu überwachen, denn einige Dinge haben eine ganz andere Denkweise. Ihr wart keine Programmierer, und das Monitoring ist genau deren Aufgabe.
- Wenn das Projekt bereits läuft und nicht überwacht wird (und Sie Manager sind) – stellen Sie Ressourcen für das Monitoring bereit.
- Wenn das Produkt bereits in der Produktion ist und Sie DevOps sind, dem gesagt wurde, "richte das Monitoring ein" – versuchen Sie, der Geschäftsführung zu erklären, worüber ich hier geschrieben habe.
Das ist die erweiterte Version eines Vortrags auf der Konferenz Saint Highload++.
Wenn Sie an meinen Ideen und Überlegungen zu IT und verwandten Themen interessiert sind, können Sie hier: 🙂
Quelle: habr.com
