

Ingenieur - übersetzt aus dem Lateinischen - inspiriert.
Ein Ingenieur kann alles. (c) R.Diesel.
Epigrafen.
Oder die Geschichte darüber, warum ein Datenbankadministrator an seine Programmiervergangenheit denken sollte.
Vorwort
Alle Namen wurden geändert. Zufällige Übereinstimmungen. Das Material stellt ausschließlich die persönliche Meinung des Autors dar.
Haftungsausschluss für Garantien: In dem geplanten Artikelzyklus wird es keine detaillierte und präzise Beschreibung der verwendeten Tabellen und Skripte geben. Materialien können nicht sofort "AS IS" verwendet werden.
Erstens aufgrund des großen Materialumfangs,
zweitens aufgrund der Anpassung an die Produktionsdatenbank eines realen Kunden.
Deshalb werden in den Artikeln nur Ideen und Beschreibungen in den allgemeinsten Zügen dargestellt.
Vielleicht wird das System in Zukunft auf das Niveau eines Uploads auf GitHub wachsen, vielleicht auch nicht. Die Zeit wird es zeigen.
Der Beginn der Geschichte - "».
Was dabei herauskam, in groben Zügen - "»
Warum brauche ich das alles?
Nun, erstens, um selbst nicht zu vergessen, wenn ich im Ruhestand an die glorreichen Zeiten zurückdenke.
Zweitens, um das Geschriebene zu systematisieren. Denn selbst ich fange manchmal an, mich in einzelnen Teilen zu verwirren und zu vergessen.
Und das Wichtigste ist - vielleicht könnte es jemandem nützlich sein und helfen, das Rad nicht neu zu erfinden und keine Fehler zu machen. Mit anderen Worten, seine Karma zu verbessern (nicht das von Habr). Denn das Wertvollste in dieser Welt sind Ideen. Das Wichtigste ist, die Idee zu finden. Die Idee in die Realität umzusetzen, das ist bereits eine rein technische Frage.
Also, fangen wir langsam an...
Die Aufgabenstellung.
Verfügbar:
PostgreSQL-Datenbank (10.5), gemischte Lastart (OLTP+DSS), mittlere bis geringe Belastung, in der AWS-Cloud gehostet.
Die Datenbanküberwachung fehlt, die Infrastrukturüberwachung erfolgt mit den standardmäßigen AWS-Tools in minimaler Konfiguration.
Erforderlich:
Die Leistung und den Zustand der Datenbank überwachen, Informationen zur Optimierung von schweren Abfragen zur Verfügung haben.
Kurze Einleitung oder Analyse der Lösungsmöglichkeiten
Zunächst versuchen wir, die Lösungsmöglichkeiten aus der Sicht eines vergleichenden Nutzen- und Nachteilanalyses für den Ingenieur zu betrachten, während das Management sich um Nutzen und Verluste kümmern kann, wie es im Stellenplan vorgesehen ist.
Option 1 - "On-Demand-Arbeiten"
Wir lassen alles wie es ist. Wenn der Auftraggeber mit der Funktionsweise oder Leistung der Datenbank oder Anwendung unzufrieden ist, wird er die DBA-Ingenieure per E-Mail benachrichtigen oder einen Vorfall im Ticketsystem erstellen.
Der Ingenieur, der die Benachrichtigung erhält, wird das Problem analysieren, eine Lösung vorschlagen oder das Problem auf die lange Bank schieben, in der Hoffnung, dass sich alles von selbst löst, und ohnehin wird alles bald vergessen sein.
Pfeffernüsse und Krapfen, blaue Flecken und BeulenPfeffernüsse und Krapfen:
1. Es ist nicht notwendig, etwas Überflüssiges zu tun.
2. Es gibt immer die Möglichkeit, sich herauszuwinden und sich zu drücken.
3. Eine Menge Zeit, die man nach eigenem Ermessen verschwenden kann.
Blaue Flecken und Beulen:
1. Früher oder später wird der Auftraggeber über die Essenz der Existenz und die universelle Gerechtigkeit in dieser Welt nachdenken und sich erneut die Frage stellen – wofür bezahle ich ihnen mein Geld? Die Konsequenz ist immer gleich – die Frage ist nur, wann der Auftraggeber gelangweilt wird und auf Wiedersehen winkt. Und die Futterstelle wird leer sein. Das ist traurig.
2. Die Entwicklung des Ingenieurs – Null.
3. Schwierigkeiten bei der Planung der Arbeit und der Auslastung.
Option 2 – „Wir tanzen mit Trommeln, verkaufen und kleiden ein.“
Punkt 1- Warum brauchen wir ein Überwachungssystem? Wir werden alles über Anfragen erhalten. Eine ganze Reihe von Anfragen an das Datenlexikon und dynamische Ansichten starten, verschiedene Zähler aktivieren, alles in Tabellen zusammenfassen, und gelegentlich sozusagen Listen und Tabellen analysieren. In der Folge erhalten wir schöne oder weniger schöne Grafiken, Tabellen, Berichte. Das Wichtigste ist, dass es mehr und mehr gibt.
Punkt 2- Wir generieren Aktivität – analysieren all das.
Punkt 3- Wir bereiten ein Dokument vor, nennen es einfach – „Wie wir die Datenbank einrichten“.
Punkt 4- Der Auftraggeber, der all diese Pracht von Grafiken und Zahlen sieht, ist in den kindlichen naiven Überzeugung, dass jetzt alles bei uns bald funktionieren wird. Und er gibt leicht und schmerzlos seine Geldressourcen aus. Das Management ist ebenfalls überzeugt – unsere Ingenieure arbeiten großartig. Die Auslastung auf dem Maximum.
Punkt 5- Punkt 1 regelmäßig wiederholen.
Pfeffernüsse und Krapfen, blaue Flecken und BeulenPfeffernüsse und Krapfen:
1. Das Leben der Manager und Ingenieure ist einfach, vorhersehbar und voller Aktivität. Alles summt, alle sind beschäftigt.
2. Das Leben des Auftraggebers ist auch nicht schlecht – er ist sich immer sicher, dass es nur ein bisschen Geduld braucht und alles sich regeln wird. Klappt es nicht, na ja, was soll’s – diese Welt ist ungerecht, im nächsten Leben wird es besser.
Blaue Flecken und Beulen:
1. Früher oder später wird es einen schnelleren Anbieter für einen ähnlichen Service geben, der das Gleiche ein bisschen günstiger macht. Und wenn das Ergebnis dasselbe ist, warum mehr bezahlen? Das wird wiederum zur Abwanderung führen.
2. Es ist langweilig. So langweilig wie jede wenig sinnvolle Aktivität.
3. Wie im vorherigen Fall gibt es keine Entwicklung. Aber für den Ingenieur ist der Nachteil, dass hier im Unterschied zur ersten Option ständig eine Datenbasis generiert werden muss. Und das kostet Zeit. Die man für sich selbst sinnvoll nutzen könnte. Denn wenn man sich nicht selbst um sich kümmert, interessiert es niemanden.
Option 3 - Man muss nicht das Rad neu erfinden, man sollte es kaufen und fahren.
Die Ingenieure anderer Unternehmen essen nicht ohne Grund Pizza mit Bier (ah, die guten Zeiten in St. Petersburg in den 90ern). Lassen Sie uns Überwachungssysteme nutzen, die entwickelt, abgestimmt und einsatzbereit sind und tatsächlich einen Nutzen bringen (mindestens für ihre Entwickler).
Pfeffernüsse und Krapfen, blaue Flecken und BeulenPfeffernüsse und Krapfen:
1. Man muss keine Zeit mit dem Erfinden von Dingen verschwenden, die bereits erfunden sind. Nimm und nutze sie.
2. Überwachungssysteme werden nicht von Dummköpfen entwickelt, und sie sind natürlich nützlich.
3. Funktionierende Überwachungssysteme liefern in der Regel nützliche gefilterte Informationen.
Blaue Flecken und Beulen:
1. Der Ingenieur ist in diesem Fall kein Ingenieur, sondern lediglich ein Nutzer eines fremden Produkts. Oder ein User.
2. Der Kunde muss davon überzeugt werden, etwas zu kaufen, wovon er im Grunde genommen keine Ahnung hat, und das sollte er auch nicht, und das Budget für das Jahr ist genehmigt und wird sich nicht ändern. Dann muss man separate Ressourcen bereitstellen und diese auf das spezifische System einrichten. Das bedeutet, zuerst muss man bezahlen, zahlen und noch einmal zahlen. Und der Kunde ist geizig. Das ist die Norm in diesem Leben.
Was tun - Tschernyschewski? Deine Frage ist durchaus berechtigt. (c)
In diesem konkreten Fall und der entstandenen Situation kann man es ein bisschen anders angehen - Lassen Sie uns unser eigenes Überwachungssystem erstellen.
Nun, nicht wirklich ein System im vollen Sinne des Wortes, das wäre zu hochtrabend und überheblich gesagt, aber dennoch sich selbst die Aufgabe erleichtern und mehr Informationen zur Lösung von Leistungsproblemen sammeln. Um nicht in die Situation zu kommen - "geh dorthin, wo du nicht weißt, und finde das, was du nicht weißt."
Was sind die Vor- und Nachteile dieser Option:
Vorteile:
1. Es ist interessant. Nun, mindestens interessanter als die ständigen "shrink datafile, alter tablespace, usw."
2. Das sind neue Fähigkeiten und neue Entwicklungen. Was perspektivisch früher oder später gebührende Belohnungen und Leckereien bringen wird.
Nachteile:
1. Man wird arbeiten müssen. Viel arbeiten.
2. Man wird regelmäßig den Sinn und die Perspektiven der gesamten Aktivitäten erklären müssen.
3. Auf etwas wird man ein Opfer bringen müssen, denn die einzige verfügbare Ressource für den Ingenieur – die Zeit – ist im Universum begrenzt.
4. Das Schlimmste und Unangenehmste — könnte ein Ergebnis hervorrufen, das wie „weder ein Mäuschen noch ein Frosch, sondern ein unbekanntes Tier“ aussieht.
Wer nicht wagt, der nicht gewinnt.
So — jetzt beginnt das Interessanteste.
Die allgemeine Idee — schematisch
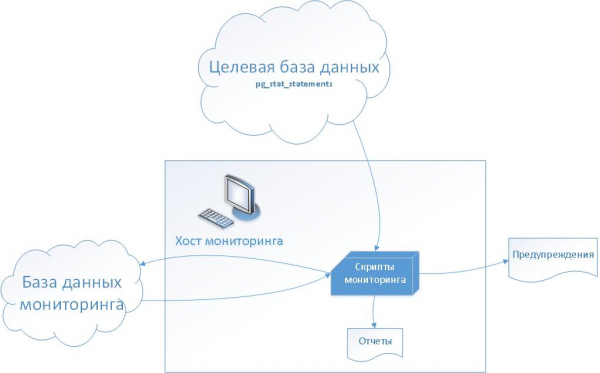
(Die Abbildung stammt aus einem Artikel «»)
Erläuterung:
- In der Ziel-Datenbank wird die Standarderweiterung PostgreSQL — „pg_stat_statements“ installiert.
- In der Überwachungsdatenbank erstellen wir einen Satz von Servicetabellen zur Speicherung der Geschichte von pg_stat_statements in der Anfangsphase sowie zur Konfiguration von Metriken und zur Überwachung in der Zukunft.
- Auf dem Überwachungs-Host erstellen wir eine Reihe von Bash-Skripten, unter anderem zur Generierung von Vorfällen im Ticket-System.
Servicetabellen
Für den Anfang eine schematisch vereinfachte ERD, was letztendlich herausgekommen ist:
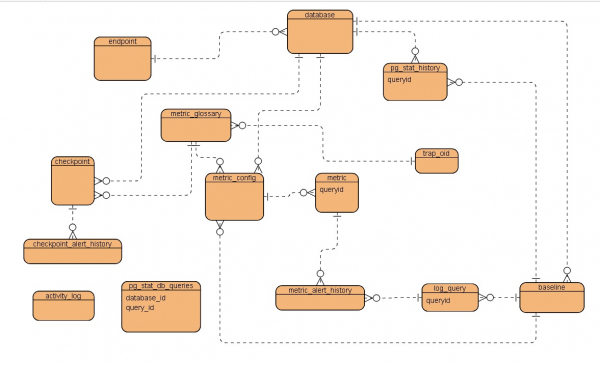
Kurze Beschreibung der Tabellenendpoint — Host, Verbindungspunkt zum Instance
database — Datenbankparameter
pg_stat_history — Historische Tabelle zur Speicherung temporärer Snapshots der Darstellung von pg_stat_statements für die Ziel-Datenbank
metric_glossary — Glossar der Leistungsmetriken
metric_config — Konfiguration einzelner Metriken
metric — Konkrete Metrik für die überwachte Anfrage
metric_alert_history — Geschichte der Warnungen zur Leistungsüberwachung
log_query — Systemtabelle zur Speicherung der analysierten Einträge aus dem Protokoll der PostgreSQL-Datei, die von AWS geladen wird
baseline — Parameter des Zeitraum, der als Basis verwendet wird
checkpoint — Konfiguration der Metriken zur Überprüfung des Datenbankzustands
checkpoint_alert_history — Geschichte der Warnungen für Metriken zur Überprüfung des Datenbankzustands
pg_stat_db_queries — Systemtabelle aktiver Anfragen
activity_log — Systemtabelle des Aktivitätsprotokolls
trap_oid — Systemtabelle zur Konfiguration von Fallstricken
Schritt 1 — Sammeln von Leistungsstatistiken und Erhalt von Berichten
Zur Speicherung der Leistungsstatistiken dient die Tabelle pg_stat_history
Die Struktur der Tabelle pg_stat_history
                                          Tabelle "public.pg_stat_history"
       Spalte        |            Typ             |                          Modifikatoren
---------------------+-----------------------------+-------------------------------------------
 id                  | ganzzahlig                  | nicht null Standard nextval('pg_stat_history_id_seq'::regclass)
 snapshot_timestamp  | Zeitstempel ohne Zeitzone  |
 database_id         | ganzzahlig                  |
 dbid                | oid                         |
 userid              | oid                         |
 queryid             | bigint                      |
 query               | Text                        |
 calls               | bigint                      |
 total_time          | doppelte Präzision          |
 min_time            | doppelte Präzision          |
 max_time            | doppelte Präzision          |
 mean_time           | doppelte Präzision          |
 stddev_time         | doppelte Präzision          |
 rows                | bigint                      |
 shared_blks_hit     | bigint                      |
 shared_blks_read    | bigint                      |
 shared_blks_dirtied | bigint                      |
 shared_blks_written | bigint                      |
 local_blks_hit      | bigint                      |
 local_blks_read     | bigint                      |
 local_blks_dirtied  | bigint                      |
 local_blks_written  | bigint                      |
 temp_blks_read      | bigint                      |
 temp_blks_written   | bigint                      |
 blk_read_time       | doppelte Präzision          |
 blk_write_time      | doppelte Präzision          |
 baseline_id         | ganzzahlig                  |
Indizes:
    "pg_stat_history_pkey" PRIMARY KEY, btree (id)
    "database_idx" btree (database_id)
    "queryid_idx" btree (queryid)
    "snapshot_timestamp_idx" btree (snapshot_timestamp)
Fremdschlüsselbeschränkungen:
    "database_id_fk" FOREIGN KEY (database_id) REFERENCES database(id) ON DELETE CASCADE
Wie man sieht, stellt die Tabelle lediglich kumulierte Daten der Ansicht dar pg_stat_statements in der Ziel-Datenbank.
Die Verwendung dieser Tabelle ist sehr einfach
pg_stat_history und wird die akkumulierten Statistiken über die Ausführung von Abfragen für jede Stunde darstellen. Zu Beginn jeder Stunde, nach dem Ausfüllen der Tabelle, werden die Statistiken pg_stat_statements mit Hilfe von pg_stat_statements_reset().
Hinweis: gesammelt, wobei die Statistiken für Abfragen mit einer Ausführungsdauer von mehr als 1 Sekunde erfasst werden.
Das Ausfüllen der Tabelle pg_stat_history
--pg_stat_history.sql
CREATE OR REPLACE FUNCTION pg_stat_history( ) RETURNS boolean AS $$
DECLARE
  endpoint_rec record ;
  database_rec record ;
  pg_stat_snapshot record ;
  current_snapshot_timestamp timestamp without time zone;
BEGIN
  current_snapshot_timestamp = date_trunc('minute',now());

  FOR endpoint_rec IN SELECT * FROM endpoint
  LOOP
    FOR database_rec IN SELECT * FROM database WHERE endpoint_id = endpoint_rec.id
	  LOOP

		RAISE NOTICE 'NEUES SHAPSHOT WIRD ERSTELLT';

		--Verbinden mit der Ziel-Datenbank
	    EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||endpoint_rec.host||' dbname='||database_rec.name||' user=USER password=PASSWORD '')';

        RAISE NOTICE 'host % und dbname % ',endpoint_rec.host,database_rec.name;
		RAISE NOTICE 'Erstelle Snapshot von pg_stat_statements für Datenbank %',database_rec.name;

		SELECT
	      *
		INTO
		  pg_stat_snapshot
	    FROM dblink('LINK1',
	      'SELECT
	       dbid , SUM(calls),SUM(total_time),SUM(rows) ,SUM(shared_blks_hit) ,SUM(shared_blks_read) ,SUM(shared_blks_dirtied) ,SUM(shared_blks_written) ,
           SUM(local_blks_hit) , SUM(local_blks_read) , SUM(local_blks_dirtied) , SUM(local_blks_written) , SUM(temp_blks_read) , SUM(temp_blks_written) , SUM(blk_read_time) , SUM(blk_write_time)
	       FROM pg_stat_statements WHERE dbid=(SELECT oid from pg_database where datname=current_database() )
		   GROUP BY dbid
  	      '
	               )
	      AS t
	       ( dbid oid , calls bigint ,
  	         total_time double precision ,
	         rows bigint , shared_blks_hit bigint , shared_blks_read bigint ,shared_blks_dirtied bigint ,shared_blks_written	 bigint ,
             local_blks_hit	 bigint ,local_blks_read bigint , local_blks_dirtied bigint ,local_blks_written bigint ,
             temp_blks_read	 bigint ,temp_blks_written bigint ,
             blk_read_time double precision , blk_write_time double precision
	       );

		INSERT INTO pg_stat_history
          (
		    snapshot_timestamp  ,database_id  ,
			dbid , calls  ,total_time ,
            rows ,shared_blks_hit  ,shared_blks_read  ,shared_blks_dirtied  ,shared_blks_written ,local_blks_hit ,
            local_blks_read,local_blks_dirtied,local_blks_written,temp_blks_read,temp_blks_written,
            blk_read_time, blk_write_time
		  )
	    VALUES
	      (
	       current_snapshot_timestamp ,
		   database_rec.id ,
	       pg_stat_snapshot.dbid ,pg_stat_snapshot.calls,
	       pg_stat_snapshot.total_time,
	       pg_stat_snapshot.rows ,pg_stat_snapshot.shared_blks_hit ,pg_stat_snapshot.shared_blks_read ,pg_stat_snapshot.shared_blks_dirtied ,pg_stat_snapshot.shared_blks_written ,
           pg_stat_snapshot.local_blks_hit , pg_stat_snapshot.local_blks_read , pg_stat_snapshot.local_blks_dirtied , pg_stat_snapshot.local_blks_written ,
	       pg_stat_snapshot.temp_blks_read , pg_stat_snapshot.temp_blks_written , pg_stat_snapshot.blk_read_time , pg_stat_snapshot.blk_write_time
	      );

        RAISE NOTICE 'Erstelle Snapshot von pg_stat_statements für Abfragen mit min_time mehr als 1000ms';

        FOR pg_stat_snapshot IN
          --Alle Abfragen mit max_time größer als 1000 ms
	      SELECT
	        *
	      FROM dblink('LINK1',
	        'SELECT
	         dbid , userid ,queryid,query,calls,total_time,min_time ,max_time,mean_time, stddev_time ,rows ,shared_blks_hit ,
			 shared_blks_read ,shared_blks_dirtied ,shared_blks_written ,
             local_blks_hit , local_blks_read , local_blks_dirtied ,
			 local_blks_written , temp_blks_read , temp_blks_written , blk_read_time ,
			 blk_write_time
	         FROM pg_stat_statements
			 WHERE dbid=(SELECT oid from pg_database where datname=current_database() AND min_time >= 1000 )
  	        '

	                  )
	        AS t
	         ( dbid oid , userid oid , queryid bigint ,query text , calls bigint ,
  	           total_time double precision ,min_time double precision	 ,max_time double precision	 , mean_time double precision	 ,  stddev_time double precision	 ,
	           rows bigint , shared_blks_hit bigint , shared_blks_read bigint ,shared_blks_dirtied bigint ,shared_blks_written	 bigint ,
               local_blks_hit	 bigint ,local_blks_read bigint , local_blks_dirtied bigint ,local_blks_written bigint ,
               temp_blks_read	 bigint ,temp_blks_written bigint ,
               blk_read_time double precision , blk_write_time double precision
	         )
	    LOOP
		  INSERT INTO pg_stat_history
          (
		    snapshot_timestamp  ,database_id  ,
			dbid ,userid  , queryid  , query  , calls  ,total_time ,min_time ,max_time ,mean_time ,stddev_time ,
            rows ,shared_blks_hit  ,shared_blks_read  ,shared_blks_dirtied  ,shared_blks_written ,local_blks_hit ,
            local_blks_read,local_blks_dirtied,local_blks_written,temp_blks_read,temp_blks_written,
            blk_read_time, blk_write_time
		  )
	      VALUES
	      (
	       current_snapshot_timestamp ,
		   database_rec.id ,
	       pg_stat_snapshot.dbid ,pg_stat_snapshot.userid ,pg_stat_snapshot.queryid,pg_stat_snapshot.query,pg_stat_snapshot.calls,
	       pg_stat_snapshot.total_time,pg_stat_snapshot.min_time ,pg_stat_snapshot.max_time,pg_stat_snapshot.mean_time, pg_stat_snapshot.stddev_time ,
	       pg_stat_snapshot.rows ,pg_stat_snapshot.shared_blks_hit ,pg_stat_snapshot.shared_blks_read ,pg_stat_snapshot.shared_blks_dirtied ,pg_stat_snapshot.shared_blks_written ,
           pg_stat_snapshot.local_blks_hit , pg_stat_snapshot.local_blks_read , pg_stat_snapshot.local_blks_dirtied , pg_stat_snapshot.local_blks_written ,
	       pg_stat_snapshot.temp_blks_read , pg_stat_snapshot.temp_blks_written , pg_stat_snapshot.blk_read_time , pg_stat_snapshot.blk_write_time
	      );

        END LOOP;

        PERFORM dblink_disconnect('LINK1');

	  END LOOP ;--FOR database_rec IN SELECT * FROM database WHERE endpoint_id = endpoint_rec.id

  END LOOP;

RETURN TRUE;
END
$$ LANGUAGE plpgsql;
In der Folge, nach einer gewissen Zeit in der Tabelle pg_stat_history werden wir eine Reihe von Aufnahmen des Inhalts der Tabelle haben pg_stat_statements der Ziel-Datenbank.
Eigentlich das Reporting
Durch einfache Abfragen lassen sich durchaus nützliche und interessante Berichte generieren.
Aggregierte Daten für den angegebenen Zeitraum
Abfrage
SELECT
  database_id ,
  SUM(calls) AS calls ,SUM(total_time)  AS total_time ,
  SUM(rows) AS rows , SUM(shared_blks_hit)  AS shared_blks_hit,
  SUM(shared_blks_read) AS shared_blks_read ,
  SUM(shared_blks_dirtied) AS shared_blks_dirtied,
  SUM(shared_blks_written) AS shared_blks_written ,
  SUM(local_blks_hit) AS local_blks_hit ,
  SUM(local_blks_read) AS local_blks_read ,
  SUM(local_blks_dirtied) AS local_blks_dirtied ,
  SUM(local_blks_written)  AS local_blks_written,
  SUM(temp_blks_read) AS temp_blks_read,
  SUM(temp_blks_written) temp_blks_written ,
  SUM(blk_read_time) AS blk_read_time ,
  SUM(blk_write_time) AS blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY database_id ;
DB-Zeit
to_char(interval '1 millisecond' * pg_total_stat_history_rec.total_time, 'HH24:MI:SS.MS')
I/O-Zeit
to_char(interval '1 millisecond' * ( pg_total_stat_history_rec.blk_read_time + pg_total_stat_history_rec.blk_write_time ), 'HH24:MI:SS.MS')
TOP10 SQL nach total_time
Abfrage
SELECT
  queryid ,
  SUM(calls) AS calls ,
  SUM(total_time)  AS total_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY queryid
ORDER BY 3 DESC
LIMIT 10
------------------------------------------------------------------------------------- | TOP10 SQL NACH DER TOTALEN AUSFÜHRUNGSZEIT | #| queryid| calls| calls %| total_time (ms) | dbtime % +----+-----------+-----------+-----------+--------------------------------+---------- | 1| 821760255| 2| .00001|00:03:23.141( 203141.681 ms.)| 5.42 | 2| 4152624390| 2| .00001|00:03:13.929( 193929.215 ms.)| 5.17 | 3| 1484454471| 4| .00001|00:02:09.129( 129129.057 ms.)| 3.44 | 4| 655729273| 1| .00000|00:02:01.869( 121869.981 ms.)| 3.25 | 5| 2460318461| 1| .00000|00:01:33.113( 93113.835 ms.)| 2.48 | 6| 2194493487| 4| .00001|00:00:17.377( 17377.868 ms.)| .46 | 7| 1053044345| 1| .00000|00:00:06.156( 6156.352 ms.)| .16 | 8| 3644780286| 1| .00000|00:00:01.063( 1063.830 ms.)| .03
TOP10 SQL nach der gesamten I/O-Zeit
Abfrage
SELECT
  queryid ,
  SUM(calls) AS calls ,
  SUM(blk_read_time + blk_write_time)  AS io_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY  queryid
ORDER BY 3 DESC
LIMIT 10
---------------------------------------------------------------------------------------- | TOP10 SQL NACH GESAMT I/O ZEIT | #| queryid| aufrufe| aufrufe %| I/O zeit (ms)|db I/O zeit % +----+-----------+-----------+-----------+--------------------------------+------------- | 1| 4152624390| 2| .00001|00:08:31.616( 511616.592 ms.)| 31.06 | 2| 821760255| 2| .00001|00:08:27.099( 507099.036 ms.)| 30.78 | 3| 655729273| 1| .00000|00:05:02.209( 302209.137 ms.)| 18.35 | 4| 2460318461| 1| .00000|00:04:05.981( 245981.117 ms.)| 14.93 | 5| 1484454471| 4| .00001|00:00:39.144( 39144.221 ms.)| 2.38 | 6| 2194493487| 4| .00001|00:00:18.182( 18182.816 ms.)| 1.10 | 7| 1053044345| 1| .00000|00:00:16.611( 16611.722 ms.)| 1.01 | 8| 3644780286| 1| .00000|00:00:00.436( 436.205 ms.)| .03
TOP10 SQL nach max. Ausführungszeit
Abfrage
SELECT
  id AS snapshotid ,
  queryid ,
  snapshot_timestamp ,
  max_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
ORDER BY 4 DESC
LIMIT 10
----------------------------------------------------------------------------------------- | TOP10 SQL NACH MAX AUSFÜHRUNGSZEIT | #| snapshot| snapshotID| queryid| max_time (ms) +----+------------------+-----------+-----------+---------------------------------------- | 1| 05.04.2019 01:03| 4169| 655729273| 00:02:01.869( 121869.981 ms.) | 2| 04.04.2019 17:00| 4153| 821760255| 00:01:41.570( 101570.841 ms.) | 3| 04.04.2019 16:00| 4146| 821760255| 00:01:41.570( 101570.841 ms.) | 4| 04.04.2019 16:00| 4144| 4152624390| 00:01:36.964( 96964.607 ms.) | 5| 04.04.2019 17:00| 4151| 4152624390| 00:01:36.964( 96964.607 ms.) | 6| 05.04.2019 10:00| 4188| 1484454471| 00:01:33.452( 93452.150 ms.) | 7| 04.04.2019 17:00| 4150| 2460318461| 00:01:33.113( 93113.835 ms.) | 8| 04.04.2019 15:00| 4140| 1484454471| 00:00:11.892( 11892.302 ms.) | 9| 04.04.2019 16:00| 4145| 1484454471| 00:00:11.892( 11892.302 ms.) | 10| 04.04.2019 17:00| 4152| 1484454471| 00:00:11.892( 11892.302 ms.)
TOP10 SQL nach SHARED Puffer lesen/schreiben
Abfrage
SELECT
  id AS snapshotid ,
  queryid ,
  snapshot_timestamp ,
  shared_blks_read ,
  shared_blks_written
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( shared_blks_read > 0 OR shared_blks_written > 0 )
ORDER BY 4 DESC  , 5 DESC
LIMIT 10
-------------------------------------------------------------------------------------------- | TOP10 SQL NACH GETEILTEN BUFFERLESEN/ -SCHREIBEN | #| Schnappschuss| SchnappschussID| AbfrageID| geteilt gelesene Blöcke| geteilt geschriebene Blöcke +----+------------------+-----------+-----------+---------------------+--------------------- | 1| 04.04.2019 17:00| 4153| 821760255| 797308| 0 | 2| 04.04.2019 16:00| 4146| 821760255| 797308| 0 | 3| 05.04.2019 01:03| 4169| 655729273| 797158| 0 | 4| 04.04.2019 16:00| 4144| 4152624390| 756514| 0 | 5| 04.04.2019 17:00| 4151| 4152624390| 756514| 0 | 6| 04.04.2019 17:00| 4150| 2460318461| 734117| 0 | 7| 04.04.2019 17:00| 4155| 3644780286| 52973| 0 | 8| 05.04.2019 01:03| 4168| 1053044345| 52818| 0 | 9| 04.04.2019 15:00| 4141| 2194493487| 52813| 0 | 10| 04.04.2019 16:00| 4147| 2194493487| 52813| 0 --------------------------------------------------------------------------------------------
Histogramm der Verteilung der Abfragen nach maximaler Ausführungszeit
Anfragen
SELECT
  MIN(max_time) AS hist_min  ,
  MAX(max_time) AS hist_max ,
  (( MAX(max_time) - MIN(min_time) ) / hist_columns ) as hist_width
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT ;

SELECT
  SUM(calls) AS calls
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( max_time >= hist_current_min AND  max_time < hist_current_max ) ;
|-----------------------------------------------------------------------------------------------
| MAX_TIME-HISTOGRAMM
| ANZAHL DER ABFRAGEN : 33851920
| MINDAUER  : 00:00:01.063
| MAXDAUER  : 00:02:01.869
---------------------------------------------------------------------------------
|                      min Dauer|                      max Dauer|     Aufrufe
+----------------------------------+----------------------------------+----------
| 00:00:01.063(      1063.830 ms.) | 00:00:13.144(     13144.445 ms.) | 9
| 00:00:13.144(     13144.445 ms.) | 00:00:25.225(     25225.060 ms.) | 0
| 00:00:25.225(     25225.060 ms.) | 00:00:37.305(     37305.675 ms.) | 0
| 00:00:37.305(     37305.675 ms.) | 00:00:49.386(     49386.290 ms.) | 0
| 00:00:49.386(     49386.290 ms.) | 00:01:01.466(     61466.906 ms.) | 0
| 00:01:01.466(     61466.906 ms.) | 00:01:13.547(     73547.521 ms.) | 0
| 00:01:13.547(     73547.521 ms.) | 00:01:25.628(     85628.136 ms.) | 0
| 00:01:25.628(     85628.136 ms.) | 00:01:37.708(     97708.751 ms.) | 4
| 00:01:37.708(     97708.751 ms.) | 00:01:49.789(    109789.366 ms.) | 2
| 00:01:49.789(    109789.366 ms.) | 00:02:01.869(    121869.981 ms.) | 0
TOP10 Schnappschüsse nach Abfrage pro Sekunde
Anfragen
--pg_qps.sql
--Berechnung der Abfragen pro Sekunde
CREATE OR REPLACE FUNCTION pg_qps( pg_stat_history_id integer ) RETURNS double precision AS $$
DECLARE
 pg_stat_history_rec record ;
 prev_pg_stat_history_id integer ;
 prev_pg_stat_history_rec record;
 total_seconds double precision ;
 result double precision;
BEGIN
  result = 0 ;

  SELECT *
  INTO pg_stat_history_rec
  FROM
    pg_stat_history
  WHERE id = pg_stat_history_id ;

  IF pg_stat_history_rec.snapshot_timestamp IS NULL
  THEN
    RAISE EXCEPTION 'FEHLER - pg_stat_history für id = % nicht gefunden',pg_stat_history_id;
  END IF ;

 --RAISE NOTICE 'pg_stat_history_id = % , snapshot_timestamp = %', pg_stat_history_id ,
 pg_stat_history_rec.snapshot_timestamp ;

  SELECT
    MAX(id)
  INTO
    prev_pg_stat_history_id
  FROM
    pg_stat_history
  WHERE
    database_id = pg_stat_history_rec.database_id AND
	queryid IS NULL AND
	id  0
  THEN
    result = pg_stat_history_rec.calls / total_seconds ;
  ELSE
   result = 0 ;
  END IF;

 RETURN result ;
END
$$ LANGUAGE plpgsql;


SELECT
  id ,
  snapshot_timestamp ,
  calls ,
  total_time ,
  ( select pg_qps( id )) AS QPS ,
  blk_read_time ,
  blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( select pg_qps( id )) IS NOT NULL
ORDER BY 5 DESC
LIMIT 10
|-----------------------------------------------------------------------------------------------
| TOP10 Schnappschüsse, geordnet nach QueryPerSeconds-Zahlen
-----------------------------------------------------------------------------------------------------------------------------------------------
|    #|          Schnappschuss| snapshotID|      Aufrufe|                      Gesamte db-Zeit|        QPS|                          I/O-Zeit| I/O-Zeit %
+-----+------------------+-----------+-----------+----------------------------------+-----------+----------------------------------+-----------
|    1|  04.04.2019 20:04|       4161|    5758631|  00:06:30.513(    390513.926 ms.)|   1573.396|  00:00:01.470(      1470.110 ms.)|       .376
|    2|  04.04.2019 17:00|       4149|    3529197|  00:11:48.830(    708830.618 ms.)|    980.332|  00:12:47.834(    767834.052 ms.)|    108.324
|    3|  04.04.2019 16:00|       4143|    3525360|  00:10:13.492(    613492.351 ms.)|    979.267|  00:08:41.396(    521396.555 ms.)|     84.988
|    4|  04.04.2019 21:03|       4163|    2781536|  00:03:06.470(    186470.979 ms.)|    785.745|  00:00:00.249(       249.865 ms.)|       .134
|    5|  04.04.2019 19:03|       4159|    2890362|  00:03:16.784(    196784.755 ms.)|    776.979|  00:00:01.441(      1441.386 ms.)|       .732
|    6|  04.04.2019 14:00|       4137|    2397326|  00:04:43.033(    283033.854 ms.)|    665.924|  00:00:00.024(        24.505 ms.)|       .009
|    7|  04.04.2019 15:00|       4139|    2394416|  00:04:51.435(    291435.010 ms.)|    665.116|  00:00:12.025(     12025.895 ms.)|      4.126
|    8|  04.04.2019 13:00|       4135|    2373043|  00:04:26.791(    266791.988 ms.)|    659.179|  00:00:00.064(        64.261 ms.)|       .024
|    9|  05.04.2019 01:03|       4167|    4387191|  00:06:51.380(    411380.293 ms.)|    609.332|  00:05:18.847(    318847.407 ms.)|     77.507
|   10|  04.04.2019 18:01|       4157|    1145596|  00:01:19.217(     79217.372 ms.)|    313.004|  00:00:01.319(      1319.676 ms.)|      1.666
Stündliche Ausführungsprotokolle mit QueryPerSeconds und I/O-Zeit
Abfrage
SELECT
  id ,
  snapshot_timestamp ,
  calls ,
  total_time ,
  ( select pg_qps( id )) AS QPS ,
  blk_read_time ,
  blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
ORDER BY 2
|-----------------------------------------------------------------------------------------------
| STUNDENWEISE AUSFÜHRUNGSGESCHICHTE  MIT QueryPerSeconds und I/O-Zeit
-----------------------------------------------------------------------------------------------------------------------------------------------
| ABFRAGEPROTOKOLL PRO SEKUNDE
|    #|          Snapshot| SnapshotID|      Aufrufe|                      Gesamte DB-Zeit|        QPS|                          I/O-Zeit| I/O-Zeit %
+-----+------------------+-----------+-----------+----------------------------------+-----------+----------------------------------+-----------
|    1|  04.04.2019 11:00|       4131|       3747|  00:00:00.835(       835.374 ms.)|      1.041|  00:00:00.000(          .000 ms.)|       .000
|    2|  04.04.2019 12:00|       4133|    1002722|  00:01:52.419(    112419.376 ms.)|    278.534|  00:00:00.149(       149.105 ms.)|       .133
|    3|  04.04.2019 13:00|       4135|    2373043|  00:04:26.791(    266791.988 ms.)|    659.179|  00:00:00.064(        64.261 ms.)|       .024
|    4|  04.04.2019 14:00|       4137|    2397326|  00:04:43.033(    283033.854 ms.)|    665.924|  00:00:00.024(        24.505 ms.)|       .009
|    5|  04.04.2019 15:00|       4139|    2394416|  00:04:51.435(    291435.010 ms.)|    665.116|  00:00:12.025(     12025.895 ms.)|      4.126
|    6|  04.04.2019 16:00|       4143|    3525360|  00:10:13.492(    613492.351 ms.)|    979.267|  00:08:41.396(    521396.555 ms.)|     84.988
|    7|  04.04.2019 17:00|       4149|    3529197|  00:11:48.830(    708830.618 ms.)|    980.332|  00:12:47.834(    767834.052 ms.)|    108.324
|    8|  04.04.2019 18:01|       4157|    1145596|  00:01:19.217(     79217.372 ms.)|    313.004|  00:00:01.319(      1319.676 ms.)|      1.666
|    9|  04.04.2019 19:03|       4159|    2890362|  00:03:16.784(    196784.755 ms.)|    776.979|  00:00:01.441(      1441.386 ms.)|       .732
|   10|  04.04.2019 20:04|       4161|    5758631|  00:06:30.513(    390513.926 ms.)|   1573.396|  00:00:01.470(      1470.110 ms.)|       .376
|   11|  04.04.2019 21:03|       4163|    2781536|  00:03:06.470(    186470.979 ms.)|    785.745|  00:00:00.249(       249.865 ms.)|       .134
|   12|  04.04.2019 23:03|       4165|    1443155|  00:01:34.467(     94467.539 ms.)|    200.438|  00:00:00.015(        15.287 ms.)|       .016
|   13|  05.04.2019 01:03|       4167|    4387191|  00:06:51.380(    411380.293 ms.)|    609.332|  00:05:18.847(    318847.407 ms.)|     77.507
|   14|  05.04.2019 02:03|       4171|     189852|  00:00:10.989(     10989.899 ms.)|     52.737|  00:00:00.539(       539.110 ms.)|      4.906
|   15|  05.04.2019 03:01|       4173|       3627|  00:00:00.103(       103.000 ms.)|      1.042|  00:00:00.004(         4.131 ms.)|      4.010
|   16|  05.04.2019 04:00|       4175|       3627|  00:00:00.085(        85.235 ms.)|      1.025|  00:00:00.003(         3.811 ms.)|      4.471
|   17|  05.04.2019 05:00|       4177|       3747|  00:00:00.849(       849.454 ms.)|      1.041|  00:00:00.006(         6.124 ms.)|       .721
|   18|  05.04.2019 06:00|       4179|       3747|  00:00:00.849(       849.561 ms.)|      1.041|  00:00:00.000(          .051 ms.)|       .006
|   19|  05.04.2019 07:00|       4181|       3747|  00:00:00.839(       839.416 ms.)|      1.041|  00:00:00.000(          .062 ms.)|       .007
|   20|  05.04.2019 08:00|       4183|       3747|  00:00:00.846(       846.382 ms.)|      1.041|  00:00:00.000(          .007 ms.)|       .001
|   21|  05.04.2019 09:00|       4185|       3747|  00:00:00.855(       855.426 ms.)|      1.041|  00:00:00.000(          .065 ms.)|       .008
|   22|  05.04.2019 10:00|       4187|       3797|  00:01:40.150(    100150.165 ms.)|      1.055|  00:00:21.845(     21845.217 ms.)|     21.812
Text aller SQL-SELECTs
Abfrage
WÄHLEN Sie
  queryid ,
  query
VON
  pg_stat_history
WO
  queryid IST NICHT NULL UND
  database_id = DATABASE_ID UND
  snapshot_timestamp ZWISCHEN BEGIN_TIMEPOINT UND END_TIMEPOINT
GRUPPEN NACH queryid , query
Fazit
Wie zu sehen ist, kann man mit recht einfachen Mitteln eine Menge nützlicher Informationen über die Auslastung und den Zustand der Datenbank erhalten.
Anmerkung:Wenn wir in den Abfragen queryid festhalten, erhalten wir die Historie für eine einzelne Abfrage (zum Zwecke der Platzersparnis sind die Berichte für einzelne Abfragen weggelassen).
Damit liegen die statistischen Daten zur Leistungsfähigkeit der Abfragen vor und werden gesammelt.
Die erste Phase „Sammlung von statistischen Daten“ ist abgeschlossen.
Wir können zur zweiten Phase übergehen – „Einstellung der Leistungsmetriken“.
Aber das ist eine ganz andere Geschichte.
Fortsetzung folgt…
Quelle: habr.com
