

Vorwort
Benutzer, Entwickler und Administratoren von MS SQL Server-Datenbanken stoßen häufig auf Probleme mit der Datenbank- oder Systemleistung, weshalb das Monitoring von MS SQL Server äußerst relevant ist.
Dieser Artikel ergänzt den Artikel und behandelt einige Aspekte des Monitorings von MS SQL Server, insbesondere: wie man schnell erkennt, welche Ressourcen fehlen, sowie Empfehlungen zur Konfiguration von Trace Flags.
Um die folgenden Skripte auszuführen, muss das Schema inf in der entsprechenden Datenbank wie folgt erstellt werden:
Erstellung des Schemas inf
use ;
go
create schema inf;
Methode zur Identifizierung von unzureichendem RAM
Ein erstes Anzeichen für unzureichenden RAM ist der Fall, wenn die Instanz von MS SQL Server den gesamten ihr zugewiesenen RAM verbraucht.
Dafür erstellen wir die folgende Ansicht inf.vRAM:
Erstellung der Ansicht inf.vRAM
CREATE view [inf].[vRAM] as
select a.[TotalAvailOSRam_Mb]						-- wie viel RAM in MB auf dem Server verfügbar ist
		 , a.[RAM_Avail_Percent]					-- Prozentsatz des verfügbaren RAM auf dem Server
		 , a.[Server_physical_memory_Mb]				-- wie viel RAM insgesamt auf dem Server in MB vorhanden ist
		 , a.[SQL_server_committed_target_Mb]			-- wie viel RAM insgesamt für MS SQL Server in MB reserviert ist
		 , a.[SQL_server_physical_memory_in_use_Mb] 		-- wie viel RAM MS SQL Server derzeit in MB verwendet
		 , a.[SQL_RAM_Avail_Percent]				-- Prozentsatz des verfügbaren RAM für MS SQL Server im Verhältnis zum gesamten für MS SQL Server zugewiesenen RAM
		 , a.[StateMemorySQL]						-- ausreichend RAM für MS SQL Server?
		 , a.[SQL_RAM_Reserve_Percent]				-- Prozentsatz des reservierten RAM für MS SQL Server im Verhältnis zum gesamten RAM des Servers
		 -- ist ausreichend RAM für den Server vorhanden
		, (case when a.[RAM_Avail_Percent]5 and a.[TotalAvailOSRam_Mb]<8192 then 'Warnung' when a.[RAM_Avail_Percent]<=5 and a.[TotalAvailOSRam_Mb]<2048 then 'Gefahr' else 'Normal' end) as [StateMemoryServer]
	from
	(
		select cast(a0.available_physical_memory_kb/1024.0 as int) as TotalAvailOSRam_Mb
			 , cast((a0.available_physical_memory_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [RAM_Avail_Percent]
			 , a0.system_low_memory_signal_state
			 , ceiling(b.physical_memory_kb/1024.0) as [Server_physical_memory_Mb]
			 , ceiling(b.committed_target_kb/1024.0) as [SQL_server_committed_target_Mb]
			 , ceiling(a.physical_memory_in_use_kb/1024.0) as [SQL_server_physical_memory_in_use_Mb]
			 , cast(((b.committed_target_kb-a.physical_memory_in_use_kb)/casT(b.committed_target_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Avail_Percent]
			 , cast((b.committed_target_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Reserve_Percent]
			 , (case when (ceiling(b.committed_target_kb/1024.0)-1024)<ceiling(a.physical_memory_in_use_kb/1024.0) then 'Warnung' else 'Normal' end) as [StateMemorySQL]
		from sys.dm_os_sys_memory as a0
		cross join sys.dm_os_process_memory as a
		cross join sys.dm_os_sys_info as b
		cross join sys.dm_os_sys_memory as v
	) as a;
Dann kann man mit folgender Anfrage feststellen, dass die Instanz von MS SQL Server den gesamten ihr zugewiesenen Speicher verbraucht:
select  SQL_server_physical_memory_in_use_Mb,  SQL_server_committed_target_Mb
from [inf].[vRAM];
Wenn der Wert von SQL_server_physical_memory_in_use_Mb ständig nicht unter SQL_server_committed_target_Mb liegt, sollte die Wartezeitstatistik überprüft werden.
Um den Mangel an Arbeitsspeicher über die Wartezeitstatistik festzustellen, erstellen wir die Ansicht inf.vWaits:
Erstellung der Ansicht inf.vWaits
ERSTELLEN Sie die Ansicht [inf].[vWaits] als
MIT [Waits] ALS
    (WÄHLEN
        [wait_type], --Name des Wartetyps
        [wait_time_ms] / 1000.0 AS [WaitS],--Gesamtwartezeit dieses Typs in Millisekunden. Diese Zeit beinhaltet signal_wait_time_ms
        ([wait_time_ms] - [signal_wait_time_ms]) / 1000.0 AS [ResourceS],--Gesamtwartezeit dieses Typs in Millisekunden ohne signal_wait_time_ms
        [signal_wait_time_ms] / 1000.0 AS [SignalS],--Differenz zwischen der Signalzeit des wartenden Threads und der Zeit seines Beginns
        [waiting_tasks_count] AS [WaitCount],--Anzahl der Wartungen dieses Typs. Dieser Zähler wird jedes Mal erhöht, wenn eine Wartung beginnt
        100.0 * [wait_time_ms] / SUM ([wait_time_ms]) OVER() AS [Percentage],
        ROW_NUMBER() OVER(ORDER BY [wait_time_ms] DESC) AS [RowNum]
    VON sys.dm_os_wait_stats
    WO [waiting_tasks_count] > 0
		und [wait_type] NICHT IN (
        N'BROKER_EVENTHANDLER',         N'BROKER_RECEIVE_WAITFOR',
        N'BROKER_TASK_STOP',            N'BROKER_TO_FLUSH',
        N'BROKER_TRANSMITTER',          N'CHECKPOINT_QUEUE',
        N'CHKPT',                       N'CLR_AUTO_EVENT',
        N'CLR_MANUAL_EVENT',            N'CLR_SEMAPHORE',
        N'DBMIRROR_DBM_EVENT',          N'DBMIRROR_EVENTS_QUEUE',
        N'DBMIRROR_WORKER_QUEUE',       N'DBMIRRORING_CMD',
        N'DIRTY_PAGE_POLL',             N'DISPATCHER_QUEUE_SEMAPHORE',
        N'EXECSYNC',                    N'FSAGENT',
        N'FT_IFTS_SCHEDULER_IDLE_WAIT', N'FT_IFTSHC_MUTEX',
        N'HADR_CLUSAPI_CALL',           N'HADR_FILESTREAM_IOMGR_IOCOMPLETION',
        N'HADR_LOGCAPTURE_WAIT',        N'HADR_NOTIFICATION_DEQUEUE',
        N'HADR_TIMER_TASK',             N'HADR_WORK_QUEUE',
        N'KSOURCE_WAKEUP',              N'LAZYWRITER_SLEEP',
        N'LOGMGR_QUEUE',                N'ONDEMAND_TASK_QUEUE',
        N'PWAIT_ALL_COMPONENTS_INITIALIZED',
        N'QDS_PERSIST_TASK_MAIN_LOOP_SLEEP',
        N'QDS_CLEANUP_STALE_QUERIES_TASK_MAIN_LOOP_SLEEP',
        N'REQUEST_FOR_DEADLOCK_SEARCH', N'RESOURCE_QUEUE',
        N'SERVER_IDLE_CHECK',           N'SLEEP_BPOOL_FLUSH',
        N'SLEEP_DBSTARTUP',             N'SLEEP_DCOMSTARTUP',
        N'SLEEP_MASTERDBREADY',         N'SLEEP_MASTERMDREADY',
        N'SLEEP_MASTERUPGRADED',        N'SLEEP_MSDBSTARTUP',
        N'SLEEP_SYSTEMTASK',            N'SLEEP_TASK',
        N'SLEEP_TEMPDBSTARTUP',         N'SNI_HTTP_ACCEPT',
        N'SP_SERVER_DIAGNOSTICS_SLEEP', N'SQLTRACE_BUFFER_FLUSH',
        N'SQLTRACE_INCREMENTAL_FLUSH_SLEEP',
        N'SQLTRACE_WAIT_ENTRIES',       N'WAIT_FOR_RESULTS',
        N'WAITFOR',                     N'WAITFOR_TASKSHUTDOWN',
        N'WAIT_XTP_HOST_WAIT',          N'WAIT_XTP_OFFLINE_CKPT_NEW_LOG',
        N'WAIT_XTP_CKPT_CLOSE',         N'XE_DISPATCHER_JOIN',
        N'XE_DISPATCHER_WAIT',          N'XE_TIMER_EVENT')
    )
, ress als (
	WÄHLEN
	    [W1].[wait_type] AS [WaitType],
	    CAST ([W1].[WaitS] AS DECIMAL (16, 2)) AS [Wait_S],--Gesamtwartezeit dieses Typs in Millisekunden. Diese Zeit beinhaltet signal_wait_time_ms
	    CAST ([W1].[ResourceS] AS DECIMAL (16, 2)) AS [Resource_S],--Gesamtwartezeit dieses Typs in Millisekunden ohne signal_wait_time_ms
	    CAST ([W1].[SignalS] AS DECIMAL (16, 2)) AS [Signal_S],--Differenz zwischen der Signalzeit des wartenden Threads und der Zeit seines Beginns
	    [W1].[WaitCount] AS [WaitCount],--Anzahl der Wartungen dieses Typs. Dieser Zähler wird jedes Mal erhöht, wenn eine Wartung beginnt
	    CAST ([W1].[Percentage] AS DECIMAL (5, 2)) AS [Percentage],
	    CAST (([W1].[WaitS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgWait_S],
	    CAST (([W1].[ResourceS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgRes_S],
	    CAST (([W1].[SignalS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgSig_S]
	VON [Waits] ALS [W1]
	INNER JOIN [Waits] ALS [W2]
	    ON [W2].[RowNum] <= [W1].[RowNum]
	Gruppieren nach [W1].[RowNum], [W1].[wait_type], [W1].[WaitS],
	    [W1].[ResourceS], [W1].[SignalS], [W1].[WaitCount], [W1].[Percentage]
	HAVING SUM ([W2].[Percentage]) - [W1].[Percentage] < 95 -- Prozentgrenze
)
WÄHLEN [WaitType]
      ,MAX([Wait_S]) als [Wait_S]
      ,MAX([Resource_S]) als [Resource_S]
      ,MAX([Signal_S]) als [Signal_S]
      ,MAX([WaitCount]) als [WaitCount]
      ,MAX([Percentage]) als [Percentage]
      ,MAX([AvgWait_S]) als [AvgWait_S]
      ,MAX([AvgRes_S]) als [AvgRes_S]
      ,MAX([AvgSig_S]) als [AvgSig_S]
  VON ress
  gruppiert nach [WaitType];
In diesem Fall kann der Mangel an Arbeitsspeicher mit der folgenden Abfrage festgestellt werden:
SELECT [Percentage]
      ,[AvgWait_S]
  FROM [inf].[vWaits]
  where [WaitType] in (
    'PAGEIOLATCH_XX',
    'RESOURCE_SEMAPHORE',
    'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Hier sollte man auf die Werte von Percentage und AvgWait_S achten. Wenn diese zusammen erheblich sind, besteht eine hohe Wahrscheinlichkeit, dass der MS SQL Server nicht genügend Arbeitsspeicher hat. Bedeutende Werte werden individuell für jedes System bestimmt. Man kann jedoch mit dem folgenden Wert beginnen: Percentage>=1 und AvgWait_S>=0.005.
Um die Werte in ein Überwachungssystem (z. B. Zabbix) auszugeben, können die folgenden zwei Abfragen erstellt werden:
- wie viel Prozent die Wartetypen im Bezug auf RAM einnehmen (Summe aller solchen Wartetypen):
select coalesce(sum([Percentage]), 0.00) as [Percentage] from [inf].[vWaits] where [WaitType] in ( 'PAGEIOLATCH_XX', 'RESOURCE_SEMAPHORE', 'RESOURCE_SEMAPHORE_QUERY_COMPILE' ); - wie viel Zeit in Millisekunden die Wartetypen im Bezug auf RAM in Anspruch nehmen (maximaler Wert aus allen durchschnittlichen Wartezeiten für alle solchen Wartetypen):
select coalesce(max([AvgWait_S])*1000, 0.00) as [AvgWait_MS]
from [inf].[vWaits]
       where [WaitType] in (
           'PAGEIOLATCH_XX',
           'RESOURCE_SEMAPHORE',
            'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Basierend auf der Dynamik der erhaltenen Werte dieser beiden Indikatoren kann man schließen, ob ausreichend RAM für die Instanz des MS SQL Servers vorhanden ist.
Methode zur Erkennung der übermäßigen CPU-Belastung
Zur Erkennung des Mangels an CPU-Zeit genügt es, die systemeigene Sicht sys.dm_os_schedulers zu verwenden. Hier, wenn der Wert von runnable_tasks_count ständig größer als 1 ist, besteht eine hohe Wahrscheinlichkeit, dass die Anzahl der Kerne für die Instanz des MS SQL Servers nicht ausreicht.
Um den Wert in ein Überwachungssystem (z. B. Zabbix) auszugeben, kann die folgende Abfrage erstellt werden:
select max([runnable_tasks_count]) as [runnable_tasks_count]
from sys.dm_os_schedulers
where scheduler_id<255;
Basierend auf der Dynamik der erhaltenen Werte dieses Indikators kann man schließen, ob ausreichend CPU-Zeit (Anzahl der CPU-Kerne) für die Instanz des MS SQL Servers vorhanden ist.
Es ist jedoch wichtig zu beachten, dass die Abfragen mehrere Threads gleichzeitig anfordern können. Oftmals kann der Optimierer die Komplexität der Abfrage nicht korrekt einschätzen. Daher können zu viele Threads für die Abfrage reserviert werden, die zu diesem Zeitpunkt nicht gleichzeitig verarbeitet werden können. Dies führt ebenfalls zu einem Wartezustand, der mit einem Mangel an CPU-Zeit verbunden ist, und lässt die Warteschlange bei den Planern anwachsen, die bestimmte CPU-Kerne verwenden, d.h. der Wert von runnable_tasks_count wird unter diesen Bedingungen steigen.
In diesem Fall ist es wichtig, die Eigenschaften der Parallelität des MS SQL Server-Instanz korrekt einzustellen, bevor die Anzahl der CPU-Kerne erhöht wird. Ab Version 2016 müssen auch die Parallelitätseigenschaften der erforderlichen Datenbanken richtig konfiguriert werden:
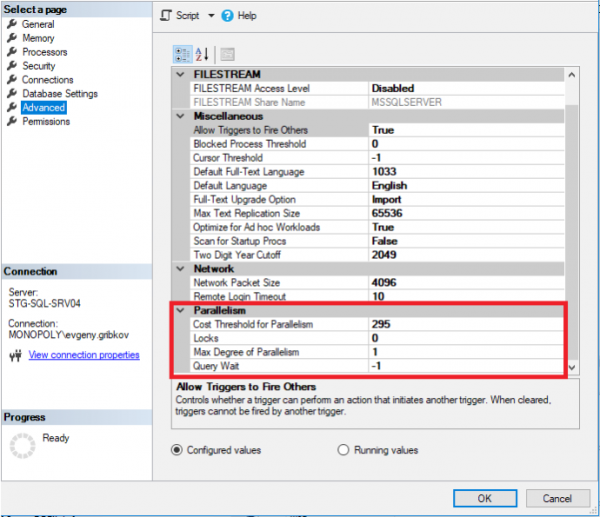
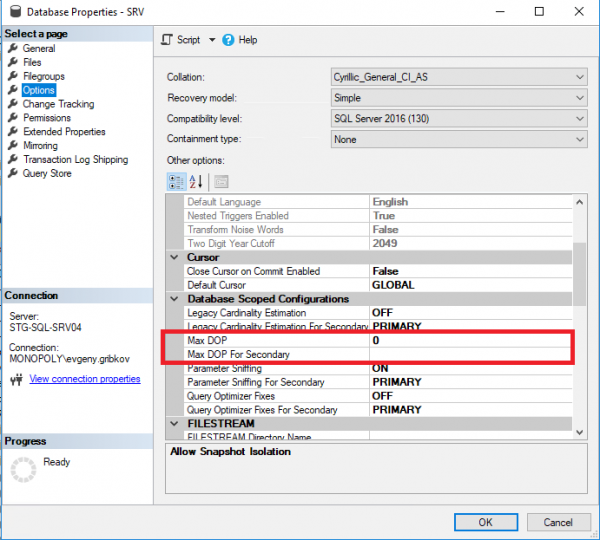
Hier sind die folgenden Parameter hervorzuheben:
- Max Degree of Parallelism - legt die maximale Anzahl an Threads fest, die jeder Abfrage zugewiesen werden können (standardmäßig 0 - Beschränkung nur durch das Betriebssystem und die Edition von MS SQL Server)
- Cost Threshold for Parallelism - die geschätzte Kostenschwelle für Parallelität (standardmäßig 5)
- Max DOP - legt die maximale Anzahl an Threads fest, die jeder Abfrage auf Datenbankebene zugewiesen werden können (aber nicht mehr als der Wert der Eigenschaft „Max Degree of Parallelism“) (standardmäßig 0 - Beschränkung nur durch das Betriebssystem und die Edition von MS SQL Server sowie durch die Eigenschaft „Max Degree of Parallelism“ der gesamten MS SQL Server-Instanz)
Hier ist es unmöglich, ein gleichwertig gutes Rezept für alle Fälle zu geben, d.h. es ist notwendig, schwere Abfragen zu analysieren.
Aus eigener Erfahrung empfehle ich den folgenden Handlungsalgorithmus zur Einstellung der Parallelitätseigenschaften für OLTP-Systeme:
- Zuerst Parallelität verbieten, indem der Max Degree of Parallelism auf Instanzebene auf 1 gesetzt wird.
- Die schwersten Abfragen analysieren und die optimale Anzahl an Threads für sie auswählen.
- Den Max Degree of Parallelism auf die in Punkt 2 ermittelte optimale Anzahl an Threads setzen, sowie für bestimmte Datenbanken den Max DOP-Wert, der aus Punkt 2 für jede Datenbank stammt, einstellen.
- Die schwersten Abfragen analysieren und negative Effekte der Multithread-Verarbeitung identifizieren. Wenn solche vorhanden sind, den Cost Threshold for Parallelism erhöhen.
Für Systeme wie 1C, Microsoft CRM und Microsoft NAV ist in den meisten Fällen ein Verbot der Multithread-Verarbeitung ausreichend.
Wenn Sie die Standard-Edition verwenden, ist in den meisten Fällen das Verbot von Mehrfachverarbeitung ausreichend, da diese Edition in der Anzahl der CPU-Kerne begrenzt ist.
Für OLAP-Systeme ist der oben beschriebene Algorithmus nicht geeignet.
Aus eigener Erfahrung empfehle ich den folgenden Handlungsalgorithmus für OLAP-Systeme zur Anpassung der Parallelitätseigenschaften:
- Die schwersten Abfragen analysieren und die optimale Anzahl an Threads für sie auswählen.
- Setzen Sie den Max Degree of Parallelism auf die optimal ermittelte Anzahl von Threads aus Punkt 1 und auch für bestimmte Datenbanken setzen Sie den Max DOP-Wert aus Punkt 1 für jede Datenbank.
- Analysieren Sie die ressourcenintensivsten Abfragen und identifizieren Sie negative Auswirkungen durch die Einschränkung der Parallelität. Wenn diese bestehen, sollten Sie entweder den Wert des Cost Threshold for Parallelism senken oder die Schritte 1-2 dieses Algorithmus wiederholen.
Das heißt, für OLTP-Systeme gehen wir von der Einzelverarbeitung zur Mehrfachverarbeitung, und für OLAP-Systeme gehen wir von der Mehrfachverarbeitung zur Einzelverarbeitung über. Auf diese Weise können optimale Parallelitätseinstellungen sowohl für eine bestimmte Datenbank als auch für die gesamte MS SQL Server-Instanz gefunden werden.
Es ist auch wichtig zu verstehen, dass die Einstellungen für die Parallelitätseigenschaften im Laufe der Zeit geändert werden müssen, basierend auf den Ergebnissen der Leistungsüberwachung des MS SQL Servers.
Empfehlungen zur Konfiguration von Trace-Flags
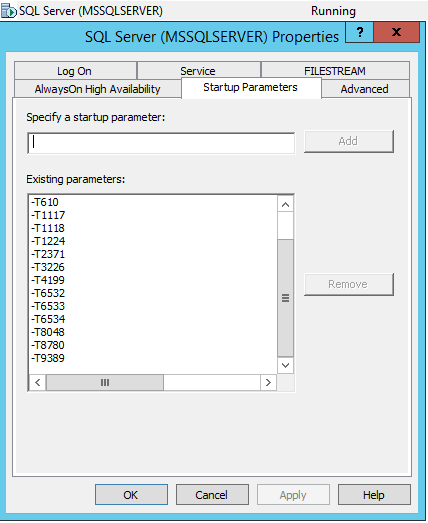
Aus eigener Erfahrung und der meiner Kollegen empfehle ich, für die Versionen 2008-2016 beim Start der MS SQL Server-Dienste die folgenden Trace-Flags zu setzen:
- 610 — Reduzierung der Protokollierung von Einfügungen in indizierte Tabellen. Kann bei Einfügungen in Tabellen mit vielen Datensätzen und zahlreichen Transaktionen helfen, wenn häufige lange Wartezeiten auf WRITELOG durch Änderungen in den Indizes auftreten.
- 1117 — Wenn eine Datei in der Dateigruppe die Anforderungen für die automatische Erhöhung erfüllt, werden alle Dateien in der Dateigruppe erhöht.
- 1118 — Erzwingt, dass alle Objekte in unterschiedlichen Extents angeordnet werden (Verbot von gemischten Extents), um die Notwendigkeit von SGAM-Seiten-Scans, die zur Verfolgung gemischter Extents verwendet werden, zu minimieren.
- 1224 — Deaktiviert das Block-Granularitätsmanagement basierend auf der Anzahl der Sperren. Eine zu aktive Speichernutzung kann jedoch die Granularitätsverwaltung von Sperren aktivieren.
- 2371 — Ändert die Schwelle für die feste automatische Aktualisierung der Statistiken auf die Schwelle für die dynamische automatische Aktualisierung der Statistiken. Wichtig für die Aktualisierung der Abfragepläne bei großen Tabellen, wo eine falsche Bestimmung der Anzahl der Datensätze zu fehlerhaften Ausführungsplänen führt.
- 3226 — Unterdrückt Meldungen über die erfolgreiche Durchführung von Backups im Fehlerprotokoll.
- 4199 — Aktiviert Änderungen im Abfrageoptimierer, die in kumulierten Update-Paketen und SQL Server-Updates veröffentlicht wurden.
- 6532-6534 — Aktiviert Leistungsverbesserungen bei Abfragen mit räumlichen Datentypen.
- 8048 — Wandelt NUMA-unterteilte Speicherobjekte in CPU-unterteilte um.
- 8780 — Aktiviert zusätzliche Zeitzuweisungen für die Erstellung von Abfrageplänen. Einige Abfragen können ohne dieses Flag abgelehnt werden, da sie keinen Abfrageplan haben (sehr seltene Fehlermeldung).
- 8780 — 9389 — Aktiviert einen zusätzlichen dynamisch zugewiesenen Zwischenspeicher für Batch-Operatoren, was es dem Batch-Operator ermöglicht, zusätzlichen Speicher anzufordern und eineÜbertragung von Daten in tempdb zu vermeiden, wenn zusätzlicher Speicher verfügbar ist.
Es ist auch bis zur Version 2016 nützlich, das Trace-Flag 2301 zu aktivieren, das eine erweiterte Unterstützung der Entscheidungsfindung optimiert und somit hilft, genauere Abfragepläne zu wählen. Ab Version 2016 hat es jedoch oft negative Auswirkungen auf die Gesamtausführungszeiten von Abfragen.
Für Systeme mit einer sehr hohen Anzahl an Indizes (zum Beispiel für 1C-Datenbanken) empfehle ich auch das Aktivieren des Trace-Flags 2330, das die Erfassung der Indexnutzung deaktiviert, was sich insgesamt positiv auf das System auswirkt.
Mehr Informationen über die Trace-Flags finden Sie hier.
Bei dem oben angegebenen Link ist es auch wichtig, die Versionen und Builds von MS SQL Server zu beachten, da in neueren Versionen einige Trace-Flags standardmäßig aktiviert sind oder keine Wirkung zeigen.
Das Aktivieren und Deaktivieren von Trace-Flags kann mit den Befehlen DBCC TRACEON und DBCC TRACEOFF erfolgen. Weitere Details finden Sie hier.
Den Status der Trace-Flags kann man mit dem Befehl DBCC TRACESTATUS abrufen:
Um die Tracing-Flags beim Autostart des MS SQL Server-Dienstes zu aktivieren, müssen Sie den SQL Server Configuration Manager aufrufen und die Tracing-Flags in den Dienstein Eigenschaften über -T hinzufügen.
Ergebnisse
In diesem Artikel wurden einige Aspekte des Monitorings von MS SQL Server behandelt, mit deren Hilfe Engpässe bei RAM und CPU-Zeit schnell identifiziert werden können, sowie eine Reihe anderer weniger offensichtlicher Probleme. Die häufigsten verwendeten Tracing-Flags wurden ebenfalls betrachtet.
Quellen:
»
»
»
»
»
»
»
Quelle: habr.com
