

Bis vor kurzem wurden in Odnoklassniki etwa 50 TB an in Echtzeit verarbeiteten Daten in SQL Server gespeichert. Bei einem solch großen Datenvolumen ist es nahezu unmöglich, schnellen und zuverlässigen, ausfallsicheren Zugang zu einem Rechenzentrum zu gewährleisten, wenn SQL-Datenbanken verwendet werden. In solchen Fällen verwendet man normalerweise eine der NoSQL-Datenbanken, doch nicht alles lässt sich in NoSQL übertragen: Einige Entitäten erfordern ACID-Transaktionsgarantien.
Das hat uns zur Nutzung eines NewSQL-Speichers geführt, also einer Datenbank, die die Ausfallsicherheit, Skalierbarkeit und Geschwindigkeit von NoSQL-Systemen bietet, aber gleichzeitig die für klassische Systeme gewohnten ACID-Garantien beibehält. Es gibt nur wenige funktionierenden Industrielösungen dieser neuen Klasse, weshalb wir selbst ein solches System entwickelt und in den produktiven Betrieb genommen haben.
Wie das funktioniert und was wir erreicht haben – lese weiter unten.
Heute hat die monatliche Nutzerzahl von „Odnoklassniki“ mehr als 70 Millionen einzigartige Besucher. Wir Sozialnetzwerken der Welt und zu den zwanzig Webseiten, auf denen Nutzer die meiste Zeit verbringen. Die Infrastruktur von „OK“ verarbeitet sehr hohe Lasten: über eine Million HTTP-Anfragen pro Sekunde an die Frontend-Server. Teile des Serverparks mit über 8000 Einheiten sind eng beieinander in vier Rechenzentren in Moskau untergebracht, was eine Netzwerkverzögerung von weniger als 1 ms zwischen ihnen ermöglicht.
Wir nutzen Cassandra seit 2010, beginnend mit Version 0.6. Heute betreiben wir mehrere Dutzend Cluster. Der schnellste Cluster verarbeitet mehr als 4 Millionen Operationen pro Sekunde, und der größte speichert 260 TB.
Allerdings sind das alles gängige NoSQL-Cluster, die zur Speicherung Daten verwendet werden. Wir wollten jedoch das primäre konsistente Speichersystem, Microsoft SQL Server, ersetzen, das seit der Gründung von „Odnoklassniki“ genutzt wurde. Das Speicher System bestand aus über 300 SQL Server Standard Edition-Rechnern, die 50 TB an Geschäftsdaten enthielten. Diese Daten werden im Rahmen von ACID-Transaktionen modifiziert und erfordern .
Für die Verteilung der Daten über die Knoten von SQL Server haben wir sowohl vertikale als auch horizontale (Sharding). Historisch gesehen haben wir ein einfaches Schema zur Datenpartitionierung verwendet: Jeder Entität wurde ein Token zugewiesen – eine Funktion der Entitäts-ID. Entitäten mit demselben Token wurden auf einen SQL-Server platziert. Die master-detail-Beziehung wurde so realisiert, dass die Tokens des Haupt- und des abgeleiteten Datensatzes immer übereinstimmten und sich auf demselben Server befanden. In sozialen Netzwerken werden fast alle Datensätze im Namen eines Benutzers erstellt – das bedeutet, dass alle Benutzerdaten innerhalb eines funktionalen Teilsystems auf demselben Server gespeichert werden. Das heißt, in Geschäftstransaktionen waren nahezu immer Tabellen eines SQL-Servers beteiligt, was die Konsistenz der Daten durch lokale ACID-Transaktionen ohne die Notwendigkeit einer Nutzung gewährleistete verteilten ACID-Transaktionen.
Dank des Shardings und zur Beschleunigung der SQL-Arbeiten:
- Verwenden wir keine Foreign Key Constraints, da die ID einer Entität beim Sharding auf einem anderen Server sein kann.
- Verwenden wir keine gespeicherten Prozeduren und Trigger aufgrund der zusätzlichen CPU-Belastung der Datenbankmanagementsysteme.
- Verwenden wir keine JOINs aufgrund all dessen und der Vielzahl an zufälligen Lesevorgängen von der Festplatte.
- Außerhalb von Transaktionen verwenden wir das Isolationsniveau Read Uncommitted, um Deadlocks zu reduzieren.
- Wir führen nur kurze Transaktionen aus (im Durchschnitt kürzer als 100 ms).
- Verwenden wir keine Mehrzeilen-UPDATE- und DELETE-Anweisungen aufgrund der hohen Anzahl an Deadlocks – wir aktualisieren immer nur einen Datensatz.
- Abfragen werden immer nur über Indizes ausgeführt – eine Abfrage mit einem vollständigen Tabellen-Scan bedeutet für uns eine Überlastung der Datenbank und ihren Ausfall.
Diese Schritte haben es ermöglicht, nahezu die maximale Leistung aus den SQL-Servern herauszuholen. Dennoch wurden die Probleme immer zahlreicher. Lass uns diese betrachten.
Probleme mit SQL
- Da wir ein selbst entwickeltes Sharding verwendet haben, wurden neue Shards manuell von den Administratoren hinzugefügt. Während dieser ganzen Zeit bedienten skalierbare Datenreplikate keine Anfragen.
- Mit dem Anstieg der Anzahl der Datensätze in der Tabelle verringert sich die Geschwindigkeit von Einfügungen und Modifikationen, beim Hinzufügen von Indizes zu bestehenden Tabellen sinkt die Geschwindigkeit exponentiell, die Erstellung und Rekonstruktion von Indizes erfolgt mit Ausfallzeiten.
- Das Vorhandensein einer kleinen Anzahl von Windows für SQL Server in der Produktion erschwert das Management der Infrastruktur.
Aber das Hauptproblem ist —
Fehlertoleranz
Ein klassischer SQL-Server hat eine schlechte Fehlertoleranz. Angenommen, Sie haben nur einen Datenbankserver, und dieser fällt alle drei Jahre aus. In dieser Zeit funktioniert die Website 20 Minuten lang nicht, was akzeptabel ist. Wenn Sie jedoch 64 Server haben, funktioniert die Website bereits alle drei Wochen nicht. Und wenn Sie 200 Server haben, funktioniert die Website jede Woche nicht. Das ist ein Problem.
Was kann man tun, um die Fehlertoleranz eines SQL-Servers zu erhöhen? Wikipedia schlägt uns vor, einen : zu erstellen, wo im Fall eines Ausfalls eines der Komponenten eine redundante vorhanden ist.
Das erfordert einen Park teurer Hardware: zahlreiche Redundanzen, Glasfaser, gemeinsame Speicher, und auch die Aktivierung des Backups funktioniert unzuverlässig: etwa 10 % der Aktivierungen enden mit dem Ausfall der Backup-Node hinter der Haupt-Node.
Aber der größte Nachteil eines solchen Hochverfügbarkeitsclusters ist die Nullverfügbarkeit bei einem Ausfall des Rechenzentrums, in dem er steht. Bei „Odnoklassniki“ gibt es vier Rechenzentren, und wir müssen den Betrieb bei einem kompletten Ausfall eines davon sicherstellen.
Dafür könnte man Replikation nutzen, die in SQL Server integriert ist. Diese Lösung ist aufgrund der Softwarekosten deutlich teurer und leidet unter gut bekannten Problemen mit der Replikation – unvorhersehbaren Verzögerungen von Transaktionen bei synchroner Replikation und Verzögerungen bei der Anwendung von Replikationen (und damit verloren gegangenen Modifikationen) bei asynchroner Replikation. Die implizite macht diese Option für uns völlig unbrauchbar.
All diese Probleme erforderten eine radikale Lösung, und wir begannen mit ihrer detaillierten Analyse. Hier müssen wir uns mit dem vertrautmachen, was SQL Server im Wesentlichen macht – Transaktionen.
Einfache Transaktion
Betrachten wir die einfachste Transaktion aus Sicht eines SQL-Anwendungsprogrammierers: das Hinzufügen eines Fotos zu einem Album. Alben und Fotos werden in verschiedenen Tabellen gespeichert. Ein Album hat einen Zähler für öffentliche Fotos. Dann wird eine solche Transaktion in die folgenden Schritte unterteilt:
- Wir sperren das Album nach Schüssel.
- Wir erstellen einen Eintrag in der Fototabelle.
- Wenn das Foto einen öffentlichen Status hat, erhöhen wir im Album den Zähler für öffentliche Fotos, aktualisieren den Eintrag und committen die Transaktion.
Oder in Form von Pseudocode:
TX.start("Alben", id);
Album album = albums.lock(id);
Foto foto = photos.create(…);

if (foto.status == PUBLIC ) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Wir sehen, dass das häufigste Szenario für Geschäftstransaktionen darin besteht, Daten aus der Datenbank in den Arbeitsspeicher der Anwendungsserver zu lesen, etwas zu ändern und die neuen Werte zurück in die Datenbank zu speichern. In der Regel aktualisieren wir in einer solchen Transaktion mehrere Entitäten, mehrere Tabellen.
Während der Ausführung einer Transaktion kann es zu konkurrierenden Modifizierungen derselben Daten aus einem anderen System kommen. Zum Beispiel kann ein Antispam-System entscheiden, dass ein Benutzer verdächtig ist, und daher sollten alle Fotos des Benutzers nicht mehr öffentlich sein, sondern zur Moderation gesendet werden, was bedeutet, dass photo.status auf einen anderen Wert geändert und entsprechende Zähler zurückgesetzt werden müssen. Offensichtlich wird das Ergebnis, wenn diese Operation ohne Garantien für die Atomarität der Anwendung und die Isolation konkurrierender Modifikationen erfolgt, nicht das sein, was benötigt wird — entweder wird der Fotozähler einen falschen Wert anzeigen oder nicht alle Fotos werden zur Moderation geschickt. , dann wird das Ergebnis nicht den Anforderungen entsprechen — entweder zeigt der Fotocounter einen falschen Wert an oder nicht alle Fotos werden zur Moderation geschickt.
Eine derartige Codierung, die mit verschiedenen Geschäftseinheiten im Rahmen einer einzigen Transaktion umgeht, wurde seit der Gründung von Odnoklassniki in großer Zahl geschrieben. Nach unseren Erfahrungen mit Migrationen zu NoSQL mit wissen wir, dass die größten Schwierigkeiten (und der Zeitaufwand) darin bestehen, Code zu entwickeln, der darauf abzielt, die Datenkonsistenz aufrechtzuerhalten. Daher hielten wir die Bereitstellung echter ACID-Transaktionen für die Anwendungsebene für die wichtigste Anforderung an den neuen Speicher.
Andere, nicht weniger wichtige Anforderungen waren:
- Bei einem Ausfall des Rechenzentrums müssen sowohl Lese- als auch Schreibzugriffe auf den neuen Speicher möglich sein.
- Die aktuelle Geschwindigkeit der Entwicklung muss beibehalten werden. Das bedeutet, dass die Menge an Code bei der Arbeit mit dem neuen Speicher ungefähr die gleiche sein sollte, es sollte nicht erforderlich sein, etwas im Speicher hinzuzufügen, Algorithmen zur Konfliktlösung, zur Unterstützung von Sekundärindizes usw. zu entwickeln.
- Die Geschwindigkeit des neuen Speichers sollte sowohl beim Lesen von Daten als auch bei der Verarbeitung von Transaktionen ausreichend hoch sein, was effektiv die Unanwendbarkeit akademisch strenger, universeller, aber langsamer Lösungen wie zum Beispiel bedeutet, .
- Automatische Skalierung in Echtzeit.
- Verwendung gewöhnlicher, kostengünstiger Server, ohne dass der Kauf exotischer Hardware erforderlich ist.
- Die Möglichkeit, das Speichersystem mit den Kräften der Unternehmensentwickler weiterzuentwickeln. Mit anderen Worten, die Priorität lag auf internen oder Open-Source-Lösungen, vorzugsweise in Java.
Lösungen, Lösungen
Bei der Analyse möglicher Lösungen sind wir zu zwei möglichen Architekturentscheidungen gekommen:
Die erste – einen beliebigen SQL-Server zu verwenden und die benötigte Fehlertoleranz, einen Skalierungsmechanismus, einen ausfallsicheren Cluster, Konfliktlösung und verteilte, zuverlässige und schnelle ACID-Transaktionen zu implementieren. Wir haben diese Option als ziemlich untrivial und arbeitsintensiv eingeschätzt.
Die zweite Option – ein fertiges NoSQL-Speichersystem mit implementierter Skalierung und ausfallsicherem Cluster zu verwenden und die Transaktionen und SQL selbst zu implementieren. Auf den ersten Blick erscheint die Aufgabe, SQL zu implementieren, ganz zu schweigen von ACID-Transaktionen, wie eine Aufgabe für Jahre. Doch später erkannten wir, dass das Set von SQL-Funktionen, das wir in der Praxis verwenden, so weit von ANSI SQL entfernt ist wie entfernt von ANSI SQL. Bei genauerer Betrachtung von CQL wurde uns klar, dass es ziemlich nah an dem ist, was wir brauchen.
Cassandra und CQL
Also, was macht Cassandra so interessant, welche Möglichkeiten bietet sie?
Erstens kann man hier Tabellen mit Unterstützung für verschiedene Datentypen erstellen und kann SELECT oder UPDATE anhand des Primärschlüssels durchführen.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
Um die Konsistenz der Datenreplikate zu gewährleisten, verwendet Cassandra . Im einfachsten Fall bedeutet dies, dass beim Platzieren von drei Replikaten derselben Zeile auf verschiedenen Knoten des Clusters der Schreibvorgang als erfolgreich gilt, wenn die Mehrheit der Knoten (d.h. zwei von drei) den Erfolg dieser Schreiboperation bestätigt hat. Die Daten der Zeile werden als konsistent betrachtet, wenn bei der Lesung die Mehrheit der Knoten befragt wurde und dies bestätigt haben. So wird bei Vorliegen von drei Replikaten vollständige und sofortige Datenkonsistenz bei Ausfall eines Knotens gewährleistet. Dieser Ansatz ermöglichte es uns, ein noch zuverlässigeres Schema zu implementieren: Immer Anfragen an alle drei Replikate zu senden und auf die Antworten der zwei schnellsten zu warten. Die verspätete Antwort des dritten Replikats wird in diesem Fall verworfen. Der verspätete Knoten könnte dabei ernsthafte Probleme haben – Verzögerungen, Garbage Collection in der JVM, Direct Memory Reclaim im Linux-Kernel, Hardwareausfälle, Netzwerkausfälle. Dies hat jedoch keinerlei Einfluss auf die Operationen des Clients und auf die Daten.
Der Ansatz, bei dem wir auf drei Knoten zugreifen und von zwei eine Antwort erhalten, wird : die Anfrage an zusätzliche Replikate wird gesendet, bevor ein "Ausfall" auftritt.
Ein weiterer Vorteil von Cassandra ist das Batchlog – ein Mechanismus, der entweder die vollständige Anwendung oder die vollständige Nicht-Anwendung des von Ihnen vorgenommenen Änderungssets garantiert. Dies ermöglicht es uns, A in ACID – atomar aus der Box – zu lösen.
Am nächsten zu Transaktionen in Cassandra sind die sogenannten „“. Doch sie sind von „echten“ ACID-Transaktionen weit entfernt: Tatsächlich handelt es sich um die Möglichkeit, einen auf den Daten eines einzelnen Datensatzes durch Konsens mit dem schwergewichtigen Paxos-Protokoll durchzuführen. Daher ist die Geschwindigkeit solcher Transaktionen gering.
Was uns in Cassandra fehlte
Wir mussten also in Cassandra echte ACID-Transaktionen implementieren. Mit deren Hilfe könnten wir zwei weitere nützliche Funktionen klassischer DBMS einfach umsetzen: konsistente schnelle Indizes, was es uns ermöglichen würde, Datenabfragen nicht nur nach dem Primärschlüssel durchzuführen, und normalerweise einen Generator für monotone Autoinkrement-ID.
C*One
So entstand ein neues DBMS C*One, das aus drei Arten von Serverknoten besteht:
- Speicher — (fast) Standard-Cassandra-Server, die für die Speicherung von Daten auf lokalen Laufwerken verantwortlich sind. Mit zunehmender Last und Datenvolumen kann die Anzahl leicht auf Dutzende oder Hunderte skaliert werden.
- Die Transaktionskoordinatoren sorgen für die Ausführung von Transaktionen.
- Clients sind Anwendungsserver, die Geschäftsoperationen umsetzen und Transaktionen initiieren. Es können Tausende solcher Clients existieren.
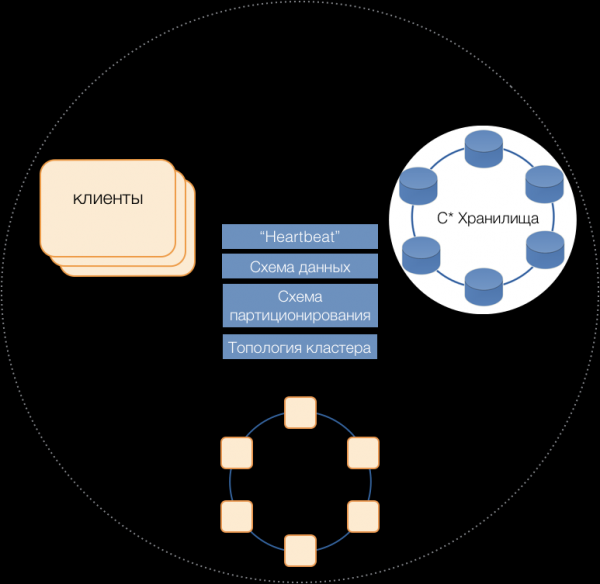
Server aller Typen sind in einem gemeinsamen Cluster verbunden, verwenden das interne Messaging-Protokoll von Cassandra zur Kommunikation untereinander und zum Austausch von Clusterinformationen. Durch Heartbeat erfahren die Server von gegenseitigen Ausfällen und halten ein einheitliches Datenschema – Tabellen, deren Struktur und Replikation; das Partitionierungsschema, die Cluster-Topologie usw.
Clients
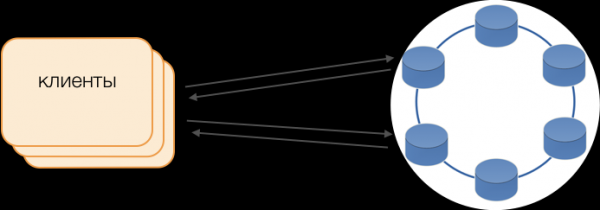
Statt der Standardtreiber wird der Fat Client-Modus verwendet. Knoten in diesem Modus speichern keine Daten, können aber als Koordinator der Anfrageausführung fungieren, das heißt, der Client selbst übernimmt die Funktion des Koordinators seiner Anfragen: Er befragt die Replikate des Speichers und löst Konflikte. Dies ist nicht nur zuverlässiger und schneller als der Standardtreiber, der Kommunikation mit einem entfernten Koordinator erfordert, sondern ermöglicht auch die Verwaltung der Übertragung von Anfragen. Anfragen außerhalb einer offenen Transaktion auf dem Client werden an die Speicher geleitet. Wenn der Client jedoch eine Transaktion eröffnet hat, werden alle Anfragen innerhalb dieser Transaktion an den Transaktionskoordinator gesendet.
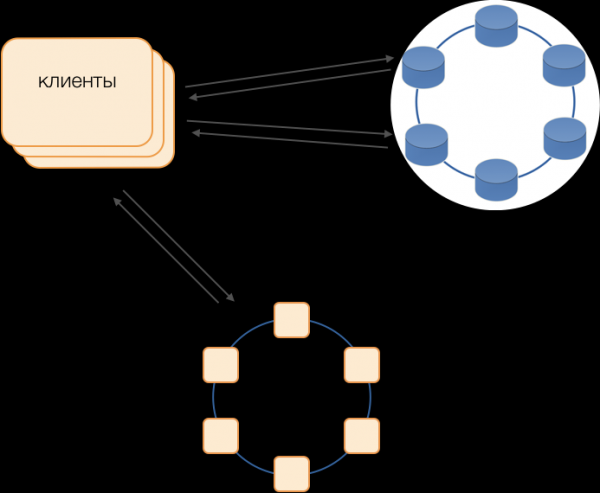
Transaktionskoordinator C*One
Der Koordinator ist das, was wir für C*One von Grund auf umgesetzt haben. Er ist verantwortlich für die Verwaltung von Transaktionen, Sperren und der Reihenfolge, in der Transaktionen angewendet werden.
Für jede verwaltete Transaktion generiert der Koordinator einen Zeitstempel: jeder nachfolgende ist größer als der des vorherigen. Da das Konfliktlösungsverfahren in Cassandra auf Zeitstempeln basiert (von zwei konfligierenden Datensätzen wird der mit dem späteren Zeitstempel als aktuell betrachtet), wird jeder Konflikt immer zugunsten der nachfolgenden Transaktion gelöst. So haben wir – eine kostengünstige Methode zur Konfliktlösung in verteilten Systemen.
Sperren
Zur Gewährleistung der Isolation haben wir uns für die einfachste Methode entschieden – pessimistische Sperren nach dem Primärschlüssel des Datensatzes. Mit anderen Worten, in der Transaktion muss der Datensatz zunächst gesperrt werden, bevor er gelesen, modifiziert und gespeichert werden kann. Erst nach einem erfolgreichen Commit kann der Datensatz entsperrt werden, damit konkurrierende Transaktionen ihn nutzen können.
Die Umsetzung einer solchen Sperrung ist in einer nicht verteilten Umgebung einfach. In einem verteilten System gibt es zwei Hauptansätze: Entweder implementiert man eine verteilte Sperrung im Cluster oder man verteilt die Transaktionen so, dass Transaktionen, die eine bestimmte Datensätze betreffen, immer von demselben Koordinator bearbeitet werden.
Da in unserem Fall die Daten bereits auf Gruppen lokaler Transaktionen in SQL verteilt sind, wurde beschlossen, die Gruppen lokaler Transaktionen Koordinatoren zuzuweisen: Ein Koordinator führt alle Transaktionen mit einem Token von 0 bis 9 aus, der zweite Koordinator die Transaktionen mit einem Token von 10 bis 19 und so weiter. Infolgedessen wird jeder der Koordinatorinstanzen zum Master der Transaktionsgruppe.
In diesem Fall können Sperren in Form eines banalen HashMap im Speicher des Koordinators implementiert werden.
Ausfälle von Koordinatoren
Da ein Koordinator ausschließlich eine Gruppe von Transaktionen betreut, ist es sehr wichtig, schnell den Ausfall dieses Koordinators zu erkennen, damit der erneute Versuch, die Transaktion auszuführen, innerhalb des Timeouts liegt. Um dies schnell und zuverlässig zu gestalten, haben wir ein voll verknüpftes quorum-basiertes Heartbeat-Protokoll verwendet:
In jedem Rechenzentrum gibt es mindestens zwei Koordinator-Knoten. Periodisch sendet jeder Koordinator Heartbeat-Nachrichten an die anderen Koordinatoren und informiert diese über seine Funktionsweise sowie darüber, von welchen Koordinatoren im Cluster er zuletzt Heartbeat-Nachrichten erhalten hat.
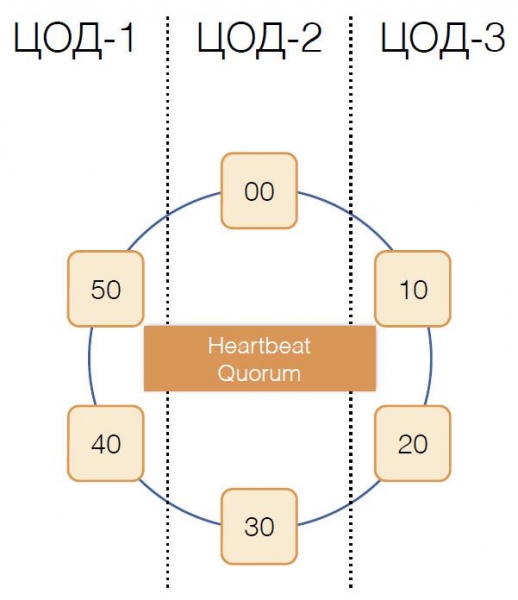
Indem sie ähnliche Informationen von den anderen in ihren Heartbeat-Nachrichten erhalten, entscheidet jeder Koordinator für sich selbst, welche Knoten im Cluster funktionieren und welche nicht, basierend auf dem Quorum-Prinzip: Wenn Knoten X von der Mehrheit der Knoten im Cluster Informationen über den normalen Erhalt von Nachrichten von Knoten Y erhält, funktioniert Y. Umgekehrt, sobald die Mehrheit meldet, dass sie keine Nachrichten von Knoten Y mehr erhält, ist Y ausgefallen. Interessanterweise wird, wenn das Quorum Knoten X darüber informiert, dass es keine Nachrichten mehr von ihm erhält, Knoten X sich selbst als ausgefallen betrachten.
Heartbeat-Nachrichten werden mit einer hohen Frequenz gesendet, etwa 20 Mal pro Sekunde, mit einem Intervall von 50 ms. In Java ist es schwierig, die Anwendungsantwort innerhalb von 50 ms zu garantieren, aufgrund der vergleichbaren Dauer von Pausen, die durch den Garbage Collector verursacht werden. Wir haben es geschafft, eine solche Reaktionszeit mit dem G1-Garbage Collector zu erreichen, der es ermöglicht, ein Ziel für die Dauer der GC-Pausen anzugeben. Allerdings kommen gelegentlich, ziemlich selten, die Pausen des Collectors über 50 ms hinaus, was zu einem falschen Ausfallnachweis führen kann. Um dies zu vermeiden, meldet der Koordinator den Ausfall eines entfernten Knotens nicht bei Verlust der ersten Heartbeat-Nachricht, sondern nur, wenn mehrere hintereinander verloren gehen. So konnten wir die Ausfallsicherung des Koordinatorknotens in 200 ms erreichen.
Es reicht jedoch nicht aus, schnell herauszufinden, welcher Knoten nicht mehr funktioniert. Wir müssen etwas dagegen unternehmen.
Reservierung
Das klassische Schema sieht vor, im Falle eines Ausfalls des Masters eine Wahl für einen neuen mit Hilfe eines der Algorithmen zu starten. Solche Algorithmen haben jedoch wohlbekannte Probleme mit der Konvergenz über die Zeit und der Dauer des gesamten Wahlprozesses. Solche zusätzlichen Verzögerungen konnten wir durch das Koordinatoren-Substitutionsschema in einem vollverketteten Netzwerk vermeiden:
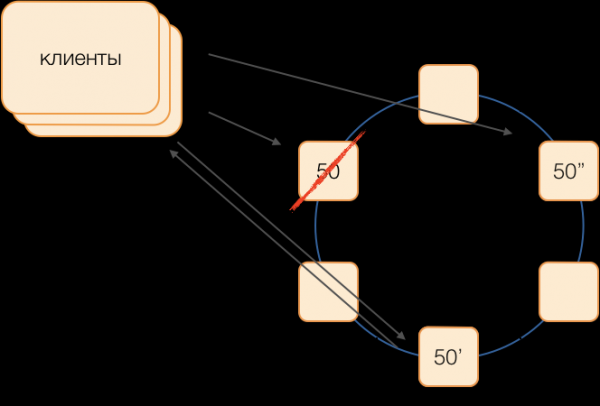
Angenommen, wir möchten eine Transaktion in der Gruppe 50 durchführen. Wir definieren im Voraus das Substitutionsschema, also welche Knoten die Transaktionen der Gruppe 50 im Falle eines Ausfalls des primären Koordinators ausführen werden. Unser Ziel ist es, die Betriebsfähigkeit des Systems im Falle eines Ausfalls des Rechenzentrums zu erhalten. Wir legen fest, dass der erste Ersatzknoten aus einem anderen Rechenzentrum kommen wird und der zweite Ersatz aus dem dritten. Dieses Schema wird einmal ausgewählt und ändert sich nicht, bis sich die Topologie des Clusters ändert, also bis neue Knoten hinzukommen (was sehr selten passiert). Die Reihenfolge zur Auswahl eines neuen aktiven Masters im Falle eines Ausfalls des alten wird immer so sein: Der erste Ersatz wird der aktive Master und falls auch dieser nicht mehr funktioniert, wird der zweite Ersatz aktiv.
Dieses Schema ist zuverlässiger als der universelle Algorithmus, da zur Aktivierung eines neuen Masters lediglich der Ausfall des alten festgestellt werden muss.
Wie können die Kunden jedoch wissen, welcher Meister gerade arbeitet? Es ist unmöglich, innerhalb von 50 ms Informationen an Tausende von Kunden zu senden. Es kann vorkommen, dass ein Kunde eine Anfrage zur Eröffnung einer Transaktion sendet, ohne zu wissen, dass dieser Meister nicht mehr funktioniert, und die Anfrage an einem Timeout hängen bleibt. Um dies zu vermeiden, senden die Kunden spekulativ Anfragen zur Eröffnung von Transaktionen gleichzeitig an den Gruppenmeister und beide Reserven, aber nur derjenige, der derzeit aktiver Meister ist, wird auf diese Anfrage antworten. Alle nachfolgenden Kommunikationen im Rahmen der Transaktion werden der Kunde nur mit dem aktiven Meister führen.
Reservemeister platzieren empfangene Anfragen für nicht ihre Transaktionen in der Warteschlange der ungeborenen Transaktionen, wo sie eine Zeit lang gespeichert werden. Wenn der aktive Meister stirbt, bearbeitet der neue Meister die Anfragen zur Eröffnung von Transaktionen aus seiner Warteschlange und antwortet dem Kunden. Wenn der Kunde bereits eine Transaktion mit dem alten Meister eröffnet hat, wird die zweite Antwort ignoriert (und offensichtlich wird eine solche Transaktion nicht abgeschlossen und vom Kunden wiederholt).
Wie funktioniert eine Transaktion
Angenommen, der Kunde hat dem Koordinator eine Anfrage zur Eröffnung einer Transaktion für eine bestimmte Entität mit einem bestimmten Primärschlüssel gesendet. Der Koordinator sperrt diese Entität und platziert sie in der Sperrtabelle im Speicher. Falls erforderlich, liest der Koordinator diese Entität aus dem Speicher und speichert die erhaltenen Daten im Transaktionszustand im Speicher des Koordinators.
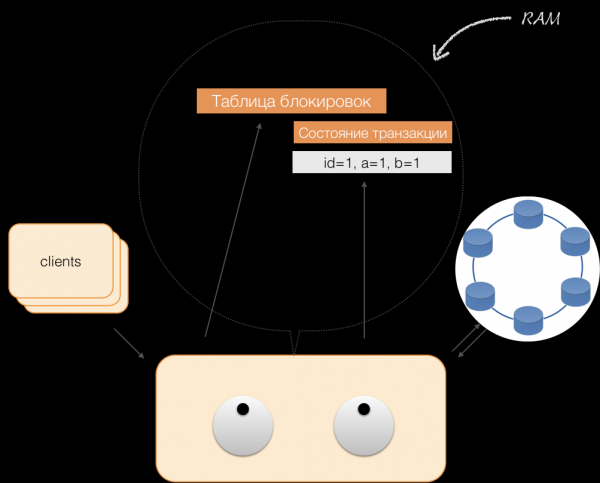
Wenn der Kunde die Daten in der Transaktion ändern möchte, sendet er dem Koordinator eine Anfrage zur Modifizierung der Entität, und dieser platziert die neuen Daten in der Tabelle des Transaktionszustands im Speicher. An dieser Stelle ist der Eintrag abgeschlossen – ein Eintrag im Speicher wird nicht vorgenommen.
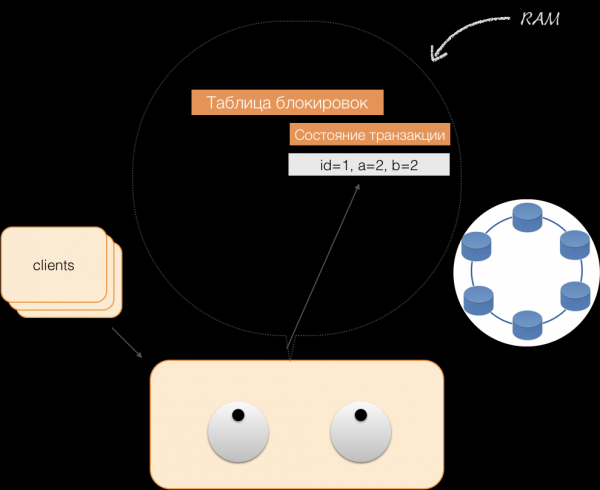
Wenn der Kunde im Rahmen einer aktiven Transaktion seine eigenen geänderten Daten anfordert, handelt der Koordinator wie folgt:
- Wenn die ID bereits in der Transaktion vorhanden ist, werden die Daten aus dem Speicher genommen;
- Wenn die ID nicht im Speicher vorhanden ist, werden die fehlenden Daten aus den Knoten-Speichern ausgelesen, mit bereits im Speicher vorhandenen Daten kombiniert und das Ergebnis dem Kunden übergeben.
So kann der Kunde seine eigenen Änderungen lesen, während andere Kunden diese Änderungen nicht sehen, da sie nur im Speicher des Koordinators gehalten werden und in den Cassandra-Knoten noch nicht vorhanden sind.
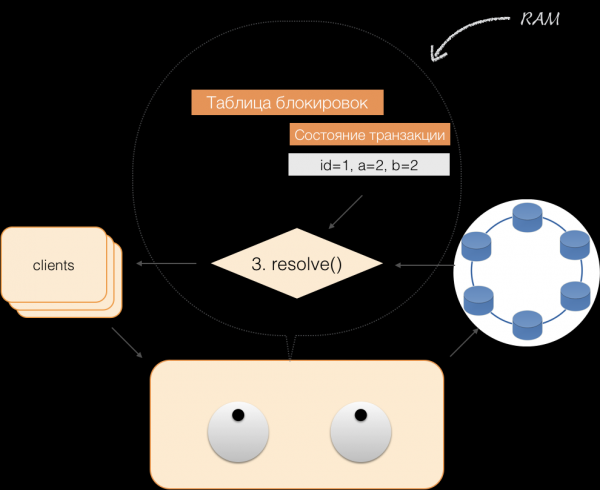
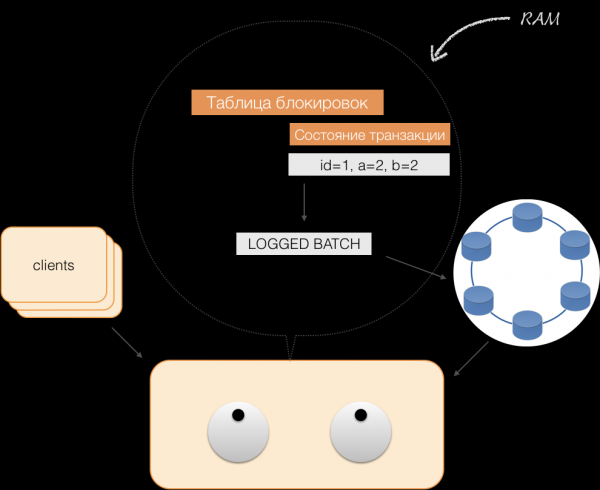
Wenn ein Kunde ein Commit sendet, wird der Zustand, der im Speicher des Services vorhanden war, vom Koordinator im logged batch gespeichert und als logged batch an die Cassandra-Speicher gesendet. Die Speicher sorgen dafür, dass dieses Paket atomar (vollständig) angewendet wird, und senden eine Antwort an den Koordinator zurück, der dann die Sperren freigibt und dem Kunden den Erfolg der Transaktion bestätigt.
Für einen Rollback reicht es dem Koordinator aus, nur den im Speicher belegten Zustand der Transaktion freizugeben.
Durch die oben beschriebenen Anpassungen haben wir die ACID-Prinzipien umgesetzt:
- Atomarität. Das ist die Garantie, dass keine Transaktion teilweise im System festgehalten wird, sondern entweder werden alle ihre Unteroperationen ausgeführt oder keine einzige. Dieses Prinzip wird bei uns durch die logged batch in Cassandra gewährleistet.
- Konsistenz. Jede erfolgreiche Transaktion fixiert definitionsgemäß nur zulässige Ergebnisse. Wenn nach dem Öffnen der Transaktion und der Ausführung einiger Operationen festgestellt wird, dass das Ergebnis unzulässig ist, wird ein Rollback durchgeführt.
- Isolierung. Bei der Ausführung der Transaktion dürfen parallele Transaktionen keinen Einfluss auf ihr Ergebnis haben. Konkurrenzierende Transaktionen sind durch pessimistische Sperren beim Koordinator isoliert. Für Lesevorgänge außerhalb der Transaktion wird das Isolationsprinzip auf Ebene von Read Committed eingehalten.
- Beständigkeit. Unabhängig von Problemen auf den unteren Ebenen – wie Stromausfällen, Hardwarefehlern – müssen die Änderungen, die von einer erfolgreich abgeschlossenen Transaktion vorgenommen wurden, nach der Wiederherstellung des Betriebs erhalten bleiben.
Lesen nach Indizes
Nehmen wir eine einfache Tabelle:
CREATE TABLE photos (
id bigint primary key,
owner bigint,
modified timestamp,
…)
Sie hat eine ID (Primärschlüssel), einen Besitzer und ein Änderungsdatum. Es muss eine sehr einfache Abfrage durchgeführt werden – die Daten nach dem Besitzer mit dem Änderungsdatum „in den letzten 24 Stunden“ auszuwählen.
SELECT *
WHERE owner=?
AND modified>?
Damit eine solche Abfrage schnell ausgeführt werden kann, muss in einer klassischen SQL-Datenbank ein Index über die Spalten (owner, modified) erstellt werden. Dies können wir recht einfach tun, da wir jetzt ACID-Garantien haben!
Indizes in C*One
Es gibt eine Ausgangstabelle mit Fotos, in der die ID des Datensatzes der Primärschlüssel ist.
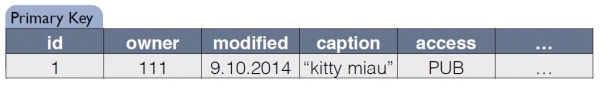
Für C*One wird eine neue Tabelle erstellt, die eine Kopie der ursprünglichen ist. Der Schlüssel entspricht dem Indexausdruck, wobei auch der Primärschlüssel des Datensatzes aus der ursprünglichen Tabelle einbezogen wird:
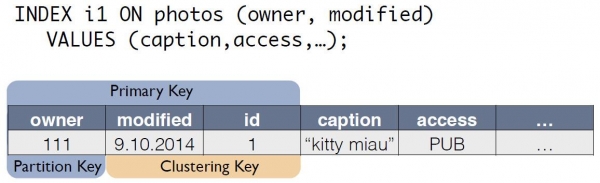
Jetzt kann die Abfrage nach „Besitzer der letzten 24 Stunden“ umgeschrieben werden als select aus einer anderen Tabelle:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
Die Konsistenz der Daten der ursprünglichen Tabelle photos und des Index i1 wird automatisch vom Koordinator aufrechterhalten. Basierend auf dem Datenschema generiert der Koordinator bei Änderungen und speichert nicht nur die Änderungen der Haupttabelle, sondern auch die Änderungen der Kopien. Es werden keine zusätzlichen Maßnahmen mit der Indextabelle durchgeführt, Protokolle werden nicht gelesen, und es werden keine Sperren verwendet. Das Hinzufügen von Indizes verbraucht also nahezu keine Ressourcen und beeinträchtigt die Geschwindigkeit der Modifizierung nicht.
Mit Hilfe von ACID ist es uns gelungen, Indizes „wie in SQL“ zu implementieren. Sie besitzen Konsistenz, sind skalierbar, arbeiten schnell, können zusammengesetzt sein und sind in die CQL-Abfragesprache integriert. Für die Unterstützung von Indizes müssen keine Änderungen am Anwendungscode vorgenommen werden. Alles ist so einfach wie in SQL. Und das Wichtigste ist, dass die Indizes die Geschwindigkeit der Ausführung von Modifikationen der Ursprungsdatenbank nicht beeinträchtigen.
Was ist herausgekommen?
Wir haben C*One vor drei Jahren entwickelt und in den produktiven Betrieb genommen.
Was haben wir also erreicht? Lassen Sie es uns am Beispiel des Systems zur Verarbeitung und Speicherung von Fotos bewerten, einer der wichtigsten Datentypen im sozialen Netzwerk. Es geht nicht um die Fotos selbst, sondern um die verschiedenen Metainformationen. Derzeit gibt es in „Odnoklassniki“ etwa 20 Milliarden solcher Datensätze, das System verarbeitet 80.000 Leseanfragen pro Sekunde, bis zu 8.000 ACID-Transaktionen pro Sekunde, die mit der Modifikation von Daten verbunden sind.
Als wir SQL mit einem Replikationsfaktor von 1 (aber in RAID 10) verwendeten, wurden die Metainformationen der Fotos in einem hochverfügbaren Cluster von 32 Maschinen mit Microsoft SQL Server (plus 11 Backup-Maschinen) gespeichert. Außerdem wurden 10 Server für die Speicherung von Backups bereitgestellt. Zusammen also 50 teure Maschinen. Dabei lief das System unter nominaler Last, ohne Puffer.
Nach der Migration auf das neue System haben wir einen Replikationsfaktor von 3 erhalten – je eine Kopie in jedem Rechenzentrum. Das System besteht aus 63 Cassandra-Storage-Nodes und 6 Koordinator-Maschinen, insgesamt 69 Servern. Diese Maschinen sind jedoch erheblich günstiger, ihre Gesamtkosten betragen etwa 30 % der Kosten des SQL-Systems. Die Auslastung bleibt dabei auf einem Niveau von 30 %.
Mit der Einführung von C*One sanken auch die Latenzen: Bei SQL betrug die Schreiboperation etwa 4,5 ms. Bei C*One sind es etwa 1,6 ms. Die Dauer von Transaktionen liegt im Durchschnitt unter 40 ms, ein Commit dauert 2 ms, und die Dauer für Lese- und Schreibvorgänge beträgt im Durchschnitt 2 ms. Der 99. Perzentil liegt bei lediglich 3-3,1 ms, die Anzahl der Zeitüberschreitungen hat sich um das 100-fache reduziert – alles dank der umfassenden Nutzung von Spekulationen.
Bis zu diesem Zeitpunkt wurden die meisten SQL Server-Nodes stillgelegt, neue Produkte werden ausschließlich mit C*One entwickelt. Wir haben C*One für die Arbeit in unserer Cloud angepasst. , was die Bereitstellung neuer Cluster beschleunigte, die Konfiguration vereinfachte und den Betrieb automatisierte. Ohne den Quellcode wäre dies erheblich komplizierter und fehleranfälliger gewesen.
Derzeit arbeiten wir an der Migration unserer anderen Speichersysteme in die Cloud — aber das ist eine ganz andere Geschichte.
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish