

Die klassische Frage, mit der ein Entwickler zu seinem DBA oder dem Geschäftsinhaber — zum PostgreSQL-Berater — kommt, klingt fast immer gleich: „Warum dauern die Abfragen auf der Datenbank so lange?“
Der traditionelle Satz von Gründen:
- ineffizienter Algorithmus
wenn Sie beschlossen haben, mehrere CTE über ein paar Zehntausend Datensätze zu verknüpfen - nicht aktuelle Statistiken.
wenn die tatsächliche Verteilung der Daten in der Tabelle bereits stark von der zuletzt durch ANALYZE gesammelten abweicht - ein Ressourcenengpass.
und die zugewiesenen CPU-Rechenressourcen nicht ausreichen, ständig werden Gigabyte an Arbeitsspeicher benötigt oder die Festplatte kommt mit all den „Wünschen“ der DB nicht nach - von Sperren von konkurrierenden Prozessen
Und wenn die Sperren ziemlich schwer zu erfassen und zu analysieren sind, dann genügt uns für alles andere der Abfrageplan, den man mit Hilfe von (am besten, gleich EXPLAIN (ANALYZE, BUFFERS) …) oder .
Aber, wie in derselben Dokumentation gesagt,
„Das Verständnis des Plans ist eine Kunst, und um es zu beherrschen, benötigt man gewisse Erfahrung, …“
Aber man kann auch ohne ihn auskommen, wenn man das richtige Werkzeug nutzt!
Wie sieht ein Abfrageplan normalerweise aus? So etwa:
Index Scan using pg_class_relname_nsp_index on pg_class (actual time=0.049..0.050 rows=1 loops=1)
  Index Cond: (relname = $1)
  Filter: (oid = $0)
  Buffers: shared hit=4
  InitPlan 1 (returns $0,$1)
    ->  Limit (actual time=0.019..0.020 rows=1 loops=1)
          Buffers: shared hit=1
          ->  Seq Scan on pg_class pg_class_1 (actual time=0.015..0.015 rows=1 loops=1)
                Filter: (relkind = 'r'::"char")
                Rows Removed by Filter: 5
                Buffers: shared hit=1
oder so:
"Append  (cost=868.60..878.95 rows=2 width=233) (actual time=0.024..0.144 rows=2 loops=1)"
"  Buffers: shared hit=3"
"  CTE cl"
"    ->  Seq Scan on pg_class  (cost=0.00..868.60 rows=9972 width=537) (actual time=0.016..0.042 rows=101 loops=1)"
"          Buffers: shared hit=3"
"  ->  Limit  (cost=0.00..0.10 rows=1 width=233) (actual time=0.023..0.024 rows=1 loops=1)"
"        Buffers: shared hit=1"
"        ->  CTE Scan on cl  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.021..0.021 rows=1 loops=1)"
"              Buffers: shared hit=1"
"  ->  Limit  (cost=10.00..10.10 rows=1 width=233) (actual time=0.117..0.118 rows=1 loops=1)"
"        Buffers: shared hit=2"
"        ->  CTE Scan on cl cl_1  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.001..0.104 rows=101 loops=1)"
"              Buffers: shared hit=2"
"Planning Time: 0.634 ms"
"Execution Time: 0.248 ms"
Aber einen Plan „vom Blatt“ zu lesen, ist sehr schwierig und unübersichtlich:
- im Knoten wird die Summe der Ressourcen des Teilbaums
Das heißt, um zu verstehen, wie viel Zeit für die Ausführung eines bestimmten Knotens benötigt wurde, oder wie viele Daten genau bei diesem Lesevorgang aus der Tabelle vom Datenträger geholt wurden — muss man irgendwie eines vom anderen abziehen - die Zeit des Knotens muss mit loops multipliziert werden
Ja, Subtraktion ist noch nicht die schwierigste Operation, die man "im Kopf" machen muss – denn die Ausführungszeit wird als Durchschnitt für eine Ausführung eines Knotens angegeben, und davon kann es Hunderte geben. - Nun, und all das zusammen erschwert es, die Hauptfrage zu beantworten – wer ist also derjenige? "Das schwächste Glied"?
Als wir versuchten, all dies einer mehreren Hundert unserer Entwickler zu erklären, merkten wir, dass es von außen ungefähr so aussieht:
Also, brauchen wir…
Tool
In ihm haben wir versucht, alle Schlüsselmechanismen zusammenzustellen, die helfen, gemäß dem Plan und der Anfrage zu verstehen, "wer schuld ist und was zu tun ist". Nun, und einen Teil unserer Erfahrungen mit der Gemeinschaft zu teilen.
Willkommen und nutzen Sie es —
Anschaulichkeit der Pläne
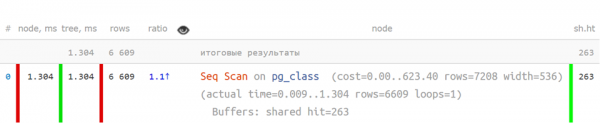
Ist es leicht, den Plan zu verstehen, wenn er so aussieht?
Seq Scan on pg_class (tatsächliche Zeit=0.009..1.304 Zeilen=6609 Schleifen=1)
  Buffers: shared hit=263
Planungszeit: 0.108 ms
Ausführungszeit: 1.800 ms
Nicht wirklich.
Aber so, in verkürzter Form, wenn die Schlüsselindikatoren getrennt sind – ist es bereits viel verständlicher:
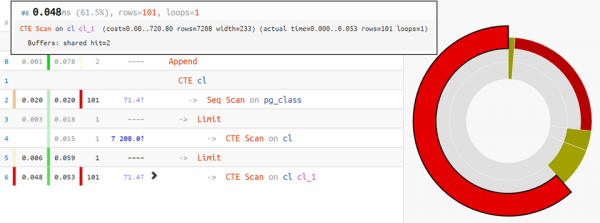
Aber wenn der Plan komplizierter ist – hilft uns das Tortendiagramm der Zeitverteilung nach Knoten:
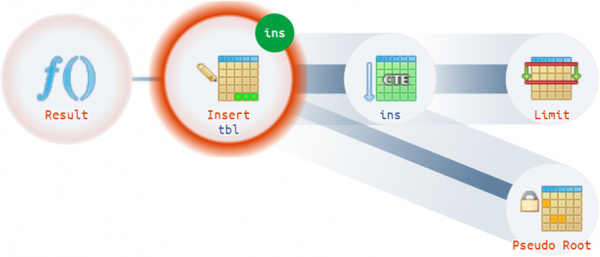
Nun, und für die kompliziertesten Varianten eilt zur Hilfe das Ausführungsdiagramm:
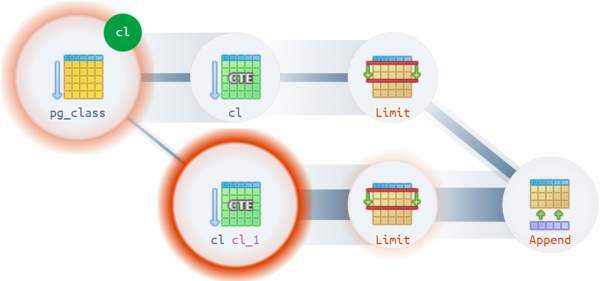
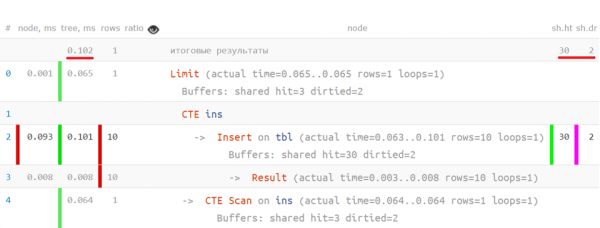
Zum Beispiel gibt es durchaus nicht triviale Situationen, in denen ein Plan mehr als einen tatsächlichen Wurzelknoten haben kann:
Strukturelle Hinweise
Nun, und wenn die gesamte Struktur des Plans und seine Schwachstellen bereits offen gelegt und sichtbar sind – warum nicht dem Entwickler hervorheben und in "normaler Sprache" erklären?
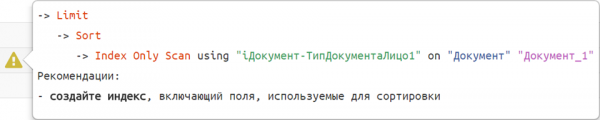 Solche Empfehlungsvorlagen haben wir bereits ein paar Dutzend gesammelt.
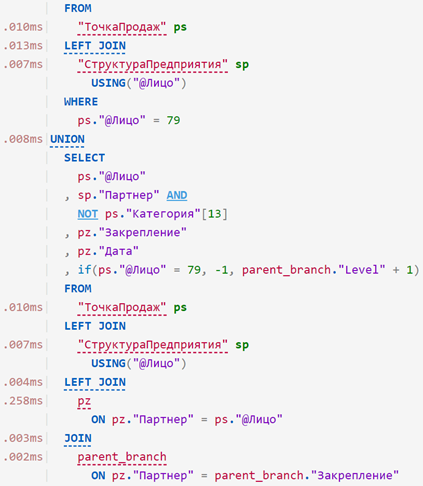
Zeilenweiser Profiling des Antrags
Jetzt, wenn wir den analysierten Plan mit dem ursprünglichen Antrag überlagern, können wir sehen, wie viel Zeit für jeden einzelnen Operator aufgewendet wurde – ungefähr so:
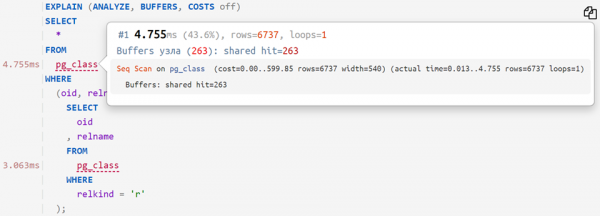
… oder sogar so:
Parameterersetzung im Antrag
Wenn Sie den Antrag nicht nur mit dem Plan, sondern auch mit seinen Parametern aus der DETAIL-Zeile des Protokolls verknüpft haben, können Sie ihn zusätzlich in einer der Varianten kopieren:
- mit Ersetzung der Werte im Antrag
für die direkte Ausführung in Ihrer Datenbank und anschließendes ProfilingSELECT 'const', 'param'::text; - mit Ersetzung der Werte über PREPARE/EXECUTE
zum Emulieren der Planerarbeit, wenn die parametrische Komponente ignoriert werden kann – zum Beispiel bei der Arbeit mit partitionierten TabellenDEALLOCATE ALL; PREPARE q(text) AS SELECT 'const', $1::text; EXECUTE q('param'::text);
Archiv der Pläne
Fügen Sie ein, analysieren Sie und teilen Sie mit Ihren Kollegen! Die Pläne bleiben im Archiv, und Sie können später darauf zurückkommen:
Wenn Sie jedoch nicht möchten, dass andere Ihren Plan sehen, vergessen Sie nicht, das Kästchen „nicht im Archiv veröffentlichen“ anzukreuzen.
In den nächsten Artikeln werde ich über die Schwierigkeiten und Lösungen sprechen, die beim Analysieren von Plänen auftreten.
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish