

Ein weiterer Benutzer möchte einen neuen Datenblock auf der Festplatte speichern, hat aber nicht genug freien Speicherplatz dafür. Auch löschen möchte er nichts, da "alles sehr wichtig und notwendig" ist. Was sollen wir also damit tun?
Ein solches Problem hat nicht nur er. Auf unseren Festplatten lagern Terabytes an Informationen, und diese Menge neigt nicht dazu, sich zu verringern. Aber wie einzigartig ist sie wirklich? Letztendlich sind alle Dateien nur Bitmuster bestimmter Länge, und wahrscheinlich unterscheidet sich das neue nicht groß von dem, was bereits gespeichert ist.
Es ist offensichtlich, dass es eine ineffiziente Aufgabe ist, bereits gespeicherte Informationsblöcke auf der Festplatte zu suchen. Auf der anderen Seite, wenn der Unterschied nur gering ist, könnte man vielleicht etwas anpassen...
TL;DR — ein zweiter Versuch, über eine seltsame Methode zur Optimierung von Daten mittels JPEG-Dateien zu berichten, diesmal in verständlicherer Form.
Über Bits und Unterschiede
Wenn man zwei völlig zufällige Datenblöcke betrachtet, stimmen im Durchschnitt die Hälfte der enthaltenen Bits überein. Tatsächlich haben in den möglichen Kombinationen für jedes Paar (’00, 01, 10, 11′) genau die Hälfte übereinstimmende Werte, das ist ganz einfach.
Aber natürlich, wenn wir einfach zwei Dateien nehmen und eine an die andere anpassen, verlieren wir eine von ihnen. Wenn wir jedoch die Änderungen speichern, erfinden wir einfach erneut , die bereits ohne unser Zutun hervorragend existiert, auch wenn sie normalerweise nicht zu den gleichen Zwecken verwendet wird. Man könnte versuchen, eine kleinere Sequenz in eine größere einzubauen, aber selbst dann riskieren wir den Verlust kritischer Datensegmente bei unüberlegtem Einsatz mit allem Möglichen.
Worin können wir dann die Unterschiede eliminieren? Das heißt, die von dem Benutzer gespeicherte neue Datei ist einfach eine Bitfolge, mit der wir selbst nichts anfangen können. Daher müssen wir einfach auf der Festplatte solche Bits finden, die sich ändern lassen, ohne die Unterschiede speichern zu müssen, sodass wir den Verlust ohne gravierende Folgen überstehen können. Und es lohnt sich nicht nur, die Datei im Dateisystem zu ändern, sondern auch einige weniger sensible Informationen darin. Aber welche und wie?
Anpassungsmethoden
Es helfen Dateien, die mit Verlusten komprimiert sind. All diese jpeg, mp3 und andere sind zwar verlustbehaftete Kompressionen, enthalten jedoch eine Menge Bits, die sicher verändert werden können. Man kann fortschrittliche Techniken verwenden, die ihre Bestandteile unauffällig an verschiedenen Stellen der Codierung modifizieren. Warte mal. Fortgeschrittene Techniken… unauffällige Modifikation… einige Bits in andere… das ist ja fast wie !
Und tatsächlich erinnert das Einbetten einer Information in eine andere an ihre Methoden. Auch die Unauffälligkeit der vorgenommenen Änderungen für die menschlichen Sinne imponiert. Hier scheiden sich die Wege – denn es geht um die Geheimhaltung: Unsere Aufgabe besteht darin, dass der Benutzer zusätzliche Informationen auf seine Festplatte einfügt, was ihm nur schaden wird. Er wird es vergessen.
Deshalb, auch wenn wir sie nutzen können, müssen einige Modifikationen vorgenommen werden. Und ich werde dies im Folgenden anhand eines der existierenden Methoden und eines verbreiteten Dateiformats erläutern und demonstrieren.
Über Schakale
Wenn schon komprimieren, dann das am meisten komprimierbare der Welt. Es geht hier natürlich um JPEG-Dateien. Es gibt nicht nur tonnenweise Werkzeuge und bestehende Methoden, um Daten darin einzubetten, sondern es ist auch das beliebteste Grafikformat auf diesem Planeten.
Dennoch, um nicht dem Hundesport nachzugehen, müssen wir unser Tätigkeitsfeld auf Dateien dieses Formats einschränken. Niemand mag eintönige quadratische Formate, die durch übermäßige Kompression entstehen, deshalb sollten wir uns auf die Arbeit mit bereits komprimierten Dateien beschränken, um eine Neucodierung zu vermeiden. Genauer gesagt mit ganzzahligen Koeffizienten, die nach den Vorgängen erhalten bleiben, die für den Datenverlust verantwortlich sind – DCT und Quantisierung, was hervorragend im Codierungsschema dargestellt ist (danke an die Wiki der Nationalbibliothek von Bauman):
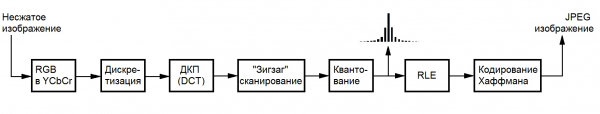
Es gibt viele mögliche Methoden zur Optimierung von JPEG-Dateien. Es gibt verlustfreie Optimierung (jpegtran), es gibt die Optimierung „“, die in der Tat noch einige einfügen, aber das interessiert uns nicht. Denn wenn der Benutzer bereit ist, eine Information in eine andere einzufügen, um den freien Speicherplatz auf der Festplatte zu vergrößern, hat er entweder seine Bilder längst optimiert oder möchte dies aus Angst vor Qualitätsverlust überhaupt nicht tun.
F5
Unter solche Bedingungen fällt eine ganze Familie von Algorithmen, mit denen man sich vertraut machen kann. . Der fortschrittlichste von ihnen ist der Algorithmus von Andreas Westfeld, der mit den Koeffizienten der Helligkeitskomponente arbeitet, da das menschliche Auge am wenigsten empfindlich auf deren Änderungen reagiert. Darüber hinaus verwendet er eine Einbettungsmethode, die auf der Codierung von Matrizen basiert, wodurch es möglich ist, umso weniger Änderungen bei der Einbettung derselben Informationsmenge vorzunehmen, je größer die Größe des verwendeten Containers ist.
Die Änderungen selbst bestehen darin, dass der absolute Wert der Koeffizienten unter bestimmten Bedingungen (also nicht immer) um eins verringert wird, was es ermöglicht, F5 zur Optimierung der Datenspeicherung auf der Festplatte zu verwenden. Der Grund dafür ist, dass der Koeffizient nach einer solchen Änderung wahrscheinlich weniger Bits nach der Huffman-Codierung belegen wird, aufgrund der statistischen Verteilung der Werte in JPEG, und die neuen Nullen bringen Vorteile bei der Codierung mit RLE.
Notwendige Modifikationen bestehen darin, den Teil, der für die Geheimhaltung (passwortbasierte Permutation) verantwortlich ist, zu beseitigen, um Ressourcen und Ausführungszeit zu sparen, und einen Mechanismus hinzuzufügen, der mit mehreren Dateien anstelle von einer einzigen auf einmal arbeitet. Der Prozess der Veränderung wird für den Leser wohl kaum von Interesse sein, deshalb kommen wir zur Beschreibung der Implementierung.
Hohe Technologie
Zur Demonstration dieses Ansatzes habe ich eine Methode in reinem C implementiert und eine Reihe von Optimierungen sowohl hinsichtlich der Ausführungsgeschwindigkeit als auch des Speicherverbrauchs vorgenommen (Sie können sich nicht vorstellen, wie viel diese Bilder ohne Kompression sogar bis DCT wiegen). Die Plattformunabhängigkeit wurde durch die Verwendung einer Kombination von Bibliotheken erreicht , und , dafür danke ich ihnen. Alles wird mit 'make' zusammengestellt, daher sollten Windows-Nutzer sich Cygwin installieren oder sich eigenständig mit Visual Studio und den Bibliotheken auseinandersetzen.
Die Implementierung ist in Form eines Konsolenwerkzeugs und einer Bibliothek verfügbar. Weitere Informationen zur Nutzung letzterer können Interessierte in der README im Repository auf GitHub finden, auf das ich am Ende des Beitrags verlinken werde.
Wie verwendet man das?
Vorsicht. Die für die Verpackung verwendeten Bilder werden durch eine Suche mit regulären Ausdrücken im angegebenen Stammverzeichnis ausgewählt. Nach Abschluss können die Dateien nach Belieben innerhalb dieses Verzeichnisses verschoben, umbenannt und kopiert werden, sowie die Dateisysteme und Betriebssysteme gewechselt werden usw. Es ist jedoch wichtig, extrem vorsichtig zu sein und den Inhalt nicht zu verändern. Der Verlust eines einzigen Bits kann dazu führen, dass Informationen nicht mehr wiederhergestellt werden können.
Nach Abschluss der Arbeit hinterlässt das Tool eine spezielle Archivdatei, die alle benötigten Informationen für die Dekompression enthält, einschließlich der Daten über die verwendeten Bilder. Diese Datei hat selbst nur ein Gewicht von etwa ein paar Kilobyte und hat keinen nennenswerten Einfluss auf den Speicherplatz.
Man kann die mögliche Kapazität mit dem Flaggen ‘-a’ analysieren: ‘./f5ar -a [Suchordner] [Perl-kompatibler regulärer Ausdruck]’. Die Archivierung erfolgt mit dem Befehl ‘./f5ar -p [Suchordner] [Perl-kompatibler regulärer Ausdruck] [zu archivierende Datei] [Archivname]’, während die Dekompression mit ‘./f5ar -u [Archivdatei] [Name der wiederhergestellten Datei]’ stattfindet.
Demonstration der Arbeit
Um die Effektivität der Methode zu zeigen, habe ich eine Sammlung von 225 absolut kostenlosen Fotos von Hunden von dem Dienst hochgeladen und fand in den Dokumenten ein großes PDF-Dokument von 45 Metern des zweiten Bandes von Knuth.
Die Abfolge ist ziemlich einfach:
$ du -sh knuth.pdf dogs/
44M knuth.pdf
633M dogs/

$ ./f5ar -p dogs/ .*jpg knuth.pdf dogs.f5ar
Lese komprimierende Datei... ok
Initialisiere das Archiv... ok
Analysiere Bibliothekskapazität... erledigt in 17.0s
Erkannte garantierte Kapazität von 48439359 Bytes
Erkannte mögliche Kapazität von bis zu 102618787 Bytes
Komprimierung... erledigt in 39.4s
Speichern des Archivs... ok

$ ./f5ar -u dogs/dogs.f5ar knuth_unpacked.pdf
Initialisiere das Archiv... ok
Lese die Archivdatei... ok
Fülle das Archiv mit Dateien... erledigt in 1.4s
Dekomprimieren... erledigt in 21.0s
Schreibe extrahierte Daten... ok

$ sha1sum knuth.pdf knuth_unpacked.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth_unpacked.pdf

$ du -sh dogs/
551M dogs/
Screenshots für Liebhaber
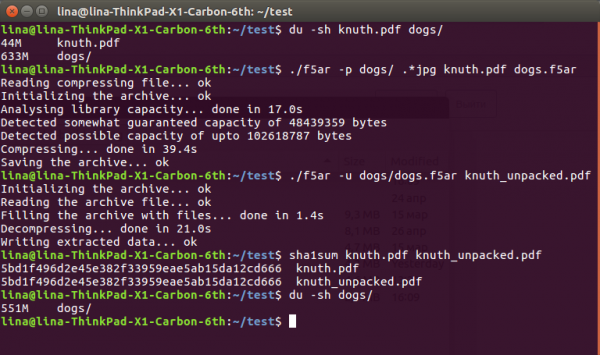
Die entpackte Datei kann und sollte weiterhin gelesen werden:
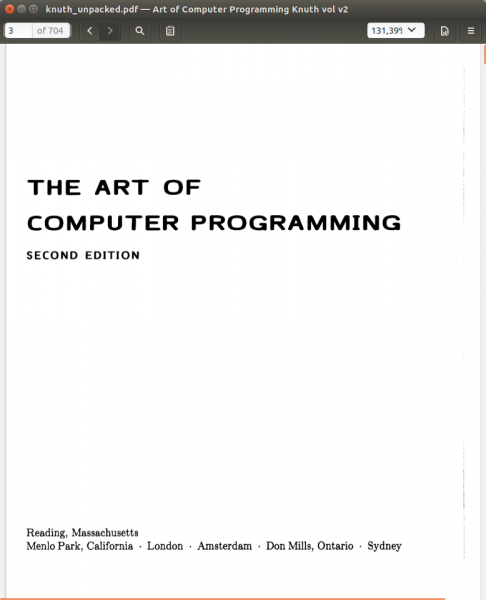
Wie zu sehen ist, haben wir von den ursprünglichen 633 + 36 == 669 Megabyte Daten auf der Festplatte zu angenehmeren 551 gewechselt. Dieser radikale Unterschied erklärt sich durch die Verringerung der Koeffizientenwerte, die sich auf die anschließende verlustfreie Kompression auswirken: Eine Verringerung um nur einen Punkt kann bereits ein paar Byte der Datei reduzieren. Dennoch sind das immer noch Datenverluste, wenn auch sehr geringe, mit denen man sich arrangieren muss.
Glücklicherweise sind sie für das Auge absolut nicht sichtbar. Im Spoiler (da habrastorage keine großen Dateien unterstützt) kann der Leser den Unterschied sowohl visuell als auch in ihrer Intensität bewerten, die sich aus der Subtraktion der Werte der modifizierten Komponente vom Original ergibt: , , (je blasser die Farbe, desto geringer der Unterschied im Block).
Zum Abschluss
Angesichts all dieser Schwierigkeiten kann es viel einfacher erscheinen, eine Festplatte zu kaufen oder alles in die Cloud hochzuladen. Aber obwohl wir jetzt in einer so wunderbaren Zeit leben, gibt es keine Garantie, dass man morgen noch ins Internet gehen und all seine zusätzlichen Daten irgendwo hochladen kann. Oder in den Laden gehen und sich eine weitere Festplatte mit tausend Terabyte kaufen kann. Aber die bereits zu Hause vorhandenen kann man immer nutzen.
->
Quelle: habr.com
