

Aloha, Leute! Ich heiße Oleg Anastasyev, ich arbeite in Odnoklassniki im Plattform-Team. Neben mir gibt es in Odnoklassniki eine Menge Hardware. Wir haben vier Rechenzentren mit etwa 500 Racks und mehr als 8.000 Servern. Irgendwann haben wir verstanden, dass die Einführung eines neuen Verwaltungssystems es uns ermöglichen wird, die Technik effizienter zu betreiben, die Verwaltung von Zugängen zu erleichtern, die (Neu)Verteilung von Rechenressourcen zu automatisieren, die Einführung neuer Dienste zu beschleunigen und schneller auf großangelegte Ausfälle zu reagieren.
Was ist daraus geworden?
Neben mir und der Menge an Hardware gibt es auch Menschen, die mit dieser Hardware arbeiten: Ingenieure, die direkt in den Rechenzentren sind; Netzwerktechniker, die die Netzwerkinfrastruktur einrichten; Administratoren oder SRE, die die Ausfallsicherheit der Infrastruktur gewährleisten; und Entwicklerteams, von denen jedes für einen Teil der Funktionen des Portals verantwortlich ist. Die von ihnen entwickelte Software funktioniert ungefähr so:
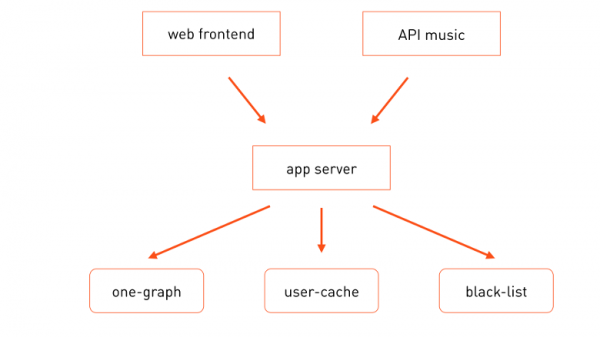
Benutzeranfragen kommen sowohl an die Fronten des Hauptportals , als auch an andere, zum Beispiel an die Fronten der Musik-API. Diese rufen zur Verarbeitung der Geschäftslogik den Anwendungsserver auf, der bei der Bearbeitung der Anfrage die notwendigen spezialisierten Mikrodienste aufruft – one-graph (Graf sozialer Netzwerke), user-cache (Cache von Benutzerprofilen) usw.
Jeder dieser Dienste ist auf zahlreichen Maschinen bereitgestellt, und jeder von ihnen hat verantwortliche Entwickler, die für das Funktionieren der Module, deren Betrieb und technologische Entwicklung zuständig sind. All diese Dienste werden auf physischen Servern gestartet, und bis vor kurzem haben wir genau eine Aufgabe pro Server gestartet, d.h. er war für eine bestimmte Aufgabe spezialisiert.
Warum ist das so? Dieser Ansatz hatte mehrere Vorteile:
- Es erleichtert die Massenverwaltung. Angenommen, eine Aufgabe erfordert bestimmte Bibliotheken oder Konfigurationen. Dann wird der Server genau einer bestimmten Gruppe zugewiesen, eine Policy für diese Gruppe wird beschrieben (oder sie ist bereits beschrieben) und diese Konfiguration wird zentral und automatisiert auf alle Server dieser Gruppe verteilt.
- Es vereinfacht die Diagnostik. Angenommen, Sie beobachten eine erhöhte Auslastung der CPU und erkennen, dass diese nur von dem Prozess verursacht worden sein kann, der auf dieser Hardware läuft. Die Suche nach dem Schuldigen endet sehr schnell.
- Es vereinfacht Überwachung. Wenn mit dem Server etwas nicht stimmt, informiert der Monitor darüber, und Sie wissen genau, wer schuld ist.
Ein Dienst, der aus mehreren Replikaten besteht, erhält mehreren Server zugewiesen — je einen für jede. Dann wird die Rechenressource für den Dienst sehr einfach zugewiesen: so viele Server der Dienst hat, so viel Ressourcen kann er maximal verbrauchen. "Einfach" bedeutet hier nicht, dass es leicht zu verwenden ist, sondern dass die Zuteilung der Ressourcen manuell erfolgt.
Ein solcher Ansatz erlaubte es uns auch, spezialisierte Hardwarekonfigurationen für Aufgaben zu erstellen, die auf diesem Server ausgeführt werden. Wenn die Aufgabe große Datenmengen speichert, verwenden wir einen 4U-Server mit einem Chassis für 38 Festplatten. Wenn die Aufgabe rein rechenintensiv ist, können wir einen günstigeren 1U-Server kaufen. Das ist aus Sicht der Rechenressourcen effizient. Zudem ermöglicht uns dieser Ansatz, viermal weniger Maschinen bei einer Auslastung zu verwenden, die mit einem uns freundlichen sozialen Netzwerk vergleichbar ist.
Eine solche Effizienz der Nutzung der Rechenressourcen sollte auch wirtschaftliche Effizienz gewährleisten, wenn man davon ausgeht, dass das teuerste die Server sind. Lange Zeit war die Hardware am teuersten, und wir haben viel Aufwand betrieben, um die Kosten der Hardware zu senken, indem wir Algorithmen zur Gewährleistung der Ausfallsicherheit entwickelten, um die Anforderungen an die Zuverlässigkeit der Ausstattung zu reduzieren. Und heute sind wir an einem Punkt angelangt, an dem der Preis des Servers nicht mehr entscheidend ist. Wenn man nicht die neueste Exotik betrachtet, hat die konkrete Konfiguration der Server im Rack keine Bedeutung. Jetzt sind wir mit einem anderen Problem konfrontiert — den Kosten für den Platz, den der Server im Rechenzentrum einnimmt, d.h. den Platz im Rack.
Sich darüber im Klaren zu werden, haben wir beschlossen zu berechnen, wie effizient wir die Racks nutzen.
Wir haben den Preis des leistungsstärksten Servers aus wirtschaftlicher Sicht ermittelt, berechnet, wie viele solcher Server wir in unsere Racks stellen können, wie viele Aufgaben wir basierend auf dem alten Modell "ein Server = eine Aufgabe" darauf ausführen könnten und inwieweit diese Aufgaben die Hardware auslasten würden. Wir haben das berechnet und waren erschüttert. Es stellte sich heraus, dass die Effizienz der Rack-Nutzung bei uns bei etwa 11 % liegt. Die Schlussfolgerung ist offensichtlich: Wir müssen die Effizienz der Nutzung von Rechenzentren steigern. Die Lösung scheint einfach: Auf einem Server mehrere Aufgaben gleichzeitig ausführen. Doch hier beginnen die Schwierigkeiten.
Die Massenkonfiguration wird erheblich komplexer - jetzt ist es unmöglich, einem Server eine bestimmte Gruppe zuzuweisen. Denn jetzt können auf einem Server mehrere Aufgaben verschiedener Teams ausgeführt werden. Darüber hinaus kann die Konfiguration für verschiedene Anwendungen konfliktreich sein. Auch die Diagnose wird komplizierter: Wenn Sie einen erhöhten Prozessor- oder Festplattenverbrauch auf einem Server sehen, wissen Sie nicht, welches der Aufgaben Probleme verursacht.
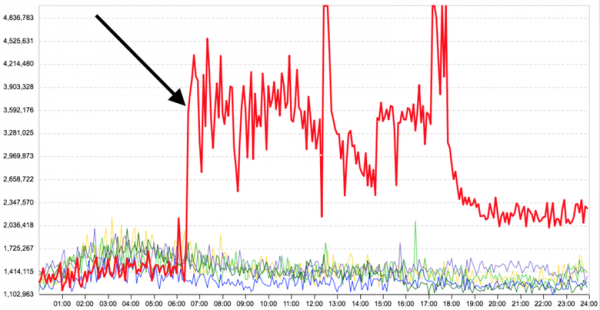
Das Wichtigste ist jedoch, dass es keine Isolation zwischen den Aufgaben gibt, die auf demselben Rechner ausgeführt werden. Beispielsweise zeigt das Diagramm der durchschnittlichen Antwortzeiten einer Serveranwendung vor und nachdem auf demselben Server eine zusätzliche, nicht mit der ersten verbundene Anwendung gestartet wurde - die Antwortzeit der Hauptaufgabe hat sich erheblich erhöht.
Offensichtlich müssen Aufgaben entweder in Containern oder in virtuellen Maschinen ausgeführt werden. Da praktisch alle unsere Aufgaben unter einer einzigen OS (Linux) laufen oder entsprechend angepasst sind, ist es nicht erforderlich, viele verschiedene Betriebssysteme zu unterstützen. Entsprechend ist Virtualisierung nicht notwendig, da sie aufgrund der zusätzlichen Betriebskosten weniger effizient ist als Containerisierung.
Als Umsetzung von Containern zur Ausführung von Aufgaben direkt auf Docker-Servern ist das eine gute Option: Die Images von Dateisystemen lösen die Probleme mit konfliktierenden Konfigurationen gut. Die Möglichkeit, dass Images aus mehreren Schichten bestehen, ermöglicht es uns, das benötigte Datenvolumen für ihre Bereitstellung in der Infrastruktur erheblich zu reduzieren, indem wir gemeinsame Teile in separate Basisschichten auslagern. Damit werden die Basisschichten (und die größten) recht schnell in der gesamten Infrastruktur zwischengespeichert, und für die Bereitstellung verschiedener Anwendungstypen und Versionen müssen nur noch kleine Schichten übertragen werden.
Zudem bieten das bereitgestellte Registry und die Tagging-Funktion von Docker uns fertige Primitiven für Versionierung und Code-Bereitstellung in der Produktion.
Docker stellt, wie jede andere ähnliche Technologie, von Haus aus ein gewisses Maß an Isolation der Container bereit. Zum Beispiel wird jedem Container ein Limit für die Nutzung des Arbeitsspeichers der Maschine zugewiesen, das er nicht überschreiten kann. Außerdem können die Container hinsichtlich der CPU-Nutzung isoliert werden. Für uns war die Standardisolation jedoch nicht ausreichend. Aber dazu mehr weiter unten.
Die direkte Ausführung von Containern auf Servern ist nur ein Teil der Probleme. Ein anderer Teil betrifft die Platzierung der Container auf den Servern. Man muss verstehen, welcher Container auf welchen Server gesetzt werden kann. Diese Aufgabe ist nicht so einfach, da die Container möglichst eng auf den Servern platziert werden müssen, ohne die Geschwindigkeit ihrer Ausführung zu verringern. Eine solche Platzierung kann auch hinsichtlich der Ausfallsicherheit kompliziert sein. Oft möchten wir die Replikate desselben Dienstes in verschiedenen Racks oder sogar in verschiedenen Hallen des Rechenzentrums platzieren, damit wir bei einem Ausfall eines Racks oder einer Halle nicht alle Replikate des Dienstes gleichzeitig verlieren.
Container manuell zu verteilen, ist keine Option, wenn man 8000 Server und 8000 bis 16000 Container hat.
Zudem wollten wir den Entwicklern mehr Autonomie bei der Ressourcenzuteilung geben, sodass sie ihre Dienste selbstständig in der Produktion bereitstellen können, ohne Hilfe eines Administrators. Dabei wollten wir die Kontrolle behalten, damit ein weniger wichtiger Dienst nicht alle Ressourcen unserer Rechenzentren verbraucht.
Offensichtlich ist eine Verwaltungs-Ebene erforderlich, die dies automatisch übernimmt.
Hier sind wir bei einem einfachen und verständlichen Bild angekommen, das alle Architekten lieben: drei Kästchen.
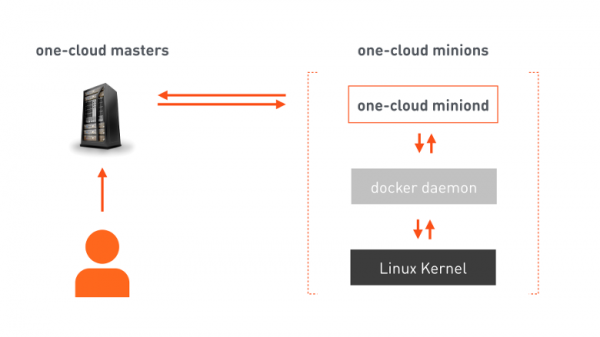
one-cloud Masters – ein ausfallsicherer Cluster, der für die Orchestrierung der Cloud verantwortlich ist. Der Entwickler sendet ein Manifest an den Master, das alle notwendigen Informationen zur Bereitstellung des Dienstes enthält. Der Master gibt auf dieser Grundlage Anweisungen an die ausgewählten Minions (Maschinen, die zum Starten von Containern vorgesehen sind). Auf den Minions befindet sich unser Agent, der den Befehl erhält, bereits seine Befehle an Docker übergibt, und Docker konfiguriert den Linux-Kernel zum Start des entsprechenden Containers. Neben der Ausführung von Befehlen berichtet der Agent kontinuierlich an den Master über Statusänderungen sowohl des Minion-Geräts als auch der darauf gestarteten Container.
Ressourcenzuteilung
Jetzt lassen Sie uns die komplexere Aufgabe der Ressourcenzuteilung für mehrere Minions betrachten.
Rechenressource in one-cloud – das ist:
- Die Rechenleistung des Prozessors, die von einer bestimmten Aufgabe benötigt wird.
- Der verfügbare Speicher für die Aufgabe.
- Netzwerkverkehr. Jeder der Minions hat ein spezifisches Netzwerkinterface mit begrenzter Bandbreite, daher können Aufgaben nicht ohne Berücksichtigung des übertragenden Datenvolumens im Netzwerk verteilt werden.
- Festplatten. Neben dem offensichtlichen Platz für die Daten der Aufgabe weisen wir auch den Festplattentyp zu: HDD oder SSD. Festplatten können eine bestimmte Anzahl von Anfragen pro Sekunde bedienen – IOPS. Daher weisen wir für Aufgaben, die mehr IOPS generieren als eine einzelne Festplatte bedienen kann, auch "Spindeln" zu – d. h. Speichereinheiten, die ausschließlich für die Aufgabe reserviert werden müssen.
Für einen bestimmten Dienst, beispielsweise user-cache, können wir die benötigten Ressourcen auf folgende Weise festhalten: 400 CPU-Kerne, 2,5 TB Speicher, 50 Gbit/s Netzwerkverkehr in beide Richtungen, 6 TB Speicher auf HDD, verteilt auf 100 Spindeln. Oder in einer für uns vertrauteren Form so:
alloc:
    cpu: 400
    mem: 2500
    lan_in: 50g
    lan_out: 50g
    hdd:100x6T
Die Ressourcen des Dienstes user-cache verbrauchen nur einen Teil aller verfügbaren Ressourcen in der Produktionsinfrastruktur. Daher möchten wir sicherstellen, dass user-cache nicht mehr Ressourcen verbraucht, als ihm zugewiesen wurden, egal ob durch einen Operatorfehler oder nicht. Das heißt, wir müssen die Ressourcen limitieren. Aber woran könnten wir das Kontingent festmachen?
Lassen Sie uns zu unserem stark vereinfachten Schema der Interaktion von Komponenten zurückkehren und es mit mehr Details neu zeichnen – so:
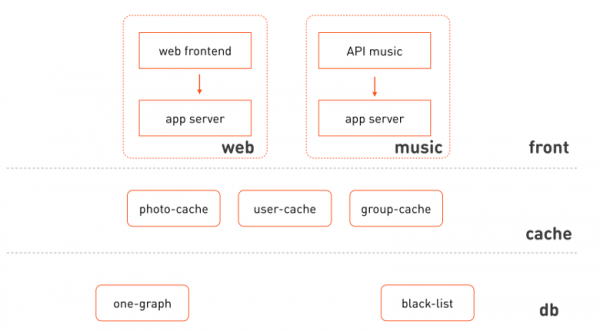
Was ins Auge fällt:
- Web-Frontend und Musik verwenden isolierte Cluster desselben Anwendungsservers.
- Es lassen sich logische Schichten unterscheiden, zu denen diese Cluster gehören: Frontends, Caches, Speicher- und Datenverwaltungsschicht.
- Das Frontend ist heterogen, es besteht aus verschiedenen funktionalen Teilsystemen.
- Caches können ebenfalls nach dem Teilsystem verteilt werden, dessen Daten sie cachen.
Lassen Sie uns das Bild noch einmal neu zeichnen:
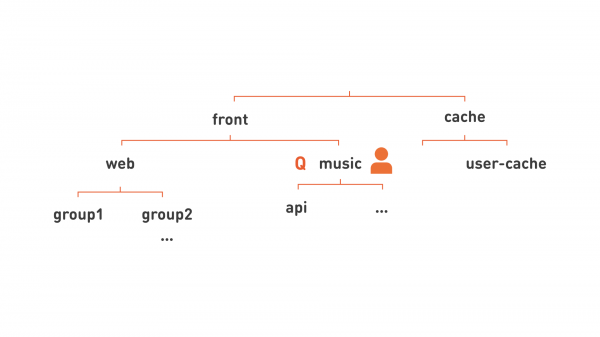
Oh! Wir sehen eine Hierarchie! Das bedeutet, dass wir Ressourcen in größeren Einheiten verteilen können: einen verantwortlichen Entwickler für einen Knoten dieser Hierarchie zuweisen, der zur funktionalen Teilsystem (wie „music“ im Bild) gehört, und zu demselben Hierarchielevel ein Kontingent binden. Eine solche Hierarchie ermöglicht es uns auch, die Dienste flexibler zur besseren Verwaltung zu organisieren. Zum Beispiel teilen wir alle Webdienste, da dies eine sehr große Gruppierung von Servern ist, in mehrere kleinere Gruppen auf, die im Bild als group1, group2 angezeigt werden.
Indem wir überflüssige Linien entfernen, können wir jeden Knoten unseres Bildes in einer flacheren Form notieren: group1.web.front, api.music.front, user-cache.cache.
So kommen wir zum Konzept der „hierarchischen Warteschlange“. Diese hat einen Namen wie „group1.web.front“. Ihr wird ein Kontingent für Ressourcen und Nutzerrechte zugewiesen. Eine Person aus DevOps erhält das Recht, einen Dienst in die Warteschlange zu senden, und dieser Mitarbeiter kann etwas in der Warteschlange starten, während jemand aus OpsDev – administrative Rechte erhält und jetzt die Warteschlange verwalten kann, Personen zuweisen, diesen Personen Rechte geben usw. Dienste, die in dieser Warteschlange gestartet werden, werden im Rahmen des Kontingents der Warteschlange ausgeführt. Wenn das Rechenkontingent der Warteschlange nicht ausreicht, um alle Dienste gleichzeitig auszuführen, werden sie nacheinander ausgeführt und bilden somit die Warteschlange.
Lassen Sie uns die Dienste genauer betrachten. Ein Dienst hat einen vollständigen Namen, der immer den Namen der Warteschlange enthält. Der Dienst des Web-Frontends wird dann den Namen haben ok-web.group1.web.front. Der Dienst des Anwendungsservers, auf den er zugreift, wird den Namen erhalten ok-app.group1.web.front. Jeder Dienst hat ein Manifest, in dem alle erforderlichen Informationen für die Bereitstellung auf bestimmten Maschinen angegeben sind: Wie viele Ressourcen diese Aufgabe benötigt, welche Konfiguration dafür erforderlich ist, wie viele Repliken vorhanden sein müssen, Eigenschaften zur Fehlerbehandlung dieses Dienstes. Nach der Bereitstellung des Dienstes auf den Maschinen erscheinen seine Instanzen. Diese werden ebenfalls eindeutig benannt - mit der Instanznummer und dem Namen des Dienstes: 1.ok-web.group1.web.front, 2.ok-web.group1.web.front, …
Das ist sehr praktisch: Wenn wir nur den Namen des laufenden Containers betrachten, können wir sofort viel herausfinden.
Lassen Sie uns nun näher kennenlernen, was diese Instanzen eigentlich tun: die Aufgaben.
Isolationsklassen von Aufgaben
Alle Aufgaben in OK (und wahrscheinlich überall) können in Gruppen eingeteilt werden:
- Aufgaben mit kurzer Latenz - prod. Für solche Aufgaben und Dienste ist die Antwortlatenz (latency) sehr wichtig, wie schnell jede Anfrage vom System verarbeitet wird. Beispiele für Aufgaben sind: Web-Frontends, Caches, Anwendungsserver, OLTP-Speicher usw.
- Berechnung Aufgaben - batch. Hier ist die Geschwindigkeit der Verarbeitung jeder einzelnen Anfrage unwichtig. Für sie ist wichtig, wie viele Berechnungen insgesamt in einem bestimmten (großen) Zeitraum diese Aufgabe durchführt (throughput). Dazu gehören alle Aufgaben in MapReduce, Hadoop, maschinelles Lernen, Statistik.
- Hintergrundaufgaben - idle. Für solche Aufgaben sind weder Latenz noch Durchsatz besonders wichtig. Dazu gehören verschiedene Tests, Migrationen, Neuberechnungen, Datenkonvertierungen von einem Format in ein anderes. Einerseits ähneln sie den Berechnungsaufgaben, andererseits ist es uns nicht so wichtig, wie schnell sie abgeschlossen werden.
Schauen wir uns an, wie solche Aufgaben Ressourcen, zum Beispiel die CPU, verbrauchen.
Aufgaben mit kurzer Latenz. Ein solches Aufgabemuster wird folgendermaßen aussehen:
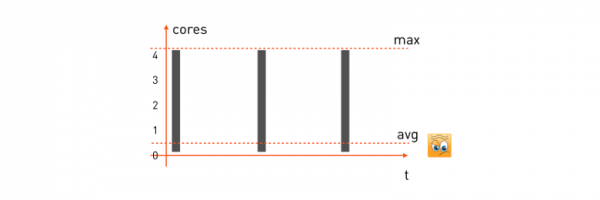
Eine Anfrage vom Benutzer wird bearbeitet, die Aufgabe nutzt alle verfügbaren CPU-Kerne, verarbeitet die Anfrage, gibt eine Antwort zurück, wartet auf die nächste Anfrage und bleibt stehen. Eine neue Anfrage kommt - wieder wird alles gewählt, was verfügbar ist, berechnet und wir warten auf die nächste.
Um eine minimale Latenz für eine solche Aufgabe zu garantieren, müssen wir die maximal verbrauchten Ressourcen reservieren und die erforderliche Anzahl von Kernen auf dem Minion (der Maschine, die die Aufgabe ausführt) reservieren. Dann ergibt sich die Reservierungsformel für unsere Aufgabe wie folgt:
alloc: cpu = 4 (max)Und wenn wir einen Minion-Server mit 16 Kernen haben, können darauf genau vier solcher Aufgaben platziert werden. Besonders hervorzuheben ist, dass der durchschnittliche CPU-Verbrauch dieser Aufgaben oft sehr niedrig ist — was offensichtlich ist, da ein erheblicher Teil der Zeit die Aufgabe auf eine Anfrage wartet und nichts tut.
Berechnungsaufgaben. Ihr Muster wird etwas anders sein:
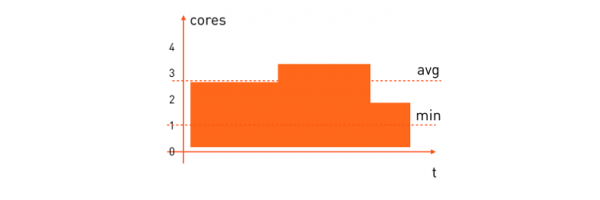
Der durchschnittliche Ressourcenverbrauch der CPU bei solchen Aufgaben ist ziemlich hoch. Oft möchten wir, dass die Berechnungsaufgabe innerhalb einer bestimmten Zeit ausgeführt wird, daher müssen wir die minimale Anzahl an Prozessoren reservieren, die sie benötigt, damit die gesamte Berechnung in einer akzeptablen Zeit abgeschlossen werden kann. Ihre Reservierungsformel wird so aussehen:
alloc: cpu = [1,*)„Bitte platziere es auf dem Minion, wo es mindestens einen freien Kern gibt, und alles Weitere wird genutzt.“
Hier ist die Effizienz der Nutzung bereits weitaus besser als bei Aufgaben mit kurzer Verzögerung. Doch der Gewinn wird viel größer, wenn man beide Aufgabentypen auf demselben Minion-Server kombiniert und dessen Ressourcen dynamisch verteilt. Wenn die Aufgabe mit kurzer Verzögerung CPU benötigt, erhält sie sie sofort, und wenn die Ressourcen nicht mehr benötigt werden, werden sie der Berechnungsaufgabe zugeteilt, d. h. so:
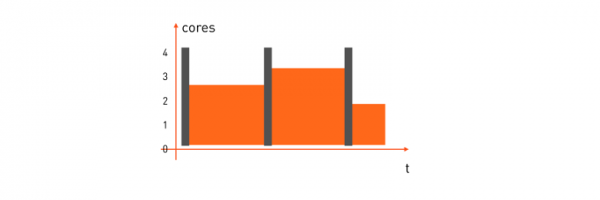
Aber wie macht man das?
Zunächst klären wir die Sache mit prod und seinem alloc: cpu = 4. Wir müssen vier Kerne reservieren. In Docker run gibt es zwei Möglichkeiten, dies zu tun:
- Durch die Option
--cpuset=1-4, d. h. der Aufgabe vier bestimmte Kerne auf dem Server zuweisen. - Verwenden
--cpuquota=400_000 --cpuperiod=100_000, eine CPU-Zeitquote zuweisen, d. h. angeben, dass die Aufgabe alle 100 ms Echtzeit nicht mehr als 400 ms CPU-Zeit verbrauchen darf. Es handelt sich um dieselben vier Kerne.
Aber welche dieser Methoden ist geeignet?
Das cpuset sieht ziemlich attraktiv aus. Die Aufgabe hat vier dedizierte Kerne, was bedeutet, dass die CPU-Caches höchst effizient arbeiten werden. Das hat jedoch auch eine Kehrseite: Wir müssten die Verteilung der Berechnungen auf die weniger ausgelasteten Kerne der Maschine selbst übernehmen, anstatt dies durch das Betriebssystem erledigen zu lassen, was eine ziemlich anspruchsvolle Aufgabe ist, insbesondere wenn wir versuchen, Batch-Aufgaben auf einer solchen Maschine zu platzieren. Tests haben gezeigt, dass hier die Quoten-Option besser geeignet ist: So hat das Betriebssystem mehr Freiheit bei der Auswahl des Kerns für die Ausführung der Aufgabe im aktuellen Moment und die Prozessorzeit wird effizienter verteilt.
Lass uns anschauen, wie man in Docker eine Reservierung nach Mindestanzahl an Kernen erstellt. Eine Quote für Batch-Aufgaben ist bereits nicht mehr anwendbar, da das Festlegen eines Maximums nicht notwendig ist; es reicht aus, lediglich ein Minimum zu garantieren. Hier eignet sich die Option gut, docker run --cpushares.
Wir haben uns darauf geeinigt, dass wenn ein Batch ein Minimum von einem Kern garantiert, wir angeben, --cpushares=1024, und wenn mindestens zwei Kerne benötigt werden, dann geben wir an, --cpushares=2048. CPU-Anteile beeinflussen nicht die Verteilung der Prozessorzeit, solange diese ausreicht. Wenn also der Prod momentan nicht alle seine vier Kerne nutzt, gibt es nichts, was die Batch-Aufgaben einschränkt, und sie können die zusätzliche Prozessorzeit verwenden. In einer Situation mit Prozessorengpässen, wenn der Prod alle vier Kerne verbraucht hat und auf die Quote stößt, wird die verbleibende Prozessorzeit proportional zu den cpushares verteilt, d.h. in einer Situation mit drei freien Kernen erhält die Aufgabe mit 1024 cpushares einen Kern, und die anderen beiden - die Aufgabe mit 2048 cpushares.
Aber die Verwendung von Quoten und Anteilen reicht nicht aus. Wir müssen sicherstellen, dass eine Aufgabe mit kurzer Verzögerung Priorität gegenüber einer Batch-Aufgabe bei der Verteilung der Prozessorzeit erhält. Ohne eine solche Priorisierung würde die Batch-Aufgabe die gesamte Prozessorzeit in Anspruch nehmen, wenn sie für den Prod erforderlich ist. Bei Docker run gibt es keine Optionen zur Priorisierung von Containern, aber CPU-Scheduler-Richtlinien in Linux kommen zur Hilfe. Mehr dazu kann man lesen, , und im Rahmen dieses Artikels werden wir sie kurz durchgehen:
- SCHED_OTHER
Standardmäßig erhalten alle normalen Benutzerprozesse auf einer Linux-Maschine. - SCHED_BATCH
Für ressourcenintensive Prozesse vorgesehen. Wenn eine Aufgabe im Prozessor platziert wird, wird eine sogenannte Aktivierungsstrafe eingeführt: Eine solche Aufgabe hat eine geringere Wahrscheinlichkeit, Prozessorressourcen zu erhalten, wenn dieser gerade von einer Aufgabe mit SCHED_OTHER verwendet wird. - SCHED_IDLE
Hintergrundprozess mit sehr niedriger Priorität, sogar niedriger als nice –19. Wir verwenden unsere Open-Source-Bibliothek , um die erforderliche Politik beim Starten des Containers über den Befehl festzulegen
one.nio.os.Proc.sched_setscheduler( pid, Proc.SCHED_IDLE )Aber selbst wenn Sie nicht in Java programmieren, kann das Gleiche mit dem Befehl chrt getan werden:
chrt -i 0 $pidLassen Sie uns alle unsere Isolationsstufen in einer Tabelle zur Veranschaulichung zusammenfassen:
Isolationsklasse
Beispiel alloc
Docker Run Optionen
sched_setscheduler chrt*
Prod
cpu = 4
--cpuquota=400000 --cpuperiod=100000
SCHED_OTHER
Batch
Cpu = [1, * )
--cpushares=1024
SCHED_BATCH
Idle
Cpu= [2, *)
--cpushares=2048
SCHED_IDLE
*Wenn Sie chrt aus dem Container heraus durchführen, könnte die Berechtigung sys_nice erforderlich sein, da Docker diese Berechtigung standardmäßig beim Starten des Containers entzieht.
Aber Aufgaben benötigen nicht nur Prozessorressourcen, sondern auch Verkehr, der die Verzögerung der Netzwerkaufgabe noch mehr beeinflusst als eine falsche Verteilung der Prozessorressourcen. Daher möchten wir natürlich dasselbe Bild auch für den Verkehr erhalten. Das heißt, wenn eine prod-Aufgabe irgendwelche Pakete ins Netzwerk sendet, quotieren wir die maximale Geschwindigkeit (Formel alloc: lan=[*,500mbps) ), mit der die Prod das tun kann. Für Batch garantieren wir jedoch nur eine minimale Bandbreite, beschränken jedoch nicht die maximale (Formel alloc: lan=[10Mbps,*) ) Dabei muss der Verkehr von Prod Vorrang vor Batch-Aufgaben haben.
Hier hat Docker keine primitiven Elemente, die wir verwenden könnten. Aber uns kommt zur Hilfe. Wir konnten das gewünschte Ergebnis mit der Disziplin erreichen. Damit teilen wir zwei Klassen von Verkehr auf: hochpriorisierter Prod und niedrigpriorisierter Batch/Idle. Das Ergebnis der Konfiguration für den ausgehenden Verkehr sieht so aus:
Hier ist 1:0 – „Root qdisc“ der Disziplin hsfc; 1:1 – untergeordnete Klasse hsfc mit einer Gesamtbandbreitenlimit von 8 Gbit/s, unter die alle untergeordneten Klassen aller Container fallen; 1:2 – untergeordnete hsfc-Klasse, die für alle batch und idle Aufgaben mit einem „dynamischen“ Limit gilt, auf das wir weiter unten eingehen. Die anderen untergeordneten hsfc-Klassen sind exklusive Klassen für derzeit aktive prod-Container mit Limits, die ihren Manifesten entsprechen – 450 und 400 Mbit/s. Jeder hsfc-Klasse ist eine qdisc-Warteschlange fq oder fq_codel zugewiesen, abhängig von der Kernel-Version von Linux, um Paketverluste bei Verkehrsspitzen zu vermeiden.
In der Regel dienen die Disziplinen tc nur der Priorisierung des ausgehenden Verkehrs. Aber wir möchten auch den eingehenden Verkehr priorisieren – denn irgendeine batch-Aufgabe kann mühelos den gesamten eingehenden Kanal belegen, indem sie beispielsweise ein großes Paket eingehender Daten für Map&Reduce erhält. Dafür verwenden wir das Modul , das ein virtuelles Interface ifbX für jede Netzwerkschnittstelle erstellt und den eingehenden Verkehr von der Schnittstelle zum ausgehenden auf ifbX umleitet. Anschließend arbeiten für ifbX dieselben Disziplinen zur Kontrolle des ausgehenden Verkehrs, für den die hsfc-Konfiguration sehr ähnlich sein wird:
In unseren Experimenten haben wir festgestellt, dass hsfc die besten Ergebnisse liefert, wenn die Klasse 1:2 des nicht priorisierten batch/idle Verkehrs auf den Minion-Maschinen auf nicht mehr als einen bestimmten freien Durchsatz begrenzt wird. Andernfalls beeinflusst der nicht priorisierte Verkehr die Latenz der prod-Aufgaben zu stark. Der aktuelle Wert des freien Durchsatzes wird von miniond jede Sekunde bestimmt, indem der durchschnittliche Verkehr von allen prod-Aufgaben dieses Minions gemessen  und von der Bandbreite der Netzwerkschnittstelle
 mit einem kleinen Puffer abgezogen wird, d. h.

Die Bandbreiten werden unabhängig für den eingehenden und ausgehenden Verkehr bestimmt. Und gemäß den neuen Werten konfiguriert miniond das Limit der nicht priorisierten Klasse 1:2 neu.
So haben wir alle drei Isolationsklassen implementiert: prod, batch und idle. Diese Klassen haben einen signifikanten Einfluss auf die Ausführungsmerkmale der Aufgaben. Daher haben wir beschlossen, dieses Merkmal an die Spitze der Hierarchie zu setzen, damit bei einem Blick auf den Namen der hierarchischen Warteschlange sofort klar ist, womit wir es zu tun haben:
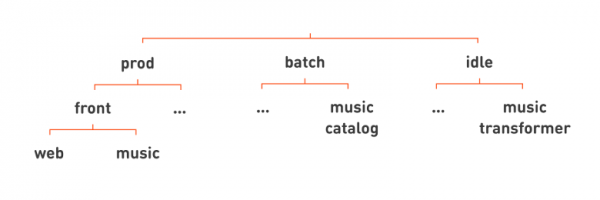
All unsere Bekannten web und music Fronten werden dann in der Hierarchie unter prod platziert. Zum Beispiel lassen Sie uns den Dienst Music Catalog, der regelmäßig einen Katalog von Tracks aus der Sammlung von hochgeladenen mp3-Dateien in "Odnoklassniki" erstellt. Ein Beispiel für einen Idle-Service könnte sein music transformer, der die Lautstärke der Musik normalisiert.
Nachdem wir die überflüssigen Linien wieder entfernt haben, können wir die Namen unserer Dienste flacher gestalten, indem wir die Klassifizierung der Aufgabe am Ende des vollständigen Dienstnamens anfügen: web.front.prod, catalog.music.batch, transformer.music.idle.
Und jetzt, wenn wir uns den Servicenamen ansehen, verstehen wir nicht nur, welche Funktion er erfüllt, sondern auch seine Klassifizierung, was bedeutet, dass wir seine Kritikalität usw. erkennen.
Alles ist wunderbar, aber es gibt eine bittere Wahrheit. Es ist unmöglich, Aufgaben, die auf einer Maschine laufen, vollständig zu isolieren.
Was wir erreicht haben: Wenn die Batch-Aufgabe intensiv nur CPU-Ressourcen verbraucht, dann erledigt der integrierte CPU-Planer in Linux seine Aufgabe sehr gut, und es gibt praktisch keinen Einfluss auf die Prod-Aufgabe. Wenn diese Batch-Aufgabe jedoch aktiv mit dem Speicher arbeitet, zeigt sich der gegenseitige Einfluss bereits. Das geschieht, weil die Prozessor-Caches der Prod-Aufgabe "ausgesogen" werden — letztlich nehmen die Cache-Fehler zu, und der Prozessor verarbeitet die Prod-Aufgabe langsamer. Solch eine Batch-Aufgabe kann die Latenz unseres typischen Prod-Containers um 10 % erhöhen.
Die Isolierung des Verkehrs ist noch schwieriger, da moderne Netzwerkkarten über eine interne Warteschlange für Pakete verfügen. Wenn ein Paket von der Batch-Aufgabe zuerst eingereicht wird, wird es auch zuerst über das Kabel übertragen, und da kann man nichts machen.
Außerdem ist es uns bisher nur gelungen, die Aufgabe der Priorisierung von TCP-Verkehr zu lösen: Für UDP funktioniert der Ansatz mit HSFC nicht. Und selbst im Fall von TCP-Verkehr, wenn die Batch-Aufgabe viel Verkehr generiert, erhöht sich auch hier die Latenz der Prod-Aufgabe um etwa 10 %.
Fehlertoleranz
Eines der Ziele bei der Entwicklung von One-Cloud war die Verbesserung der Fehlertoleranz von Odnoklassniki. Daher möchte ich im Folgenden mögliche Ausfallszenarien und Notfälle genauer betrachten. Lassen Sie uns mit einem einfachen Szenario beginnen – dem Ausfall eines Containers.
Ein Container kann auf verschiedene Weise ausfallen. Dies kann ein Experiment, ein Fehler oder ein Problem im Manifest sein, wodurch die Prod-Aufgabe mehr Ressourcen verbraucht als im Manifest angegeben. Wir hatten einen Fall, in dem ein Entwickler einen komplexen Algorithmus implementierte, ihn mehrmals überarbeitete, sich dabei selbst verwirrte und schließlich so kompliziert wurde, dass die Aufgabe ziemlich untrivial in eine Endlosschleife geriet. Da die Prod-Aufgabe jedoch eine höhere Priorität hat als alle anderen auf denselben Minions, begann sie, alle verfügbaren CPU-Ressourcen zu verbrauchen. In dieser Situation half die Isolation, genauer gesagt, das Kontingent für die CPU-Zeit. Wenn einer Aufgabe ein Kontingent zugewiesen ist, verbraucht sie nicht mehr. Daher bemerkten die Batch- und anderen Prod-Aufgaben, die auf demselben Rechner liefen, nichts.
Das zweite mögliche Problem ist der Absturz des Containers. Hier helfen uns die Neustart-Richtlinien, die jeder kennt; Docker kommt damit sehr gut zurecht. Praktisch alle Prod-Aufgaben haben die Neustart-Richtlinie "always". Manchmal verwenden wir "on_failure" für Batch-Aufgaben oder zur Fehlerbehebung von Prod-Containern.
Was kann man tun, wenn ein ganzer Minion nicht verfügbar ist?
Offensichtlich kann man den Container auf einem anderen Rechner starten. Das Interessanteste dabei ist, was mit der IP-Adresse (den IP-Adressen), die dem Container zugewiesen sind, passiert.
Wir können Containern die gleichen IP-Adressen zuweisen wie den Maschinen-Minions, auf denen diese Container gestartet werden. Dann ändert sich die IP-Adresse des Containers, wenn er auf einem anderen Rechner gestartet wird, und alle Clients müssen verstehen, dass der Container umgezogen ist; sie müssen nun die andere Adresse ansteuern, was einen separaten Service für die Service Discovery erfordert.
Service Discovery ist praktisch. Auf dem Markt gibt es viele Lösungen mit unterschiedlichem Grad an Ausfallsicherheit zur Organisation eines Service-Registers. Oft wird in solchen Lösungen auch die Logik eines Lastenausgleichers implementiert, sowie die Speicherung zusätzlicher Konfigurationen in Form eines KV-Speichers usw.
Wir möchten jedoch auf die Notwendigkeit verzichten, ein separates Register einzuführen, da das die Einführung eines kritischen Systems bedeuten würde, das von allen Diensten in der Produktion genutzt wird. Das bedeutet, dass es einen potenziellen Ausfallpunkt darstellt, und es müssen sehr ausfallsichere Lösungen gewählt oder entwickelt werden, was offensichtlich sehr kompliziert, zeitaufwendig und teuer ist.
Und ein weiterer großer Nachteil: Damit unsere alte Infrastruktur mit der neuen funktioniert, müsste man alle Aufgaben vollständig umschreiben, um ein Service Discovery-System zu verwenden. Es gibt SEHR viel Arbeit, und manchmal ist es bis zur Unmöglichkeit, wenn es um niedrigstufige Geräte geht, die auf Betriebssystemkern- oder Hardware-Ebene arbeiten. Die Implementierung dieser Funktionalität mithilfe etablierter Lösungsansätze, wie zum Beispiel , würde an vielen Stellen eine zusätzliche Last bedeuten, an anderen Stellen — eine Komplexität der Wartung und zusätzliche Ausfallszenarien. Da wir die Komplexität nicht erhöhen wollten, entschieden wir uns, die Nutzung von Service Discovery optional zu machen.
In one-cloud folgt die IP der Instanz, d.h. jede Aufgabeninstanz hat ihre eigene IP-Adresse. Diese Adresse ist "statisch": sie wird jeder Instanz zum Zeitpunkt der ersten Bereitstellung des Dienstes in der Cloud zugewiesen. Wenn der Dienst während seiner Lebensdauer eine unterschiedliche Anzahl von Instanzen hatte, wird im Ergebnis so viele IP-Adressen zugewiesen, wie es maximal Instanzen gab.
Diese Adressen ändern sich anschließend nicht: Sie werden einmal zugewiesen und existieren während der gesamten Lebensdauer des Dienstes in der Produktion weiter. Die IP-Adressen folgen den Containern im Netzwerk. Wenn ein Container auf einen anderen Knoten verschoben wird, wird die Adresse ebenfalls mit ihm übertragen.
So kommt es selten vor, dass der Dienstnamen mit seiner Liste von IP-Adressen abgeglichen wird. Wenn man sich noch einmal die Instanznamen des Dienstes betrachtet, die wir zu Beginn des Artikels erwähnt haben (1.ok-web.group1.web.front.prod, 2.ok-web.group1.web.front.prod, …), dann werden wir feststellen, dass sie FQDN ähneln, die im DNS verwendet werden. Das ist auch der Fall, denn zur Anzeige der Instanznamen von Diensten in ihren IP-Adressen verwenden wir das DNS-Protokoll. Dabei gibt dieses DNS alle reservierten IP-Adressen aller Container zurück – sowohl der laufenden als auch der gestoppten (angenommen, es werden drei Replikate verwendet, und uns stehen fünf Adressen zur Verfügung – alle fünf werden zurückgegeben). Die Clients, die diese Informationen erhalten, versuchen, eine Verbindung zu allen fünf Replikaten herzustellen – und bestimmen auf diese Weise, welche davon aktiv sind. Diese Methode zur Feststellung der Verfügbarkeit ist deutlich zuverlässiger, da hier weder DNS noch Service Discovery beteiligt sind, was bedeutet, dass es keine schwer lösbaren Probleme hinsichtlich der Aktualität der Informationen und der Fehlertoleranz dieser Systeme gibt. Darüber hinaus können wir in kritischen Diensten, von denen der gesamte Portalbetrieb abhängt, auf DNS ganz verzichten und die IP-Adressen einfach in die Konfiguration eintragen.
Die Umsetzung eines solchen IP-Transfers für Container kann nicht trivial sein – und wir werden an einem nächsten Beispiel darauf eingehen, wie das funktioniert:
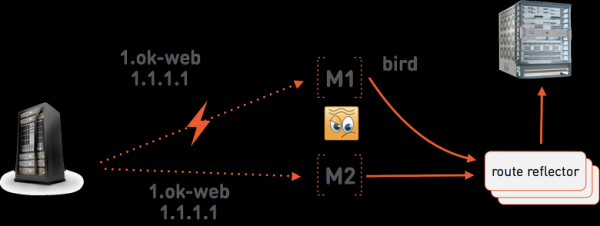
Angenommen, der one-cloud Master befiehlt dem Minion M1, zu starten 1.ok-web.group1.web.front.prod mit der Adresse 1.1.1.1. Auf dem Minion läuft , das diese Adresse an spezielle Server ankündigt . Letztere haben eine BGP-Session mit dem Netzwerkgerät, in das die Route der Adresse 1.1.1.1 auf M1 übertragen wird. M1 routet die Pakete mit den Mitteln von Linux ins Containerinnere. Es gibt drei route reflectoren, da dies ein sehr kritischer Teil der one-cloud-Infrastruktur ist – ohne sie wird das Netzwerk in der one-cloud nicht funktionieren. Wir platzieren sie in verschiedenen Racks, wenn möglich in verschiedenen Räumen des Rechenzentrums, um die Wahrscheinlichkeit eines gleichzeitigen Ausfalls aller drei zu verringern.
Nehmen wir nun an, die Verbindung zwischen dem one-cloud Master und dem Minion M1 ist abgebrochen. Der one-cloud Master wird nun davon ausgehen, dass M1 vollständig ausgefallen ist. Das heißt, er wird dem Minion M2 den Befehl geben, zu starten web.group1.web.front.prod Mit der gleichen Adresse 1.1.1.1. Jetzt haben wir zwei Konflikt-Routen im Netz für 1.1.1.1: auf M1 und auf M2. Um solche Konflikte zu lösen, verwenden wir den Multi Exit Discriminator, der in der BGP-Ankündigung angegeben wird. Dies ist eine Zahl, die das Gewicht der angekündigten Route anzeigt. Die Route mit dem niedrigeren MED-Wert wird aus den Konflikten ausgewählt. Der Master von one-cloud unterstützt MED als integralen Bestandteil der IP-Adressen von Containern. Zuerst wird die Adresse mit einem relativ hohen MED = 1.000.000 ausgegeben. Wenn es jedoch zu einem Notfall-Transfer des Containers kommt, verringert der Master das MED, und M2 erhält den Befehl, die Adresse 1.1.1.1 mit MED = 999.999 anzukündigen. Der Instance, die auf M1 läuft, bleibt dabei offline, und ihr weiteres Schicksal interessiert uns kaum, bis die Verbindung zum Master wiederhergestellt ist, wenn sie dann wie ein alter Duplicat gestoppt wird.
Notfälle
Alle Systeme zur Verwaltung von Rechenzentren bewältigen kleinere Ausfälle in der Regel akzeptabel. Der Ausfall eines Containers ist praktisch überall die Norm.
Schauen wir uns an, wie wir mit einem Notfall umgehen, zum Beispiel mit einem Stromausfall in einem oder mehreren Räumen des Rechenzentrums.
Was bedeutet ein Notfall für das System zur Verwaltung des Rechenzentrums? Zuerst einmal ist es ein massiver gleichzeitiger Ausfall vieler Maschinen, und das Management-System muss gleichzeitig viele Container migrieren. Aber bei einem sehr großflächigen Notfall kann es vorkommen, dass nicht alle Aufgaben auf anderen Minions umverteilt werden können, da die Ressourcen-Kapazität des Rechenzentrums unter 100 % Auslastung fällt.
Oft gehen Notfälle mit einem Ausfall auch der Management-Ebene einher. Dies kann durch einen Ausfall der Hardware verursacht werden, häufiger jedoch, weil Notfälle nicht getestet werden und die Management-Ebene selbst unter der erhöhten Last zusammenbricht.
Was kann man in all dem tun?
Massive Migrationen bedeuten, dass in der Infrastruktur eine große Anzahl von Aktionen, Migrationen und Platzierungen stattfindet. Jede Migration kann einige Zeit in Anspruch nehmen, die notwendig ist, um Container-Images zu den Minions zu liefern und zu entpacken, Container zu starten und zu initialisieren usw. Daher ist es wünschenswert, dass wichtigere Aufgaben vor weniger wichtigen gestartet werden.
Lassen Sie uns erneut die uns vertraute Hierarchie der Dienste betrachten und versuchen zu entscheiden, welche Aufgaben wir zuerst starten möchten.
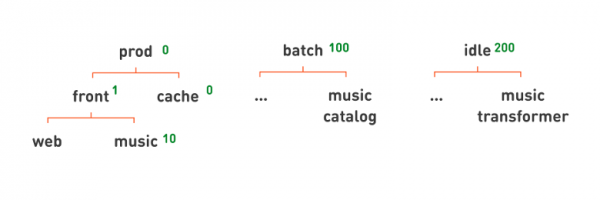
Natürlich sind dies die Prozesse, die direkt an der Bearbeitung von Benutzeranfragen beteiligt sind, d. h. prod. Wir geben dies an mit Priorität der Platzierung — einer Zahl, die einer Warteschlange zugewiesen werden kann. Wenn eine Warteschlange eine höhere Priorität hat, werden ihre Dienste zuerst platziert.
In prod weisen wir höhere Prioritäten zu, 0; in batch etwas niedrigere, 100; in idle noch niedrigere, 200. Die Prioritäten werden hierarchisch angewendet. Alle Aufgaben auf einer tieferen Hierarchieebene haben die entsprechende Priorität. Wenn wir wollen, dass innerhalb von prod die Caches vor den Frontends gestartet werden, weisen wir den Caches eine Priorität von 0 und den Frontunterwarteschlangen eine Priorität von 1 zu. Wenn wir beispielsweise möchten, dass das Hauptportal aus den Frontends zuerst gestartet wird und der Musik-Frontend danach, können wir letzterem eine niedrigere Priorität zuweisen — 10.
Ein weiteres Problem ist der Mangel an Ressourcen. Wir haben also eine große Anzahl von Geräten verloren, ganze Säle im Rechenzentrum, und wir haben so viele Dienste gestartet, dass es jetzt für alle nicht genug Ressourcen gibt. Wir müssen entscheiden, welche Aufgaben wir opfern, damit die wichtigsten kritischen Dienste weiterhin funktionieren.
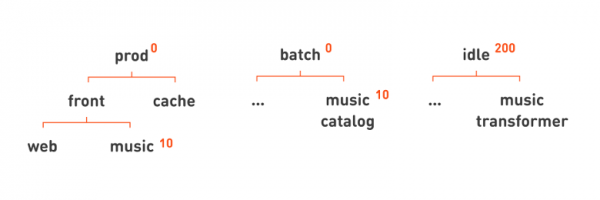
Im Gegensatz zur Priorität der Platzierung können wir nicht einfach alle batch-Aufgaben opfern, einige davon sind wichtig für den Betrieb des Portals. Daher haben wir separat Priorität der Verdrängung aufgaben выдел especíal. Bei der Platzierung kann eine Aufgabe mit höherer Priorität eine Aufgabe mit niedrigerer Priorität verdrängen, d. h. anhalten, wenn es keine freien Minions mehr gibt. In diesem Fall wird die Aufgabe mit niedrigerer Priorität wahrscheinlich unplatziert bleiben, d. h. es gibt keinen geeigneten Minion mit ausreichend freien Ressourcen mehr.
In unserer Hierarchie ist es sehr einfach, eine solche Verdrängungspriorität anzugeben, dass prod- und batch-Aufgaben idle-Aufgaben verdrängen oder anhalten, aber sich gegenseitig nicht, indem wir für idle eine Priorität von 200 angeben. Genau wie im Fall der Platzierungspriorität können wir unsere Hierarchie nutzen, um komplexere Regeln zu beschreiben. Zum Beispiel geben wir an, dass wir auf die Musikfunktion verzichten, wenn uns die Ressourcen für das Haupt-Webportal fehlen, indem wir für die entsprechenden Knoten eine niedrigere Priorität festlegen: 10.
Vorfälle im Rechenzentrum
Warum kann das gesamte Rechenzentrum ausfallen? Naturkatastrophen. Es gab einen interessanten Beitrag darüber, wie . Die Elemente kann man als Obdachlose betrachten, die einmal im Kanal die Optik abgebrannt haben, und das Rechenzentrum komplett den Kontakt zu den anderen Standorten verloren hat. Ein Grund für den Ausfall kann auch der menschliche Faktor sein: Ein Operator könnte einen Befehl erteilen, der dazu führt, dass das gesamte Rechenzentrum ausfällt. Dies kann durch einen großen Bug geschehen. Insgesamt fallen Rechenzentren — das ist keine Seltenheit. Bei uns passiert das alle paar Monate einmal.
Und das machen wir, damit niemand #окживи auf Twitter postet.
Die erste Strategie ist die Isolation. Jede Instanz von one-cloud ist isoliert und kann Maschinen nur eines Rechenzentrums verwalten. Das heißt, der Verlust der Cloud aufgrund von Bugs oder falschen Befehlen des Operators bedeutet den Verlust nur eines Rechenzentrums. Darauf sind wir vorbereitet: Es gibt eine Reservierungspolitik, bei der die Replikate der Anwendungen und Daten in allen Rechenzentren platziert werden. Wir nutzen ausfallsichere Datenbanken und testen regelmäßig Ausfälle.
Da wir heute über vier Rechenzentren verfügen, gibt es auch vier separate, vollständig isolierte Instanzen von one-cloud.
Dieser Ansatz schützt nicht nur vor physischen Ausfällen, sondern kann auch vor Fehlern des Operators schützen.
Was kann man noch mit dem menschlichen Faktor machen? Wenn ein Operator der Cloud einen seltsamen oder potenziell gefährlichen Befehl erteilt, könnte plötzlich verlangt werden, eine kleine Aufgabe zu lösen, um zu überprüfen, wie gut er überlegt hat. Zum Beispiel, wenn es sich um einen massiven Stopp vieler Replikate handelt oder einfach um einen seltsamen Befehl — die Anzahl der Replikate zu reduzieren oder den Namen des Images zu ändern und nicht nur die Versionsnummer im neuen Manifest.
Ergebnisse
Einzigartige Merkmale von one-cloud:
- Eine hierarchische und übersichtliche Benennungsskema für Dienste und Container,, die es ermöglicht, sehr schnell zu erkennen, um welche Aufgabe es sich handelt, zu welchem Zweck sie dient, wie sie funktioniert und wer dafür verantwortlich ist.
- Wir verwenden unsere Techniken zur Kombination von Prod- und Batch-Aufgaben auf Minions, um die Effizienz der Maschinen gemeinsam zu nutzen, zu erhöhen. Statt cpuset verwenden wir CPU-Quoten, Shares, CPU-Planerpolitiken und Linux QoS.
- Es gelang uns nicht, die Container, die auf einer Maschine arbeiten, vollständig zu isolieren, aber ihr gegenseitiger Einfluss bleibt auf 20 % beschränkt.
- Die Organisation der Dienste in eine Hierarchie hilft bei der automatischen Beseitigung von Notfällen mithilfe von Platzierungs- und Verdrängungsprioritäten..
FAQ
Warum haben wir keine fertige Lösung übernommen?
- Verschiedene Klassen von Aufgabenisolierungen erfordern unterschiedliche Logik beim Deployment auf Minions. Während Prod-Aufgaben einfach durch Ressourcensicherung bereitgestellt werden können, müssen Batch- und Idle-Aufgaben unter Berücksichtigung der tatsächlichen Ressourcenauslastung auf den Maschinen-Minions platziert werden.
- Die Notwendigkeit, solche Ressourcen, die von Aufgaben verbraucht werden, zu berücksichtigen, wie:
- Netzwerkbandbreite;
- Arten und „Spindeln“ von Festplatten.
- Die Notwendigkeit, Prioritäten der Dienste bei der Behebung von Störungen festzulegen, sowie die Rechte und Quoten von Teams auf Ressourcen, was durch hierarchische Warteschlangen in one-cloud gelöst wird.
- Die Notwendigkeit, menschliche Bezeichnungen für Container zu haben, um die Reaktionszeiten auf Störungen und Vorfälle zu verkürzen.
- Die Unmöglichkeit, Service Discovery gleichzeitig flächendeckend zu implementieren; die Notwendigkeit, lange Zeit mit Aufgaben zu koexistieren, die auf physischen Hosts platziert sind – dies wird durch „statische“ IP-Adressen, die Container folgen, gelöst, und infolgedessen die Notwendigkeit einer einzigartigen Integration in große Netzwerkstrukturen.
All diese Funktionen würden erhebliche Umgestaltungen bestehender Lösungen erfordern, und nach einer Abschätzung des Arbeitsaufwands haben wir festgestellt, dass wir unsere eigene Lösung mit ungefähr dem gleichen Aufwand entwickeln können. Doch unsere Lösung wird erheblich einfacher zu betreiben und weiterzuentwickeln sein – sie enthält keine unnötigen Abstraktionen, die unnötige Funktionalitäten unterstützen.
An diejenigen, die die letzten Zeilen lesen – danke für Ihre Geduld und Aufmerksamkeit!
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish