

Einführung in Betriebssysteme
Hallo, Habr! Ich möchte Ihnen eine Serie von Übersetzungen einer interessanten Literatur — OSTEP — vorstellen. In diesem Material wird die Funktionsweise von Unix-ähnlichen Betriebssystemen ziemlich gründlich behandelt, insbesondere die Arbeit mit Prozessen, verschiedenen Planern, Speicher und anderen ähnlichen Komponenten, die ein modernes Betriebssystem ausmachen. Das Original aller Materialien können Sie hier ansehen . Bitte beachten Sie, dass die Übersetzung unprofessionell (relativ frei) durchgeführt wurde, aber ich hoffe, dass ich den allgemeinen Sinn bewahrt habe.
Die Laborarbeiten zu diesem Thema finden Sie hier:
Andere Teile:
Und Sie können auch meinen Kanal auf =)
Planung: Multi-Level Feedback Queue
In dieser Vorlesung werden wir über die Herausforderungen bei der Entwicklung eines der bekanntesten Ansätze zur
Planung sprechen, der als Multi-Level Feedback Queue (MLFQ) bezeichnet wird. Der MLFQ Scheduler wurde erstmals 1962 von Fernando J. Corbató im System beschrieben, das
Compatible Time-Sharing System (CTSS) genannt wird. Diese Arbeiten (einschließlich späterer Arbeiten an
Multics) wurden später für den Turing Award nominiert. Der Scheduler wurde
später weiter verbessert und nahm eine Form an, die man bereits in
einigen modernen Systemen antreffen kann.
Der MLFQ-Algorithmus versucht, zwei grundlegende, sich überschneidende Probleme zu lösen.
Zunächst einmal, er versucht, die Durchlaufzeit zu optimieren, die, wie wir in der vorherigen Vorlesung betrachtet haben, durch das Starten der kürzesten
Aufgaben zu Beginn der Warteschlange optimiert wird. Allerdings weiß das OS nicht, wie lange ein bestimmter Prozess arbeiten wird, was
das notwendige Wissen für die Algorithmen SJF, STCF ist. Zweitens, MLFQ versucht,
das System reaktionsschnell für die Benutzer zu machen (zum Beispiel für diejenigen, die warten und
auf ihren Bildschirm starren, in der Erwartung, dass die Aufgabe abgeschlossen wird) und damit die Zeit
der Reaktion zu minimieren. Leider verringern Algorithmen wie RR die Reaktionszeit, haben aber äußerst
negative Auswirkungen auf die Durchlaufzeit-Metrik. Daher unser Problem: Wie entwirft man einen
Scheduler, der unseren Anforderungen entspricht und dabei nichts über die
Charakteristik des Prozesses im Allgemeinen weiß? Wie kann der Scheduler die Eigenschaften der Aufgaben lernen,
die er ausführt, und dadurch bessere Entscheidungen bezüglich der Planung treffen?
Die Kernproblematik: Wie plant man Aufgaben ohne perfektes Wissen?
Wie gestaltet man einen Scheduler, der gleichzeitig die Reaktionszeit minimiert
für interaktive Aufgaben und dabei die Durchlaufzeit minimiert, ohne im Voraus.
das Zeitverhalten der Aufgabe zu kennen?
Hinweis: Lernend aus vergangenen Ereignissen
Die MLFQ-Warteschlange ist ein hervorragendes Beispiel für ein System, das aus
vergangenen Ereignissen lernt, um die Zukunft vorherzusagen. Solche Ansätze sind häufig
in Betriebssystemen zu finden (und in vielen anderen Bereichen der Informatik, einschließlich der Bereiche
Vorhersagen in Hardware und Algorithmen zur Caching). Ähnliche Ansätze
wirken, wenn Aufgaben Verhaltensphasen haben und somit vorhersagbar sind.
Allerdings sollte man mit dieser Technik vorsichtig sein, da Vorhersagen sehr leicht
falsch sein können und das System zu schlechteren Entscheidungen führen können als
ohne jegliches Wissen.
MLFQ: Grundregeln
Betrachten wir die Grundregeln des MLFQ-Algorithmus. Und obwohl es verschiedene
Implementierungen dieses Algorithmus gibt, sind die grundlegenden Ansätze ähnlich.
In der Implementierung, die wir betrachten werden, wird MLFQ mehrere
einzelne Warteschlangen haben, von denen jede eine unterschiedliche Priorität hat. Zu jeder Zeit
befindet sich eine aufbereitete Aufgabe in einer Warteschlange. MLFQ verwendet Prioritäten,
um zu entscheiden, welche Aufgabe zur Ausführung gebracht werden soll, d.h. die Aufgabe mit
höherer Priorität (Aufgabe aus der Warteschlange mit höchster Priorität) wird zuerst
ausgeführt.
Zweifellos kann in einer bestimmten Warteschlange mehr als eine Aufgabe sein, damit
haben sie die gleiche Priorität. In diesem Fall wird der RR-Mechanismus
zur Planung der Ausführung unter diesen Aufgaben verwendet.
So kommen wir zu zwei grundlegenden Regeln für MLFQ:
- Regel 1: Wenn Priorität(A) > Priorität(B), wird Aufgabe A ausgeführt (B nicht)
- Regel 2: Wenn Priorität(A) = Priorität(B), werden A und B unter Verwendung von RR ausgeführt
Aus den obigen Punkten ergeben sich die Schlüsselfaktoren für die MLFQ-Planung
sind die Prioritäten. Anstatt jeder
Aufgabe eine feste Priorität zuzuweisen, ändert MLFQ ihre Priorität basierend auf dem beobachteten Verhalten.
Wenn eine Aufgabe beispielsweise ständig Arbeiten auf der CPU ausführt, während sie auf Eingaben von der Tastatur wartet,
wird MLFQ die Priorität des Prozesses hoch halten, da genau das so
ein interaktiver Prozess funktionieren sollte. Wenn hingegen die Aufgabe ständig und
intensiv die CPU über einen längeren Zeitraum nutzt, wird MLFQ ihre
Priorität senken. Auf diese Weise wird MLFQ das Verhalten der Prozesse während ihrer Ausführung studieren
und verwenden.
Lassen Sie uns ein Beispiel zeichnen, wie die Warteschlangen zu einem bestimmten Zeitpunkt
aussehen könnten, und dann würde dies etwa so aussehen:
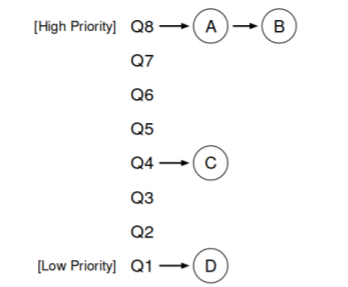
In diesem Szenario befinden sich 2 Prozesse A und B in der Warteschlange mit der höchsten Priorität. Prozess
C befindet sich irgendwo in der Mitte, und Prozess D am Ende der Warteschlange. Gemäß den obigen
Beschreibungen des MLFQ-Algorithmus wird der Scheduler nur Aufgaben mit der höchsten Priorität ausführen.
Priorität gemäß RR, während die Aufgaben C und D nicht berücksichtigt werden.
Natürlich wird ein statischer Snapshot nicht das volle Bild davon geben, wie MLFQ funktioniert.
Es ist wichtig zu verstehen, wie sich das Bild im Laufe der Zeit verändert.
Versuch 1: Wie man die Priorität ändert
In diesem Moment muss entschieden werden, wie MLFQ das Prioritätsniveau
der Aufgaben (und damit deren Position in der Warteschlange) im Verlauf ihres Lebenszyklus ändert. Dazu
muss man den Arbeitsablauf im Kopf behalten: Eine bestimmte Anzahl
interaktiver Aufgaben mit kurzer Laufzeit (und somit häufige Freigabe
der CPU) und mehrere langwierige Aufgaben, die die CPU die gesamte Arbeitszeit nutzen, wobei
die Reaktionszeit für solche Aufgaben nicht wichtig ist. Somit kann der erste Versuch
unternehmen werden, den MLFQ-Algorithmus mit folgenden Regeln zu implementieren:
- Regel 3: Wenn eine Aufgabe in das System eintritt, wird sie in die Warteschlange mit der höchsten
- Priorität festgelegt wurde.
- Regel 4a: Wenn eine Aufgabe ihr zugewiesenes Zeitfenster vollständig nutzt, wird ihre
- Priorität gesenkt.
- Regel 4b: Wenn die Aufgabe die CPU vor Ablauf ihres Zeitfensters freigibt,
- behält sie ihre vorherige Priorität.
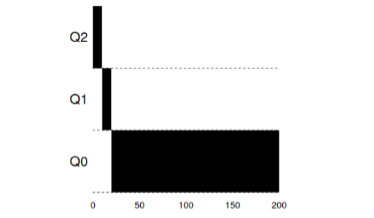
Beispiel 1: Eine einzelne langlaufende Aufgabe
Wie in diesem Beispiel zu sehen ist, wird die Aufgabe beim Eingang mit der höchsten
Priorität eingestuft. Nach einem Zeitfenster von 10 ms wird die Priorität durch den
Scheduler gesenkt. Nach dem nächsten Zeitfenster wird die Aufgabe schließlich auf
die niedrigste Priorität im System herabgestuft, wo sie verbleibt.
Beispiel 2: Eine kurze Aufgabe wurde hinzugefügt
Jetzt schauen wir uns ein Beispiel an, wie MLFQ versucht, sich SJF anzunähern. In diesem
Beispiel gibt es zwei Aufgaben: A, die eine langlaufende Aufgabe ist, die ständig
CPU beansprucht, und B, die eine kurze interaktive Aufgabe ist. Angenommen,
A hat bereits eine gewisse Zeit gearbeitet, als die Aufgabe B eintrifft.
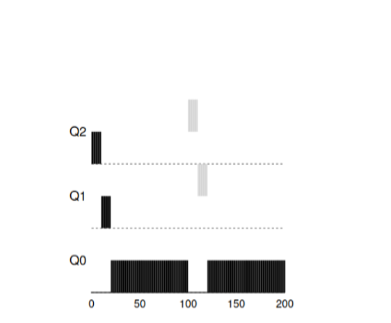
In diesem Diagramm sind die Ergebnisse des Szenarios sichtbar. Aufgabe A, wie jede Aufgabe,
die die CPU nutzt, befindet sich ganz unten. Aufgabe B wird zu Zeitpunkt T=100 eintreffen und wird
in die Warteschlange mit der höchsten Priorität platziert. Da ihre Laufzeit kurz ist, wird
sie abgeschlossen, bevor sie die letzte Warteschlange erreicht.
Aus diesem Beispiel lässt sich das Hauptziel des Algorithmus ableiten: Da der Algorithmus nicht
weiß, ob es sich um eine lange oder kurze Aufgabe handelt, geht er zunächst davon aus, dass es sich um eine Aufgabe handelt.
kurz und gibt ihr die höchste Priorität. Wenn es sich tatsächlich um eine kurze Aufgabe handelt, dann
wird sie schnell ausgeführt, andernfalls, wenn es sich um eine lange Aufgabe handelt, wird sie sich langsam bewegen
nach unten in der Priorität und bald beweisen, dass es sich tatsächlich um eine lange Aufgabe handelt, die nicht
eine Rückmeldung erfordert.
Beispiel 3: Was ist mit der Ein- und Ausgabe?
Lassen Sie uns nun das Beispiel mit Ein- und Ausgabe betrachten. Wie in Regel 4b gesagt,
wenn ein Prozess den Prozessor freigibt, ohne seine gesamte Prozessorzeit vollständig genutzt zu haben,
dann bleibt er auf dem bisherigen Prioritätsniveau. Die Absichten dieser Regel sind recht einfach
— wenn eine interaktive Aufgabe viele Ein- und Ausgabeoperationen ausführt, zum Beispiel, wenn sie auf
Benutzereingaben wie Tastatureingaben oder Mausklicks wartet, wird eine solche Aufgabe den Prozessor
früher von dem zugewiesenen Zeitfenster befreien. Wir möchten eine solche Aufgabe nicht herabstufen,
deshalb bleibt sie auf dem gleichen Niveau.
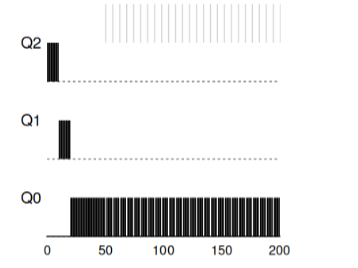
Dieses Beispiel zeigt, wie der Algorithmus mit solchen Prozessen arbeitet - die interaktive Aufgabe B, die nur 1 ms CPU benötigt, bevor sie die
Ein- und Ausgabeprozesse ausführt, und die lange Aufgabe A, die die gesamte CPU-Zeit nutzt.
MLFQ hält den Prozess B mit der höchsten Priorität, da er ständig
den CPU freigibt. Wenn B eine interaktive Aufgabe ist, dann hat der Algorithmus in diesem Fall sein Ziel erreicht,
interaktive Aufgaben schnell auszuführen.
Probleme mit dem aktuellen MLFQ-Algorithmus
In den vorherigen Beispielen haben wir eine grundlegende Version von MLFQ entwickelt. Und es scheint, dass er
seine Arbeit gut macht und fair, indem er die Prozessorzeit gerecht zwischen
langen Aufgaben verteilt und kurzen Aufgaben oder solchen, die intensiv Eingaben verarbeiten, die Möglichkeit gibt, schnell zu arbeiten. Leider enthält dieser Ansatz mehrere
ernsthafte Probleme.
, das Hungersnot-Problem: Wenn es im System viele interaktive
Zunächst einmalAufgaben gibt, werden sie die gesamte Prozessorzeit beanspruchen und somit wird keine lange
Aufgabe die Möglichkeit erhalten, ausgeführt zu werden (sie verhungern).
, clevere Benutzer könnten ihre Programme so schreiben, dass sie
Zweitensden Scheduler überlisten. Der Trick besteht darin, etwas zu tun, das dazu führt, dass der
Scheduler dem Prozess mehr Prozessorzeit zuweist. Der Algorithmus, der
Der Planer wird dem Prozess mehr Prozessorzeit zuweisen. Der Algorithmus, der
Wie oben beschrieben, ist es durchaus anfällig für derartige Angriffe: Bevor das Zeitfenster praktisch
abgelaufen ist, muss eine Ein- oder Ausgabeoperation (für eine bestimmte, gleichgültig welche Datei) durchgeführt werden
und damit die CPU freigegeben werden. Ein solches Verhalten ermöglicht es, in der gleichen
Warteschlange zu bleiben und erneut einen höheren Prozentsatz an CPU-Zeit zu erhalten. Wenn das richtig gemacht wird (zum Beispiel 99% der Zeit im Fenster vor der Freigabe der CPU auszuführen),
kann eine solche Aufgabe einfach monopolistisch die CPU nutzen.
Schließlich kann das Programm sein Verhalten im Laufe der Zeit ändern. Die Aufgaben,
die die CPU verwendet haben, können interaktiv werden. In unserem Beispiel erhalten solche
Aufgaben nicht die angemessene Behandlung vom Scheduler, da sie andere
(ursprüngliche) interaktive Aufgaben erhalten hätten.
Frage an das Publikum: Welche Angriffe auf den Scheduler könnten in der modernen Welt durchgeführt werden?
Versuch 2: Prioritätserhöhung
Lassen Sie uns versuchen, die Regeln zu ändern und zu sehen, ob wir es schaffen, Probleme mit
Hunger zu vermeiden. Was könnten wir tun, um zu gewährleisten, dass die mit
CPU verbundenen Aufgaben ihre Zeit erhalten (auch wenn nicht viel).
Als einfache Lösung des Problems kann man vorschlagen, alle solchen Aufgaben im System periodisch
in der Priorität zu erhöhen. Es gibt viele Möglichkeiten, dies zu erreichen; lassen Sie uns als Beispiel etwas Einfaches umsetzen: Alle
Aufgaben sofort in die höchste Priorität zu versetzen, von dort ein neues Regelwerk:
Regel5
: Nach einer bestimmten Zeitspanne S alle Aufgaben im System in die höchste Warteschlange versetzen.
- Unser neues Regelwerk löst sofort zwei Probleme. Erstens, Prozesseverhungern garantiert nicht: Aufgaben, die sich in der höheren Warteschlange befinden, werden die
CPU-Zeit gemäß dem RR-Algorithmus teilen, sodass alle Prozesse
CPU-Zeit erhalten. Zweitens, wenn ein Prozess, der zuvor nur die CPU verwendet hat, interaktiv wird, bleibt er in der Warteschlange mit der höheren
Priorität, nachdem er einmal in die höchste Priorität erhöht wurde.
Betrachten wir ein Beispiel. In diesem Szenario betrachten wir einen Prozess, der die
nur die CPU betrifft, wird interaktiv und bleibt in der Warteschlange mit höherer
Priorität, nachdem er einmal in die höchste Priorität befördert wurde.
Betrachten wir ein Beispiel. In diesem Szenario betrachten wir einen Prozess, der
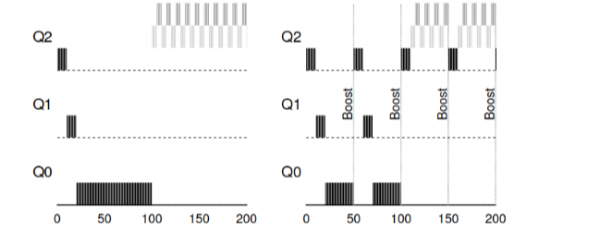
CPU und zwei interaktive, kurze Prozesse. Links zeigt die Abbildung das Verhalten ohne Prioritätserhöhung, wodurch eine langwierige Aufgabe nach dem Eintreffen von zwei interaktiven Aufgaben im System verhungern beginnt. Auf der rechten Seite wird alle 50 ms eine Prioritätserhöhung durchgeführt, sodass alle Prozesse garantiert CPU-Zeit erhalten und periodisch ausgeführt werden. 50 ms wurde in diesem Fall als Beispiel gewählt, tatsächlich ist diese Zahl etwas höher.
Offensichtlich führt die Hinzufügung der Zeit für die periodische Erhöhung S zu
der berechtigten Frage: Welcher Wert sollte festgelegt werden? Einer der angesehenen
Systemingenieure, John Ousterhout, nannte solche Größen in Systemen voo-doo
Konstanten, da sie in gewissem Sinne schwarze Magie für die korrekte
Festlegung erforderten. Und leider hat S diesen Charakter. Wenn der Wert zu hoch
gesetzt wird, beginnen lange Aufgaben zu verhungern. Ist der Wert zu niedrig,
erhalten interaktive Aufgaben nicht die nötige CPU-Zeit.
Versuch 3: Beste Zeiterfassung
Nun haben wir ein weiteres Problem, das gelöst werden muss: Wie können wir
verhindern, dass unser Scheduler ausgetrickst wird? Die Schuld tragen
die Regeln 4a, 4b, die es einer Aufgabe ermöglichen, ihre Priorität beizubehalten, indem sie die CPU
vor Ablauf der zugewiesenen Zeit freigibt. Wie gehen wir damit um?
In diesem Fall kann eine bessere Zeiterfassung der CPU auf jedem
Level von MLFQ als Lösung angesehen werden. Anstatt die Zeit, die das Programm verwendet hat,
um CPU über den festgelegten Zeitraum zu nutzen, sollte diese erfasst und gespeichert werden. Nachdem
ein Prozess die ihm zugewiesene Zeit aufgebraucht hat, sollte sein Prioritätslevel auf das nächste
niedrigere Niveau gesenkt werden. Jetzt spielt es keine Rolle, wie der Prozess seine Zeit verwendet – ob
er ständig rechnend auf der CPU oder durch zahlreiche Aufrufe agiert. Somit
sollte Regel 4 wie folgt umgeschrieben werden:
- Regel4: Nachdem eine Aufgabe die ihr zugewiesene Zeit in der aktuellen Warteschlange aufgebraucht hat (unabhängig davon, wie oft sie die CPU freigegeben hat), wird die Priorität dieser Aufgabe gesenkt (sie bewegt sich weiter unten in der Warteschlange).
Sehen wir uns ein Beispiel an:
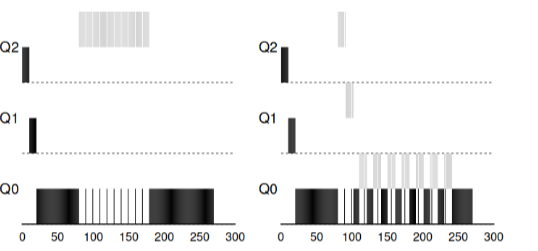 »
Die Abbildung zeigt, was passiert, wenn man versucht, den Scheduler auszutricksen, wie
Wenn man die vorherigen Regeln 4a, 4b anwendet, ergibt sich das Ergebnis links. Mit der neuen
Regel – das Ergebnis rechts. Vor der Aktivierung der Schutzmechanismen konnte jeder Prozess I/O bis zur
Fertigstellung aufrufen und so die CPU dominieren. Nach Aktivierung des Schutzes wird er jedoch, unabhängig vom Verhalten
der I/O, immer weiter unten in die Warteschlangen eingestuft und kann somit nicht unrechtmäßig
auf die CPU-Ressourcen zugreifen.
Verbesserungen von MLFQ und anderen Problemen
Mit den oben genannten Verbesserungen entstehen neue Probleme: Eine der Hauptfragen ist, wie ein
solcher Scheduler parametrisiert werden sollte? Das heißt, wie viele Warteschlangen sollten vorhanden sein?
Wie groß sollte das Arbeitsfenster des Programms innerhalb der Warteschlange sein? Wie
häufig sollte die Priorität eines Programms erhöht werden, um Hunger zu vermeiden und
Verhaltensänderungen des Programms zu berücksichtigen? Auf diese Fragen gibt es keine einfache
Antwort, und nur Experimente mit Lasten und anschließende Anpassungen
des Schedulers können zu einem einigermaßen zufriedenstellenden Gleichgewicht führen.
Beispielsweise erlauben die meisten Implementierungen von MLFQ die Zuweisung unterschiedlicher
Zeitintervalle zu verschiedenen Warteschlangen. Hochpriorisierte Warteschlangen erhalten in der Regel
kurze Intervalle. Diese Warteschlangen bestehen aus interaktiven Aufgaben,
zwischen denen der Wechsel recht empfindlich ist und etwa 10 Millisekunden oder weniger
dauern sollte. Im Gegensatz dazu bestehen niedrigpriorisierte Warteschlangen aus langen Aufgaben, die
die CPU verwenden. In diesem Fall sind lange Zeitintervalle sehr passend (100 ms).
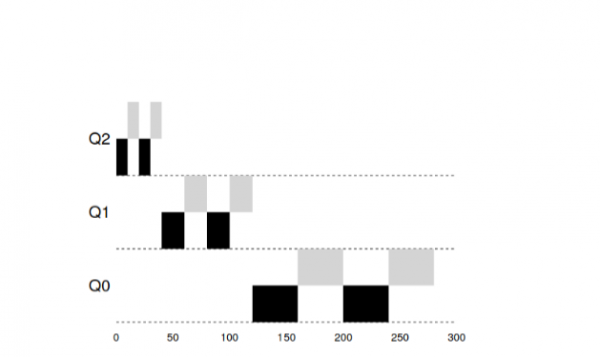
In diesem Beispiel gibt es 2 Aufgaben, die 20 Millisekunden in der hochpriorisierten Warteschlange gearbeitet haben,
aufgeteilt in Fenster von 10 Millisekunden. 40 Millisekunden in der mittleren Warteschlange (Fenster von 20 Millisekunden) und in der niedrigpriorisierten
Warteschlange betrug das temporäre Fenster 40 Millisekunden, in dem die Aufgaben ihre Arbeit abgeschlossen haben.
Die Umsetzung von MLFQ im Betriebssystem Solaris ist eine Klasse von zeitscheibenden Scheduler.
Der Scheduler bietet eine Reihe von Tabellen an, die genau definieren, wie sich die Priorität eines Prozesses im Laufe
seines Lebens ändern sollte, wie groß das zugeteilte Fenster sein sollte und wie oft die Prioritäten
einer Aufgabe erhöht werden müssen. Der Systemadministrator
kann mit dieser Tabelle interagieren und den Scheduler dazu bringen, sich
anders zu verhalten. Standardmäßig enthält diese Tabelle 60 Warteschlangen mit schrittweise zunehmender
Fenstergröße von 20 ms (hohe Priorität) bis mehrere Hundert ms (niedrige Priorität), und
auch mit Boost für alle Aufgaben einmal pro Sekunde.
Andere MLFQ-Planer verwenden keine Tabelle oder spezifische
Regeln, die in dieser Vorlesung beschrieben sind, sondern berechnen Prioritäten unter Verwendung
mathematischer Formeln. So verwendet beispielsweise der Planer in FreeBSD eine Formel zur
Berechnung der aktuellen Priorität einer Aufgabe, basierend darauf, wie viel der Prozess
CPU verwendet hat. Darüber hinaus verrottet die CPU-Nutzung im Laufe der Zeit, und somit
geschieht die Prioritätensteigerung etwas anders, als oben beschrieben. Dies sind die
sogenannten Abklingalgorithmen. Seit Version 7.1 wird in FreeBSD der ULE-Planer verwendet.
Schließlich haben viele Planer andere Besonderheiten. Zum Beispiel reservieren einige
Planer die höchsten Ebenen für das Betriebssystem, sodass kein Benutzerprozess die höchste
Priorität im System erhalten kann. Einige Systeme ermöglichen es, Hinweise zu geben, um
dem Planer zu helfen, Prioritäten korrekt festzulegen. So kann man beispielsweise mit dem Befehl
die Priorität einer Aufgabe erhöhen oder verringern und damit die Chancen des Programms auf Zeit nice
auf der CPU erhöhen oder senken.
MLFQ: Ergebnisse
Wir haben einen Ansatz zur Planung beschrieben, der MLFQ genannt wird. Sein Name
entspricht dem Prinzip seiner Arbeitsweise – er hat mehrere Warteschlangen und nutzt Feedback
zur Bestimmung der Priorität einer Aufgabe.
Die endgültige Form der Regeln wird wie folgt sein:
Regel 1
- : Wenn Priorität(A) > Priorität(B), wird Aufgabe A gestartet (B nicht)Regel 2
- : Wenn Priorität(A) = Priorität(B), werden A und B mit RR gestartetRegel 3
- : Wenn eine Aufgabe ins System kommt, wird sie in die Warteschlange mit der höchsten Priorität gelegt.MLFQ ist aus folgendem Grund interessant – anstatt im Voraus Wissen über
- Regel4: Nachdem eine Aufgabe die ihr zugewiesene Zeit in der aktuellen Warteschlange aufgebraucht hat (unabhängig davon, wie oft sie die CPU freigegeben hat), wird die Priorität dieser Aufgabe gesenkt (sie bewegt sich weiter unten in der Warteschlange).
- Unser neues Regelwerk löst sofort zwei Probleme. Erstens, Prozesseverhungern garantiert nicht: Aufgaben, die sich in der höheren Warteschlange befinden, werden die
die Natur der Aufgabe zu verlangen, lernt der Algorithmus aus dem bisherigen Verhalten der Aufgabe und legt
die Prioritäten entsprechend fest. So versucht er, gleichzeitig zwei Stühle zu besetzen – sowohl Leistung für kurze Aufgaben (SJF, STCF) zu erreichen als auch fair lange,
CPU-intensive Aufgaben zu starten. Deshalb verwenden viele Systeme, einschließlich BSD und ihrer Derivate,
Solaris, Windows, Mac eine gewisse Form des MLFQ-Algorithmus als grundlegende Grundlage.
manpages.debian.org/stretch/manpages/sched.7.en.html
en.wikipedia.org/wiki/Scheduling_
Zusätzliche Materialien:
- (computing)
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish