

In Linux gibt es eine große Anzahl von Tools zur Fehlerbehebung in Kernel und Anwendungen. Die meisten von ihnen wirken sich negativ auf die Anwendungsleistung aus und können nicht in der Produktion verwendet werden.
Vor ein paar Jahren wurde — eBPF. Es ermöglicht, den Kernel und Benutzeranwendungen mit geringem Overhead zu tracen, ohne Programme neu kompilieren oder externe Module in den Kernel laden zu müssen.
Heute gibt es bereits zahlreiche Anwendungsprogramme, die eBPF nutzen. In diesem Artikel werden wir untersuchen, wie man ein eigenes Profiling-Tool auf Basis der Bibliothek schreibt. Der Artikel basiert auf realen Ereignissen. Wir werden den Weg vom Auftreten des Problems bis zu seiner Behebung nachvollziehen, um zu zeigen, wie bestehende Werkzeuge in konkreten Situationen eingesetzt werden können.
Ceph ist langsam
Ein neuer Host wurde zum Ceph-Cluster hinzugefügt. Nach der Migration eines Teils der Daten auf ihn bemerkten wir, dass die Schreibgeschwindigkeit für Anfragen dort viel niedriger war als auf anderen Servern.
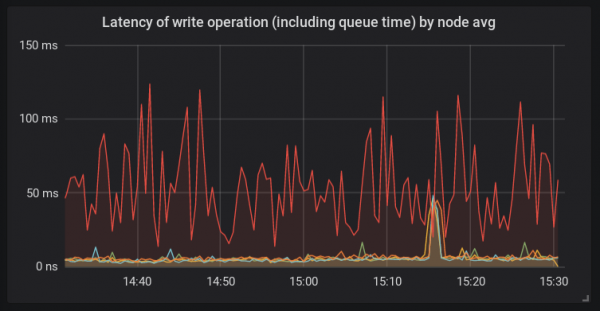
Im Gegensatz zu anderen Plattformen verwendete dieser Host bcache und den neuen Linux-Kernel 4.15. Ein Host mit dieser Konfiguration wurde hier zum ersten Mal eingesetzt. Zu diesem Zeitpunkt war klar, dass theoretisch alles der Ursprung des Problems sein könnte.
Untersuchung des Hosts
Lass uns zunächst einen Blick darauf werfen, was im Prozess ceph-osd passiert. Dazu verwenden wir und (nähere Informationen dazu finden Sie ):
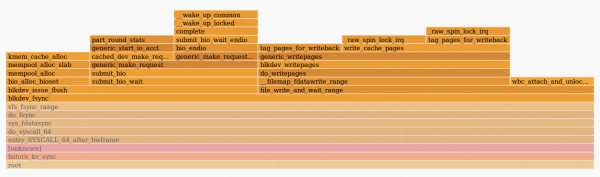
Das Bild zeigt uns, dass die Funktion fdatasync() viel Zeit für das Senden der Anfrage in der Funktion generic_make_request()benötigte. Das bedeutet, dass die Ursache der Probleme wahrscheinlich außerhalb des OSD-Daemons liegt. Das könnte entweder der Kernel oder die Festplatten sein. Der iostat-Ausgang zeigte hohe Verzögerungen bei der Verarbeitung von Anfragen an bcache-Festplatten.
Bei der Überprüfung des Hosts stellten wir fest, dass der Daemon systemd-udevd viel CPU-Zeit verbraucht — etwa 20 % auf mehreren Kernen. Dieses seltsame Verhalten erfordert eine Untersuchung der Ursache. Da systemd-udevd mit uevents arbeitet, entschieden wir uns, diese über udevadm monitorzu betrachten. Es stellte sich heraus, dass eine große Anzahl von Change-Ereignissen für jedes Blockgerät im System generiert wurde. Das ist ziemlich ungewöhnlich, also müssen wir herausfinden, was all diese Events erzeugt.
Verwendung des BCC-Toolkits
Wie wir bereits festgestellt haben, benötigt der Kernel (und der ceph-Daemon beim Systemaufruf) viel Zeit in generic_make_request(). Lassen Sie uns die Leistung dieser Funktion messen. In gibt es bereits ein hervorragendes Werkzeug — funclatency. Wir werden den Demon anhand seiner PID mit einem Intervall von 1 Sekunde zwischen den Ausgaben verfolgen und das Ergebnis in Millisekunden anzeigen.
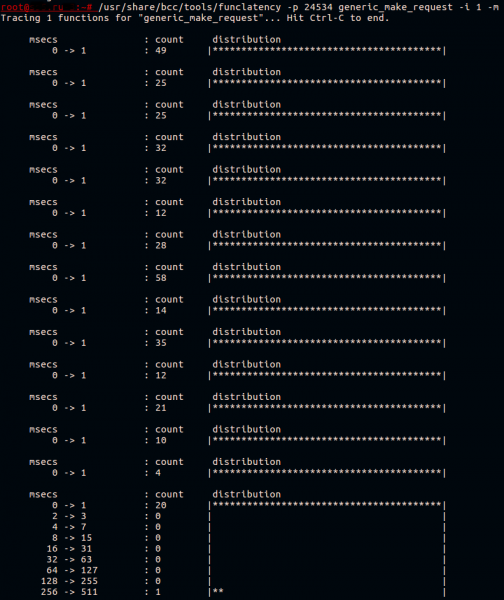
Normalerweise funktioniert diese Funktion schnell. Alles, was sie tut, ist, die Anfrage in die Warteschlange des Gerätetreibers zu übermitteln.
Bcache ist ein komplexes Gerät, das tatsächlich aus drei Festplatten besteht:
- backing device (cachierbare Festplatte), in diesem Fall eine langsame HDD;
- caching device (cachierende Festplatte), hier ist es eine Partition des NVMe-Geräts;
- ein virtuelles Gerät von bcache, mit dem die Anwendung arbeitet.
Wir wissen, dass die Anfrageübermittlung stagniert, aber bei welchem dieser Geräte? Lassen Sie uns das später klären.
Derzeit wissen wir, dass die ueventen wahrscheinlich zu Problemen führen. Es ist nicht so einfach herauszufinden, was genau ihre Generierung verursacht. Nehmen wir an, es handelt sich um eine Software, die periodisch ausgeführt wird. Lassen Sie uns mit dem Skript execsnoop aus demselben . Lassen Sie es uns ausführen und die Ausgabe in eine Datei umleiten.
Zum Beispiel so:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Wir werden hier nicht die gesamte Ausgabe von execsnoop angeben, aber eine interessante Zeile sah so aus:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
Die dritte Spalte ist die PPID (Eltern-PID) des Prozesses. Der Prozess mit der PID 5802 war einer der Threads unseres Überwachungssystems. Bei der Überprüfung der Konfiguration des Überwachungssystems wurden fehlerhaft festgelegte Parameter gefunden. Die Temperatur des HBA-Adapters wurde alle 30 Sekunden erfasst, was viel häufiger war, als nötig. Nach der Änderung des Prüfintervalls auf längere Zeit stellten wir fest, dass die Verzögerung bei der Verarbeitung von Anfragen auf diesem Host nicht mehr im Vergleich zu anderen Hosts auffiel.
Aber es ist immer noch unklar, warum das bcache-Gerät so verzögert hat. Wir haben eine Testplattform mit identischer Konfiguration vorbereitet und versucht, das Problem nachzustellen, indem wir fio auf bcache ausgeführt haben und periodisch udevadm trigger für die Generierung von uevents ausgeführt haben.
Writing BCC-Based Tools
Wir werden versuchen, ein einfaches Dienstprogramm zum Nachverfolgen und Anzeigen der langsamsten Aufrufe zu schreiben. generic_make_request()Wir interessieren uns auch für den Namen der Festplatte, für die diese Funktion aufgerufen wurde.
Der Plan ist einfach:
- Registrieren wir kprobe auf generic_make_request():
- Wir speichern den Namen des Festplatten, der über das Argument der Funktion verfügbar ist;
- Wir speichern den Zeitstempel.
- Registrieren wir kretprobe bei der Rückkehr von generic_make_request():
- Wir erhalten den aktuellen Zeitstempel;
- Wir suchen den gespeicherten Zeitstempel und vergleichen ihn mit dem aktuellen;
- Wenn das Ergebnis größer als festgelegt ist, finden wir den gespeicherten Namen des Laufwerks und geben ihn im Terminal aus.
Kprobes und kretprobes verwenden den Mechanismus von Haltepunkten, um den Funktionscode zur Laufzeit zu ändern. Sie können und Artikel zu diesem Thema lesen. Wenn Sie sich den Code verschiedener Dienstprogramme in , ansehen, werden Sie feststellen, dass sie eine identische Struktur haben. Daher werden wir in diesem Artikel das Parsen der Skriptargumente überspringen und uns der eigentlichen BPF-Programmierarbeit widmen.
Der eBPF-Text innerhalb des Python-Skripts sieht wie folgt aus:
bpf_text = “”” # Hier wird der BPF-Programmiercode sein “””
Für den Datenaustausch zwischen Funktionen verwenden eBPF-Programme . Das werden wir auch tun. Als Schlüssel verwenden wir die PID des Prozesses und definieren als Wert die Struktur:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Hier registrieren wir eine Hash-Tabelle, die genannt wird p, mit einem Schlüssel vom Typ u64 und einem Wert vom Typ struct data_t. Die Tabelle wird im Kontext unseres BPF-Programms verfügbar sein. Das Makro BPF_PERF_OUTPUT registriert eine andere Tabelle, die genannt wird events, die verwendet wird, um an den Benutzerspeicher zu übertragen.
Bei der Messung von Verzögerungen zwischen dem Aufruf einer Funktion und ihrer Rückkehr oder zwischen den Aufrufen verschiedener Funktionen muss berücksichtigt werden, dass die erhaltenen Daten demselben Kontext angehören müssen. Mit anderen Worten, es ist wichtig, mögliche parallele Ausführungen von Funktionen zu berücksichtigen. Wir haben die Möglichkeit, die Verzögerung zwischen dem Aufruf einer Funktion im Kontext eines Prozesses und der Rückkehr aus dieser Funktion im Kontext eines anderen Prozesses zu messen, was jedoch wahrscheinlich wenig nützlich ist. Ein gutes Beispiel dafür ist , bei dem der Schlüssel der Hash-Tabelle auf einen Zeiger auf struct requestzeigt, der eine einzelne Anfrage an das Laufwerk darstellt.
Als Nächstes müssen wir den Code schreiben, der bei dem Aufruf der untersuchten Funktion ausgeführt wird:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Hier wird als zweites Argument das erste Argument der aufgerufenen Funktion eingesetzt . Danach erhalten wir die PID des Prozesses, in dem wir arbeiten, und den aktuellen Zeitstempel in Nanosekunden. Wir speichern all dies in der neu allokierten struct data_t data. Den Namen des Laufwerks erhalten wir aus der Struktur. bio, die beim Aufruf übergeben wird generic_make_request(), und speichern es in derselben Struktur data. Der letzte Schritt besteht darin, einen Eintrag in die zuvor erwähnte Hashtabelle hinzuzufügen.
void stop(struct pt_regs *ctx) { u64 pid = bpf_get_current_pid_tgid(); u64 ts = bpf_ktime_get_ns(); struct data_t* data = p.lookup(&pid); if (data != 0 && data->ts > 0) { bpf_get_current_comm(&data->comm, sizeof(data->comm)); data->lat = (ts - data->ts)/1000; if (data->lat > MIN_US) { FACTOR data->pid >>= 32; events.perf_submit(ctx, data, sizeof(struct data_t)); } p.delete(&pid); } } generic_make_request():
Diese Funktion ähnelt der vorherigen: Wir ermitteln die PID des Prozesses und den Zeitstempel, aber wir reservieren keinen Speicher für eine neue Datenstruktur. Stattdessen suchen wir in der Hashtabelle nach einer bereits vorhandenen Struktur anhand des Schlüssels == aktuelle PID. Wenn die Struktur gefunden wird, erfahren wir den Namen des laufenden Prozesses und fügen ihn hinzu.
Der binäre Schub, den wir hier verwenden, dient dazu, die Thread-GID zu erhalten, d.h. die PID des Hauptprozesses, der den Thread gestartet hat, in dessen Kontext wir arbeiten. Die von uns aufgerufene Funktion
bpf_get_current_pid_tgid() Bei der Ausgabe im Terminal interessiert uns jetzt nicht der Thread, sondern der Hauptprozess. Nach dem Vergleich der erhaltenen Verzögerung mit dem festgelegten Schwellenwert übergeben wir unsere Struktur
in den Benutzerspeicher über die Tabelle data , danach löschen wir den Eintrag aus eventsIm Python-Skript, das diesen Code laden wird, müssen wir MIN_US und FACTOR durch die Verzögerungsschwellenwerte und Zeit-Einheiten ersetzen, die wir über Argumente übergeben werden: p.
bpf_text = bpf_text.replace('MIN_US',str(min_usec)) if args.milliseconds: bpf_text = bpf_text.replace('FACTOR','data->lat /= 1000;') label = "msec" else: bpf_text = bpf_text.replace('FACTOR','') label = "usec"
Jetzt müssen wir das BPF-Programm über
das BPF-Makro b = BPF(text=bpf_text) b.attach_kprobe(event="generic_make_request",fn_name="start") b.attach_kretprobe(event="generic_make_request",fn_name="stop")
Außerdem müssen wir definieren
in unserem Skript, sonst können wir nichts lesen: struct data_t TASK_COMM_LEN = 16 # linux/sched.h DISK_NAME_LEN = 32 # linux/genhd.h class Data(ct.Structure): _fields_ = [("pid", ct.c_ulonglong), ("ts", ct.c_ulonglong), ("comm", ct.c_char * TASK_COMM_LEN), ("lat", ct.c_ulonglong), ("disk", ct.c_char * DISK_NAME_LEN)]
Der letzte Schritt – die Ausgabe der Daten im Terminal:
Der letzte Schritt ist die Ausgabe der Daten auf das Terminal:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# Ausgabe formatieren
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Das Skript ist verfügbar auf . Lassen Sie uns versuchen, es auf einer Testplattform auszuführen, auf der fio läuft, das auf bcache schreibt, und udevadm monitor aufzurufen:
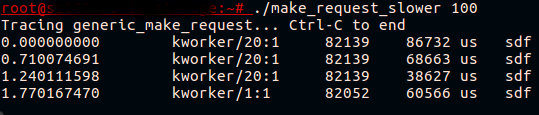
Endlich! Jetzt sehen wir, dass das, was wie ein störendes bcache-Gerät aussah, tatsächlich ein störender Aufruf ist generic_make_request() für die zwischengespeicherte Festplatte.
Eintauchen in den Kernel
Was genau verlangsamt die Anfrage? Wir sehen, dass die Verzögerung sogar vor dem Beginn der Anfrageverarbeitung auftritt, d.h. die spezifische Anfrage zur weiteren Ausgabe von Statistiken ( /proc/diskstats oder iostat) noch nicht erfasst wurde. Dies lässt sich leicht überprüfen, indem man iostat während der Reproduktion des Problems ausführt, oder , das auf dem Beginn und Ende der Anfrageverarbeitung basiert. Keine dieser Utilities wird Probleme für Anfragen an die zwischengespeicherte Festplatte anzeigen.
Wenn wir uns die Funktion ansehen generic_make_request(), sehen wir, dass vor Beginn der Anfrageverarbeitung noch zwei andere Funktionen aufgerufen werden. Die erste — generic_make_request_checks(), führt Überprüfungen der Anfragetauglichkeit in Bezug auf die Festplatteneinstellungen durch. Die zweite — , beinhaltet einen interessanten Aufruf :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
Hier wartet der Kernel auf das Auftauen der Warteschlange. Messen wir die Verzögerung blk_queue_enter():
~# /usr/share/bcc/tools/funclatency  blk_queue_enter -i 1 -m
Verfolgen von 1 Funktionen für "blk_queue_enter"... Drücken Sie Strg-C, um zu beenden.

 	msecs           	: Anzahl 	Verteilung
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: Anzahl 	Verteilung
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: Anzahl 	Verteilung
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Es scheint, dass wir der Lösung nahe sind. Die Funktionen, die zum "Einfrieren/Auftauen" der Warteschlange verwendet werden, sind und . Sie werden verwendet, wenn Änderungen an den Anfragesettings erforderlich sind, die potenziell gefährlich für die Anfragen in dieser Warteschlange sind. Bei einem Aufruf von blk_mq_freeze_queue() wird durch die Funktion der Zähler q->mq_freeze_depth inkrementiert.. Nach dem wartet der Kernel darauf, dass die Warteschlange in .
Die Wartezeit für das Leeren dieser Warteschlange entspricht der Verzögerung des Datenträgers, da der Kernel auf den Abschluss aller eingereihten Operationen wartet. Sobald die Warteschlange leer ist, werden die Einstellungen angewendet. Danach wird , was den Zähler freeze_depth.
Jetzt wissen wir genug, um die Situation zu beheben. Der Befehl udevadm trigger führt dazu, dass die Einstellungen für das Blockgerät angewendet werden. Diese Einstellungen sind in den udev-Regeln beschrieben. Wir können herausfinden, welche spezifischen Einstellungen die Warteschlange „einfrieren“, indem wir versuchen, sie über sysfs zu ändern oder den Quellcode des Kernels zu prüfen. Außerdem können wir das BCC-Tool verwenden, , das die Kern- und Benutzerspace-Stack-Traces für jeden Aufruf von blk_freeze_queue, zum Beispiel:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Udev-Regeln ändern sich ziemlich selten und normalerweise unter kontrollierten Bedingungen. Wir sehen also, dass selbst die Anwendung bereits festgelegter Werte einen Anstieg der Verzögerung bei der Übertragung von Anfragen vom Anwendungsträger verursacht. Es ist natürlich keine gute Praxis, udev-Ereignisse zu generieren, wenn es keine Änderungen in der Datenträgerskonfiguration gibt (z. B. wird das Gerät nicht angeschlossen/getrennt). Dennoch können wir dem Kernel helfen, keine unnötige Arbeit zu verrichten und die Anfragewarteschlange nicht „einzufrieren“, wenn dies nicht erforderlich ist. die Situation zu beheben.
Fazit
eBPF ist ein sehr flexibles und leistungsstarkes Werkzeug. Im Artikel haben wir einen praktischen Anwendungsfall betrachtet und einen kleinen Teil dessen demonstriert, was möglich ist. Wenn Sie an der Entwicklung von BCC-Tools interessiert sind, sollten Sie sich das , das die Grundlagen gut beschreibt, ansehen.
Es gibt auch andere interessante Werkzeuge für das Debugging und Profiling, die auf eBPF basieren. Eines davon ist , das es ermöglicht, leistungsstarke Einzeiler und kleine Programme in einer awk-ähnlichen Sprache zu schreiben. Ein anderes ist , das es ermöglicht, hochauflösende Low-Level-Metriken direkt in Ihren Prometheus-Server zu sammeln, mit der Möglichkeit, später eine ansprechende Visualisierung und sogar Alarme zu erhalten.
Quelle: habr.com
