

Hallo, Habra!
Wir erinnern Sie daran, dass wir einen weiteren äußerst interessanten und nützlichen Artikel über Kubernetes-Pattern veröffentlicht haben. Alles begann mit "" von Brendan Burns, und unsere Arbeit in diesem Bereich ist . Heute möchten wir Ihnen einen Blogartikel von MinIO empfehlen, der die Trends und Besonderheiten der Datenspeicherungs-Patterns in Kubernetes zusammenfasst.
Kubernetes hat die traditionellen Patterns der Anwendungsentwicklung und -bereitstellung grundlegend verändert. Jetzt kann ein Team nur wenige Tage für die Entwicklung, das Testen und die Bereitstellung einer Anwendung benötigen – in verschiedenen Umgebungen, und dies alles innerhalb von Kubernetes-Clustern. Diese Vorgehensweise erforderte in früheren Technologiegenerationen in der Regel mehrere Wochen, wenn nicht Monate.
Diese Beschleunigung wurde durch die Abstraktion, die Kubernetes bietet, ermöglicht – das heißt, Kubernetes selbst verwaltet die Interaktion mit den niedrigstufigen Details physischer oder virtueller Maschinen und ermöglicht den Benutzern, unter anderem den benötigten Prozessor, den benötigten Speicherplatz und die Anzahl der Containerinstanzen anzugeben. Da eine riesige Community von Entwicklern an Kubernetes arbeitet und der Einsatz von Kubernetes ständig zunimmt, führt es deutlich den Markt aller Container-Orchestrierungsplattformen an.
Mit der Ausweitung des Einsatzes von Kubernetes wächst auch die Verwirrung über die darin verwendeten Datenspeicher-Patterns..
In der allgemeinen Konkurrenz um ein Stück vom Kubernetes-Kuchen (d.h. um den Storage) geht die Signalwirkung beim Thema Datenspeicherung in der lauten Geräuschkulisse unter.
Kubernetes verkörpert ein modernes Modell der Anwendungsentwicklung und -bereitstellung sowie deren Verwaltung. Dieses moderne Modell trennt die Datenspeicherung von der Berechnung. Um dieses Abtrennen im Kontext von Kubernetes vollständig zu verstehen, muss man auch verstehen, was Anwendungen sind, die zustandsbehaftet und zustandslos sind, und wie die Datenspeicherung damit zusammenhängt. Hier hat der REST-API-Ansatz, der von S3 verwendet wird, klare Vorteile gegenüber dem POSIX/CSI-Ansatz, der typischerweise für andere Lösungen charakteristisch ist.
In diesem Artikel sprechen wir über die Datenhaltungsmuster in Kubernetes und beleuchten insbesondere den Streit zwischen zustandsbehafteten und zustandslosen Anwendungen, um besser zu verstehen, worin der Unterschied zwischen ihnen besteht und warum dieser wichtig ist. Im weiteren Verlauf des Textes werden Anwendungen und die in ihnen verwendeten Datenhaltungsmuster im Kontext der besten Praktiken für den Umgang mit Containern und Kubernetes behandelt.
Zustandslose Container
Container sind per Definition leichtgewichtig und vergänglich. Sie können problemlos gestoppt, gelöscht oder auf einem anderen Knoten bereitgestellt werden – das alles dauert nur wenige Sekunden. In einem großen Containerorchestrierungssystem finden solche Vorgänge ständig statt, und die Benutzer bemerken diese Änderungen oft nicht einmal. Allerdings sind solche Bewegungen nur möglich, wenn der Container keine Abhängigkeiten von dem Knoten hat, auf dem er sich befindet. Solche Container bezeichnet man als zustandslos.
Zustandsbehaftete Container
Wenn ein Container Daten auf lokal angeschlossenen Geräten (oder auf einem Blockgerät) speichert, muss der Datenspeicher, auf dem er sich befindet, im Falle eines Fehlers zusammen mit dem Container auf einen neuen Knoten verschoben werden. Das ist wichtig, da andernfalls die Anwendung, die im Container läuft, nicht korrekt funktionieren kann, da sie auf die Daten zugreifen muss, die auf den lokalen Speichermedien gespeichert sind. Solche Container werden als zustandsbehaftet.
Aus rein technischer Sicht können auch zustandsbehaftete Container auf andere Knoten verschoben werden. Dies geschieht normalerweise mithilfe von verteilten Dateisystemen oder blockbasierten Netzwerkspeichern, die an allen Knoten, auf denen Container betrieben werden, angeschlossen sind. Auf diese Weise erhalten Container Zugriff auf Volumes für persistente Datenhaltung, und die Informationen werden auf Festplatten gespeichert, die im gesamten Netzwerk verteilt sind. Diese Methode nenne ich "zustandsbehafteter Containeransatz", und im weiteren Verlauf des Artikels werde ich ihn der Einheitlichkeit halber so bezeichnen.
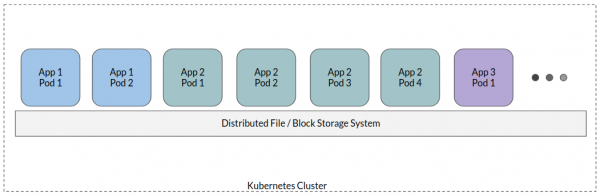
Bei einem typischen containerbasierten Ansatz mit Speicherung des Zustands werden alle Anwendungspods an ein einziges verteiltes Dateisystem angeheftet – es entsteht eine Art gemeinsamer Speicher, in dem alle Anwendungsdaten gesammelt werden. Obwohl einige Variationen möglich sind, handelt es sich hierbei um einen hochgradig abstrahierten Ansatz.
Lassen Sie uns nun verstehen, warum der containerbasierte Ansatz mit Speicherung des Zustands in einer cloudorientierten Welt ein Antipattern ist.
Cloud-orientiertes Anwendungsdesign
Traditionell verwendeten Anwendungen Datenbanken für die strukturierte Speicherung von Informationen sowie lokale Festplatten oder verteilte Dateisysteme, in die alle unstrukturierten oder sogar halbstrukturierten Daten abgelegt wurden. Als die Menge an unstrukturierten Daten zunahm, erkannten die Entwickler, dass POSIX zu „gesprächig“ war, erhebliche Kosten verursachte und letztendlich die Leistung der Anwendung bei echt großen Skalierungen beeinträchtigte.
Dies trug im Wesentlichen zur Schaffung eines neuen Standards für die Datenspeicherung bei, nämlich cloudorientierter Speichersysteme, die überwiegend auf REST-APIs basieren und die Anwendung von der lästigen Wartung lokaler Datenspeicher befreien. In einem solchen Fall funktioniert die Anwendung faktisch im Modus ohne Speicherung des Zustands (da der Zustand im entfernten Speicher liegt). Moderne Anwendungen werden von Grund auf unter Berücksichtigung dieses Faktors entwickelt. In der Regel basiert jede moderne Anwendung, die Daten irgendeiner Art verarbeitet (Protokolle, Metadaten, Blobs usw.), auf der cloudorientierten Paradigmen, bei der der Zustand in ein speziell dafür vorgesehenes Softwaresystem verschoben wird.
Der containerbasierte Ansatz mit Speicherung des Zustands zwingt dieses gesamte Paradigma, genau zu dem zurückzukehren, von dem es ursprünglich ausgegangen ist!
Bei der Verwendung von POSIX-Schnittstellen zur Speicherung von Daten verhält sich die Anwendung genau so, als ob sie den Zustand speichert, wodurch sie von den wichtigsten Grundsätzen des Cloud-orientierten Designs abweicht, nämlich von der Möglichkeit, die Größe der Arbeitsströme der Anwendung je nach eingehender Last zu variieren, zu einem neuen Knoten zu migrieren, sobald der aktuelle Knoten ausfällt, und so weiter.
Wenn wir diese Situation genauer betrachten, stellen wir fest, dass wir bei der Wahl des Datenspeichers immer wieder mit dem Dilemma „POSIX gegen REST API“ konfrontiert sind, wobei sich die Probleme von POSIX durch die verteilte Natur von Kubernetes-Umgebungen zusätzlich verschärfen. Insbesondere
- POSIX redselig: Die Semantik von POSIX erfordert, dass jeder Operation Metadaten und Dateideskriptoren zugeordnet werden, die helfen, den Zustand der Operation aufrechtzuerhalten. Dies führt zu erheblichen Kosten, die keinerlei echten Wert haben. APIs für die Objektspeicherung, insbesondere das S3-API, haben diese Anforderungen abgeschafft, wodurch die Anwendung arbeiten und dann „vergessen“ kann, dass der Aufruf stattgefunden hat. Die Antwort des Speichersystems zeigt an, ob die Aktion erfolgreich war oder nicht. Im Falle eines Fehlers kann die Anwendung einen neuen Versuch durchführen.
- Netzwerkeinschränkungen: In einem verteilten System wird angenommen, dass es mehrere Anwendungen geben kann, die versuchen, Daten auf dasselbe angehängte Medium zu schreiben. Daher konkurrieren die Anwendungen nicht nur um die Bandbreite, um Daten auf das Medium zu übertragen, sondern auch das Speichersystem wird um diese Bandbreite konkurrieren, indem es Daten über physische Laufwerke verteilt. Aufgrund der Redseligkeit von POSIX steigt die Anzahl der Netzwerkaufrufe um ein Vielfaches. Andererseits bietet das S3-API eine klare Trennung zwischen den Netzwerkaufrufen, die von dem Client an den Server gehen, und denen, die innerhalb des Servers stattfinden.
- Sicherheit: Das POSIX-Sicherheitsmodell basiert auf der aktiven Teilnahme des Menschen: Administratoren konfigurieren spezifische Zugriffslevels für jeden Benutzer oder jede Gruppe. Dieses Paradigma ist schwer an die cloud-orientierte Welt anzupassen. Moderne Anwendungen hängen von Sicherheitsmodellen ab, die an APIs gebunden sind, wo Zugriffsrechte als eine Sammlung von Richtlinien definiert, Servicekonten zugewiesen und temporäre Anmeldeinformationen bereitgestellt werden.
- Verwaltbarkeit: Zustandsbehaftete Container bringen bestimmte Verwaltungskosten mit sich. Es geht um die Synchronisierung des parallelen Zugriffs auf Daten und die Gewährleistung der Datenkonsistenz; all dies erfordert eine sorgfältige Abwägung, welche Zugriffsmuster für Daten verwendet werden sollten. Es ist notwendig, zusätzliche Programme zu installieren, zu überwachen und zu konfigurieren, ganz zu schweigen von dem zusätzlichen Aufwand, der in die Entwicklung investiert werden muss.
Container-Speicher-Interface
Während das Container Storage Interface (CSI) hervorragend zur Verbreitung der Kubernetes-Volume-Ebene beigetragen hat, indem es zum Teil an Drittanbieter von Speichersystemen übergeben wurde, hat es auch unbeabsichtigt den Glauben verstärkt, dass der zustandsbehaftete Containeransatz die empfohlene Methode zur Datenspeicherung in Kubernetes darstellt.
CSI wurde als Standard zur Bereitstellung beliebiger Block- und Dateispeichersysteme für veraltete Anwendungen bei der Arbeit mit Kubernetes entwickelt. Und, wie in diesem Artikel gezeigt, ist die einzige Situation, in der der zustandsbehaftete Containeransatz (und CSI in seiner derzeitigen Form) sinnvoll ist, wenn die Anwendung selbst ein veraltetes System ist, dem es nicht möglich ist, Unterstützung für API-basierte Objektspeichersysteme hinzuzufügen.
Es ist wichtig zu verstehen, dass die Verwendung von CSI in seiner aktuellen Form, das heißt das Einbinden von Volumes in modernen Anwendungen, mit denselben Problemen konfrontiert sein wird wie Systeme, in denen die Datenspeicherung im POSIX-Stil organisiert ist.
Ein qualitativ hochwertigerer Ansatz
In diesem Fall ist es wichtig zu verstehen, dass die meisten Anwendungen im Grunde genommen nicht auf die Arbeit mit stateful oder stateless optimiert sind. Dieses Verhalten hängt von der allgemeinen Systemarchitektur und von den spezifischen Optionen ab, die während der Planung gewählt wurden. Lassen Sie uns ein wenig über stateful Anwendungen sprechen.
Im Prinzip können alle Anwendungsdaten in mehrere weitreichende Typen unterteilt werden:
- Protokolldaten
- Zeitstempeldaten
- Transaktionsdaten
- Metadaten
- Container-Images
- Blob-Daten (große Binärobjekte)
All diese Datentypen werden auf modernen Datenplattformen sehr gut unterstützt, und es gibt mehrere cloud-orientierte Plattformen, die angepasst sind, um Daten in jedem dieser spezifischen Formate bereitzustellen. Zum Beispiel können Transaktionsdaten und Metadaten in einer modernen cloud-orientierten Datenbank wie CockroachDB, YugaByte usw. gespeichert werden. Container-Images oder Blob-Daten können in einem Docker-Registry, basierend auf MinIO, abgelegt werden. Zeitstempeldaten können in einer Zeitreihendatenbank wie InfluxDB usw. gespeichert werden. Lassen Sie uns hier nicht in die Einzelheiten jedes Datentyps und der entsprechenden Anwendungen vertiefen, aber die allgemeine Idee besteht darin, persistenten Datenspeicher auf lokales Disk-Mounting zu vermeiden.
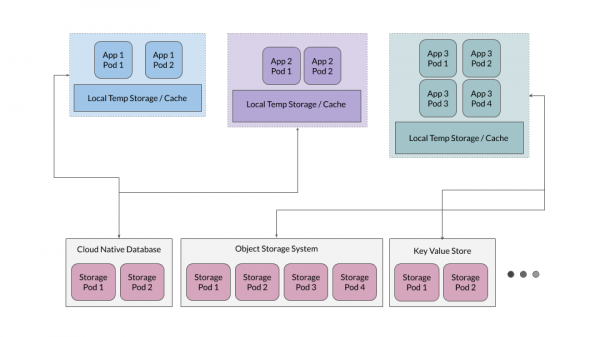
Darüber hinaus erweist es sich häufig als effektiv, eine temporäre Cache-Ebene bereitzustellen, die als eine Art temporäres Dateispeicher für Anwendungen dient, wobei diese Ebene nicht als Quelle der Wahrheit betrachtet werden sollte.
Speicher für stateful Anwendungen
Während es in den meisten Fällen nützlich ist, Anwendungen stateless zu halten, sollten stateful Anwendungen, die auf die Datenspeicherung ausgelegt sind – wie Datenbanken, Objekt-Storage, Schlüssel-Wert-Stores – ihren Status bewahren. Lassen Sie uns untersuchen, warum diese Anwendungen auf Kubernetes bereitgestellt werden. Nehmen wir MinIO als Beispiel, aber ähnliche Prinzipien sind auch auf andere große cloud-orientierte Datenspeichersysteme anwendbar.
Cloud-orientierte Anwendungen werden mit dem Ziel entworfen, die Flexibilität von Containern maximal effizient zu nutzen. Das bedeutet, dass keine Annahmen über die Umgebung getroffen werden, in der sie bereitgestellt werden. Zum Beispiel verwendet MinIO einen internen Mechanismus zur Redundanzkodierung (erasure coding), der dem System ausreichend Stabilität verleiht, sodass es auch bei einem Ausfall der Hälfte der Festplatten funktionsfähig bleibt. Außerdem verwaltet MinIO die Integrität und Sicherheit der Daten, indem es eigenes Hashing und Verschlüsselung auf der Serverseite verwendet.
Für solche cloud-orientierten Anwendungen sind lokale persistente Volumes (PV) als Backup-Speicher am praktischsten. Ein lokales PV bietet die Möglichkeit, rohe Daten zu speichern, während die Anwendungen, die auf diesen PV arbeiten, selbst Informationen sammeln, die eine Skalierung der Daten ermöglichen und die wachsenden Datenanforderungen verwalten.
Dieser Ansatz ist wesentlich einfacher und skalierbarer im Vergleich zu PVs auf Basis von CSI, die eigene Ebenen der Datenverwaltung und Redundanz in das System einführen; das Problem ist, dass diese Ebenen in der Regel mit Anwendungen in Konflikt stehen, die nach dem Prinzip der Zustandsbewahrung entworfen wurden.
Der entschlossene Fortschritt in Richtung der Entkopplung von Daten und Berechnungen
In diesem Artikel haben wir erörtert, wie Anwendungen umgeschichtet werden, um ohne Zustandsbewahrung zu arbeiten, oder anders gesagt, wie die Datenspeicherung von den Berechnungen getrennt wird. Zum Schluss betrachten wir einige reale Beispiele für diesen Trend.
, die bekannte Plattform zur Datenanalyse, wurde traditionell mit Zustandsbewahrung und Deployment im HDFS-Dateisystem verwendet. Mit dem Übergang von Spark in die cloud-orientierte Welt wird diese Plattform zunehmend ohne Zustandsbewahrung mit `s3a` verwendet. Spark nutzt s3a, um den Zustand in andere Systeme zu übertragen, während die Spark-Container vollständig ohne Zustandsbewahrung arbeiten. Auch andere große Unternehmen im Bereich der Big Data-Analyse, insbesondere , , , wechseln ebenfalls zur Arbeit mit der Aufteilung von Datenspeicherung und Berechnungen.
Ähnliche Muster sind auch auf anderen großen Analyseplattformen wie Presto, Tensorflow für R und Jupyter zu beobachten. Durch das Exportieren von Daten in entfernte Cloud-Speichersysteme wird es viel einfacher, Ihre Anwendung zu verwalten und zu skalieren. Darüber hinaus fördert dies die Portabilität der Anwendung in verschiedene Umgebungen.
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish