

Vor einem halben Jahr — ein öffentlicher für PostgreSQL.
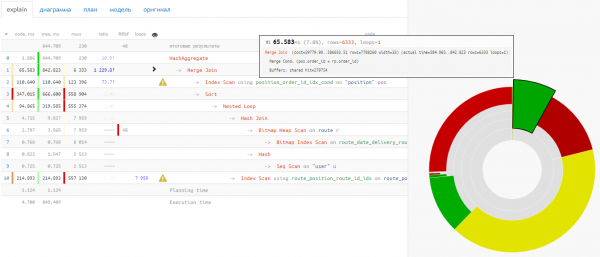
In den vergangenen Monaten haben wir einen Bericht darüber erstellt , eine zusammenfassende basierend auf den Empfehlungen, die er ausgibt… aber das Wichtigste ist, dass wir Ihr Feedback gesammelt und die realen Anwendungsfälle beobachtet haben.
Und jetzt sind wir bereit, über die neuen Möglichkeiten zu berichten, die Sie nutzen können.
Unterstützung verschiedener Planformate
Plan aus dem Log, zusammen mit der Abfrage
Markieren Sie direkt in der Konsole den gesamten Block, beginnend mit der Zeile mit Query Text, mit allen führenden Leerzeichen:
        Query Text: INSERT INTO dicquery_20200604 VALUES ($1.*) ON CONFLICT (query)
                           DO NOTHING;
        Insert on dicquery_20200604 (cost=0.00..0.05 rows=1 width=52) (actual time=40.376..40.376 rows=0 loops=1)
          Conflict Resolution: NOTHING
          Conflict Arbiter Indexes: dicquery_20200604_pkey
          Tuples Inserted: 1
          Conflicting Tuples: 0
          Buffers: shared hit=9 read=1 dirtied=1
          -> Result (cost=0.00..0.05 rows=1 width=52) (actual time=0.001..0.001 rows=1 loops=1)
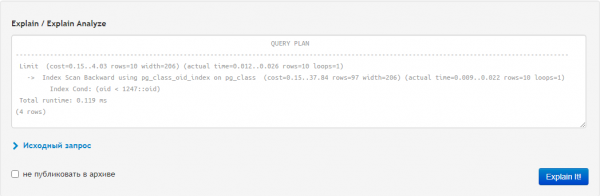
… und fügen alles, was wir kopiert haben, direkt in das Feld für den Plan ein, ohne etwas zu teilen:
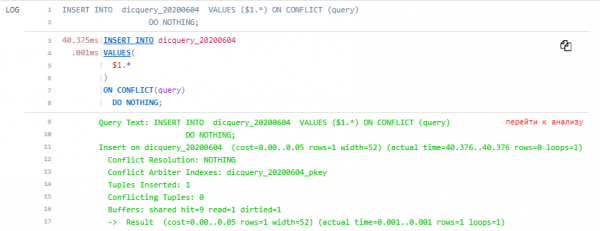
Am Ende erhalten wir zusätzlich zum erläuterten Plan noch den Reiter „Kontext“, wo unsere Anfrage in vollem Glanz präsentiert wird:
JSON und YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM pg_class;
"[
{
"Plan": {
"Node Type": "Seq Scan",
"Parallel Aware": false,
"Relation Name": "pg_class",
"Alias": "pg_class",
"Startup Cost": 0.00,
"Total Cost": 1336.20,
"Plan Rows": 13804,
"Plan Width": 539,
"Actual Startup Time": 0.006,
"Actual Total Time": 1.838,
"Actual Rows": 10266,
"Actual Loops": 1,
"Shared Hit Blocks": 646,
"Shared Read Blocks": 0,
"Shared Dirtied Blocks": 0,
"Shared Written Blocks": 0,
"Local Hit Blocks": 0,
"Local Read Blocks": 0,
"Local Dirtied Blocks": 0,
"Local Written Blocks": 0,
"Temp Read Blocks": 0,
"Temp Written Blocks": 0
},
"Planning Time": 5.135,
"Triggers": [
],
"Execution Time": 2.389
}
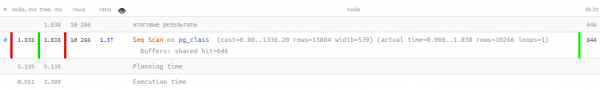
]"Ob mit äußeren Anführungszeichen, wie es pgAdmin kopiert, oder ohne – werfen wir es in dasselbe Feld, am Ende – Schönheit:
Erweiterte Visualisierung
Planungszeit / Ausführungszeit
Jetzt sieht man besser, wo die zusätzliche Zeit bei der Ausführung der Abfrage geblieben ist:
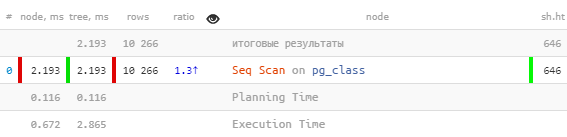
I/O-Zeit
Manchmal muss man mit der Situation umgehen, dass im Plan anscheinend nicht zu viele Ressourcen gelesen oder geschrieben wurden, aber die Ausführungszeit irgendwie unverhältnismäßig groß ist.
Hier muss man sagen: "Oh, wahrscheinlich war der Server in diesem Moment zu stark ausgelastet, deshalb dauerte das Lesen so lange!" Aber irgendwie ist das nicht sehr genau…
Aber man kann das absolut zuverlässig feststellen. Es liegt daran, dass unter den Konfigurationsoptionen des PG-Servers :
Erfasst die Zeit für Ein- und Ausgabeoperationen. Dieser Parameter ist standardmäßig deaktiviert, da es erforderlich ist, ständig die aktuelle Zeit vom Betriebssystem abzufragen, was die Leistung auf einigen Plattformen erheblich verlangsamen kann. Um die Kosten der Zeitmessung auf Ihrer Plattform zu bewerten, können Sie das Dienstprogramm pg_test_timing verwenden. Die Ein-/Ausgabe-Statistiken können über die Ansicht pg_stat_database abgerufen werden, im EXPLAIN-Ausgabe (wenn der Parameter BUFFERS verwendet wird) und über die Ansicht pg_stat_statements.
Dieser Parameter kann auch innerhalb einer lokalen Sitzung aktiviert werden:
SET track_io_timing = TRUE;Nun, das angenehmste — wir haben gelernt, diese Daten zu verstehen und anzuzeigen, unter Berücksichtigung aller Transformationen des Ausführungsbaums:
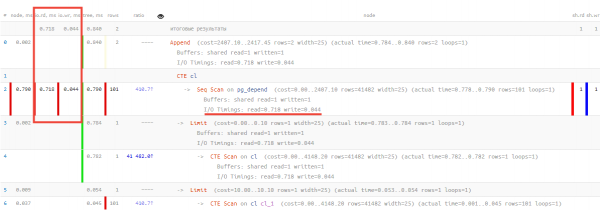
Hier kann man beobachten, dass von 0,790 ms der gesamten Ausführungszeit 0,718 ms für das Lesen einer Seite von Daten benötig wurden, 0,044 ms für das Schreiben derselben und für alle anderen nützlichen Aktivitäten insgesamt nur 0,028 ms aufgewendet wurden!
Die Zukunft mit PostgreSQL 13
Eine vollständige Übersicht über die Neuerungen finden Sie , während wir spezifisch über die Änderungen in der Planung sprechen.
Planung der Puffer
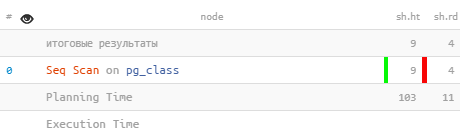
Die Berücksichtigung der Ressourcen, die dem Planner zugewiesen sind, spiegelt sich auch in einem anderen Patch wider, der nicht zu pg_stat_statements gehört. EXPLAIN mit der Option BUFFERS wird die Anzahl der Puffer melden, die in der Planungsphase verwendet wurden:
 Seq Scan auf pg_class (tatsächliche Zeilen=386 Schleifen=1)
   Puffer: gemeinsam Treffer=9 gelesen=4
 Planungszeit: 0.782 ms
   Puffer: gemeinsam Treffer=103 gelesen=11
 Ausführungszeit: 0.219 ms
Inkrementelle Sortierung
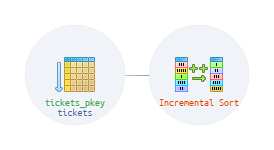
In Fällen, in denen eine Sortierung nach vielen Schlüsseln erforderlich ist (k1, k2, k3…), kann der Planner nun das Wissen nutzen, dass die Daten bereits nach einigen der ersten Schlüssel (z. B. k1 und k2) sortiert sind. In diesem Fall müssen die gesamten Daten nicht erneut sortiert werden, sondern sie können in aufeinanderfolgende Gruppen mit gleichen Werten für k1 und k2 unterteilt und nach dem Schlüssel k3 "nachsortiert" werden.
So zerfällt die gesamte Sortierung in mehrere aufeinanderfolgende Sortierungen kleinerer Größe. Dies reduziert den benötigten Speicherbedarf und ermöglicht es zudem, die ersten Daten früher auszugeben, bevor die gesamte Sortierung vollständig abgeschlossen ist.
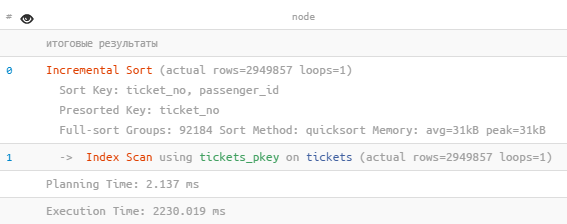
 Inkrementelle Sortierung (tatsächliche Zeilen=2949857 Schleifen=1)
   Sortierschlüssel: ticket_no, passenger_id
   Vorgesortierter Schlüssel: ticket_no
   Vollsortiergruppen: 92184 Sortiermethode: Quicksort Speicher: avg=31kB peak=31kB
   ->  Indexpfadsuche mit tickets_pkey auf tickets (tatsächliche Zeilen=2949857 Schleifen=1)
 Planungszeit: 2.137 ms
 Ausführungszeit: 2230.019 ms
Verbesserungen UI/UX
Screenshots, sie sind überall!
Jetzt gibt es auf jedem Tab die Möglichkeit, schnell einen Screenshot des Tabs in die Zwischenablage zu übernehmen in voller Breite und Tiefe des Tabs – das „Fadenkreuz“ oben rechts:
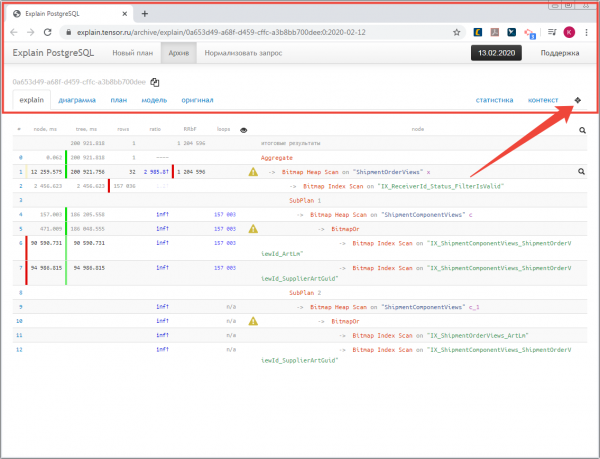
Die meisten Bilder für diese Veröffentlichung wurden tatsächlich auf diese Weise erhalten.
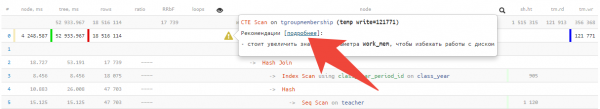
Empfehlungen in den Knoten
Es sind nicht nur mehr geworden, sondern man kann auch über jeden einzelnen , indem man dem Link folgt:
Löschen aus dem Archiv
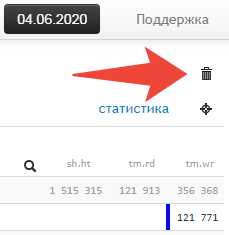
Einige haben dringend gebeten, die Möglichkeit hinzuzufügen, „vollständig“ zu löschen auch nicht veröffentlichte Pläne im Archiv – bitte, es genügt, das entsprechende Symbol zu drücken:
Nun, und vergessen wir nicht, dass wir eine , an die man seine Anmerkungen und Vorschläge schreiben kann.
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish