

Der Effekt der Fragmentierung von Tabellen und Indizes (Bloat) ist weit verbreitet und tritt nicht nur in Postgres auf. Es gibt „out-of-the-box“ Methoden wie VACUUM FULL oder CLUSTER, aber diese sperren Tabellen während des Betriebs, weshalb sie nicht immer verwendet werden können.
Der Artikel enthält etwas Theorie darüber, wie Bloat entsteht, wie man ihm entgegenwirken kann, über deferred constraints und über die Probleme, die sie bei der Verwendung der Erweiterung pg_repack mit sich bringen.
Dieser Artikel basiert auf PgConf.Russia 2020.
Warum entsteht Bloat
Postgres basiert auf einem mehrversionierten Modell (). Der Kernidee ist, dass jede Zeile in einer Tabelle mehrere Versionen haben kann, wobei Transaktionen nicht mehr als eine dieser Versionen sehen, aber nicht unbedingt dieselbe. Dies ermöglicht es mehreren Transaktionen, gleichzeitig zu arbeiten, ohne sich gegenseitig zu beeinflussen.
Es ist offensichtlich, dass all diese Versionen gespeichert werden müssen. Postgres arbeitet seitenweise, und eine Seite ist das kleinste Datenvolumen, das von der Festplatte gelesen oder darauf geschrieben werden kann. Lassen Sie uns ein kleines Beispiel betrachten, um zu verstehen, wie das funktioniert.
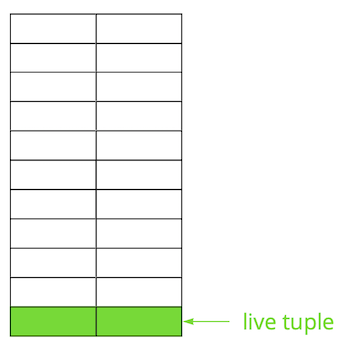
Angenommen, wir haben eine Tabelle, in die wir mehrere Datensätze eingefügt haben. Auf der ersten Seite der Datei, in der die Tabelle gespeichert ist, sind neue Daten hinzugekommen. Das sind die aktuellen Versionen der Zeilen, die nach dem Commit anderen Transaktionen zur Verfügung stehen (zur Vereinfachung nehmen wir an, dass der Isolationsgrad Read Committed ist).
Dann haben wir einen der Datensätze aktualisiert und dadurch die alte Version als obsolet markiert.
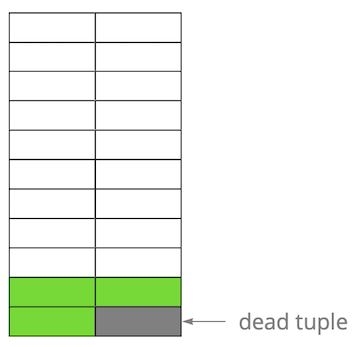
Schritt für Schritt, durch das Aktualisieren und Löschen von Versionen der Zeilen, haben wir eine Seite erhalten, auf der etwa die Hälfte der Daten 'Müll' sind. Diese Daten sind für keine Transaktion sichtbar.
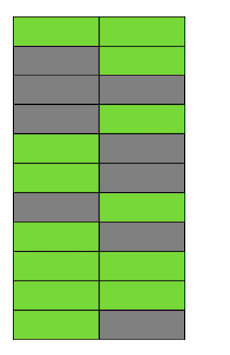
In Postgres gibt es einen Mechanismus , der nicht mehr aktuelle Versionen bereinigt und Platz für neue Daten schafft. Wenn er jedoch nicht aggressiv genug konfiguriert ist oder mit der Arbeit in anderen Tabellen beschäftigt ist, bleiben „Mülldaten“ bestehen und wir müssen zusätzliche Seiten für neue Daten verwenden.
So wird unsere Tabelle in unserem Beispiel zu einem bestimmten Zeitpunkt aus vier Seiten bestehen, aber es werden nur die Hälfte der Daten aktuell sein. Infolgedessen lesen wir beim Zugriff auf die Tabelle viel mehr Daten, als tatsächlich erforderlich ist.
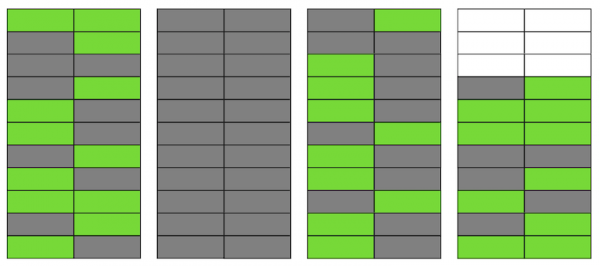
Selbst wenn VACUUM alle veralteten Zeilenversionen jetzt entfernt, wird sich die Situation nicht grundlegend verbessern. Wir werden freien Speicherplatz auf Seiten oder sogar ganze Seiten für neue Zeilen haben, aber wir werden immer noch mehr Daten lesen, als nötig ist.
Übrigens, wenn eine vollständig leere Seite (die zweite in unserem Beispiel) am Ende der Datei wäre, könnte VACUUM sie abschneiden. Aber da sie sich jetzt in der Mitte befindet, kann nichts damit gemacht werden.
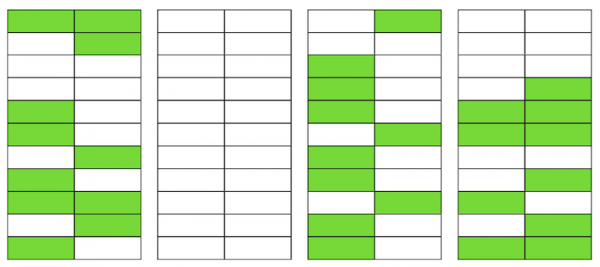
Wenn die Anzahl solcher leeren oder stark ausgedünnten Seiten groß wird, was man als bloat bezeichnet, hat es Auswirkungen auf die Leistung.
Das oben Beschriebene ist die Mechanik, wie bloat in Tabellen entsteht. In Indizes geschieht das ungefähr ähnlich.
Habe ich bloat?
Es gibt mehrere Möglichkeiten, um festzustellen, ob Sie bloat haben. Die Idee des ersten Ansatzes ist die Verwendung interner Statistiken von Postgres, die ungefähre Informationen über die Anzahl der Zeilen in Tabellen, die Anzahl der 'lebenden' Zeilen usw. enthalten. Im Internet findet man viele Variationen bereits fertiger Skripte. Wir haben als Basis genommen von PostgreSQL Experts, das bloat sowohl in Tabellen als auch in Toast- und Bloat-Btree-Indizes bewerten kann. Nach unserer Erfahrung liegt sein Fehlerbereich bei 10-20%.
Ein weiterer Weg ist die Verwendung der Erweiterung , die es ermöglicht, in die Seiten hineinzusehen und sowohl geschätzte als auch exakte Werte für bloat zu erhalten. Im zweiten Fall muss jedoch die gesamte Tabelle gescannt werden.
Ein geringer bloat-Wert von bis zu 20% wird als akzeptabel angesehen. Er kann als Analogon zum fillfactor für und . Bei 50% und mehr können Leistungsprobleme auftreten.
Methoden zur Bekämpfung von bloat
In Postgres gibt es mehrere Möglichkeiten zur Bekämpfung von bloat 'out of the box', jedoch sind sie nicht immer für jeden geeignet.
AUTOVACUUM so konfigurieren, dass bloat nicht entsteht. Und genauer gesagt, damit er auf einem für Sie akzeptablen Niveau bleibt. Es scheint ein „Kapitäne“-Ratschlag zu sein, aber in der Realität ist das nicht immer leicht zu erreichen. Zum Beispiel, wenn Sie aktiv an der Entwicklung sind und regelmäßig das Datenschema ändern oder eine Datenmigration stattfindet. Infolgedessen kann sich Ihr Lastprofil häufig ändern und ist in der Regel unterschiedlich für verschiedene Tabellen. Das bedeutet, dass Sie ständig ein wenig vorausplanen und AUTOVACUUM an das sich ändernde Profil jeder Tabelle anpassen müssen. Aber offensichtlich ist das nicht einfach zu bewerkstelligen.
Ein weiterer häufiger Grund, warum AUTOVACUUM nicht rechtzeitig mit der Verarbeitung der Tabellen fertig wird, sind längere Transaktionen, die es ihm nicht ermöglichen, Daten zu bereinigen, da diese von diesen Transaktionen genutzt werden. Die Empfehlung hier ist ebenfalls offensichtlich – „hängende“ Transaktionen loszuwerden und die Zeit aktiver Transaktionen zu minimieren. Wenn jedoch die Last auf Ihre Anwendung eine Mischung aus OLAP und OLTP ist, können Sie gleichzeitig sowohl viele häufige Aktualisierungen und kurzen Anfragen als auch längere Vorgänge haben – zum Beispiel den Aufbau eines Berichts. In diesem Fall sollten Sie in Betracht ziehen, die Last auf verschiedene Datenbanken zu verteilen, was eine feinere Abstimmung jeder einzelnen ermöglicht.
Ein weiteres Beispiel – selbst wenn das Profil homogen ist, aber die DB einer sehr hohen Last ausgesetzt ist, kann selbst das aggressivste AUTOVACUUM scheitern, und Bloat wird auftreten. Skalierung (vertikal oder horizontal) ist die einzige Lösung.
Was tun in einer Situation, in der Sie AUTOVACUUM eingerichtet haben, aber Bloat weiterhin wächst.
Team VACUUM FULL stellt den Inhalt von Tabellen und Indizes um und lässt nur aktuelle Daten zurück. Für die Beseitigung von Bloat funktioniert es bestens, aber während seiner Ausführung wird eine exklusive Sperre auf die Tabelle (AccessExclusiveLock) gesetzt, die das Ausführen von Abfragen auf dieser Tabelle, selbst Selects, verhindert. Wenn Sie sich eine Unterbrechung Ihres Dienstes oder eines Teils davon für eine gewisse Zeit (von mehreren Minuten bis zu mehreren Stunden, abhängig von der Größe der DB und Ihrer Hardware) leisten können, ist diese Option die beste. Leider schaffen wir es nicht, VACUUM FULL innerhalb der geplanten Wartung durchzuführen, daher ist dieser Ansatz für uns nicht geeignet.
Team CLUSTER Es rekonstruiert auch den Inhalt von Tabellen wie VACUUM FULL, erlaubt aber die Angabe eines Indexes, nach dem die Daten physisch auf der Festplatte sortiert werden (allerdings wird in Zukunft die Reihenfolge für neue Zeilen nicht garantiert). In bestimmten Situationen ist dies eine gute Optimierung für eine Reihe von Abfragen – insbesondere beim Lesen mehrerer Datensätze nach Index. Der Nachteil des Befehls ist derselbe wie bei VACUUM FULL – er sperrt die Tabelle während der Ausführung.
Team REINDEX ähnelt den beiden vorherigen, führt jedoch die Rekonstruktion eines bestimmten Index oder aller Indizes einer Tabelle durch. Die Sperren sind etwas schwächer: ShareLock auf die Tabelle (verhindert Modifikationen, erlaubt jedoch Selects) und AccessExclusiveLock auf den rekonstruierten Index (sperrt Abfragen, die diesen Index verwenden). In der 12. Version von Postgres wurde jedoch ein Parameter eingeführt, , der es ermöglicht, den Index ohne Sperrung paralleler Einfügungen, Änderungen oder Löschungen von Datensätzen neu zu bauen.
In früheren Versionen von Postgres kann man ein ähnliches Ergebnis wie REINDEX CONCURRENTLY mit erreichen. Er erlaubt die Erstellung eines Index ohne strikte Sperrung (ShareUpdateExclusiveLock, die parallele Abfragen nicht stört), danach den alten Index durch den neuen zu ersetzen und den alten Index zu löschen. Dadurch kann Bloat in den Indizes behoben werden, ohne den Betrieb Ihrer Anwendung zu stören. Es ist wichtig zu beachten, dass beim Rekonstruieren der Indizes die Festplattensubsysteme zusätzlich belastet werden.
Somit gibt es für Indizes Möglichkeiten, Bloat "live" zu beheben, für Tabellen hingegen nicht. Hier kommen verschiedene externe Erweiterungen ins Spiel: (früher pg_reorg), , und andere. In diesem Artikel werde ich sie nicht vergleichen, sondern nur über pg_repack sprechen, das wir nach einigen Anpassungen bei uns verwenden.
Wie funktioniert pg_repack?
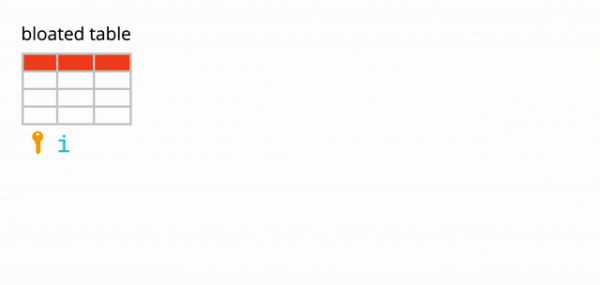
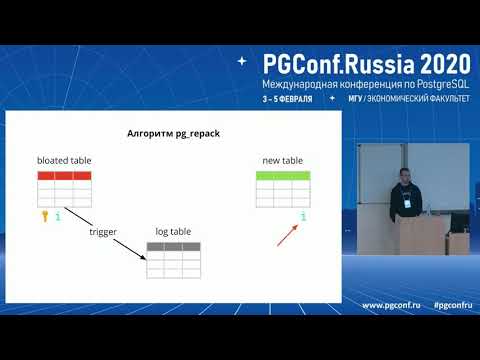
Angenommen, wir haben eine ganz normale Tabelle – mit Indizes, Einschränkungen und, leider, mit Bloat. Im ersten Schritt erstellt pg_repack eine Log-Tabelle, um Daten über alle Änderungen während der Ausführung zu speichern. Ein Trigger repliziert diese Änderungen bei jedem Insert, Update und Delete. Anschließend wird eine Tabelle erstellt, die der Ausgangstabelle hinsichtlich der Struktur ähnlich ist, jedoch ohne Indizes und Einschränkungen, um den Dateninsertionsprozess nicht zu verlangsamen.
Anschließend überträgt pg_repack Daten aus der alten Tabelle in die neue und filtert dabei automatisch alle irrelevanten Zeilen heraus. Danach erstellt es Indizes für die neue Tabelle. Während der Ausführung aller dieser Operationen sammeln sich Änderungen in der Protokolltabelle an.
Der nächste Schritt besteht darin, die Änderungen in die neue Tabelle zu übertragen. Der Transfer erfolgt in mehreren Iterationen, und wenn weniger als 20 Einträge in der Protokolltabelle verbleiben, erfasst pg_repack eine strikte Sperre, überträgt die letzten Daten und ersetzt die alte Tabelle in den Systemtabellen von Postgres durch die neue. Dies ist der einzige und sehr kurze Moment, in dem Sie nicht mit der Tabelle arbeiten können. Danach werden die alte Tabelle und die Protokolltabelle gelöscht, und der Speicherplatz im Dateisystem wird freigegeben. Der Prozess ist abgeschlossen.
In der Theorie sieht alles großartig aus, aber wie sieht es in der Praxis aus? Wir haben pg_repack ohne und unter Last getestet und seine Funktionsweise im Falle eines vorzeitigen Stopps (kurz gesagt, durch Drücken von Ctrl+C) überprüft. Alle Tests waren positiv.
Wir sind in die Produktionsumgebung gegangen – und hier lief alles nicht so, wie wir es erwartet hatten.
Der erste Versuch in der Produktion
Im ersten Cluster erhielten wir einen Fehler wegen eines Verstoßes gegen die eindeutige Einschränkung:
$ ./pg_repack -t tablename -o id
INFO: Tabelle "tablename" wird neu verpackt
ERROR: Abfrage gescheitert:
    ERROR: Duplicater Schlüsselwert verletzt eindeutige Einschränkung "index_16508"
DETAIL: Schlüssel (id, index)=(100500, 42) existiert bereits.
Diese Einschränkung hatte den automatisch generierten Namen index_16508 – sie wurde von pg_repack erstellt. Anhand der Attribute, die Teil davon sind, haben wir „unser“ entsprechendes Limit identifiziert. Das Problem war, dass es sich nicht um eine ganz gewöhnliche Einschränkung handelte, sondern um eine verzögerte (), d.h. deren Überprüfung erfolgt später als der sql-Befehl, was zu unerwarteten Folgen führt.
Verzögerte Einschränkungen: Warum sie notwendig sind und wie sie funktionieren
Ein wenig Theorie über verzögerte Einschränkungen.
Betrachten wir ein einfaches Beispiel: Wir haben eine Referenztabelle für Autos mit zwei Attributen – dem Namen und der Reihenfolge des Autos in der Referenz.
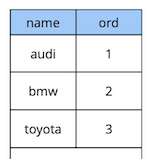
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Angenommen, wir müssen das erste und das zweite Auto vertauschen. Die direkte Lösung wäre, den ersten Wert auf den zweiten und den zweiten auf den ersten zu aktualisieren:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Aber bei der Ausführung dieses Codes werden wir erwartungsgemäß einen Verstoß gegen die Einschränkung erhalten, da die Reihenfolge der Werte in der Tabelle eindeutig ist:
[23305] FEHLER: doppelter Schlüsselwert verstößt gegen die einzigartige Einschränkung „uk_cars“
Detail: Schlüssel (ord)=(2) existiert bereits.
Was kann man anders machen? Erste Möglichkeit: Fügen Sie einen zusätzlichen Wert für die Reihenfolge hinzu, der in der Tabelle garantiert nicht existiert, zum Beispiel „-1“. In der Programmierung nennt man das „Wertetausch zweier Variablen über eine dritte“. Der einzige Nachteil dieser Methode ist das zusätzliche Update.
Zweite Möglichkeit: Entwerfen Sie die Tabelle neu, um für den Reihenfolgewert den Datentyp mit Fließkomma anstelle von Ganzzahlen zu verwenden. Dann wird beim Aktualisieren eines Wertes von 1, zum Beispiel auf 2,5, der erste Datensatz automatisch zwischen dem zweiten und dritten stehen. Diese Lösung funktioniert, hat jedoch zwei Einschränkungen. Erstens ist sie nicht geeignet, wenn der Wert irgendwo in der Benutzeroberfläche verwendet wird. Zweitens haben Sie, je nach Genauigkeit des Datentyps, eine begrenzte Anzahl möglicher Einfügungen, bevor Sie eine Neuberechnung der Werte aller Datensätze durchführen.
Dritte Möglichkeit: Machen Sie die Einschränkung verzögert, sodass sie nur zum Zeitpunkt des Commit überprüft wird:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Da die Logik unserer ursprünglichen Anfrage garantiert, dass alle Werte zum Zeitpunkt des Commits eindeutig sind, wird sie erfolgreich ausgeführt.
Das oben betrachtete Beispiel ist zwar sehr synthetisch, verdeutlicht jedoch die Idee. In unserer Anwendung nutzen wir verzögerte Einschränkungen zur Implementierung der Logik, die für die Konfliktlösung verantwortlich ist, wenn mehrere Benutzer gleichzeitig mit gemeinsamen Objekten-Widgets auf einem Board arbeiten. Der Einsatz solcher Einschränkungen ermöglicht es uns, den Anwendungscode etwas einfacher zu gestalten.
Insgesamt gibt es, je nach Art der Einschränkung in Postgres, drei Ebenen der Granularität ihrer Überprüfung: Zeilenebene, Transaktionsebene und Ausdrucksebene.
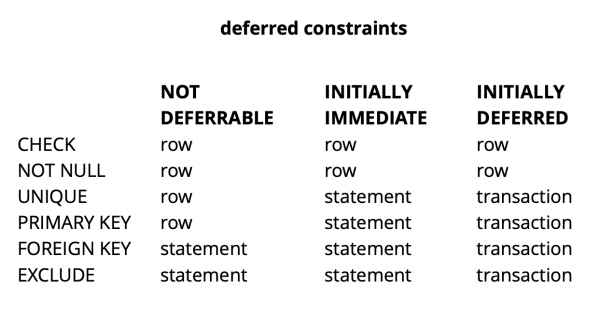
Quelle:
CHECK und NOT NULL werden immer auf Zeilenebene überprüft, für die anderen Einschränkungen gibt es je nach Tabelle unterschiedliche Varianten. Weitere Informationen finden Sie hier. .
Kurz gesagt, führen verzögerte Einschränkungen in bestimmten Situationen zu einem besser lesbaren Code und einer geringeren Anzahl von Befehlen. Allerdings hat dies den Preis, dass der Debugging-Prozess komplizierter wird, da der Zeitpunkt, an dem ein Fehler auftritt, und der Zeitpunkt, an dem Sie davon erfahren, zeitlich auseinanderliegen. Ein weiteres mögliches Problem besteht darin, dass der Planer nicht immer in der Lage ist, einen optimalen Plan zu erstellen, wenn eine verzögerte Einschränkung in der Anfrage beteiligt ist.
Überarbeitung von pg_repack
Wir haben uns angesehen, was verzögerte Einschränkungen sind, aber wie hängen sie mit unserem Problem zusammen? Denken wir an den Fehler, den wir zuvor erhalten haben:
$ ./pg_repack -t tablename -o id
INFO: Tabelle "tablename" wird neu verpackt
ERROR: Abfrage gescheitert:
    ERROR: Duplicater Schlüsselwert verletzt eindeutige Einschränkung "index_16508"
DETAIL: Schlüssel (id, index)=(100500, 42) existiert bereits.
Dieser tritt auf, wenn Daten aus der Log-Tabelle in die neue Tabelle kopiert werden. Das sieht seltsam aus, da die Daten in der Log-Tabelle zusammen mit den Daten der Ursprünglichen Tabelle committiert werden. Wenn sie die Einschränkungen der ursprünglichen Tabelle erfüllen, wie können sie dann dieselben Einschränkungen in der neuen Tabelle verletzen?
Wie sich herausstellte, liegt die Wurzel des Problems im vorherigen Schritt der pg_repack-Arbeit, bei dem nur Indizes, jedoch keine Einschränkungen erstellt werden: In der alten Tabelle gab es eine unique constraint, und in der neuen wurde an deren Stelle ein eindeutiger Index erstellt.
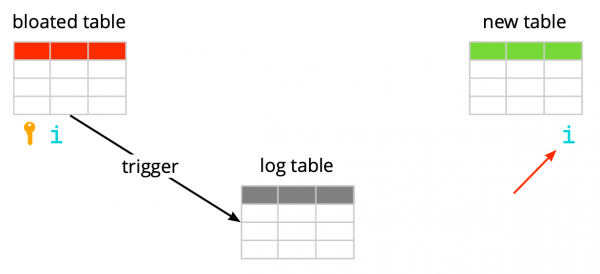
Hier ist wichtig zu beachten, dass, wenn die Einschränkung gewöhnlich und nicht verzögert ist, der erstellte eindeutige Index dieser Einschränkung gleichwertig ist, da eindeutige Einschränkungen in Postgres durch die Erstellung eines einzigartigen Indexes umgesetzt werden. Aber im Fall von verzögerten Einschränkungen ist das Verhalten nicht identisch, weil der Index nicht verzögert sein kann und immer zum Zeitpunkt der Ausführung des SQL-Befehls überprüft wird.
Somit besteht das Wesentliche des Problems in der "Verzögerung" der Überprüfung: In der ursprünglichen Tabelle erfolgt sie zum Zeitpunkt des Commits, in der neuen hingegen zum Zeitpunkt der Ausführung des SQL-Befehls. Das bedeutet, wir müssen sicherstellen, dass die Prüfungen in beiden Fällen gleich durchgeführt werden: entweder immer verzögert oder immer sofort.
Also, welche Ideen hatten wir.
Einen Index erstellen, der der deferred-Variante ähnelt.
Die erste Idee bestand darin, beide Prüfungen im unmittelbaren Modus durchzuführen. Dies kann einige False-Positive-Warnungen der Einschränkung verursachen, aber wenn es nicht viele sind, sollte sich das nicht auf die Arbeit der Benutzer auswirken, da solche Konflikte für sie normal sind. Sie treten beispielsweise auf, wenn zwei Benutzer gleichzeitig dasselbe Widget zu bearbeiten versuchen und der Client des zweiten Benutzers keine Informationen darüber erhält, dass das Widget bereits von dem ersten Benutzer für die Bearbeitung gesperrt ist. In dieser Situation erhält der Server vom zweiten Benutzer eine Ablehnung, woraufhin sein Client die Änderungen zurücksetzt und das Widget sperrt. Etwas später, wenn der erste Benutzer die Bearbeitung abgeschlossen hat, erfährt der zweite, dass das Widget nicht mehr gesperrt ist, und kann seine Aktion wiederholen.
Um sicherzustellen, dass die Prüfungen immer im sofortigen Modus ausgeführt werden, haben wir einen neuen Index erstellt, der dem ursprünglichen verzögerten Limit entspricht:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- pg_repack ausführen
DROP INDEX CONCURRENTLY uk_tablename__immediate;
In der Testumgebung erhielten wir nur einige erwartete Fehler. Erfolg! Wir haben pg_repack erneut in der Produktion gestartet und erhielten 5 Fehler im ersten Cluster innerhalb einer Stunde. Das ist ein akzeptables Ergebnis. Allerdings stieg die Anzahl der Fehler im zweiten Cluster erheblich an, sodass wir pg_repack stoppen mussten.
Warum ist das passiert? Die Wahrscheinlichkeit eines Fehlers hängt davon ab, wie viele Benutzer gleichzeitig mit denselben Widgets arbeiten. Anscheinend gab es zu diesem Zeitpunkt im ersten Cluster viel weniger konkurrierende Änderungen als in den anderen, also hatten wir einfach "Glück".
Die Idee hat nicht funktioniert. Zu diesem Zeitpunkt sahen wir zwei andere Lösungsansätze: unseren Anwendungscode umschreiben, um auf verzögerte Einschränkungen zu verzichten, oder pg_repack "beizubringen", damit zu arbeiten. Wir wählten den zweiten.
Die Indizes in der neuen Tabelle durch die verzögerten Einschränkungen der ursprünglichen Tabelle ersetzen.
Das Ziel der Überarbeitung war offensichtlich – wenn die ursprüngliche Tabelle eine verzögerte Einschränkung hat, sollte für die neue eine solche Einschränkung und kein Index erstellt werden.
Um unsere Änderungen zu überprüfen, schrieben wir einen einfachen Test:
- Tabelle mit verzögerter Einschränkung und einem Datensatz;
- Wir fügen in einer Schleife Daten ein, die mit dem vorhandenen Datensatz in Konflikt stehen;
- Wir führen das Update durch – die Daten stehen nicht mehr im Konflikt;
- Wir committen die Änderungen.
create table test_table
(
  id serial,
  val int,
  constraint uk_test_table__val unique (val) deferrable initially deferred
);
INSERT INTO test_table (val) VALUES (0);
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (0) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    COMMIT;
  END;
END LOOP;
Die ursprüngliche Version von pg_repack schlug beim ersten Insert fehl, die überarbeitete Version funktionierte fehlerfrei. Ausgezeichnet.
Wir gehen in die Produktion und erhalten erneut einen Fehler in derselben Phase des Kopierens von Daten aus der Protokolltabelle in die neue:
$ ./pg_repack -t tablename -o id
INFO: Tabelle "tablename" wird neu verpackt
ERROR: Abfrage gescheitert:
    ERROR: Duplicater Schlüsselwert verletzt eindeutige Einschränkung "index_16508"
DETAIL: Schlüssel (id, index)=(100500, 42) existiert bereits.
Klassische Situation: In den Testumgebungen funktioniert alles, aber in der Produktion – nicht?!
APPLY_COUNT und die Schnittstelle zweier Batch-Prozesse
Wir begannen, den Code zeilenweise zu analysieren und fanden einen wichtigen Punkt: Der Transfer von Daten aus der Protokolltabelle in die neue erfolgt in Batches, die Konstante APPLY_COUNT gab die Größe des Batches an:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;
/* Es könnten noch einige Tupel vorhanden sein, wiederholen. */
...
}
Das Problem ist, dass die Daten der ursprünglichen Transaktion, bei der mehrere Operationen potenziell die Einschränkung verletzen könnten, beim Transfer auf die Schnittstelle zweier Batches gelangen können – die Hälfte der Befehle wird im ersten Batch committen, die andere Hälfte im zweiten. Und hier kommt es darauf an: Wenn die Befehle im ersten Batch nichts verletzen, ist alles gut, aber wenn sie verletzen – tritt ein Fehler auf.
APPLY_COUNT beträgt 1000 Datensätze, was erklärt, warum unsere Tests erfolgreich waren – sie deckten den Fall des "Übergangs zwischen Batches" nicht ab. Wir verwendeten zwei Befehle – Insert und Update, daher am Ende 500 Transaktionen mit jeweils zwei Befehlen gingen immer in einen Batch und wir hatten keine Probleme. Nach dem Hinzufügen eines zweiten Updates funktionierte unsere Anpassung nicht mehr:
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (1) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    UPDATE test_table set val = i where id = v_id; -- ein weiteres Update
    COMMIT;
  END;
END LOOP;
Die nächste Aufgabe besteht darin, sicherzustellen, dass die Daten aus der ursprünglichen Tabelle, die in einer Transaktion geändert wurden, auch in die neue Tabelle innerhalb derselben Transaktion gelangen.
Verzicht auf Batching
Und wir hatten wieder zwei Lösungsansätze. Erster Vorschlag: Lassen Sie uns ganz auf die Batch-Verarbeitung verzichten und die Daten in einer einzigen Transaktion übertragen. Für diese Lösung sprach ihre Einfachheit – die erforderlichen Codeänderungen sind minimal (übrigens funktionierte in älteren Versionen pg_reorg genau so). Aber es gibt ein Problem – wir schaffen eine lange Transaktion, und das ist, wie bereits erwähnt, eine Gefahr für das Entstehen von neuem Bloat.
Die zweite Lösung ist komplexer, aber wahrscheinlich die bessere: Erstellen Sie in der Log-Tabelle eine Spalte mit der ID der Transaktion, die die Daten in die Tabelle eingefügt hat. Dann können wir beim Kopieren der Daten diese nach diesem Attribut gruppieren und garantieren, dass zusammenhängende Änderungen gemeinsam übertragen werden. Der Batch wird aus mehreren Transaktionen (oder einer großen) bestehen, und seine Größe wird variieren, je nachdem, wie viele Daten in diesen Transaktionen geändert wurden. Es ist wichtig zu beachten, dass, da die Daten unterschiedlicher Transaktionen in zufälliger Reihenfolge in die Log-Tabelle gelangen, es nicht mehr möglich ist, sie sequenziell zu lesen, wie es früher war. Ein seqscan bei jeder Anfrage mit Filterung nach tx_id ist zu teuer, ein Index ist notwendig, aber dieser wird die Methode aufgrund der Überheadkosten bei dessen Aktualisierung verlangsamen. Im Allgemeinen muss man wie immer etwas opfern.
Also entschieden wir uns dafür, mit der ersten Variante zu beginnen, da sie einfacher war. Zunächst musste geklärt werden, ob die lange Transaktion ein echtes Problem darstellen würde. Da die Hauptübertragung der Daten von der alten Tabelle in die neue ebenfalls in einer langen Transaktion erfolgt, verwandelte sich die Frage in „Wie sehr werden wir diese Transaktion verlängern?“. Die Dauer der ersten Transaktion hängt hauptsächlich von der Größe der Tabelle ab. Die Dauer der neuen hängt davon ab, wie viele Änderungen sich während der Datenübertragung in der Tabelle ansammeln, d.h. von der Intensität der Last. Der Durchlauf von pg_repack fand bei minimaler Belastung des Dienstes statt, und das Volumen der Änderungen war im Vergleich zur ursprünglichen Größe der Tabelle bedeutend gering. Wir entschieden, dass wir die Dauer der neuen Transaktion ignorieren können (zum Vergleich: durchschnittlich sind das 1 Stunde und 2-3 Minuten).
Die Experimente waren positiv. Der Einsatz in der Produktion ebenfalls. Zur Veranschaulichung – ein Bild von der Größe einer der Datenbanken nach dem Durchlauf:
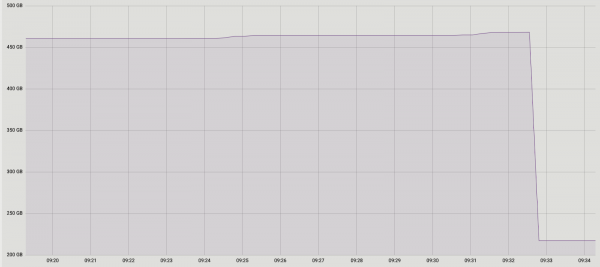
Da dies eine Lösung war, die uns vollständig zufriedenstellte, haben wir es nicht versucht, eine zweite umzusetzen, ziehen jedoch in Betracht, deren Diskussion mit den Entwicklern der Erweiterung zu führen. Unser derzeitiger Fortschritt ist leider noch nicht bereit zur Veröffentlichung, da wir das Problem lediglich mit den einzigartigen verzögerten Einschränkungen gelöst haben, und für einen vollständigen Patch ist es notwendig, auch andere Typen zu unterstützen. Wir hoffen, dass wir dies in Zukunft erreichen können.
Vielleicht fragen Sie sich, warum wir uns überhaupt mit der Überarbeitung von pg_repack beschäftigt haben und nicht stattdessen seine Alternativen verwendet haben? Auch wir haben einen Moment lang darüber nachgedacht, aber die positiven Erfahrungen, die wir zuvor mit ihm auf Tabellen ohne verzögerte Einschränkungen gemacht haben, motivierten uns dazu, das Problem zu verstehen und zu beheben. Außerdem erfordert die Nutzung anderer Lösungen ebenfalls Zeit für Tests, daher haben wir beschlossen, zunächst zu versuchen, das Problem darin zu beheben, und wenn wir feststellen, dass wir dies in einem angemessenen Zeitrahmen nicht schaffen, werden wir Alternativen in Betracht ziehen.
Das DBMS Tarantool ist ein attraktives, zukunftsträchtiges Produkt zur Erstellung von hochbelasteten Anwendungen.
Was wir basierend auf eigener Erfahrung empfehlen können:
- Überwachen Sie Ihren Bloat. Anhand der Monitoring-Daten können Sie verstehen, wie gut autovacuum konfiguriert ist.
- Konfigurieren Sie AUTOVACUUM, um den Bloat auf einem akzeptablen Niveau zu halten.
- Wenn der Bloat dennoch zunimmt und Sie ihn mit den "Out-of-the-box"-Mitteln nicht bekämpfen können, scheuen Sie sich nicht, externe Erweiterungen zu verwenden. Das Wichtigste ist, alles gut zu testen.
- Scheuen Sie sich nicht, externe Lösungen nach Ihren Bedürfnissen anzupassen – manchmal kann dies effektiver und sogar einfacher sein als Änderungen an Ihrem eigenen Code.
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish