

Im Rahmen unserer Tätigkeit stoßen wir auf Situationen, in denen ein Entwickler eine Anfrage schreibt und denkt: «die Datenbank ist clever, sie wird sich selbst kümmern!"«
In einigen Fällen (teilweise aufgrund mangelnden Wissens über die Fähigkeiten der Datenbank, teilweise aufgrund voreiliger Optimierungen) führt dieser Ansatz zur Entstehung von „Frankensteins“.
Zunächst möchte ich ein Beispiel für eine solche Anfrage anführen:
-- für jedes Schlüssel-Paar finden wir die zugeordneten Feldwerte
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- wir finden min/max Werte für jeden ersten Schlüssel
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- wir verknüpfen die Schlüssel-Paare und min/max-Werte nach dem ersten Schlüssel
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
Um die Qualität der Anfrage konkret zu bewerten, lassen Sie uns eine willkürliche Datenmenge erstellen:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
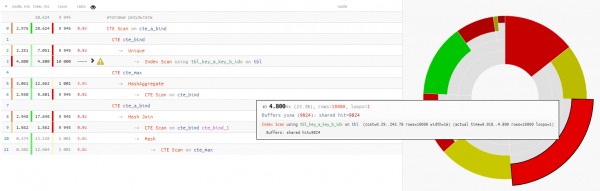
Es stellt sich heraus, dass das eigentliche Lesen der Daten weniger als ein Viertel der gesamten Zeit in Anspruch nahm, die für die Ausführung der Anfrage benötigt wurde:
Wir analysieren im Detail
Wir sehen uns die Anfrage genau an und sind verwirrt:
- Warum gibt es hier WITH RECURSIVE, wenn es keine rekursiven CTE gibt?
- Warum min/max-Werte in einer separaten CTE gruppieren, wenn sie doch später wieder an die ursprüngliche Auswahl gebunden werden?
+25% Zeit - Warum am Ende eine erneute Abfrage aus der vorherigen CTE über die bedingungslose 'SELECT * FROM'-Syntax verwenden?
+14% Zeit
In diesem Fall hatten wir auch großes Glück, dass der Hash Join für die Verbindung gewählt wurde und nicht der Nested Loop, denn sonst hätten wir nicht einen CTE-Scan, sondern 10K erzielt!
Ein wenig über CTE ScanHier muss man daran denken, dass CTE Scan das Pendant von Seq Scan ist – das heißt, keine Indizierung, sondern nur eine vollständige Durchsuchung, die 10K x 0.3ms = 3000ms bei Zyklen über cte_max oder 1K x 1.5ms = 1500ms bei Zyklen über cte_bind!
Was wollten wir denn eigentlich als Ergebnis erhalten? Aha, normalerweise kommt genau diese Frage nach etwa fünf Minuten der Analyse von „dreistöckigen“ Anfragen.
Wir wollten für jedes einzigartige Schlüssel-Paar die min/max aus der Gruppe nach key_a ausgeben..
Also nutzen wir dafür :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 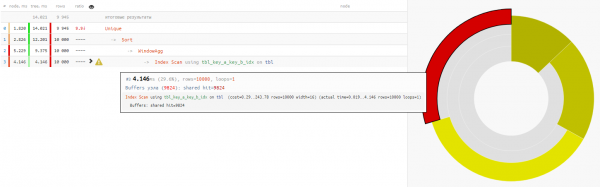
Da das Lesen der Daten in beiden Varianten ungefähr 4-5 ms dauert, verschaffen wir uns damit einen zeitlichen Gewinn. -32% — das ist rein die Last, die vom CPU der Datenbank genommen wird, wenn eine solche Anfrage häufig genug ausgeführt wird.
Insgesamt sollte man die Datenbank nicht dazu bringen, "rund zu tragen, viereckig zu rollen".
Quelle: habr.com
