

Gelegentlich hat der Entwickler die Notwendigkeit einen Parameter-Set oder sogar eine gesamte Auswahl „als Eingabe“ zu übergeben. Manchmal begegnen einem sehr seltsame Lösungen für dieses Problem.
Lass uns „vom Gegenteil“ ausgehen und schauen, wie man es nicht machen sollte, warum und wie man es besser machen kann.
Direkte „Einschübe“ von Werten in den Anfragekörper
sehen normalerweise ungefähr so aus:
query = "SELECT * FROM tbl WHERE id = " + value… oder so:
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)Über diese Methode wurde viel gesagt, geschrieben und es gibt mehr als genug:
Fast immer führt dies zu einem direkten Weg zu SQL-Injektionen und übermäßiger Belastung der Geschäftslogik, die gezwungen ist, die Zeichenfolge deiner Anfrage „zusammenzukleben“.
Ein solcher Ansatz kann nur teilweise gerechtfertigt sein, wenn es notwendig ist, Partitionierung in PostgreSQL-Versionen 10 und niedriger zu verwenden, um einen effizienteren Plan zu erhalten. In diesen Versionen wird die Liste der gescannten Abschnitte noch ohne Berücksichtigung der übergebenen Parameter ausschließlich auf Grundlage des Anfragekörpers festgelegt.
$n-Argumente
Verwendung Parameter sind gut, sie erlauben es, , wodurch die Belastung sowohl der Geschäftslogik (die Anfrage wird nur einmal erstellt und übergeben) als auch des DB-Servers (eine wiederholte Analyse und Planung für jede Instanz der Anfrage ist nicht erforderlich) reduziert wird.
Eine variable Anzahl von Argumenten
Probleme werden uns erwarten, wenn wir eine im Voraus unbekannte Anzahl von Argumenten übergeben möchten:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Wenn wir die Anfrage in dieser Form belassen, wird sie uns zwar vor potenziellen Injektionen bewahren, aber trotzdem wird es notwendig sein, die Anfrage zusammenzukleben / zu analysieren für jede Variante der Anzahl der Argumente.Das ist schon besser, als es jedes Mal zu tun, aber man könnte darauf verzichten.
Es reicht, nur einen Parameter zu übergeben, der eine serialisierte Darstellung eines Arrays enthält:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'Der einzige Unterschied ist die Notwendigkeit, das Argument explizit in den erforderlichen Arraytyp umzuwandeln. Aber das verursacht keine Probleme, da wir ohnehin im Voraus wissen, wohin wir gehen.
Übergabe eines Abfragesatzes (Matrix)
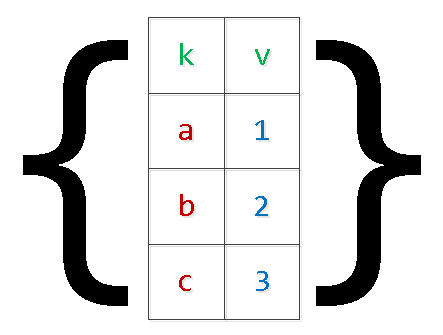
Normalerweise handelt es sich um verschiedene Möglichkeiten, Datensätze für eine „einzeilige Anfrage“ in die Datenbank einzufügen:
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...Neben den oben beschriebenen Problemen mit der „Zusammenklebe-Anfrage“ kann dies auch zu Out of Memory führen. und dem Absturz des Servers. Der Grund ist simpel – beim Argument PG wird zusätzlicher Speicher reserviert, und die Anzahl der Datensätze in der Menge wird nur durch die Geschäftslogik der Anwendung begrenzt. In besonders klinischen Fällen musste ich sehen dass die »nummerischen« Argumente mehr als 9000 Dollar betragen – das müssen wir nicht so machen.
Lass uns die Abfrage umschreiben und dabei bereits die „zweistufige“ Serialisierung anwenden:
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Ja, im Falle von „komplexen“ Werten innerhalb des Arrays müssen diese in Anführungszeichen gesetzt werden.
Es ist klar, dass man auf diese Weise die Auswahl mit einer beliebigen Anzahl von Feldern „entfalten“ kann.
unnest, unnest, …
Gelegentlich gibt es Varianten, bei denen anstelle eines „Arrays von Arrays“ mehrere „Spalten-Arrays“ übergeben werden, auf die ich hingewiesen habe. :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Bei dieser Methode ist es sehr einfach, unerwartete Ergebnisse zu erzielen, wenn man bei der Erstellung von Wertlisten für verschiedene Spalten einen Fehler macht. die zudem von der Serverversion abhängen:, abhängig von der Serverversion:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
Seit Version 9.3 gibt es in PostgreSQL vollständige Funktionen zur Arbeit mit dem json-Typ. Daher können Sie, wenn die Definition der Eingabeparameter in Ihrem Browser erfolgt, direkt dort das json-Objekt für die SQL-Abfrage formulieren:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
Für frühere Versionen kann dieselbe Methode für each(hstore), aber eine korrekte „Einschmelzung“ mit der Escapierung komplexer Objekte in hstore kann Probleme verursachen.
json_populate_recordset
Wenn Sie im Voraus wissen, dass die Daten aus dem „eingehenden“ json-Array zum Befüllen einer bestimmten Tabelle verwendet werden, können Sie erheblich an „Entdereferenzierung“ von Feldern und Typkonvertierung sparen, indem Sie die Funktion json_populate_recordset verwenden:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
Diese Funktion „entfaltet“ einfach das übergebene Objektarray in die Auswahl, ohne sich auf das Tabellenformat zu stützen:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
TEMPORÄRE TABELLE
Wenn das Datenvolumen in der übergebenen Auswahl jedoch sehr groß ist, ist es schwierig, es in einem einzigen serialisierten Parameter zu verarbeiten – manchmal sogar unmöglich, da dies eine einmalige Zuweisung eines großen Speicherumfangs erfordert.. Zum Beispiel möchten Sie einen großen Datensatz von Ereignissen aus einem externen System über einen längeren Zeitraum sammeln und möchten ihn dann einmalig auf der Datenbankseite verarbeiten.
In diesem Fall wäre die beste Lösung die Nutzung von :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- viele Male wiederholen
...
-- hier machen wir etwas Nützliches mit der gesamten Tabelle
Die Methode ist besonders für seltene Übertragungen großer Datenmengen geeignet. von Daten.
Aus Sicht der Beschreibung der Struktur Ihrer Daten unterscheidet sich eine temporäre Tabelle von einer „gewöhnlichen“ nur durch ein einziges Merkmal. in der Systemtabelle pg_class, sondern in pg_type, pg_depend, pg_attribute, pg_attrdef, … — so unterscheidet sie sich überhaupt nicht.
Deshalb erzeugt eine solche Tabelle in Websystemen mit einer großen Anzahl von kurzlebigen Verbindungen bei jedem einzelnen eine neue systematische Aufzeichnung, die beim Schließen der Verbindung zur Datenbank gelöscht wird. Infolgedessen führt die unkontrollierte Verwendung von TEMP TABLE zu einer „Aufblähung“ der Tabellen im pg_catalog und verlangsamt viele Operationen, die sie verwenden.
Natürlich kann man dem mit einem regelmäßigen VACUUM FULL des Systemkatalogs begegnen.
Sitzungsvariablen
Angenommen, die Verarbeitung von Daten aus dem vorherigen Fall ist für eine SQL-Abfrage ziemlich komplex, aber wir möchten sie häufig durchführen. Das heißt, wir möchten die prozedurale Verarbeitung in , aber die Verwendung der Übertragung von Daten über temporäre Tabellen wäre zu umständlich.
Wir können auch die $n-Parameter nicht verwenden, um sie in einen anonymen Block zu übergeben. Eine Lösung für unser Problem bietet uns die Verwendung von Sitzungsvariablen und der Funktion current_setting.
Bis zur Version 9.2 war es notwendig, ein spezielles Namensraum für „eigene“ Sitzungsvariablen im Voraus zu konfigurieren. In den aktuellen Versionen kann man etwa so schreiben: SET my.val = '{1,2,3}'; DO $$ DECLARE id integer; BEGIN FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP RAISE NOTICE 'id : %', id; END LOOP; END; $$ LANGUAGE plpgsql; -- NOTICE: id : 1 -- NOTICE: id : 2 -- NOTICE: id : 3
In anderen unterstützten prozeduralen Sprachen können auch andere Lösungen gefunden werden.Kennt ihr noch andere Methoden? Teilt sie in den Kommentaren!
Gelegentlich hat der Entwickler die Notwendigkeit, eine Menge von Parametern oder sogar eine gesamte Auswahl „zu übergeben“.
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish