

Die Übersetzung des Artikels wurde speziell für die Studierenden des Kurses erstellt .
In den letzten Wochen haben wir mit in das binäre Streaming-Format integriert, ergänzt um das bereits vorhandene Random Access / IPC-Dateiformat. Wir haben Implementierungen in Java und C++ sowie Python-Bindings. In diesem Artikel werde ich erklären, wie das Format funktioniert und zeigen, wie man eine sehr hohe Datenübertragungsrate für DataFrame pandas erreichen kann.
Streaming von Spaltendaten
Eine häufige Frage, die ich von Arrow-Nutzern erhalte, ist die hohe Kosten für die Übertragung großer tabellarischer Datensätze von einem zeilen- oder aufzeichnungenorientierten Format in ein spaltenorientiertes Format. Bei Multigigabyte-Datensätzen kann die Transponierung im Speicher oder auf der Festplatte eine unüberwindbare Aufgabe sein.
Für das Streaming von Daten, unabhängig davon, ob die Quelldaten zeilen- oder spaltenbasiert sind, bleibt eine Möglichkeit, kleine Datenpakete zu senden, von denen jedes eine spaltenbasierte Anordnung enthält.
In Apache Arrow wird eine Sammlung von Spaltenarrays im Speicher, die einen Chunk einer Tabelle repräsentiert, als Record Batch bezeichnet. Um eine einheitliche Datenstruktur einer logischen Tabelle darzustellen, können mehrere Record Batches zusammengestellt werden.
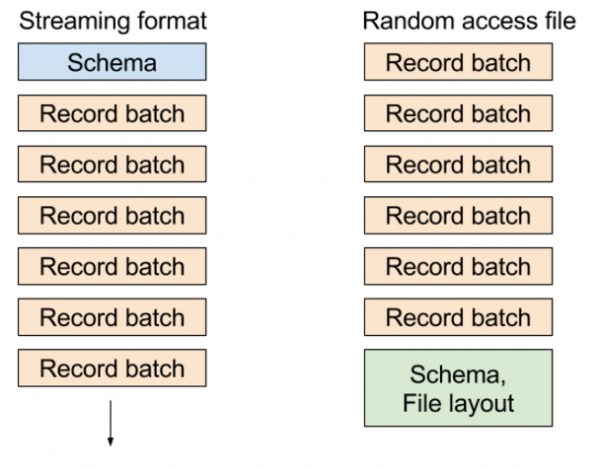
Im bestehenden Random Access-Dateiformat schreiben wir Metadaten, die das Schema der Tabelle und die Position der Blöcke am Ende der Datei enthalten, was es Ihnen ermöglicht, sehr kostengünstig jeden Record Batch oder jede Spalte aus dem Datensatz auszuwählen. Im Streaming-Format senden wir eine Reihe von Nachrichten: das Schema und dann einen oder mehrere Record Batches.
Die verschiedenen Formate sehen ungefähr so aus, wie auf diesem Bild dargestellt:
Datenstreaming in PyArrow: Anwendung
Um Ihnen zu zeigen, wie das funktioniert, werde ich ein Beispielformat erstellen, das einen Streaming-Chunk darstellt:
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = int(total_size / ncols / np.dtype('float64').itemsize)
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })
Nehmen wir nun an, dass wir 1 GB an Daten aufzeichnen möchten, bestehend aus 1 MB großen Chunks, insgesamt 1024 Chunks. Zuerst erstellen wir das erste DataFrame mit einer Größe von 1 MB und 16 Spalten:
KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

df = generate_data(MEGABYTE, NCOLS)
Dann konvertiere ich sie in pyarrow.RecordBatch:
batch = pa.RecordBatch.from_pandas(df) Jetzt werde ich einen Ausgabestream erstellen, der in den Speicher schreibt und erstellen StreamWriter:
sink = pa.InMemoryOutputStream()
stream_writer = pa.StreamWriter(sink, batch.schema)
Dann schreiben wir 1024 Chunks, die letztendlich 1GB Datensatz ausmachen:
for i in range(DATA_SIZE // MEGABYTE):
    stream_writer.write_batch(batch)
Da wir im RAM geschrieben haben, können wir den gesamten Stream in einem Buffer erhalten:
In [13]: source = sink.get_result()

In [14]: source
Out[14]:

In [15]: source.size
Out[15]: 1074750744
Da sich diese Daten im Speicher befinden, ist das Lesen der Arrow-Datensatzpakete eine zero-copy Operation. Ich öffne StreamReader und lese die Daten in pyarrow.Table, und konvertiere sie dann in DataFrame pandas:
In [16]: reader = pa.StreamReader(source)

In [17]: table = reader.read_all()

In [18]: table
Out[18]:

In [19]: df = table.to_pandas()

In [20]: df.memory_usage().sum()
Out[20]: 1073741904
Das ist natürlich alles gut, aber Sie haben vielleicht Fragen. Wie schnell geht das? Wie beeinflusst die Chunk-Größe die Leistung beim Erhalten eines pandas DataFrame?
Leistung der Datenübertragung
Mit abnehmender Chunk-Größe steigt die Kosten für die Rekonstruktion eines kontinuierlichen Column-Frames des DataFrame in pandas aufgrund ineffizienter Cachezugriffs-Schemata. Es gibt auch einige Overheads durch die Arbeit mit C++-Datenstrukturen und Arrays sowie deren Speicherpuffern.
Für 1 MB, wie oben angegeben, ergibt sich auf meinem Laptop (Quad-Core Xeon E3-1505M):
In [20]: %timeit pa.StreamReader(source).read_all().to_pandas()
10 loops, best of 3: 129 ms per loop
So beträgt die effektive Bandbreite 7,75 GB/s für die Wiederherstellung eines 1GB DataFrames aus 1024 Chunks von 1MB. Was passiert, wenn wir größere oder kleinere Chunks verwenden? Hier sind die Ergebnisse:
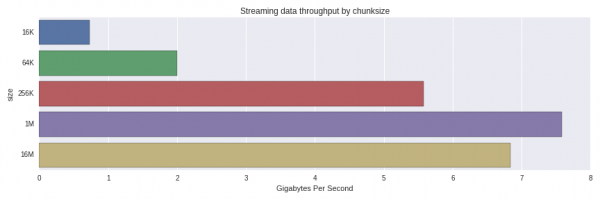
Die Leistung verringert sich erheblich von 256K auf 64K Chunks. Es hat mich überrascht, dass Chunks von 1 MB schneller verarbeitet wurden als 16 MB. Es wäre sinnvoll, eine genauere Untersuchung durchzuführen und herauszufinden, ob dies eine normale Verteilung ist oder ob noch etwas anderes eine Rolle spielt.
In der aktuellen Implementierung des Formats werden die Daten grundsätzlich nicht komprimiert, daher sind Größe im Speicher und 'auf den Drähten' etwa gleich. In Zukunft könnte die Kompression eine zusätzliche Option werden.
Fazit
Die Streaming-Übertragung von Spaltendaten kann eine effektive Methode zum Übertragen großer Datensätze in spaltenbasierte Analysetools, wie zum Beispiel in pandas, mithilfe kleiner Chunks sein. Datenservices, die speicherorientierte Zeilenbanken verwenden, können kleine Daten-Chunks übertragen und transponieren, die besser für den L2- und L3-Cache Ihres Prozessors geeignet sind.
Vollständiger Code
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = total_size / ncols / np.dtype('float64').itemsize
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })

KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

def get_timing(f, niter):
    start = time.clock_gettime(time.CLOCK_REALTIME)
    for i in range(niter):
        f()
    return (time.clock_gettime(time.CLOCK_REALTIME) - start) / NITER

def read_as_dataframe(klass, source):
    reader = klass(source)
    table = reader.read_all()
    return table.to_pandas()
NITER = 5
results = []

CHUNKSIZES = [16 * KILOBYTE, 64 * KILOBYTE, 256 * KILOBYTE, MEGABYTE, 16 * MEGABYTE]

for chunksize in CHUNKSIZES:
    nchunks = DATA_SIZE // chunksize
    batch = pa.RecordBatch.from_pandas(generate_data(chunksize, NCOLS))

    sink = pa.InMemoryOutputStream()
    stream_writer = pa.StreamWriter(sink, batch.schema)

    for i in range(nchunks):
        stream_writer.write_batch(batch)

    source = sink.get_result()

    elapsed = get_timing(lambda: read_as_dataframe(pa.StreamReader, source), NITER)

    result = (chunksize, elapsed)
    print(result)
    results.append(result)
Quelle: habr.com
