

Im Wir haben die Clusterbildung von RabbitMQ zur Gewährleistung der Ausfallsicherheit und hohen Verfügbarkeit betrachtet. Jetzt tauchen wir tiefer in Apache Kafka ein.
Hier ist die Replikationseinheit die Partition. Jedes Thema hat ein oder mehrere Partitionen. In jeder Partition gibt es einen Leader mit oder ohne Follower. Bei der Erstellung eines Themas wird die Anzahl der Partitionen und der Replikationsfaktor angegeben. Ein häufig verwendeter Wert ist 3, was drei Replikate bedeutet: ein Leader und zwei Follower.
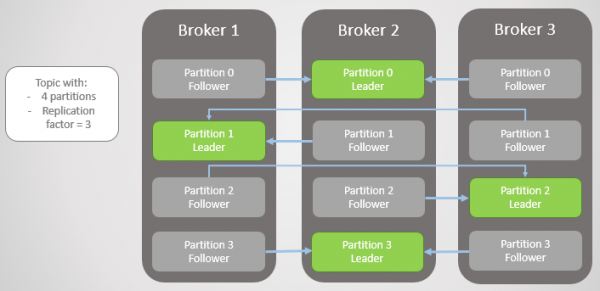
Abb. 1. Vier Partitionen sind auf drei Broker verteilt
Alle Lese- und Schreibanfragen werden an den Leader gesendet. Follower senden dem Leader regelmäßig Anfragen nach den neuesten Nachrichten. Verbraucher wenden sich niemals an Follower; diese existieren nur für Redundanz und Ausfallsicherheit.
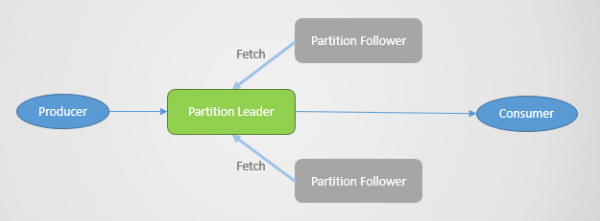
Ausfall einer Partition
Wenn ein Broker ausfällt, fallen häufig die Leader mehrerer Partitionen aus. In jeder von ihnen wird ein Follower von einem anderen Knoten zum Leader. Tatsächlich ist dies nicht immer so, da auch der Synchronisationsfaktor eine Rolle spielt: Gibt es synchronisierte Follower und wenn nicht, ist der Übergang zu einer unsynchronisierten Replikat erlaubt? Aber lass uns das vorerst nicht komplizieren.
Broker 3 fällt aus — und für Partition 2 wird ein neuer Leader auf Broker 2 gewählt.
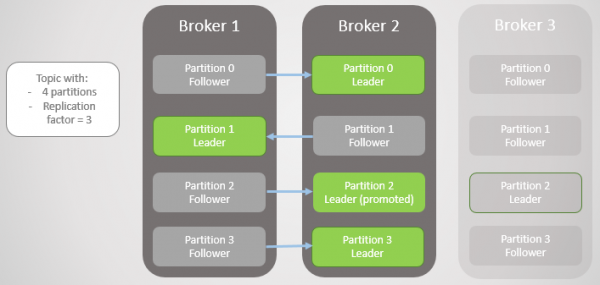
Abb. 2. Broker 3 stirbt, und sein Follower auf Broker 2 wird neuer Leader von Partition 2
Dann fällt Broker 1 aus und Partition 1 verliert ebenfalls ihren Leader, dessen Rolle auf Broker 2 übergeht.
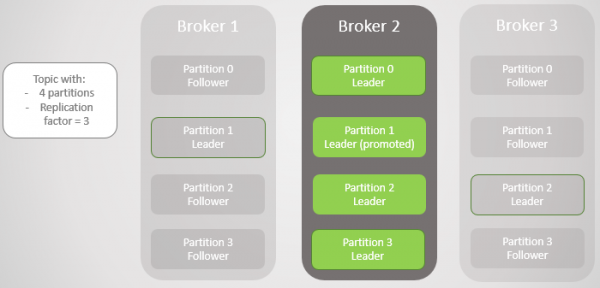
Abb. 3. Nur ein Broker bleibt. Alle Leader befinden sich auf einem Broker mit null Redundanz
Wenn Broker 1 ins Netzwerk zurückkehrt, fügt er vier Follower hinzu, sodass jedem Abschnitt eine gewisse Redundanz geboten wird. Aber alle Leader bleiben weiterhin auf Broker 2.
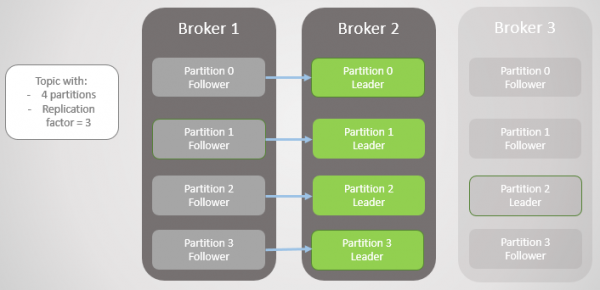
Abb. 4. Die Leader bleiben auf Broker 2
Wenn Broker 3 wieder hochgefahren wird, kehren wir zu drei Replikaten pro Partition zurück. Aber alle Leader bleiben weiterhin auf Broker 2.
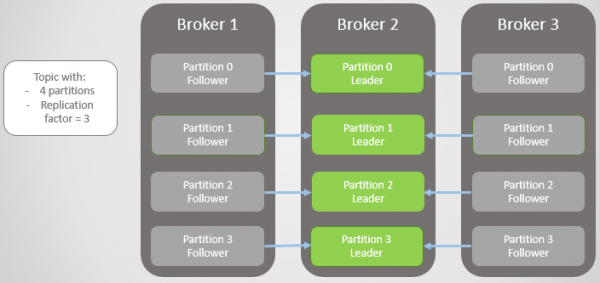
Abb. 5. Unausgewogene Verteilung der Leader nach der Wiederherstellung der Broker 1 und 3
Kafka verfügt über ein Werkzeug zur hochwertigeren Neubesetzung von Leadern als RabbitMQ. Dort musste ein externes Plugin oder Skript verwendet werden, das die Richtlinien zur Migration des Hauptknotens änderte, um die Redundanz während der Migration zu verringern. Außerdem musste man sich bei großen Warteschlangen mit einer Unzugänglichkeit während der Synchronisation abfinden.
Kafka hat das Konzept der "bevorzugten Replikate" für die Rolle des Leaders. Wenn Partitionen eines Topics erstellt werden, versucht Kafka, die Leader gleichmäßig auf die Knoten zu verteilen und markiert diese ersten Leader als bevorzugt. Im Laufe der Zeit können die Leader aufgrund von Serverneustarts, Ausfällen und Verbindungseinbußen auf anderen Knoten landen, wie im vorher beschriebenen Extremfall.
Um dies zu beheben, bietet Kafka zwei Optionen:
- Option auto.leader.rebalance.enable=true ermöglicht es dem Controller-Knoten, die Leader automatisch wieder auf die bevorzugten Replikate umzubenennen und somit die gleichmäßige Verteilung wiederherzustellen.
- Der Administrator kann das Skript kafka-preferred-replica-election.sh zum manuellen Umbenennen ausführen.
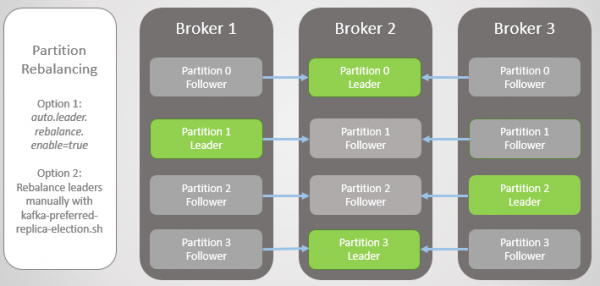
Abb. 6. Replikate nach der Neubesetzung
Dies war eine vereinfachte Version des Ausfalls, aber die Realität ist komplexer, obwohl hier nichts übermäßig kompliziert ist. Alles hängt von den synchronisierten Replikaten (In-Sync Replicas, ISR) ab.
Synchronisierte Replikate (ISR)
ISR ist eine Menge von Partitionen, die als "synchronisiert" (in-sync) gelten. Dabei gibt es einen Leader, und es können keine Follower vorhanden sein. Ein Follower gilt als synchronisiert, wenn er alle Nachrichten des Leaders rechtzeitig kopiert hat, bis der Zeitintervall replica.lag.time.max.ms.
abgelaufen ist. Der Follower wird aus der ISR entfernt, wenn er:
- keine Abrufanfrage im Intervall gestellt hat replica.lag.time.max.ms (als tot geltend)
- im Intervall nicht rechtzeitig aktualisiert wurde replica.lag.time.max.ms (als langsam geltend)
Follower stellen Abrufanfragen im Intervall replica.fetch.wait.max.ms, das standardmäßig 500 ms beträgt.
Um das Ziel von ISR klar zu erklären, muss man sich die Bestätigungen vom Produzenten und einige Ausfallszenarien ansehen. Produzenten können wählen, wann der Broker eine Bestätigung sendet:
- acks=0, Bestätigung wird nicht gesendet
- acks=1, Bestätigung wird gesendet, nachdem der Leader die Nachricht in sein lokales Protokoll geschrieben hat
- acks=all, Bestätigung wird gesendet, nachdem alle Replikate in ISR die Nachricht in ihren lokalen Protokollen geschrieben haben
In der Kafka-Terminologie wird eine Nachricht „committed“, wenn der ISR sie gespeichert hat. Acks=all ist die sicherste Option, bedeutet jedoch zusätzliche Verzögerung. Lassen Sie uns zwei Ausfallbeispiele betrachten und wie die verschiedenen Optionen ‚acks‘ mit dem Konzept des ISR interagieren.
Acks=1 und ISR
In diesem Beispiel sehen wir, dass, wenn der Leader nicht darauf wartet, dass jede Nachricht von allen Followern gespeichert wird, bei einem Leader-Ausfall Daten verloren gehen können. Der Wechsel zu einem unsynchronisierten Follower kann durch die Einstellung erlaubt oder verweigert werden. unclean.leader.election.enable.
In diesem Beispiel hat der Producer den Wert acks=1 eingestellt. Der Partition ist auf alle drei Broker verteilt. Broker 3 hinkt hinterher, synchronisierte sich vor acht Sekunden mit dem Leader und hat jetzt 7456 Nachrichten Rückstand. Broker 1 hat nur einen Sekunden Rückstand. Unser Producer sendet eine Nachricht und erhält schnell ack zurück, ohne Overhead für langsame oder tote Follower, auf die der Leader nicht wartet.
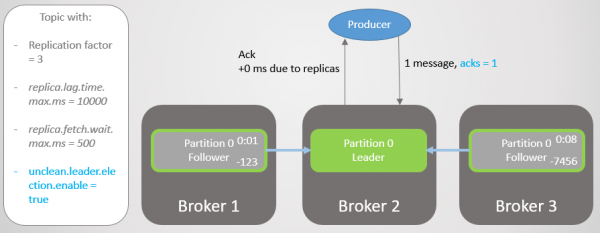
Abb. 7. ISR mit drei Replikaten
Broker 2 fällt aus, und der Producer erhält einen Verbindungsfehler. Nach dem Führungswechsel zu Broker 1 verlieren wir 123 Nachrichten. Der Follower auf Broker 1 war im ISR, hatte sich jedoch nicht vollständig mit dem Leader synchronisiert, als dieser abstürzte.
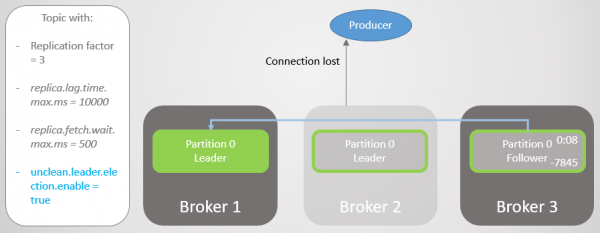
Abb. 8. Nachrichtenverlust bei Ausfall
In der Konfiguration bootstrap.servers sind mehrere Broker für den Producer aufgelistet, und er kann einen anderen Broker fragen, wer der neue Leader der Partition ist. Dann stellt er eine Verbindung zu Broker 1 her und sendet weiterhin Nachrichten.
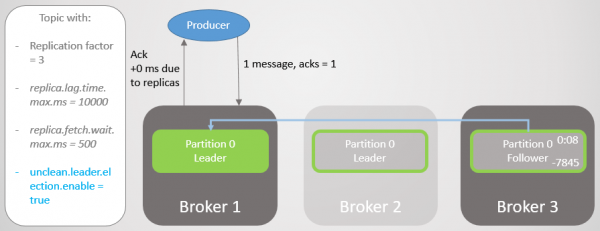
Abb. 9. Das Senden von Nachrichten wird nach einer kurzen Unterbrechung fortgesetzt
Broker 3 hinkt noch weiter hinterher. Er stellt Anfragen zum Abrufen, kann sich jedoch nicht synchronisieren. Das kann mit einer langsamen Netzwerkverbindung zwischen den Brokern, Speicherproblemen usw. zu tun haben. Er wird aus dem ISR entfernt. Jetzt besteht der ISR nur noch aus einer Replik — dem Leader! Der Producer sendet weiterhin Nachrichten und erhält Bestätigungen.
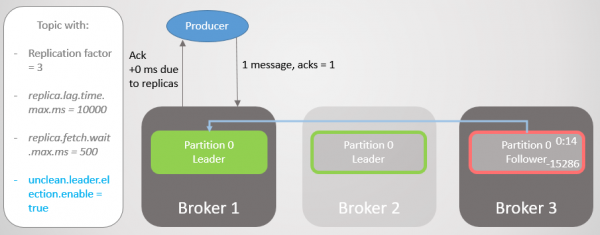
Abb. 10. Follower auf Broker 3 wird aus dem ISR entfernt
Broker 1 fällt aus, und die Führungsrolle wechselt zu Broker 3 mit dem Verlust von 15286 Nachrichten! Der Producer erhält eine Fehlermeldung zur Verbindung. Der Wechsel zu einem Leader außerhalb des ISR war nur wegen der Einstellung möglich unclean.leader.election.enable=true. Wenn sie eingestellt ist auf false, dann würde kein Übergang stattfinden, und alle Lese- und Schreibanfragen wären abgelehnt worden. In diesem Fall warten wir auf die Rückkehr von Broker 1 mit seinen unberührten Daten in der Replik, die erneut die Führung übernehmen wird.
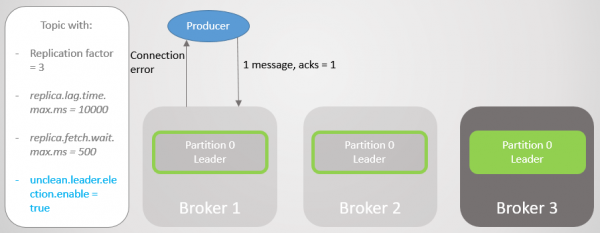
Abb. 11. Broker 1 fällt aus. Bei einem Ausfall gehen viele Nachrichten verloren.
Der Produzent verbindet sich mit dem letzten Broker und sieht, dass dieser jetzt der Führer der Partition ist. Er beginnt, Nachrichten an Broker 3 zu senden.
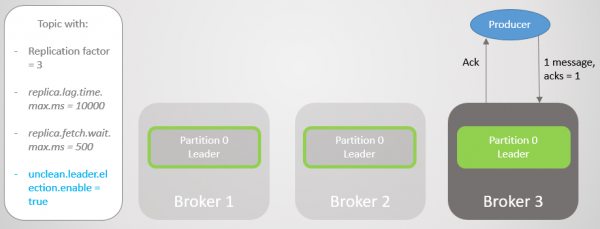
Abb. 12. Nach einer kurzen Unterbrechung werden die Nachrichten wieder an Partition 0 gesendet.
Wir haben gesehen, dass der Produzent kontinuierlich Nachrichten sendete, abgesehen von kurzen Unterbrechungen beim Einrichten neuer Verbindungen und der Suche nach einem neuen Führer. Diese Konfiguration gewährleistet Verfügbarkeit auf Kosten von Konsistenz (Datensicherheit). Kafka hat Tausende von Nachrichten verloren, aber weiterhin neue Einträge entgegengenommen.
Acks=all und ISR
Lassen Sie uns dieses Szenario noch einmal wiederholen, jedoch mit acks=all. Die Verzögerung von Broker 3 beträgt im Durchschnitt vier Sekunden. Der Produzent sendet eine Nachricht mit acks=all, und erhält jetzt keine schnelle Antwort. Der Führer wartet, bis die Nachricht von allen Replikaten im ISR gespeichert wird.
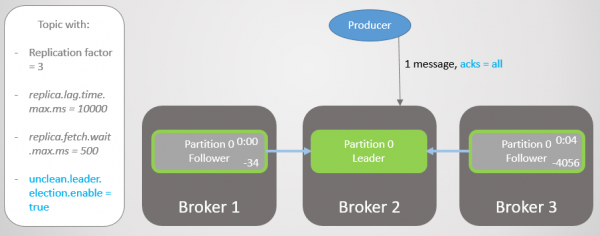
Abb. 13. ISR mit drei Replikaten. Eine arbeitet langsam, was zu einer Verzögerung beim Schreiben führt.
Nach vier zusätzlichen Sekunden Verzögerung sendet Broker 2 ein Ack. Alle Replikate sind nun vollständig aktualisiert.
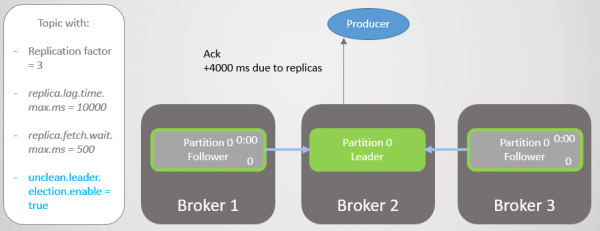
Abb. 14. Alle Replikate speichern die Nachrichten und senden ein Ack.
Broker 3 hinkt nun noch weiter hinterher und wird aus dem ISR entfernt. Die Verzögerung verringert sich erheblich, da es im ISR keine langsamen Replikate mehr gibt. Broker 2 wartet jetzt nur noch auf Broker 1, dessen durchschnittliche Verzögerung 500 ms beträgt.
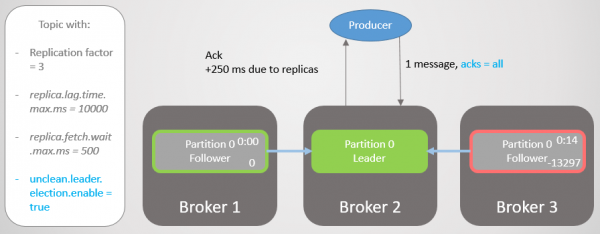
Abb. 15. Die Replik auf Broker 3 wird aus dem ISR entfernt.
Dann fällt Broker 2 aus, und die Führung wechselt zu Broker 1, ohne dass Nachrichten verloren gehen.
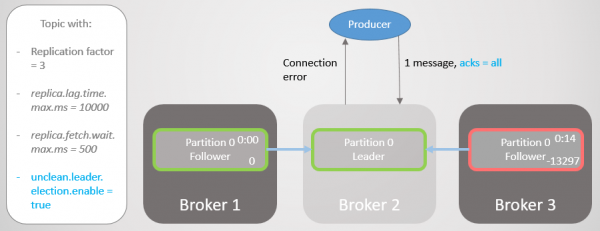
Abb. 16. Broker 2 fällt aus.
Der Produzent findet einen neuen Führer und beginnt, ihm Nachrichten zu senden. Die Verzögerung verringert sich weiter, da der ISR nun aus einer einzigen Replik besteht! Daher fügt die Option acks=all keine Redundanz hinzu.
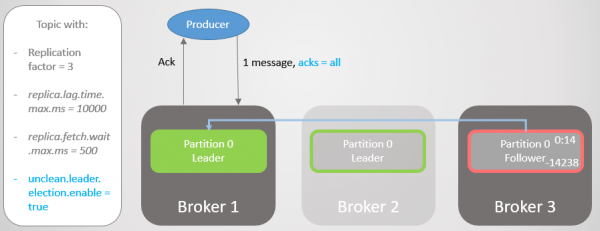
Abb. 17. Die Replik auf Broker 1 übernimmt die Führung, ohne Nachrichten zu verlieren.
Dann fällt Broker 1 aus, und die Führung wechselt zu Broker 3 mit einem Verlust von 14.238 Nachrichten!
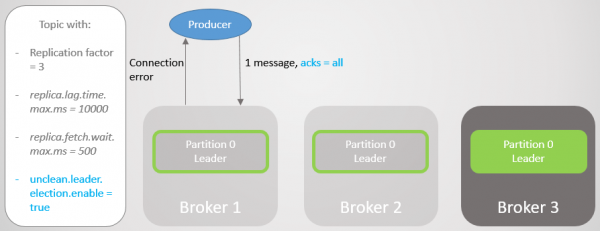
Abb. 18. Broker 1 stirbt, und der Führungswechsel mit unclean gesetzt führt zu erheblichen Datenverlusten.
Wir hätten die Option nicht setzen können unclean.leader.election.enable auf den Wert true. Standardmäßig beträgt sie false. Einstellung acks=all c unclean.leader.election.enable=true stellt die Verfügbarkeit mit etwas zusätzlicher Datensicherheit sicher. Aber wie Sie sehen, können wir immer noch Nachrichten verlieren.
Was ist jedoch, wenn wir die Datensicherheit erhöhen wollen? Man kann unclean.leader.election.enable = false, aber das schützt uns nicht unbedingt vor Datenverlust. Wenn der Leader hart abstürzt und die Daten mit sich bringt, gehen die Nachrichten weiterhin verloren, zudem ist die Verfügbarkeit verloren, bis der Administrator die Situation wiederherstellt.
Es ist besser, die Redundanz aller Nachrichten zu garantieren, andernfalls auf die Aufzeichnung zu verzichten. Dann ist der Datenverlust aus Sicht des Brokers nur bei zwei oder mehr gleichzeitigen Ausfällen möglich.
Acks=alle, min.insync.replicas und ISR
Mit der Topic-Konfiguration min.insync.replicas erhöhen wir das Niveau der Datensicherheit. Lassen Sie uns noch einmal den letzten Teil des vorherigen Szenarios durchgehen, aber diesmal mit min.insync.replicas=2.
Also hat Broker 2 einen Leader Replica, und der Follower auf Broker 3 wurde aus dem ISR entfernt.
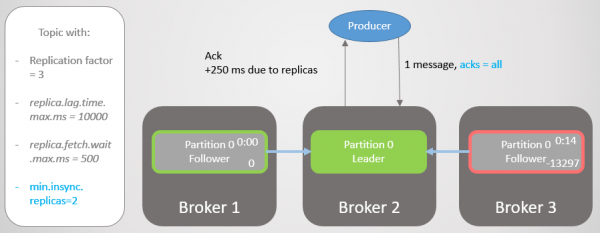
Abb. 19. ISR aus zwei Replikaten
Broker 2 stürzt ab, und die Führung wechselt zu Broker 1, ohne dass Nachrichten verloren gehen. Aber jetzt besteht der ISR nur aus einer Replica. Das entspricht nicht der minimalen Anzahl für Aufzeichnungen, und daher gibt Broker eine Fehlermeldung bei dem Versuch, eine Aufzeichnung zu schreiben. NotEnoughReplicas.
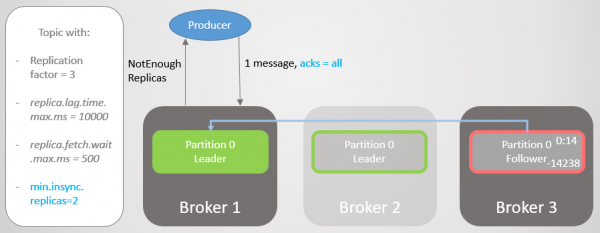
Abb. 20. Die Anzahl der ISR liegt um eins unter dem in min.insync.replicas angegebenen Wert.
Diese Konfiguration opfert die Verfügbarkeit für Konsistenz. Bevor wir eine Nachricht bestätigen, stellen wir sicher, dass sie auf mindestens zwei Replikaten gespeichert wird. Das gibt dem Produzenten viel mehr Sicherheit. Hier ist der Verlust von Nachrichten nur möglich, wenn zwei Replikate gleichzeitig im kurzen Zeitraum ausfallen, während die Nachricht nicht an einen zusätzlichen Follower repliziert wurde, was unwahrscheinlich ist. Wenn Sie jedoch super paranoid sind, können Sie einen Replikationsfaktor von 5 einstellen, und min.insync.replicas auf 3. Hier müssen sofort drei Broker gleichzeitig ausfallen, um einen Eintrag zu verlieren! Natürlich zahlen Sie für diese Zuverlässigkeit mit zusätzlicher Verzögerung.
Wenn Verfügbarkeit für Datensicherheit erforderlich ist
Wie in , ist manchmal die Verfügbarkeit für die Datensicherheit erforderlich. Sie sollten Folgendes in Betracht ziehen:
- Kann der Publisher einfach einen Fehler zurückgeben, und der übergeordnete Dienst oder der Benutzer versucht es später erneut?
- Kann der Publisher die Nachricht lokal oder in einer Datenbank speichern, um einen späteren Versuch zu ermöglichen?
Wenn die Antwort negativ ist, erhöht die Verfügbarkeit die Datensicherheit. Sie verlieren weniger Daten, wenn Sie die Verfügbarkeit anstelle von Schreibverweigerung wählen. Letztendlich kommt es darauf an, ein Gleichgewicht zu finden, und die Entscheidung hängt von der spezifischen Situation ab.
Bedeutung von ISR
Das ISR-Set ermöglicht es, ein optimales Gleichgewicht zwischen Datensicherheit und Verzögerung zu wählen. Beispielsweise die Verfügbarkeit im Falle eines Ausfalls der meisten Repliken zu gewährleisten, während der Einfluss toter oder langsamer Repliken in Bezug auf die Verzögerung minimiert wird.
Wir wählen den Wert selbst replica.lag.time.max.ms entsprechend unseren Bedürfnissen. Im Grunde bedeutet dieser Parameter, welche Verzögerung wir bei acks=allbereitschaft sind. Der Standardwert beträgt zehn Sekunden. Wenn Ihnen das zu lange ist, können Sie ihn verkürzen. In diesem Fall wird die Häufigkeit der Änderungen im ISR steigen, da Nachfolger häufiger hinzugefügt und entfernt werden.
In RabbitMQ gibt es einfach eine Reihe von Spiegeln, die repliziert werden müssen. Langsame Spiegel verursachen zusätzliche Verzögerungen, und auf die Antwort toter Spiegel kann gewartet werden, bis die Lebensdauer der Pakete abläuft, die die Erreichbarkeit jedes Knotens überprüfen (net tick). ISR ist ein interessanter Weg, um diese Probleme mit erhöhten Verzögerungen zu umgehen. Aber wir riskieren, Redundanz zu verlieren, da ISR nur bis zum Führer verkürzt werden kann. Um dieses Risiko zu vermeiden, verwenden Sie die Einstellung min.insync.replicas.
Kundenverbindungs-Garantie
In den Einstellungen bootstrap.servers des Herstellers und des Verbrauchers können mehrere Broker für die Verbindung der Kunden angegeben werden. Die Idee ist, dass bei der Trennung eines Knotens mehrere Backup-Knoten bleiben, mit denen der Kunde eine Verbindung herstellen kann. Dies sind nicht unbedingt die Führer der Partitionen, sondern einfach eine Grundlage für den initialen Load. Der Kunde kann sie fragen, auf welchem Knoten der Führer der Partition für Lese- / Schreibzugriffe untergebracht ist.
In RabbitMQ können sich Kunden mit jedem Knoten verbinden, und das interne Routing sendet die Anfrage dorthin, wo sie benötigt wird. Das bedeutet, dass Sie vor RabbitMQ einen Lastenausgleichsmechanismus installieren können. Kafka erfordert, dass sich die Kunden mit dem Knoten verbinden, auf dem der Führer der entsprechenden Partition untergebracht ist. In dieser Situation kann kein Lastenausgleichsmechanismus installiert werden. Die Liste bootstrap.servers ist entscheidend, damit die Kunden auf die benötigten Knoten zugreifen und diese nach einem Ausfall finden können.
Kafka-Konsensusarchitektur
Bis jetzt haben wir nicht betrachtet, wie der Cluster über den Ausfall des Brokers informiert wird und wie ein neuer Leader ausgewählt wird. Um zu verstehen, wie Kafka mit Netzwerkpartitionen umgeht, müssen wir zunächst die Architektur des Konsenses verstehen.
Jeder Kafka-Cluster wird zusammen mit einem Zookeeper-Cluster bereitgestellt – einem Service für verteilten Konsens, der es dem System ermöglicht, einen Konsens über einen bestimmten Zustand zu erreichen, wobei die Konsistenz über die Verfügbarkeit priorisiert wird. Für die Genehmigung von Lese- und Schreiboperationen ist das Einverständnis der Mehrheit der Zookeeper-Knoten erforderlich.
Zookeeper speichert den Zustand des Clusters:
- Die Liste der Themen, Partitionen, Konfigurationen, aktuellen Leader-Repliken und bevorzugten Repliken.
- Cluster-Mitglieder. Jeder Broker pingt den Zookeeper-Cluster. Wenn dieser innerhalb eines festgelegten Zeitraums kein Ping erhält, wird der Broker als nicht verfügbar eingestuft.
- Auswahl des Haupt- und Ersatzknotens für den Controller.
Der Controller-Knoten ist einer der Kafka-Broker, der für die Wahl der Leader-Repliken verantwortlich ist. Zookeeper sendet dem Controller Benachrichtigungen über die Mitgliedschaft im Cluster und Änderungen des Themas, und der Controller muss entsprechend diesen Änderungen handeln.
Nehmen wir beispielsweise ein neues Thema mit zehn Partitionen und einem Replikationsfaktor von 3. Der Controller muss für jede Partition einen Leader auswählen und dabei versuchen, die Leader gleichmäßig auf die Broker zu verteilen.
Für jede Partition aktualisiert der Controller:
- die Informationen in Zookeeper über ISR und Leader;
- sendet jedem Broker, der eine Replik dieser Partition hostet, den LeaderAndISRCommand und informiert die Broker über ISR und Leader.
Wenn ein Broker mit dem Leader ausfällt, sendet Zookeeper eine Benachrichtigung an den Controller, der dann einen neuen Leader auswählt. Der Controller aktualisiert zuerst Zookeeper und sendet dann den Befehl an jeden Broker, um sie über die Änderung der Führung zu informieren.
Jeder Leader ist für eine Menge von ISR verantwortlich. Die Konfiguration replica.lag.time.max.ms bestimmt, wer dort hineinkommt. Wenn sich ISR ändert, übermittelt der Leader neue Informationen an Zookeeper.
Zookeeper ist stets über alle Änderungen informiert, sodass im Falle eines Ausfalls die Führung nahtlos an den neuen Leader übergehen kann.
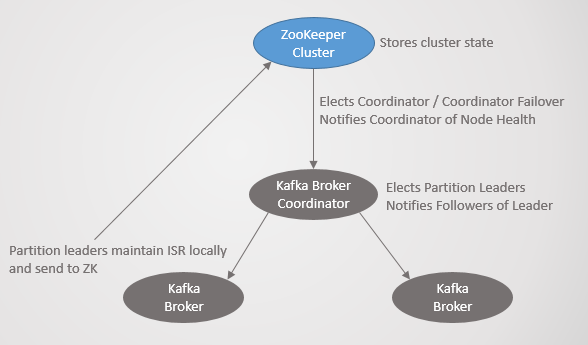
Abb. 21. Kafka-Konsens
Replikationsprotokoll
Das Verständnis der Einzelheiten der Replikation hilft dabei, potenzielle Szenarien eines Datenverlusts besser zu verstehen.
Abfragen zum Abrufen, Log End Offset (LEO) und Highwater Mark (HW)
Wir haben gesehen, dass Follower dem Leader periodisch Anfragen für die Abfrage (fetch) senden. Das Standardintervall beträgt 500 ms. Dies unterscheidet sich von RabbitMQ, da bei RabbitMQ die Replikation nicht vom Spiegel der Warteschlange, sondern vom Master initiiert wird. Der Master pusht die Änderungen zu den Spiegeln.
Der Leader und alle Follower speichern den Endoffset des Logs (Log End Offset, LEO) und das Highwater-Marke (HW). Der LEO speichert den Versatz der letzten Nachricht in der lokalen Replik, während HW den Versatz des letzten Commits enthält. Denken Sie daran, dass für den Status „Commit“ die Nachricht in allen Replikaten des ISR gespeichert sein muss. Das bedeutet, dass LEO normalerweise etwas vor HW liegt.
Wenn der Leader eine Nachricht erhält, speichert er diese lokal. Der Follower sendet eine Anfrage zur Abfrage, wobei er seinen LEO übermittelt. Daraufhin sendet der Leader ein Paket von Nachrichten, beginnend mit diesem LEO, und überträgt auch das aktuelle HW. Wenn der Leader die Information erhält, dass alle Replikate die Nachricht mit dem angegebenen Offset gespeichert haben, verschiebt er die HW-Markierung. Nur der Leader kann HW verschieben, und so erfahren alle Follower den aktuellen Wert in den Antworten auf ihre Anfragen. Das bedeutet, dass Follower sowohl im Hinblick auf die Nachrichten als auch hinsichtlich des Wissens um HW hinter dem Leader zurückbleiben können. Verbraucher erhalten Nachrichten nur bis zum aktuellen HW.
Bitte beachten Sie, dass „persisted“ (persistiert) bedeutet, dass es im Speicher, nicht auf der Festplatte gespeichert ist. Um die Leistung zu optimieren, führt Kafka die Synchronisierung auf die Festplatte in bestimmten Intervallen durch. RabbitMQ hat ebenfalls ein solches Intervall, wird jedoch den Publisher erst benachrichtigen, nachdem der Master und alle Spiegel die Nachricht auf der Festplatte abgespeichert haben. Die Entwickler von Kafka haben aus Leistungsgründen beschlossen, die Bestätigung (ack) zu senden, sobald die Nachricht im Speicher abgelegt wurde. Kafka setzt darauf, dass Redundanz das Risiko des kurzfristigen Speicherns bestätigter Nachrichten nur im Speicher ausgleicht.
Leader-Ausfall
Wenn der Leader ausfällt, benachrichtigt Zookeeper den Controller, der dann eine neue Replik des Leaders auswählt. Der neue Leader legt eine neue HW-Markierung gemäß seinem LEO fest. Die Follower erhalten dann Informationen über den neuen Leader. Je nach Version von Kafka wählt der Follower eines von zwei Szenarien:
- Er kürzt das lokale Log auf das bekannte HW und sendet dem neuen Leader eine Anfrage nach Nachrichten nach diesem Offset.
- Sendet eine Anfrage an den Leader, um den HW zum Zeitpunkt seiner Wahl zum Leader zu erfahren, und schneidet dann das Log bis zu diesem Offset ab. Danach beginnt es, regelmäßige Abfragen zur Auswahl durchzuführen, beginnend mit diesem Offset.
Ein Follower muss möglicherweise das Log aus folgenden Gründen kürzen:
- Wenn ein Leader ausfällt, gewinnt der erste Follower aus der ISR-Gruppe, der in Zookeeper registriert ist, die Wahl und wird zum Leader. Alle Follower in der ISR, obwohl sie als "synchronisiert" gelten, haben möglicherweise nicht alle Nachrichten vom ehemaligen Leader erhalten. Es ist gut möglich, dass der gewählte Follower nicht die aktuellste Kopie hat. Kafka garantiert, dass zwischen den Replikaten keine Diskrepanz besteht. Um Diskrepanzen zu vermeiden, muss jeder Follower sein Log bis zum HW des neuen Leaders zum Zeitpunkt seiner Wahl kürzen. Dies ist ein weiterer Grund, warum die Konfiguration acks=all so wichtig für die Konsistenz ist.
- Nachrichten werden regelmäßig auf die Festplatte geschrieben. Wenn alle Knoten des Clusters gleichzeitig ausfallen, bleiben Replikate mit unterschiedlichem Offset auf den Festplatten zurück. Es ist gut möglich, dass, wenn die Broker wieder ins Netzwerk zurückkehren, der neue Leader, der gewählt wird, hinter seinen Followern zurückliegt, weil er sich früher auf die Festplatte gespeichert hat als andere.
Wiederverbindung mit dem Cluster
Bei der Wiederverbindung mit dem Cluster verhalten sich die Replikate genauso wie bei einem Leader-Ausfall: Sie überprüfen die Leader-Replikate und schneiden ihr Log bis zu dessen HW (zum Zeitpunkt der Wahl) ab. Im Vergleich dazu betrachtet RabbitMQ wiederverbundene Knoten als völlig neu. In beiden Fällen verwirft der Broker jeden bestehenden Zustand. Wenn eine automatische Synchronisation verwendet wird, muss der Master den gesamten aktuellen Inhalt in das neue Mirror auf eine "und die ganze Welt soll warten"-Weise replizieren. Während dieses Vorgangs akzeptiert der Master keine Lese- oder Schreiboperationen. Dieser Ansatz schafft Probleme bei großen Warteschlangen.
Kafka ist ein verteiltes Log, das insgesamt mehr Nachrichten speichert als eine RabbitMQ-Warteschlange, in der Daten nach ihrem Lesen aus der Warteschlange gelöscht werden. Aktive Warteschlangen müssen relativ klein bleiben. Aber Kafka ist ein Log mit einer eigenen Aufbewahrungspolitik, die Fristen von Tagen oder Wochen festlegen kann. Der Ansatz mit Warteschlangen-Sperren und absoluter Synchronisation ist für ein verteiltes Log völlig inakzeptabel. Stattdessen kürzen Kafka-Folger ihr Log einfach bis zum HW-Führer (zum Zeitpunkt seiner Wahl), wenn ihre Kopie dem Führer voraus ist. Im wahrscheinlicheren Fall, wenn ein Folger hinterherhinkt, beginnt er einfach, Abfragen zu machen, beginnend mit seinem aktuellen LEO.
Neue oder wiederverbundene Folger beginnen außerhalb des ISR und nehmen nicht an Commit-Operationen teil. Sie arbeiten einfach neben der Gruppe und empfangen Nachrichten so schnell, wie sie können, bis sie den Führer einholen und im ISR landen. Hier gibt es keine Sperrung und es müssen keine Daten verworfen werden.
Netzwerkunterbrechungen
Kafka hat mehr Komponenten als RabbitMQ, daher gibt es hier ein komplexeres Verhalten, wenn die Konnektivität im Cluster gestört ist. Aber Kafka wurde von Anfang an für Cluster entworfen, sodass die Lösungen gut durchdacht sind.
Im Folgenden sind einige Szenarien für Konnektivitätsstörungen aufgeführt:
- Szenario 1. Ein Folger sieht den Führer nicht, sieht aber immer noch Zookeeper.
- Szenario 2. Der Führer sieht keinen Folger, sieht aber immer noch Zookeeper.
- Szenario 3. Ein Folger sieht den Führer, sieht aber Zookeeper nicht.
- Szenario 4. Der Führer sieht die Folger, sieht aber Zookeeper nicht.
- Szenario 5. Ein Folger ist vollständig von anderen Kafka-Knoten und von Zookeeper getrennt.
- Szenario 6. Der Führer ist vollständig von anderen Kafka-Knoten und von Zookeeper getrennt.
- Szenario 7. Der Kafka-Controller-Knoten sieht keinen anderen Kafka-Knoten.
- Szenario 8. Der Kafka-Controller sieht Zookeeper nicht.
Für jedes Szenario ist ein spezifisches Verhalten vorgesehen.
Szenario 1. Ein Folger sieht den Führer nicht, sieht aber immer noch Zookeeper
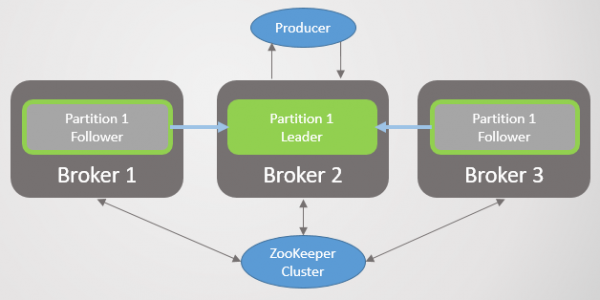
Abb. 22. Szenario 1. ISR aus drei Replikaten
Die Konnektivitätsstörung trennt Broker 3 von den Brokern 1 und 2, aber nicht von Zookeeper. Broker 3 kann keine Abfragen mehr senden. Nach Ablauf der Zeit. replica.lag.time.max.ms Er entfernt sich aus dem ISR und nimmt nicht an den Commit-Nachrichten teil. Sobald die Konnektivität wiederhergestellt ist, wird er die Abfragen wieder aufnehmen und sich dem ISR anschließen, sobald er den Leader eingeholt hat. Zookeeper wird weiterhin Pings erhalten und annehmen, dass der Broker lebt und gesund ist.
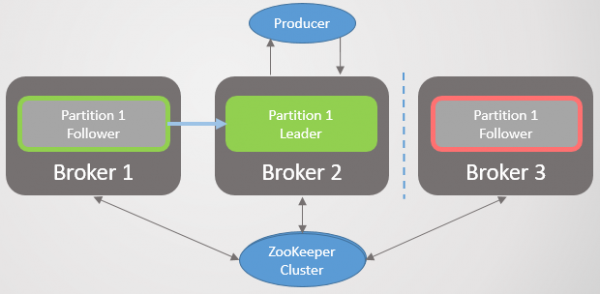
Abb. 23. Szenario 1. Der Broker wird aus dem ISR entfernt, wenn innerhalb des Intervalls replica.lag.time.max.ms keine Abfrage empfangen wurde.
Es gibt keine logische Trennung (Split-Brain) oder Anhalten des Knotens, wie bei RabbitMQ. Stattdessen wird die Redundanz verringert.
Szenario 2. Der Leader sieht keinen einzigen Follower, sieht aber immer noch Zookeeper.
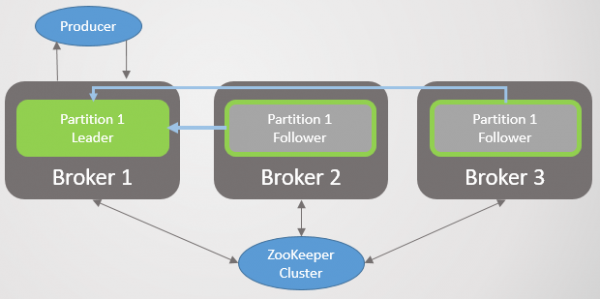
Abb. 24. Szenario 2. Leader und zwei Follower.
Eine Unterbrechung der Netzwerkverbindung trennt den Leader von den Followern, aber der Broker sieht weiterhin Zookeeper. Wie im ersten Szenario wird das ISR komprimiert, aber diesmal nur bis zum Leader, da alle Follower aufhören, Abfragen zu senden. Wieder gibt es keine logische Trennung. Stattdessen gibt es einen Verlust der Redundanz für neue Nachrichten, bis die Konnektivität wiederhergestellt ist. Zookeeper empfängt weiterhin Pings und hält den Broker für lebendig und gesund.
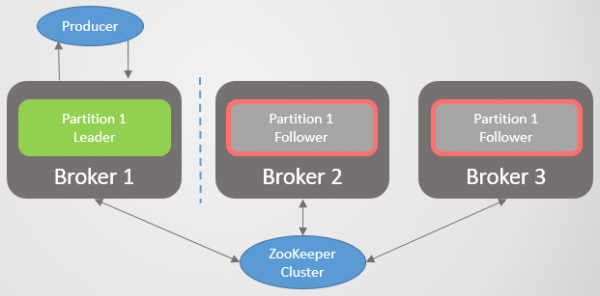
Abb. 25. Szenario 2. Das ISR hat sich nur bis zum Leader komprimiert.
Szenario 3. Der Follower sieht den Leader, sieht aber Zookeeper nicht.
Der Follower trennt sich von Zookeeper, nicht aber vom Broker mit dem Leader. Infolgedessen sendet der Follower weiterhin Abfragen und bleibt Mitglied des ISR. Zookeeper erhält keine Pings mehr und registriert den Ausfall des Brokers, aber da es nur ein Follower ist, gibt es nach der Wiederherstellung keine Konsequenzen.
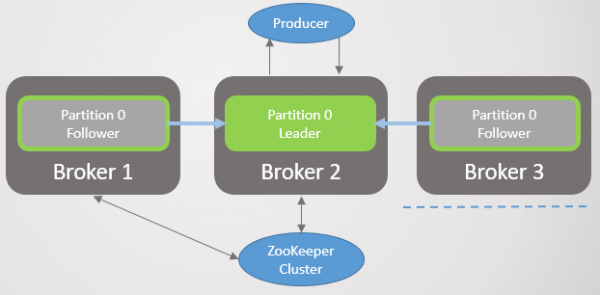
Abb. 26. Szenario 3. Der Follower sendet weiterhin Abfragen an den Leader.
Szenario 4. Der Leader sieht die Follower, sieht aber Zookeeper nicht.
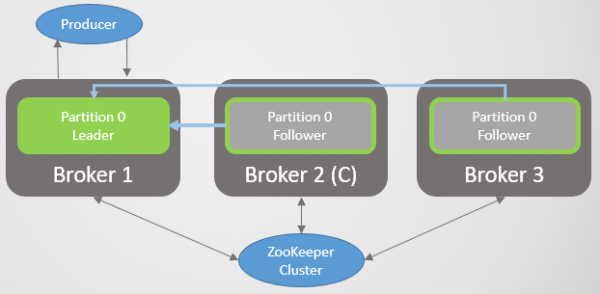
Abb. 27. Szenario 4. Leader und zwei Follower.
Der Leader ist von Zookeeper getrennt, nicht aber von den Brokern mit den Followern.
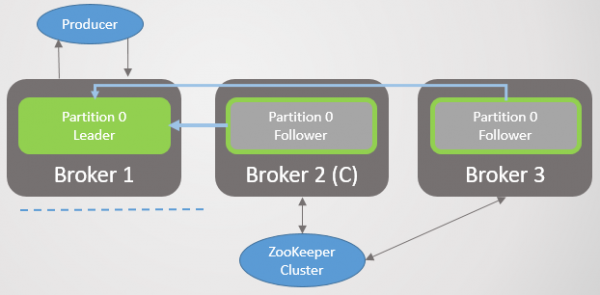
Abb. 28. Szenario 4. Der Leader ist von Zookeeper isoliert.
Nach einiger Zeit wird Zookeeper den Ausfall des Brokers registrieren und den Controller benachrichtigen. Dieser wird einen neuen Leader aus den Followern auswählen. Der ursprüngliche Leader wird jedoch weiterhin denken, dass er der Leader ist und weiterhin Aufzeichnungen annehmen. acks=1. Die Follower senden ihm keine Abfragen mehr, daher wird er sie als tot betrachten und versuchen, das ISR auf sich selbst zu komprimieren. Da er jedoch keine Verbindung zu Zookeeper hat, kann er dies nicht tun und wird in diesem Moment aufhören, Aufzeichnungen anzunehmen.
Nachrichten acks=all Sie erhalten keine Bestätigung, weil der ISR zunächst alle Replikate umfasst und die Nachrichten sie nicht erreichen. Wenn der ursprüngliche Leader versucht, sie aus dem ISR zu entfernen, kann er dies nicht tun und hört auf, irgendwelche Nachrichten zu empfangen.
Die Clients bemerken bald den Wechsel des Leaders und beginnen, Aufzeichnungen an den neuen Server zu senden. Sobald das Netzwerk wiederhergestellt ist, sieht der ursprüngliche Leader, dass er nicht mehr Leader ist, und schneidet sein Log auf den HW-Wert, den der neue Leader zum Zeitpunkt des Ausfalls hatte, um eine Log-Abweichung zu vermeiden. Dann beginnt er, Anfragen an den neuen Leader zu senden. Alle Aufzeichnungen des ursprünglichen Leaders, die nicht an den neuen Leader repliziert wurden, gehen verloren. Das heißt, es gehen Nachrichten verloren, die in den wenigen Sekunden, in denen zwei Leader aktiv waren, nicht vom ursprünglichen Leader bestätigt wurden.
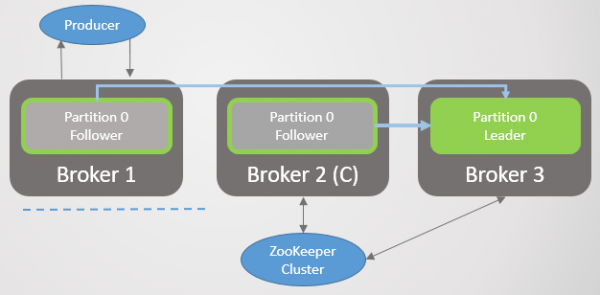
Abb. 29. Szenario 4. Der Leader auf Broker 1 wird nach der Wiederherstellung des Netzwerks zu einem Follower
Szenario 5. Der Follower ist vollständig von anderen Kafka-Knoten und von Zookeeper isoliert
Der Follower ist vollständig von anderen Kafka-Knoten und von Zookeeper isoliert. Er wird einfach aus dem ISR entfernt, bis das Netzwerk wiederhergestellt ist, und holt dann die anderen ein.

Abb. 30. Szenario 5. Der isolierte Follower wird aus dem ISR entfernt
Szenario 6. Der Leader ist vollständig von anderen Kafka-Knoten und von Zookeeper isoliert
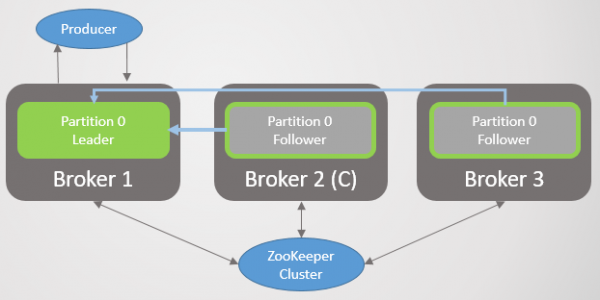
Abb. 31. Szenario 6. Leader und zwei Follower
Der Leader ist vollständig von seinen Followern, dem Controller und Zookeeper isoliert. Für eine kurze Zeit wird er weiterhin Aufzeichnungen empfangen von acks=1.
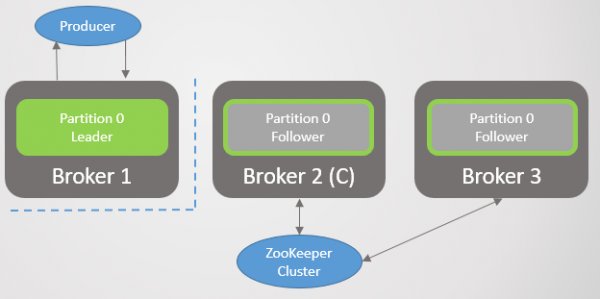
Abb. 32. Szenario 6. Isolation des Leaders von anderen Kafka-Knoten und Zookeeper
Nachdem er keine Anfragen erhalten hat, replica.lag.time.max.ms, wird er versuchen, den ISR auf sich selbst zu komprimieren, kann dies aber nicht tun, da keine Verbindung zu Zookeeper besteht, also hört er auf, Aufzeichnungen anzunehmen.
In der Zwischenzeit wird Zookeeper den isolierten Broker als tot markieren, und der Controller wählt einen neuen Leader aus.
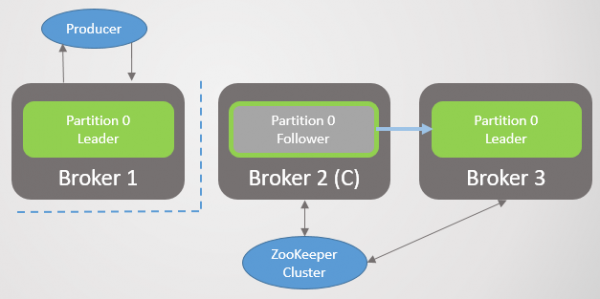
Abb. 33. Szenario 6. Zwei Leader
Der ursprüngliche Leader kann für einige Sekunden Aufzeichnungen empfangen, hört dann aber auf, irgendwelche Nachrichten anzunehmen. Die Clients werden alle 60 Sekunden mit den neuesten Metadaten aktualisiert. Sie werden über den Wechsel des Leaders informiert und beginnen, Aufzeichnungen an den neuen Leader zu senden.
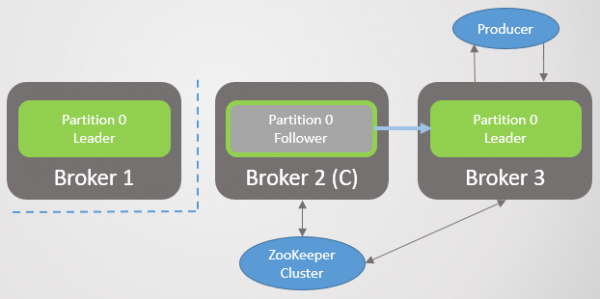
Abb. 34. Szenario 6. Produzenten wechseln zu dem neuen Leader
Alle bestätigten Einträge, die der ursprüngliche Leader seit dem Verlust der Verbindungsfähigkeit gemacht hat, gehen verloren. Sobald das Netzwerk wiederhergestellt ist, wird der ursprüngliche Leader über Zookeeper feststellen, dass er nicht mehr Leader ist. Er wird dann sein Protokoll bis zum HW des neuen Leaders zum Zeitpunkt der Wahl kürzen und beginnt, Anfragen als Follower zu senden.
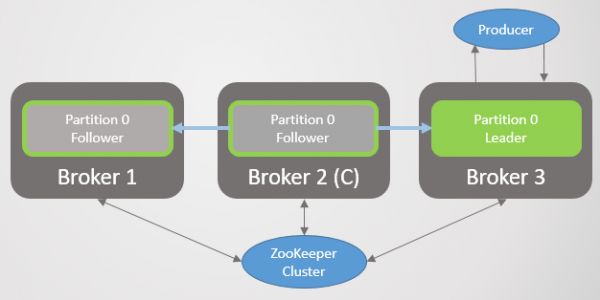
Abb. 35. Szenario 6. Der ursprüngliche Leader wird Follower nach der Wiederherstellung der Netzwerkverbindung
In dieser Situation kann für einen kurzen Zeitraum eine logische Trennung beobachtet werden, aber nur wenn acks=1 und min.insync.replicas auch 1. Die logische Trennung endet automatisch entweder nach der Wiederherstellung des Netzwerks, wenn der ursprüngliche Leader versteht, dass er nicht mehr Leader ist, oder wenn alle Clients verstehen, dass der Leader gewechselt hat und beginnen, an den neuen Leader zu schreiben – je nachdem, was zuerst eintritt. In jedem Fall werden einige Nachrichten verloren gehen, aber nur mit acks=1.
Es gibt eine andere Möglichkeit dieses Szenarios, bei der die Follower kurz vor der Netzwerktrennung zurückgefallen sind und der Leader ISR auf nur sich selbst komprimiert hat. Dann isoliert er sich aufgrund des Verlusts der Verbindung. Ein neuer Leader wird gewählt, aber der ursprüngliche Leader akzeptiert weiterhin Einträge, selbst acks=all, weil außer ihm niemand im ISR ist. Diese Einträge gehen nach der Wiederherstellung des Netzwerks verloren. Der einzige Weg, dieses Szenario zu vermeiden, ist min.insync.replicas = 2.
Szenario 7. Kafka-Controller sieht keinen anderen Kafka-Knoten
Im Allgemeinen kann der Controller nach dem Verlust der Verbindung zu einem Kafka-Knoten diesem keine Informationen über den Wechsel des Leaders übermitteln. Im schlimmsten Fall führt dies zu einer kurzfristigen logischen Trennung, wie in Szenario 6. Am häufigsten wird der Broker einfach kein Kandidat für die Führungsposition im Falle eines Ausfalls des letzten.
Szenario 8. Kafka-Controller sieht Zookeeper nicht
Der abgetrennte Zookeeper-Controller erhält kein Pinging und wählt einen neuen Kafka-Knoten als Controller. Der ursprüngliche Controller kann weiterhin als solcher auftreten, erhält jedoch keine Benachrichtigungen von Zookeeper, sodass er keine Aufgaben auszuführen hat. Sobald das Netzwerk wiederhergestellt ist, wird er verstehen, dass er kein Controller mehr ist, sondern ein gewöhnlicher Kafka-Knoten geworden ist.
Schlussfolgerungen aus den Szenarien
Es ist zu beobachten, dass der Verlust der Konnektivität von Followern nicht zu einem Verlust von Nachrichten führt, sondern lediglich vorübergehend die Redundanz verringert, bis das Netzwerk wiederhergestellt ist. Dies kann natürlich zu Datenverlust führen, wenn ein oder mehrere Knoten verloren gehen.
Wenn durch den Verlust der Konnektivität der Leader vom Zookeeper getrennt wird, kann dies zu einem Verlust von Nachrichten führen mit acks=1. Der Verlust der Verbindung zum Zookeeper führt zu einer vorübergehenden logischen Trennung zwischen zwei Leaders. Dieses Problem wird durch den Parameter acks=all.
Parameter min.insync.replicas in zwei oder mehr Replikate ermöglicht zusätzliche Garantien, dass solche kurzfristigen Szenarien nicht zu einem Verlust von Nachrichten führen, wie im Szenario 6.
Zusammenfassung zum Verlust von Nachrichten
Lassen Sie uns alle Wege auflisten, wie man Daten in Kafka verlieren kann:
- Jeglicher Ausfall des Leaders, wenn Nachrichten mit Hilfe von acks=1
- Bestätigt wurden. Jeglicher unrein (unclean) Führungswechsel, d.h. zu einem Follower außerhalb von ISR, selbst mit acks=all
- Die Isolation des Leaders vom Zookeeper, wenn Nachrichten mit Hilfe von acks=1
- vollständiger Isolation des Leaders, der die ISR-Gruppe bereits auf sich selbst komprimiert hat. Es werden alle Nachrichten verloren gehen, selbst acks=all. Dies gilt nur, wenn min.insync.replicas=1.
- Gleichzeitige Ausfälle aller Knoten eines Segments. Da Nachrichten aus dem Speicher bestätigt werden, könnten einige noch nicht auf die Festplatte geschrieben sein. Nach dem Neustart der Server könnte es an einigen Nachrichten fehlen.
Unreine Führungswechsel können vermieden werden, indem sie entweder verboten oder eine Redundanz von mindestens zwei gewährleistet wird. Die robusteste Konfiguration ist eine Kombination von acks=all und min.insync.replicas mehr als 1.
Direkter Vergleich der Zuverlässigkeit von RabbitMQ und Kafka
Um Zuverlässigkeit und hohe Verfügbarkeit zu gewährleisten, implementieren beide Plattformen ein System der primären und sekundären Replikation. RabbitMQ hat jedoch eine Achillesferse. Bei der Wiederverbindung nach einem Ausfall verwerfen die Knoten ihre Daten, und die Synchronisation wird blockiert. Dieser doppelte Schlag gefährdet die Langlebigkeit großer Warteschlangen in RabbitMQ. Sie müssen sich entweder mit einer Verringerung der Redundanz oder mit langen Blockaden abfinden. Eine Verringerung der Redundanz erhöht das Risiko eines massiven Datenverlusts. Wenn die Warteschlangen jedoch klein sind, kann man mit kurzen Zeiträumen der Nichtverfügbarkeit (einige Sekunden) durch mehrfache Verbindungsversuche die Redundanz aufrechterhalten.
In Kafka gibt es dieses Problem nicht. Sie verwirft Daten nur an dem Punkt der Divergenz zwischen dem Leader und dem Follower. Alle gemeinsamen Daten werden gespeichert. Außerdem blockiert die Replikation das System nicht. Der Leader verarbeitet weiterhin Aufzeichnungen, während ein neuer Follower ihn einholt, sodass das Beitreten oder Wiederbeitreten zum Cluster für DevOps zu einer trivialen Aufgabe wird. Natürlich bleiben Probleme wie die Bandbreite des Netzwerks bei der Replikation bestehen. Wenn mehrere Follower gleichzeitig hinzugefügt werden, kann es zu einer Erreichungsgrenze kommen.
RabbitMQ übertrifft Kafka in der Zuverlässigkeit beim gleichzeitigen Ausfall mehrerer Server im Cluster. Wie bereits erwähnt, sendet RabbitMQ dem Publisher eine Bestätigung nur, nachdem die Nachricht auf der Festplatte beim Master und allen Spiegeln gespeichert wurde. Dies führt jedoch aus zwei Gründen zu einer zusätzlichen Verzögerung:
- fsync alle paar Hundert Millisekunden
- Den Ausfall eines Spiegels kann man erst nach Ablauf der Lebensdauer der Pakete bemerken, die die Verfügbarkeit jedes Knotens prüfen (net tick). Wenn ein Spiegel langsamer wird oder ausfällt, erhöht sich die Verzögerung.
Kafka setzt darauf, dass, wenn eine Nachricht auf mehreren Knoten gespeichert wird, die Bestätigungen erfolgen können, sobald sie im Speicher landen. Dadurch entsteht das Risiko, dass Nachrichten jeglicher Art verloren gehen (sogar acks=all, min.insync.Replikate=2) im Falle eines gleichzeitigen Ausfalls.
Insgesamt zeigt Kafka eine höhere Leistung und wurde ursprünglich für Cluster konzipiert. Die Anzahl der Follower kann auf bis zu 11 erhöht werden, wenn dies aus Zuverlässigkeitsgründen erforderlich ist. Ein Replikationsfaktor von 5 und eine minimale Anzahl synchronisierter Replikate min.insync.replicas=3 machen den Verlust von Nachrichten zu einem sehr seltenen Ereignis. Wenn Ihre Infrastruktur diese Replikationsrate und den Redundanzgrad gewährleisten kann, können Sie diese Option wählen.
Die Clusterbildung von RabbitMQ ist gut für kleine Warteschlangen. Aber selbst kleine Warteschlangen können bei hohem Traffic schnell wachsen. Sobald die Warteschlangen groß werden, müssen schwierige Entscheidungen zwischen Verfügbarkeit und Zuverlässigkeit getroffen werden. Die Clusterbildung von RabbitMQ ist am besten für nicht alltägliche Situationen geeignet, in denen die Vorteile der Flexibilität von RabbitMQ alle Nachteile seiner Clusterbildung überwiegen.
Eines der Gegenmittel gegen die Schwachstelle von RabbitMQ in Bezug auf große Warteschlangen besteht darin, sie in viele kleinere aufzuteilen. Wenn eine vollständige Reihenfolge der gesamten Warteschlange nicht erforderlich ist, sondern nur für die entsprechenden Nachrichten (z. B. Nachrichten eines bestimmten Kunden), oder wenn überhaupt keine Reihenfolge erforderlich ist, ist diese Option akzeptabel: Schauen Sie sich mein Projekt an. zum Aufteilen der Warteschlange (das Projekt befindet sich noch in der frühen Phase).
Vergessen Sie schließlich nicht die Vielzahl von Bugs in den Cluster- und Replikationsmechanismen sowohl von RabbitMQ als auch von Kafka. Im Laufe der Zeit sind die Systeme reifer und stabiler geworden, aber keine Nachricht wird jemals zu 100 % vor Verlust geschützt sein! Darüber hinaus gibt es in Rechenzentren großflächige Ausfälle!
Wenn ich etwas übersehen habe, einen Fehler gemacht habe oder Sie mit einer der Behauptungen nicht einverstanden sind, zögern Sie nicht, einen Kommentar zu hinterlassen oder mich zu kontaktieren.
Ich werde oft gefragt: „Was soll man wählen, Kafka oder RabbitMQ?“, „Welche Plattform ist besser?“. Die Wahrheit ist, dass es wirklich von Ihrer Situation, Ihren aktuellen Erfahrungen usw. abhängt. Ich scheue mich, meine Meinung zu äußern, da es eine erhebliche Vereinfachung wäre, eine einzige Plattform für alle Anwendungsfälle und potenziellen Einschränkungen zu empfehlen. Ich habe diese Artikelreihe geschrieben, damit Sie sich eine eigene Meinung bilden können.
Ich möchte sagen, dass beide Systeme führend auf diesem Gebiet sind. Möglicherweise bin ich ein wenig voreingenommen, da ich aus meinen Projekterfahrungen stärker dazu neige, solche Dinge wie die garantierte Reihenfolge von Nachrichten und Zuverlässigkeit zu schätzen.
Ich sehe andere Technologien, denen diese Zuverlässigkeit und garantierte Reihenfolge fehlen, und schaue dann auf RabbitMQ und Kafka – und verstehe den unglaublichen Wert beider Systeme.
Quelle: habr.com
