

Failover und hohe Verfügbarkeit sind große Themen, daher widmen wir RabbitMQ und Kafka separate Artikel. Dieser Artikel handelt von RabbitMQ, während der nächste über Kafka im Vergleich zu RabbitMQ sein wird. Der Artikel ist lang, also machen Sie es sich bequem.
Wir betrachten Strategien zur Fehlertoleranz, Konsistenz und hohen Verfügbarkeit (HA) sowie die Kompromisse, die man in jeder Strategie eingehen muss. RabbitMQ kann auf einem Cluster von Knoten arbeiten und wird dann als verteiltes System klassifiziert. Wenn es um verteilte Systeme geht, sprechen wir oft von Konsistenz und Verfügbarkeit.
Diese Begriffe beschreiben, wie sich das System im Falle eines Ausfalls verhält. Netzwerkunterbrechungen, Serverausfälle, Festplattenfehler, temporäre Nichtverfügbarkeit des Servers aufgrund von Garbage Collection, Paketverluste oder langsame Netzwerkverbindungen. All dies kann zu Datenverlust oder Konflikten führen. Es scheint praktisch unmöglich zu sein, ein System gleichzeitig vollständig konsistent (ohne Datenverlust, ohne inkonsistente Daten) und für alle Ausfallvarianten verfügbar zu machen (es wird Lese- und Schreiboperationen annehmen).
Wir werden sehen, dass Konsistenz und Verfügbarkeit an entgegengesetzten Enden des Spektrums stehen und Sie auswählen müssen, in welche Richtung Sie optimieren möchten. Die gute Nachricht ist, dass dies mit RabbitMQ möglich ist. Sie haben gewissermaßen „Nerd“-Hebel, um das Gleichgewicht zugunsten von mehr Konsistenz oder mehr Verfügbarkeit zu verschieben.
Wir werden besonderes Augenmerk darauf legen, welche Konfigurationen zu Datenverlust aufgrund bestätigter Nachrichten führen. Es gibt eine Verantwortungskette zwischen Publishern, Brokern und Verbrauchern. Sobald eine Nachricht an den Broker übergeben wurde, liegt es an ihm, die Nachricht nicht zu verlieren. Wenn der Broker dem Publisher den Empfang der Nachricht bestätigt, erwarten wir nicht, dass sie verloren geht. Aber wir werden sehen, dass dies tatsächlich je nach Konfiguration Ihres Brokers und Publishers eintreten kann.
Primitiven der Fehlertoleranz eines Knotens
Fehlertolerante Warteschlangen/Routing
In RabbitMQ gibt es zwei Arten von Warteschlangen: langlebige (durable) und nicht-langlebige (non-durable). Alle Warteschlangen werden in der Mnesia-Datenbank gespeichert. Langlebige Warteschlangen werden beim Starten des Knotens erneut deklariert und überstehen somit einen Neustart, einen Systemausfall oder einen Serverfehler (sofern die Daten gespeichert bleiben). Das bedeutet, dass solange Sie das Routing (exchange) und die Warteschlange als langlebig deklarieren, die Infrastruktur der Warteschlangen/Routings in den Betriebszustand zurückkehrt.
Nicht-langlebige Warteschlangen und -routing werden beim Neustart des Knotens gelöscht.
Langlebige Nachrichten
Nur weil eine Warteschlange langlebig ist, bedeutet das nicht, dass alle ihre Nachrichten den Neustart des Knotens überstehen. Es werden nur die Nachrichten wiederhergestellt, die vom Publisher als langlebig (persistent) festgelegt wurden. Langlebige Nachrichten verursachen tatsächlich zusätzliche Belastung für den Broker, aber wenn der Verlust einer Nachricht inakzeptabel ist, gibt es keinen anderen Weg.
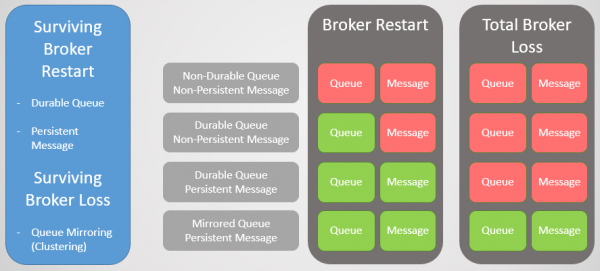
Abb. 1. Lebensdauer-Matrix
Clusterbildung mit Warteschlangen-Spiegelung
Um den Verlust eines Brokers zu überstehen, benötigen wir Redundanz. Wir können mehrere RabbitMQ-Knoten in einem Cluster zusammenfassen und dann zusätzliche Redundanz durch Replikation von Warteschlangen zwischen mehreren Knoten hinzufügen. So verlieren wir keine Daten und bleiben erreichbar, selbst wenn ein Knoten ausfällt.
Warteschlangen-Spiegelung:
- eine Hauptwarteschlange (Master), die alle Lese- und Schreibbefehle empfängt
- ein oder mehrere Spiegel, die alle Nachrichten und Metadaten aus der Hauptwarteschlange erhalten. Diese Spiegel existieren nicht zum Skalieren, sondern ausschließlich zur Redundanz.
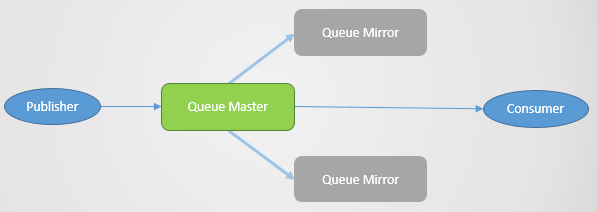
Abb. 2. Warteschlangen-Spiegelung
Die Spiegelung wird durch die entsprechende Richtlinie festgelegt. In dieser können Sie den Replikationsfaktor und sogar die Knoten auswählen, auf denen die Warteschlange platziert werden soll. Beispiele:
ha-mode: allha-mode: exactly, ha-params: 2(ein Master und ein Spiegel)ha-mode: nodes, ha-params: rabbit@node1, rabbit@node2
Bestätigung an den Publisher
Um eine konsistente Nachrichtenaufzeichnung zu erreichen, sind Bestätigungen an den Publisher (Publisher Confirms) erforderlich. Ohne diese besteht das Risiko des Verlusts von Nachrichten. Die Bestätigung wird an den Publisher gesendet, nachdem die Nachricht auf die Festplatte geschrieben wurde. RabbitMQ schreibt Nachrichten nicht beim Empfang, sondern in regelmäßigen Abständen, in der Regel alle paar hundert Millisekunden, auf die Festplatte. Wenn die Warteschlange gespiegelt wird, erfolgt die Bestätigung erst, nachdem auch alle Spiegel ihre Kopie der Nachricht auf die Festplatte geschrieben haben. Das bedeutet, dass die Verwendung von Bestätigungen Verzögerungen mit sich bringt, aber wenn Datensicherheit wichtig ist, sind sie notwendig.
Fehlertolerante Warteschlange
Wenn der Broker heruntergefahren wird oder ausfällt, fallen alle Hauptwarteschlangen (Master) auf diesem Knoten mit ihm aus. Dann wählt der Cluster das älteste Spiegelbild jedes Masters aus und fördert es zum neuen Master.
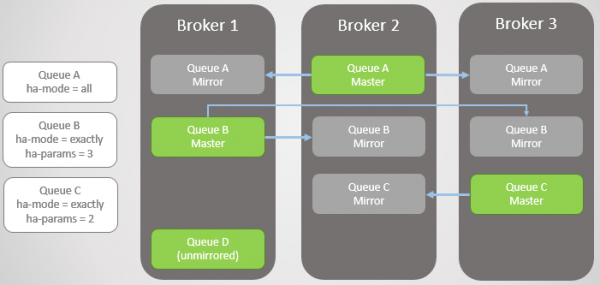
Abb. 3. Mehrere gespiegelte Warteschlangen und ihre Richtlinien
Broker 3 fällt aus. Beachten Sie, dass das Spiegelbild der Warteschlange C auf Broker 2 zum Master befördert wird. Beachten Sie auch, dass ein neues Spiegelbild der Warteschlange C auf Broker 1 erstellt wurde. RabbitMQ versucht immer, den in Ihren Richtlinien angegebenen Replikationsfaktor aufrechtzuerhalten.
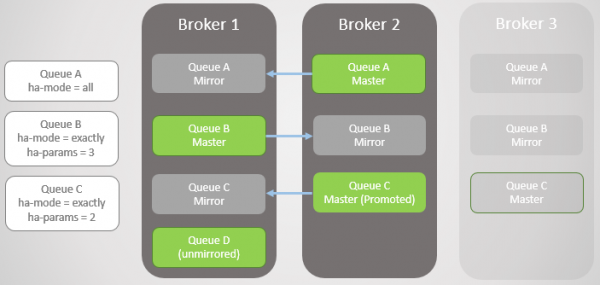
Abb. 4. Broker 3 fällt aus, was zum Ausfall der Warteschlange C führt
Der nächste Broker 1 fällt aus! Wir haben nur noch einen Broker. Das Spiegelbild der Warteschlange B wird zum Master befördert.
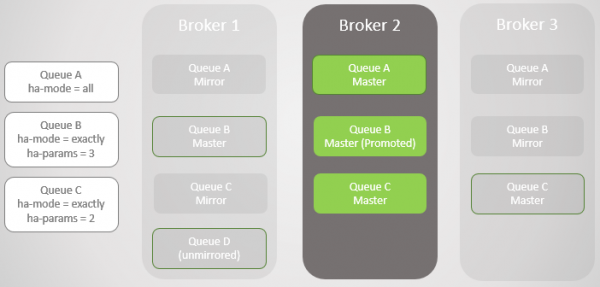
Abbildung 5
Wir haben Broker 1 wiederhergestellt. Unabhängig davon, wie erfolgreich die Daten den Verlust und die Wiederherstellung des Brokers überstanden haben, werden alle gespiegelten Nachrichten der Warteschlange beim Neustart verworfen. Dies ist wichtig zu beachten, da es Konsequenzen hat. Diese Konsequenzen werden wir bald betrachten. Broker 1 ist nun wieder ein Mitglied des Clusters, und der Cluster versucht, die Richtlinien einzuhalten und erstellt daher Spiegelbilder auf Broker 1.
In diesem Fall war der Verlust von Broker 1 vollständig, ebenso wie die Daten, daher ist die nicht gespiegelte Warteschlange B vollständig verloren.
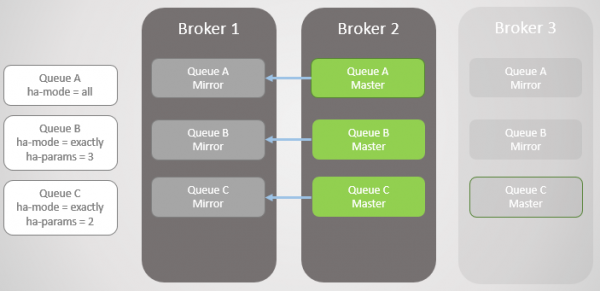
Abb. 6. Broker 1 kehrt in den Dienst zurück
Broker 3 ist wieder betriebsbereit, sodass die Warteschlangen A und B ihre auf ihm erstellten Spiegel zurückbekommen, um ihre HA-Politiken zu erfüllen. Doch jetzt befinden sich alle Hauptwarteschlangen auf einem Knoten! Das ist nicht ideal, eine gleichmäßige Verteilung zwischen den Knoten wäre besser. Leider gibt es hier keine besonderen Optionen zur Umverteilung der Master. Wir werden dieses Problem später erneut aufgreifen, da wir zuerst die Synchronisation der Warteschlange betrachten müssen.
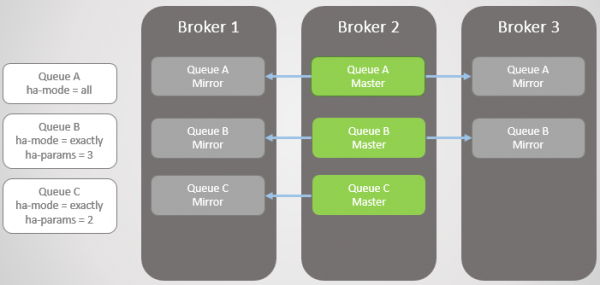
Abb. 7. Broker 3 wird wieder betriebsbereit. Alle Hauptwarteschlangen auf einem Knoten!
So sollten Sie jetzt eine Vorstellung davon haben, wie Spiegel Redundanz und Ausfallsicherheit bieten. Dies gewährleistet die Verfügbarkeit im Falle eines Ausfalls eines Knotens und schützt vor Datenverlust. Aber wir sind noch nicht fertig, denn tatsächlich ist alles viel komplizierter.
Synchronisierung
Wenn ein neuer Spiegel erstellt wird, werden alle neuen Nachrichten immer auf diesen Spiegel und auf alle anderen repliziert. Was die bestehenden Daten in der Hauptwarteschlange betrifft, können wir sie in den neuen Spiegel replizieren, der eine vollständige Kopie des Masters wird. Wir können auch entscheiden, bestehende Nachrichten nicht zu replizieren und der Hauptwarteschlange und dem neuen Spiegel die Zeit zu lassen, sich beim Eingang neuer Nachrichten, während bestehende Nachrichten den Kopf der Hauptwarteschlange verlassen.
Eine solche Synchronisation erfolgt automatisch oder manuell und wird durch Warteschlangenrichtlinien gesteuert. Sehen wir uns ein Beispiel an.
Wir haben zwei gespiegelte Warteschlangen. Warteschlange A synchronisiert sich automatisch, während Warteschlange B manuell synchronisiert wird. In beiden Warteschlangen befinden sich zehn Nachrichten.
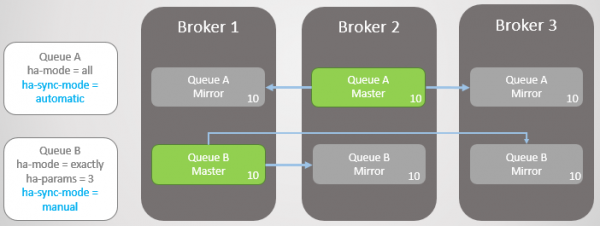
Abb. 8. Zwei Warteschlangen mit unterschiedlichen Synchronisationsmodi
Nun verlieren wir Broker 3.
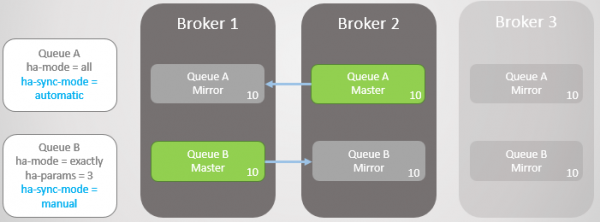
Abb. 9. Broker 3 ist ausgefallen
Broker 3 wird wieder betriebsbereit. Der Cluster erstellt einen Spiegel für jede Warteschlange auf dem neuen Knoten und synchronisiert die neue Warteschlange A automatisch mit dem Master. Der Spiegel der neuen Warteschlange B bleibt jedoch leer. Somit haben wir vollständige Redundanz für Warteschlange A und nur einen Spiegel für die bestehenden Nachrichten von Warteschlange B.
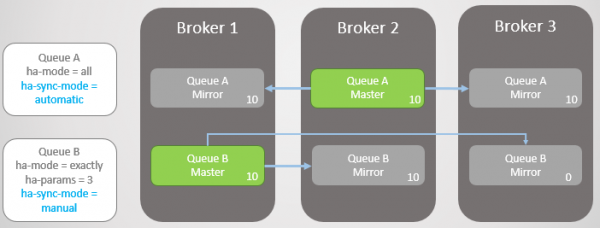
Abb. 10. Der neue Spiegel der Warteschlange A erhält alle bestehenden Nachrichten, während der neue Spiegel der Warteschlange B dies nicht tut.
In beiden Warteschlangen werden erneut jeweils zehn Nachrichten empfangen. Dann fällt Broker 2 aus, und die Warteschlange A rollt auf das älteste Spiegelbild zurück, das sich auf Broker 1 befindet. Bei einem Ausfall gibt es keinen Datenverlust. In Warteschlange B befinden sich zwanzig Nachrichten im Master und nur zehn im Spiegel, da diese Warteschlange die ursprünglichen zehn Nachrichten nie repliziert hat.
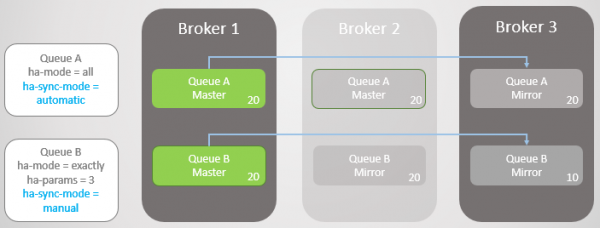
Abb. 11. Warteschlange A rollt auf Broker 1 zurück, ohne Nachrichten zu verlieren
In beiden Warteschlangen werden erneut jeweils zehn Nachrichten empfangen. Jetzt fällt Broker 1 aus. Warteschlange A wechselt problemlos auf das Spiegelbild, ohne Nachrichten zu verlieren. Allerdings hat Warteschlange B Probleme. An dieser Stelle können wir entweder Verfügbarkeit oder Konsistenz optimieren.
Wenn wir die Verfügbarkeit optimieren wollen, sollte die Richtlinie ha-promote-on-failure auf always. Dieser Wert ist der Standardwert, daher kann die Richtlinie einfach weggelassen werden. In diesem Fall akzeptieren wir im Wesentlichen Ausfälle in unsynchronisierten Spiegeln. Dies wird zu einem Nachrichtenverlust führen, aber die Warteschlange bleibt für Lese- und Schreiboperationen verfügbar.
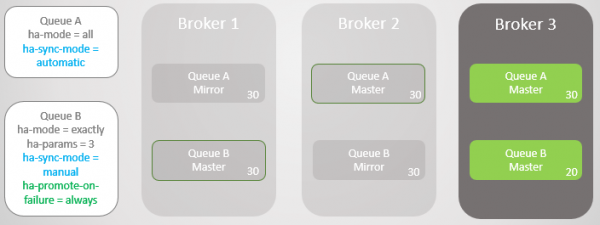
Abb. 12. Warteschlange A rollt auf Broker 3 zurück, ohne Nachrichten zu verlieren. Warteschlange B rollt auf Broker 3 zurück und verliert dabei zehn Nachrichten
Wir können auch ha-promote-on-failure auf den Wert when-synced. In diesem Fall wird die Warteschlange auf das Spiegelbild warten, anstatt zurückzurollen, bis Broker 1 mit seinen Daten wieder betriebsbereit ist. Nach seiner Rückkehr befindet sich die Hauptwarteschlange erneut auf Broker 1, ohne Datenverlust. Die Verfügbarkeit wird auf Kosten der Datensicherheit geopfert. Aber dies ist ein riskanter Modus, der sogar zu einem vollständigen Datenverlust führen kann, was wir gleich erörtern werden.
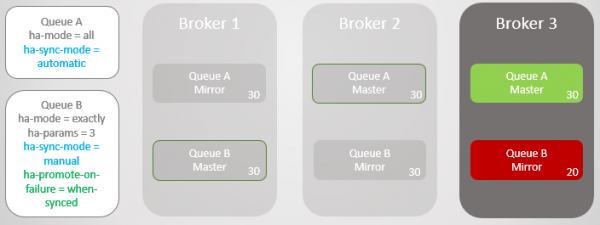
Abb. 13. Warteschlange B bleibt nach dem Ausfall von Broker 1 nicht verfügbar
Sie könnten sich fragen: „Vielleicht ist es besser, die automatische Synchronisierung niemals zu verwenden?“ Die Antwort ist, dass Synchronisierung eine blockierende Operation ist. Während der Synchronisierung kann die Hauptwarteschlange keine Lese- oder Schreiboperationen ausführen!
Betrachten wir ein Beispiel. Jetzt haben wir sehr große Warteschlangen. Wie können sie so groß werden? Aus mehreren Gründen:
- Warteschlangen werden nicht aktiv verwendet
- Dies sind Hochgeschwindigkeitswarteschlangen, und im Moment arbeiten die Verbraucher langsam
- Dies sind Hochgeschwindigkeitswarteschlangen, ein Ausfall ist aufgetreten, und die Verbraucher holen auf
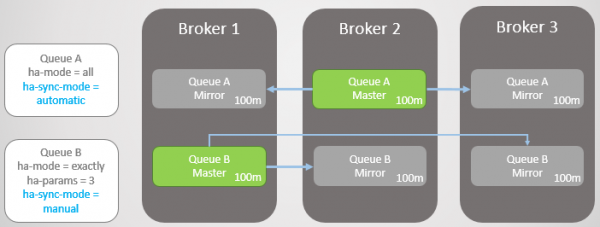
Abb. 14. Zwei große Warteschlangen mit unterschiedlichen Synchronisationsmodi
Jetzt fällt Broker 3 aus.
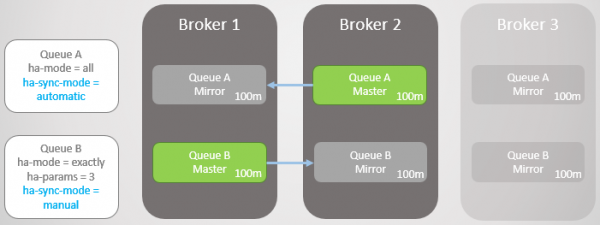
Abb. 15. Broker 3 fällt aus und hinterlässt jeweils einen Master und ein Spiegelbild in jeder Warteschlange
Broker 3 wird wieder in Betrieb genommen und es werden neue Spiegel erstellt. Die Hauptwarteschlange A beginnt mit der Replikation vorhandener Nachrichten auf das neue Spiegelbild, wobei die Warteschlange während dieser Zeit nicht verfügbar ist. Die Datenreplikation dauert zwei Stunden, was zu zwei Stunden Ausfallzeit für diese Warteschlange führt!
Die Warteschlange B bleibt jedoch während des gesamten Zeitraums verfügbar. Sie hat etwas Redundanz für die Verfügbarkeit geopfert.
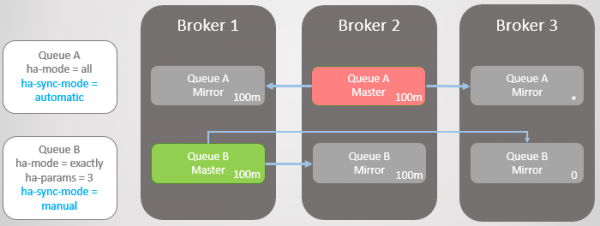
Abb. 16. Die Warteschlange ist während der Synchronisierung nicht verfügbar
Nach zwei Stunden wird auch Warteschlange A verfügbar und kann wieder Lese- und Schreiboperationen annehmen.
Updates
Dieses blockierende Verhalten während der Synchronisierung erschwert die Aktualisierung von Clustern mit sehr großen Warteschlangen. Irgendwann muss der Knoten mit dem Master neu gestartet werden, was entweder einen Wechsel zu dem Spiegelbild oder die Deaktivierung der Warteschlange während des Serverupdates bedeutet. Wenn wir den Wechsel wählen, verlieren wir Nachrichten, wenn die Spiegel nicht synchronisiert sind. Standardmäßig wird beim Ausschalten des Brokers kein Wechsel zu nicht synchronisierten Spiegeln vorgenommen. Das bedeutet, dass wir, sobald der Broker zurückkommt, keine Nachrichten verlieren; der einzige Schaden ist die Ausfallzeit der Warteschlange. Die Regeln für das Verhalten beim Ausschalten des Brokers werden durch die Politik festgelegt. ha-promote-on-shutdown. Es kann einer von zwei Werten eingestellt werden:
always= der Wechsel zu nicht synchronisierten Spiegeln ist aktiviertwhen-synced= Wechsel nur zu synchronisierten Spiegeln, andernfalls wird die Warteschlange nicht für Lese- und Schreiboperationen verfügbar. Die Warteschlange wird wieder in Betrieb genommen, sobald der Broker zurückkehrt.
So oder so muss man bei großen Warteschlangen zwischen Datenverlust und Nichtverfügbarkeit wählen.
Wenn Verfügbarkeit die Datensicherheit erhöht
Bevor eine Entscheidung getroffen wird, muss ein weiteres Komplikation berücksichtigt werden. Auch wenn die automatische Synchronisierung besser für die Redundanz ist, wie wirkt sich das auf die Datensicherheit aus? Natürlich ist RabbitMQ mit besserer Redundanz weniger wahrscheinlich, dass vorhandene Nachrichten verloren gehen, aber wie steht es um neue Nachrichten von Publishern?
Hier sind folgende Punkte zu beachten:
- Kann der Publisher einfach einen Fehler zurückgeben, und der übergeordnete Dienst oder der Benutzer versucht es später erneut?
- Kann der Publisher die Nachricht lokal oder in einer Datenbank speichern, um einen späteren Versuch zu ermöglichen?
Wenn der Publisher nur die Nachricht verwerfen kann, verbessert die Verfügbarkeit tatsächlich auch die Datensicherheit.
Daher muss ein Gleichgewicht gesucht werden, und die Entscheidung hängt von der konkreten Situation ab.
Probleme mit ha-promote-on-failure=when-synced
Idee ha-promote-on-failure= when-synced besteht darin, dass wir den Wechsel zu einem unsynchronisierten Spiegel verhindern und damit Datenverluste vermeiden. Die Warteschlange bleibt für Lese- oder Schreibvorgänge nicht verfügbar. Stattdessen versuchen wir, den ausgefallenen Broker mit intakten Daten zurückzubringen, damit er als Master ohne Datenverlust weiterarbeitet.
Aber (und das ist ein großes Aber) wenn der Broker seine Daten verloren hat, haben wir ein großes Problem: Die Warteschlange ist verloren! Alle Daten sind weg! Auch wenn Sie Spiegel haben, die größtenteils die Hauptwarteschlange einholen, werden diese Spiegel ebenfalls verworfen.
Um einen Knoten mit dem gleichen Namen neu hinzuzufügen, sagen wir dem Cluster, dass es den verlorenen Knoten vergessen soll (mit dem Befehl rabbitmqctl forget_cluster_node) und starten einen neuen Broker mit demselben Hostnamen. Solange das Cluster den verlorenen Knoten im Gedächtnis behält, merkt es sich die alte Warteschlange und die unsynchronisierten Spiegel. Wenn dem Cluster gesagt wird, dass es den verlorenen Knoten vergessen soll, wird diese Warteschlange ebenfalls vergessen. Jetzt muss sie neu deklariert werden. Wir haben alle Daten verloren, obwohl wir Spiegel mit einem teilweisen Datensatz hatten. Es wäre besser gewesen, auf einen unsynchronisierten Spiegel umzuschalten!
Daher ist eine manuelle Synchronisation (und das Ausbleiben einer Synchronisation) zusammen mit ha-promote-on-failure=when-synced, meiner Meinung nach ziemlich riskant. Dokumente besagen, dass diese Option für die Datensicherheit existiert, aber sie ist ein zweischneidiges Schwert.
Neuausbalancierung der Master
Wie versprochen, kehren wir zum Problem der Ansammlung aller Master auf einem oder mehreren Knoten zurück. Dies kann sogar durch ein „rollierendes“ Update des Clusters verursacht werden. In einem Cluster mit drei Knoten sammeln sich alle Hauptwarteschlangen auf einem oder zwei Knoten.
Die Neuausbalancierung der Master kann aus zwei Gründen problematisch sein:
- Es gibt keine guten Werkzeuge zur Durchführung einer Neuausbalancierung
- Synchronisation der Warteschlangen
Um das Gleichgewicht wiederherzustellen, gibt es ein Drittanbieter- , das offiziell nicht unterstützt wird. In der Dokumentation von RabbitMQ wird über Drittanbieter-Plugins gesagt, : „Das Plugin bietet einige zusätzliche Konfigurations- und Reporting-Tools, wird jedoch nicht von dem RabbitMQ-Team unterstützt oder getestet. Verwenden Sie es auf eigenes Risiko.“
Es gibt noch einen weiteren Trick, um die Hauptwarteschlange über HA-Richtlinien zu verschieben. In der Dokumentation wird darüber erwähnt. Es funktioniert wie folgt:
- Es entfernt alle Spiegel mithilfe einer temporären Richtlinie mit höherer Priorität als die vorhandene HA-Richtlinie.
- Es ändert die temporäre HA-Richtlinie, um den ‚Knoten‘-Modus zu verwenden, wobei der Knoten angegeben wird, auf den die Hauptwarteschlange verschoben werden soll.
- Es synchronisiert die Warteschlange für die erzwungene Migration.
- Nach Abschluss der Migration wird die temporäre Richtlinie entfernt. Die ursprüngliche HA-Richtlinie tritt in Kraft, und es werden die erforderliche Anzahl an Spiegeln erstellt.
Der Nachteil besteht darin, dass dieser Ansatz möglicherweise nicht funktioniert, wenn Sie große Warteschlangen oder strenge Anforderungen an die Redundanz haben.
Jetzt schauen wir uns an, wie RabbitMQ-Cluster mit Netzwerkpartitionen umgehen.
Netzwerkunterbrechungen
Die Knoten eines verteilten Systems sind durch Netzwerkverbindungen miteinander verbunden, und diese Verbindungen können und werden ausfallen. Die Häufigkeit von Ausfällen hängt von der lokalen Infrastruktur oder der Zuverlässigkeit der gewählten Cloud ab. Auf jeden Fall sollten verteilte Systeme in der Lage sein, damit umzugehen. Wieder stehen wir vor der Wahl zwischen Verfügbarkeit und Konsistenz, und erneut ist die gute Nachricht, dass RabbitMQ beide Optionen bietet (nur nicht gleichzeitig).
Mit RabbitMQ haben wir zwei Hauptoptionen:
- Logische Partitionierung (split-brain) erlauben. Dies gewährleistet Verfügbarkeit, kann jedoch zu Datenverlust führen.
- Logische Partitionierung verbieten. Dies kann kurzfristig zu einem Verlust der Verfügbarkeit führen, abhängig davon, wie die Clients mit dem Cluster verbunden sind. Es kann auch zur vollständigen Unzugänglichkeit des Clusters bei zwei Knoten führen.
Aber was ist logische Partitionierung? Das ist, wenn der Cluster aufgrund von Netzwerkverbindungsverlust in zwei Teile geteilt wird. Auf jeder Seite werden die Spiegel zu Meistern befördert, sodass am Ende mehrere Meister auf jede Warteschlange kommen.
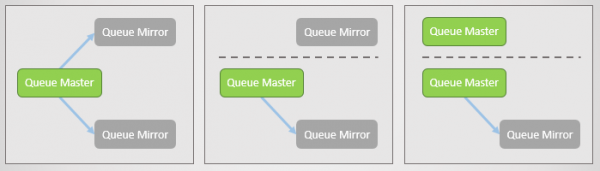
Abb. 17. Die Hauptwarteschlange und zwei Spiegel, jeweils an einem separaten Knoten. Dann tritt ein Netzwerkfehler auf, und ein Spiegel trennt sich. Der getrennte Knoten sieht, dass zwei andere abgebrochen sind, und befördert seine Spiegel zum Master. Jetzt haben wir zwei Hauptwarteschlangen, und beide erlauben Schreib- und Lesezugriffe.
Wenn Publisher Daten an beide Master senden, haben wir zwei divergente Kopien der Warteschlange.
Die verschiedenen Modi von RabbitMQ gewährleisten entweder Verfügbarkeit oder Konsistenz.
Modus Ignore (Standardmodus)
Dieser Modus gewährleistet die Verfügbarkeit. Nach dem Verlust der Konnektivität tritt eine logische Trennung auf. Nach der Wiederherstellung der Konnektivität muss der Administrator entscheiden, welchem Partition der Vorzug gegeben wird. Die unterlegene Seite wird neu gestartet, und alle gesammelten Daten dieser Seite gehen verloren.
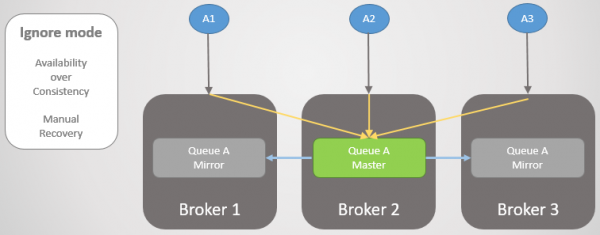
Abb. 18. Drei Publisher sind mit drei Brokern verbunden. Intern leitet der Cluster alle Anfragen an die Hauptwarteschlange auf Broker 2.
Jetzt verlieren wir Broker 3. Er sieht, dass die anderen Broker abgebrochen sind, und befördert seinen Spiegel zum Master. So tritt eine logische Trennung ein.
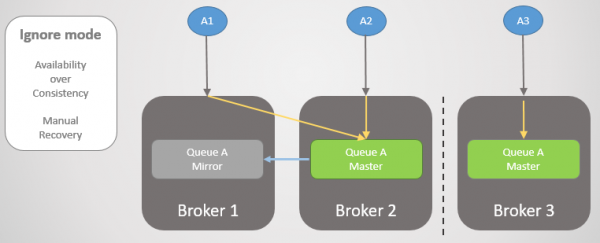
Abb. 19. Logische Trennung (split-brain). Schreibvorgänge erfolgen in zwei Hauptwarteschlangen, und zwei Kopien divergieren.
Die Konnektivität wird wiederhergestellt, aber die logische Trennung bleibt bestehen. Der Administrator muss manuell die unterlegene Seite auswählen. Im folgenden Fall startet der Administrator Broker 3 neu. Alle Nachrichten, die dieser noch nicht übermitteln konnte, gehen verloren.
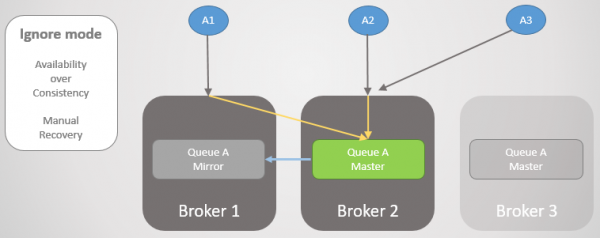
Abb. 20. Der Administrator schaltet Broker 3 aus.
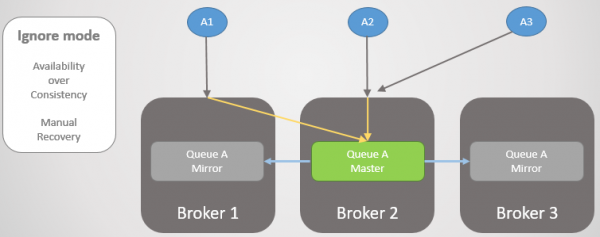
Abb. 21. Der Administrator startet Broker 3, und er tritt dem Cluster bei, wobei er alle Nachrichten verliert, die dort geblieben sind.
Während des Verlusts der Konnektivität und nach deren Wiederherstellung waren der Cluster und diese Warteschlange für Lese- und Schreibzugriffe verfügbar.
Modus Autoheal
Funktioniert ähnlich wie der Modus Ignore, mit dem Unterschied, dass der Cluster automatisch nach der Trennung und Wiederherstellung der Konnektivität die unterlegene Seite auswählt. Die unterlegene Seite kehrt leer in den Cluster zurück, und die Warteschlange verliert alle Nachrichten, die nur an diese Seite gesendet wurden.
Modus Pause Minority
Wenn wir eine logische Trennung vermeiden wollen, ist unsere einzige Option, das Lesen und Schreiben auf der kleineren Seite nach der Clustertrennung zu verweigern. Wenn der Broker sieht, dass er sich auf der kleineren Seite befindet, stoppt er den Betrieb, schließt alle bestehenden Verbindungen und lehnt alle neuen ab. Einmal pro Sekunde überprüft er die Wiederherstellung der Konnektivität. Sobald die Konnektivität wiederhergestellt ist, setzt er seine Arbeit fort und schließt sich dem Cluster wieder an.
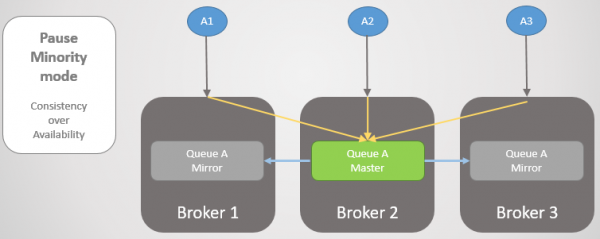
Abb. 22. Drei Publisher sind mit drei Brokern verbunden. Intern leitet das Cluster alle Anfragen an die Hauptwarteschlange auf Broker 2 weiter.
Dann trennen sich die Broker 1 und 2 von Broker 3. Anstatt sein Spiegelbild zum Master zu erheben, stoppt Broker 3 die Arbeit und wird nicht mehr verfügbar.
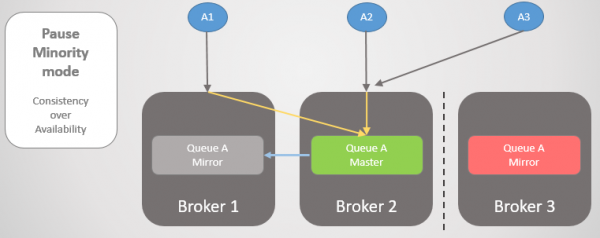
Abb. 23. Broker 3 stoppt die Arbeit, trennt alle Clients und lehnt Verbindungsgesuche ab.
Sobald die Konnektivität wiederhergestellt ist, kehrt er ins Cluster zurück.
Schauen wir uns ein anderes Beispiel an, bei dem die Hauptwarteschlange auf Broker 3 liegt.
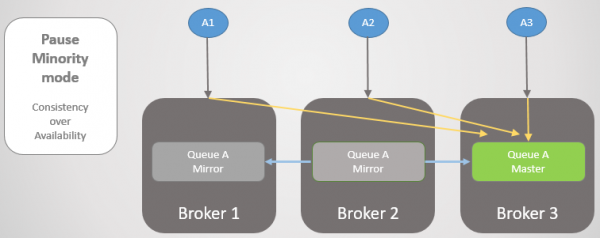
Abb. 24. Hauptwarteschlange auf Broker 3.
Dann tritt dasselbe Konnektivitätsproblem auf. Broker 3 pausiert, da er sich auf der kleineren Seite befindet. Auf der anderen Seite sehen die Knoten, dass Broker 3 ausgefallen ist, sodass das ältere Spiegelbild von Broker 1 und 2 zum Master erhoben wird.
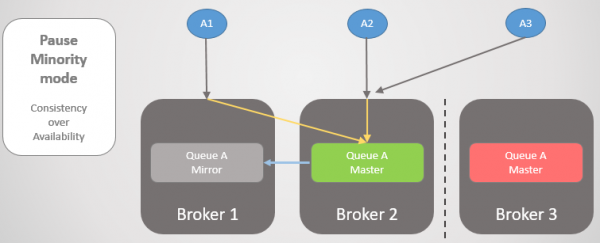
Abb. 25. Übergang zu Broker 2 bei Nichterreichbarkeit von Broker 3.
Wenn die Konnektivität wiederhergestellt ist, wird Broker 3 dem Cluster beitreten.

Abb. 26. Das Cluster ist wieder im Normalbetrieb.
Hier ist es wichtig zu verstehen, dass wir Konsistenz erzielen, aber gleichzeitig auch Verfügbarkeit erreichen können, wenn wir die Clients erfolgreich auf den größeren Teil der Partition umstellen. Für die meisten Situationen würde ich persönlich den Modus "Pause Minority" wählen, aber das hängt wirklich vom spezifischen Fall ab.
Für die Gewährleistung der Verfügbarkeit ist es wichtig sicherzustellen, dass die Clients erfolgreich mit dem Knoten verbunden werden. Schauen wir uns unsere Optionen an.
Gewährleistung der Konnektivität der Clients
Wir haben mehrere Optionen, um nach einem Verlust der Verbindung Kunden zum Hauptteil des Clusters oder zu den funktionierenden Knoten (nach einem Fehler eines Knotens) zu leiten. Lassen Sie uns zunächst daran erinnern, dass eine bestimmte Warteschlange auf einem bestimmten Knoten platziert ist, aber die Routen und Richtlinien auf allen Knoten repliziert werden. Kunden können sich mit jedem Knoten verbinden, und das interne Routing leitet sie dorthin, wo sie hin müssen. Wenn jedoch ein Knoten ausgesetzt ist, wird er Verbindungen ablehnen, sodass sich die Kunden mit einem anderen Knoten verbinden müssen. Wenn ein Knoten ausgefallen ist, kann er überhaupt nichts tun.
Unsere Optionen:
- Der Zugang zum Cluster erfolgt über einen Lastenausgleich, der einfach zyklisch die Knoten durchläuft, während die Kunden Wiederholungsversuche zur Verbindung durchführen, bis sie erfolgreich sind. Wenn ein Knoten nicht funktioniert oder ausgesetzt ist, schlagen die Versuche, sich mit diesem Knoten zu verbinden, fehl, aber die folgenden Versuche werden an andere Server weitergeleitet (im zyklischen Modus). Dies eignet sich für kurzfristige Verbindungsverluste oder einen ausgefallenen Server, der schnell wiederhergestellt wird.
- Zugang zum Cluster über einen Lastenausgleich und sofortige Entfernung von ausgesetzten/fehlgeschlagenen Knoten aus der Liste, sobald sie erkannt werden. Wenn dies schnell geschieht und die Kunden in der Lage sind, Wiederholungsversuche durchzuführen, erhalten wir eine ständige Verfügbarkeit.
- Jeden Kunden eine Liste aller Knoten geben, und der Kunde wählt beim Verbinden zufällig einen davon aus. Wenn er bei dem Verbindungsversuch einen Fehler erhält, wechselt er zum nächsten Knoten in der Liste, bis er verbunden ist.
- Leiten Sie den Datenverkehr von einem ausgefallenen/ausgesetzten Knoten über DNS um. Dies geschieht mit einer kurzen TTL.
Das DBMS Tarantool ist ein attraktives, zukunftsträchtiges Produkt zur Erstellung von hochbelasteten Anwendungen.
Die Clusterbildung von RabbitMQ hat ihre eigenen Vor- und Nachteile. Die schwerwiegendsten Nachteile sind:
- bei der Verbindung zum Cluster verwerfen die Knoten ihre Daten;
- die blockierende Synchronisierung führt zur Unzugänglichkeit der Warteschlange.
Alle schwierigen Entscheidungen ergeben sich aus diesen beiden Merkmalen der Architektur. Wenn RabbitMQ Daten beim Wiederverbinden des Clusters speichern könnte, würde die Synchronisierung schneller erfolgen. Wenn es in der Lage wäre, nicht-blockierende Synchronisierung zu unterstützen, könnte es große Warteschlangen besser verwalten. Die Behebung dieser beiden Probleme würde die Eigenschaften von RabbitMQ als ausfallsichere und hochverfügbare Messaging-Technologie erheblich verbessern. Ich würde nicht empfehlen, RabbitMQ mit Clusterbildung in den folgenden Situationen einzusetzen:
- Unzuverlässiges Netzwerk.
- Unzuverlässige Speicherung.
- Sehr große Warteschlangen.
Was die Einstellungen für hohe Verfügbarkeit betrifft, so ziehen Sie Folgendes in Betracht:
ha-promote-on-failure=alwaysha-sync-mode=manualcluster_partition_handling=ignore(oderautoheal)- Persistente Nachrichten
- Stellen Sie sicher, dass die Clients mit dem aktiven Knoten verbunden sind, wenn ein Knoten ausfällt
Für Konsistenz (Datensicherheit) ziehen Sie folgende Einstellungen in Betracht:
- Publisher Confirms und manuelle Bestätigungen auf der Verbraucherseite
ha-promote-on-failure=when-synced, wenn die Publisher später erneut versuchen können und wenn Sie eine sehr zuverlässige Speicherung haben! Andernfalls setzen Sie=always.ha-sync-mode=automatic(aber für große inaktive Warteschlangen kann ein manueller Modus erforderlich sein; außerdem überlegen Sie, ob die Nichtverfügbarkeit zum Verlust von Nachrichten führen könnte)- Pause-Minority-Modus
- Persistente Nachrichten
Wir haben noch nicht alle Fragen zur Ausfallsicherheit und hochverfügbaren Verfügbarkeit behandelt; zum Beispiel, wie man administrative Verfahren sicher durchführt (wie rollierende Updates). Auch über die Föderation und das Shovel-Plugin muss gesprochen werden.
Wenn ich noch etwas übersehen habe, lassen Sie es mich bitte wissen.
Siehe auch meinen , in dem ich ein Chaos im RabbitMQ-Cluster mit Docker und Blockade verursache, um einige der in diesem Artikel beschriebenen Verlustszenarien zu überprüfen.
Frühere Artikel der Serie:
Nr. 1 —
Nr. 2 —
Nr. 3 —
Quelle: habr.com
