

Ideen und Treffen darüber, welche Prozesse im Alltag unterschiedlicher Unternehmen weiter automatisiert werden können, entstehen täglich. Aber neben der Tatsache, dass viel Zeit in die Erstellung eines Modells investiert werden kann, muss auch Zeit für die Bewertung und Überprüfung aufgewendet werden, ob das erzielte Ergebnis zufällig ist oder nicht. Nach der Implementierung muss jedes Modell kontinuierlich überwacht und regelmäßig überprüft werden.
All diese Schritte müssen in jedem Unternehmen unabhängig von seiner Größe durchlaufen werden. Wenn wir über den Umfang und das Erbe der Sberbank sprechen, nehmen die Anzahl der feinen Anpassungen erheblich zu. Bis Ende 2019 wurden in Sber bereits über 2000 Modelle genutzt. Es ist nicht genug, lediglich ein Modell zu entwickeln; es ist notwendig, sich mit industriellen Systemen zu integrieren, Datensichten für die Modellerstellung zu entwickeln und die Kontrolle über deren Funktion im Cluster zu gewährleisten.
Unser Team entwickelt die Plattform Sber.DS. Diese ermöglicht die Lösung von Aufgaben des maschinellen Lernens, beschleunigt den Prozess der Hypothesenüberprüfung, vereinfacht grundsätzlich den Entwicklungs- und Validierungsprozess von Modellen und kontrolliert zudem das Ergebnis der Modellentwicklung in der PRODUKTION.
Um Ihre Erwartungen nicht zu enttäuschen, möchte ich im Voraus sagen, dass dieser Beitrag eine Einführungsnotiz ist und im Weiteren zunächst erläutert wird, was sich grundsätzlich unter der Haube der Plattform Sber.DS verbirgt. Die Geschichte des Lebenszyklus eines Modells von der Erstellung bis zur Implementierung werden wir gesondert erzählen.
Sber.DS besteht aus mehreren Komponenten, wobei die wichtigsten eine Bibliothek, ein Entwicklungssystem und ein Ausführungssystem für Modelle sind.
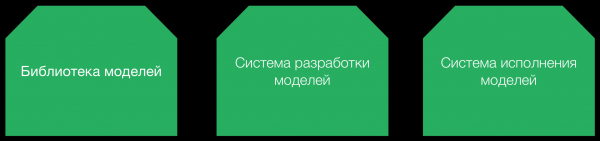
Die Bibliothek kontrolliert den Lebenszyklus eines Modells vom Moment der Idee seiner Entwicklung bis zur Implementierung in die PRODUKTION, der Überwachung und der Außerbetriebnahme. Viele Funktionen der Bibliothek sind durch die Vorschriften des Regulators diktiert, beispielsweise die Berichterstattung und die Speicherung von Trainings- und Validierungsdaten. Tatsächlich handelt es sich um ein Register all unserer Modelle.
Das Entwicklungssystem dient der visuellen Entwicklung von Modellen und Validierungsmethoden. Die entwickelten Modelle durchlaufen eine erste Validierung und werden zur Ausführung übermittelt, um ihre Geschäftsoperationen auszuführen. Auch im Ausführungssystem kann das Modell auf einen Monitor gesetzt werden, um die regelmäßige Aktivierung von Validierungsmethoden zur Kontrolle seiner Funktionsweise sicherzustellen.
Im System gibt es mehrere Arten von Knoten. Einige sind für die Verbindung mit verschiedenen Datenquellen vorgesehen, andere dienen der Transformation und Anreicherung der Ausgangsdaten (Tagging). Es gibt zahlreiche Knoten zum Erstellen verschiedener Modelle und Knoten zur Validierung dieser Modelle. Der Entwickler kann Daten aus beliebigen Quellen laden, sie transformieren, filtern, Zwischeninformationen visualisieren und in Teile zerlegen.
Die Plattform enthält auch fertige Module, die per Drag & Drop in den Projektbereich gezogen werden können. Alle Aktionen werden über eine visualisierte Schnittstelle durchgeführt. Tatsächlich kann die Aufgabe ohne eine einzige Zeile Code gelöst werden.
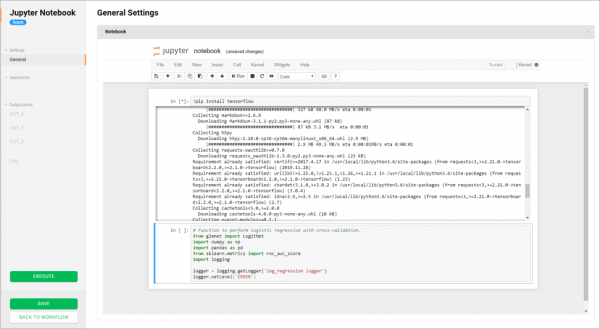
Wenn die integrierten Funktionen nicht ausreichen, bietet das System die Möglichkeit, schnell eigene Module zu erstellen. Wir haben den integrierten Entwicklungsmodus auf Basis von für diejenigen, die neue Module „von Grund auf“ entwickeln.
Die Architektur von Sber.DS basiert auf Microservices. Es gibt viele Meinungen darüber, was Microservices sind. Einige glauben, es reiche aus, monolithischen Code in Teile zu zerlegen, aber sie greifen immer noch auf dieselbe Datenbank zu. Bei uns sollte ein Microservice nur über REST API mit einem anderen Microservice kommunizieren. Es gibt keine Umgehungsmöglichkeiten, um direkt auf die Datenbank zuzugreifen.
Wir bemühen uns, dass die Dienste nicht zu groß und unhandlich werden: Eine Instanz sollte nicht mehr als 4-8 Gigabyte Arbeitsspeicher verbrauchen und die Möglichkeit der horizontalen Skalierung von Anfragen durch das Starten neuer Instanzen bieten. Jeder Dienst kommuniziert nur über REST API (). Das Team, das für den Dienst verantwortlich ist, muss die Rückwärtskompatibilität der API bis zum letzten Kunden, der sie nutzt, aufrechterhalten.
Der Kern der Anwendung ist in Java unter Verwendung des Spring Framework geschrieben. Die Lösung wurde ursprünglich für eine schnelle Bereitstellung in der Cloud-Infrastruktur konzipiert, daher wurde die Anwendung unter Verwendung eines Containerisierungssystems aufgebaut (). Die Plattform entwickelt sich ständig weiter, sowohl in Bezug auf den Ausbau der Geschäftsfunktionalität (es werden neue Konnektoren, AutoML hinzugefügt), als auch hinsichtlich der technologischen Effizienz.
Eine der „Besonderheiten“ unserer Plattform besteht darin, dass wir Code, der in einer visuellen Schnittstelle entwickelt wurde, auf jedem Ausführungssystem der Sberbank-Modelle ausführen können. Derzeit gibt es bereits zwei: eines auf Hadoop, das andere auf OpenShift (Docker). Wir ruhen uns darauf nicht aus und entwickeln Integrationsmodule, um Code auf jeder Infrastruktur auszuführen, einschließlich On-Premise und in der Cloud. In Bezug auf die Möglichkeiten für eine effektive Integration in das Ökosystem der Sberbank planen wir auch, die Arbeit mit bestehenden Ausführungsumgebungen zu unterstützen. Perspektivisch kann die Lösung flexibel „out of the box“ in jede Landschaft jeder Organisation integriert werden.
Diejenigen, die jemals versucht haben, eine Lösung zu unterstützen, die Python auf Hadoop in der Produktion ausführt, wissen, dass es nicht ausreicht, die Benutzerumgebung für Python auf jedem Datenknoten vorzubereiten und bereitzustellen. Eine große Anzahl von C/C++-Bibliotheken für maschinelles Lernen, die Python-Module nutzen, lässt Ihnen keine Ruhe. Man darf nicht vergessen, die Pakete beim Hinzufügen neuer Bibliotheken oder Server zu aktualisieren, um die Rückwärtskompatibilität mit bereits implementiertem Modellcode zu gewährleisten.
Es gibt mehrere Ansätze, um dies zu tun. Zum Beispiel kann man im Voraus mehrere häufig verwendete Bibliotheken vorbereiten und in die Produktion einfügen. In der Hadoop-Distribution von Cloudera wird dafür in der Regel verwendet . Auch in Hadoop gibt es jetzt die Möglichkeit, -Container zu starten. In einigen einfachen Fällen kann man den Code zusammen mit dem Paket .
Die Bank legt großen Wert auf die Sicherheit der Ausführung von fremdem Code, deshalb nutzen wir die neuen Möglichkeiten des Linux-Kerns, wo der in einer isolierten Umgebung gestartete Prozess zum Beispiel im Hinblick auf den Zugriff auf das Netzwerk und die lokale Festplatte eingeschränkt werden kann, was die Möglichkeiten für schädlichen Code erheblich reduziert. Die Datenbereiche jeder Abteilung sind geschützt und nur für die Eigentümer dieser Daten zugänglich. Die Plattform garantiert, dass Daten aus einem Bereich nur durch einen Veröffentlichungsprozess mit Kontrolle in allen Phasen von der Zugriff auf die Datenquellen bis zum Platzieren der Daten in der Zielausstellung in einen anderen Bereich gelangen können.
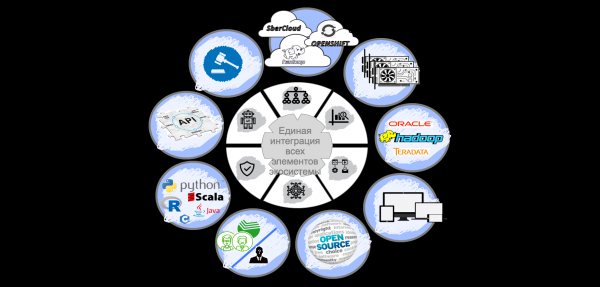
In diesem Jahr planen wir, den MVP-Start von Modellen, die in Python/R/Java auf Hadoop geschrieben sind, abzuschließen. Wir haben uns das ehrgeizige Ziel gesetzt, jeden benutzerdefinierten Environment auf Hadoop zu starten, um unsere Plattformnutzern keine Einschränkungen zu auferlegen.
Darüber hinaus haben sich viele Data-Science-Spezialisten als sehr gut in Mathematik und Statistik erwiesen, sie erstellen großartige Modelle, sind jedoch nicht mit der Verarbeitung großer Datenmengen vertraut. Sie benötigen die Unterstützung unserer Data Engineers zur Vorbereitung von Trainingsdatensätzen. Wir haben beschlossen, unseren Kollegen zu helfen und benutzerfreundliche Module für die typische Transformation und Vorbereitung von Features für Modelle auf dem Spark-Framework zu erstellen. Dies wird es ermöglichen, mehr Zeit der Modellentwicklung zu widmen und nicht darauf zu warten, dass die Data Engineers einen neuen Datensatz vorbereiten.
Bei uns arbeiten Menschen mit Kenntnissen in verschiedenen Bereichen: Linux und DevOps, Hadoop und Spark, Java und Spring, Scala und Akka, OpenShift und Kubernetes. Im nächsten Mal werden wir über die Modellbibliothek berichten, darüber, wie ein Modell im Unternehmen den Lebenszyklus durchläuft, wie die Validierung und Implementierung erfolgt.
Quelle: habr.com
