

Ich möchte von einem neuen CLI-Tool erzählen, das ich entwickelt habe, um ein altes Problem zu lösen.
Problem
Terraform ist längst zum Standard in der DevOps-/Cloud-/IT-Community geworden. Es ist sehr praktisch und hilfreich, um Infrastruktur als Code zu verwalten. Es gibt viele Vorteile bei Terraform, aber auch viele Fallstricke, scharfe Messer und Stolpersteine.
Mit Terraform ist es sehr einfach, neue Dinge zu erstellen und diese dann zu verwalten, zu ändern oder zu löschen. Aber was ist mit denen, die eine riesige Infrastruktur in der Cloud haben, die nicht mit Terraform erstellt wurde? Alles neu zu schreiben und die gesamte Cloud neu zu erstellen, ist ziemlich teuer und riskant.
Ich habe dieses Problem in zwei Jobs erlebt, das einfachste Beispiel ist, wenn man möchte, dass alles in Git in Form von Terraform-Dateien ist, aber man hat über 250 Buckets und es ist irgendwie viel, sie manuell für Terraform zu schreiben.
Ja Seit 2014 gab es Terraform, das 2016 eingestellt wurde, in der Hoffnung, dass eine Importfunktion kommen würde.
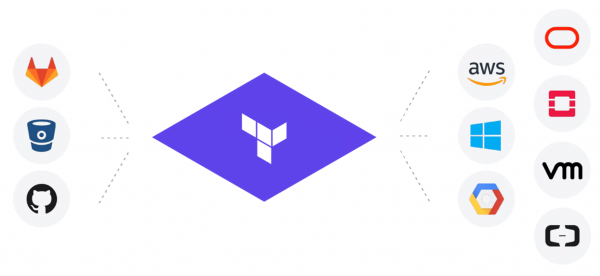
Kurz gesagt, es ist alles wie auf dem Bild, nur von rechts nach links.
Warnung: Der Autor lebt seit einem halben Leben nicht in Russland und schreibt nicht viel auf Russisch. Vorsicht, Fehler in der Rechtschreibung.
Lösungen
1. Es gibt fertige und alte Lösungen für AWS. . Als ich versuchte, über 250 Buckets damit zu erhalten, stellte ich fest, dass es viele Probleme gab. AWS hat seit langem viele neue Optionen hinzugefügt, von denen terraforming nichts weiß, und außerdem ist es in Ruby geschrieben. . Nach zwei Abenden habe ich gesendet, um mehr Funktionen hinzuzufügen, und verstand, dass solche Lösungen überhaupt nicht geeignet sind.
So funktioniert terraforming: Es nimmt Daten von SDK AWS und generiert tf und tfstate durch Templates.
Hier gibt es drei Probleme:
1. Es wird immer eine Verzögerung bei den Updates geben.
2. Die tf-Dateien sind manchmal beschädigt.
3. tfstate wird separat von tf gesammelt und stimmt nicht immer überein.
Es ist insgesamt schwierig, ein Ergebnis zu erzielen, bei dem `terraform plan` sagt, dass es keine Änderungen gibt.
2. `terraform import` — ist ein integrierter Befehl in Terraform. Wie funktioniert das?
Man schreibt eine leere TF-Datei mit dem Namen und Typ der Ressource, dann führt man `terraform import` aus und übergibt die ID der Ressource. Terraform kontaktiert den Provider, erhält die Daten und erstellt die tfstate-Datei.
Hier gibt es drei Probleme:
1. Man bekommt nur die tfstate-Datei, und die tf ist leer, muss manuell geschrieben oder von der tfstate konvertiert werden.
2. Es kann immer nur mit einer Ressource gleichzeitig arbeiten und unterstützt nicht alle Ressourcen. Und was soll ich wieder mit über 250 Buckets tun?
3. Man muss die ID der Ressourcen kennen - das heißt, man muss es in den Code einwickeln, der die Liste der Ressourcen abruft.
Insgesamt ist das Ergebnis teilweise und nicht gut skalierbar.
Meine Lösung
Anforderungen:
1. Möglichkeit, tf- und tfstate-Dateien basierend auf Ressourcen zu erstellen. Zum Beispiel alle Buckets/Sicherheitsgruppen/Load Balancer herunterzuladen und was `terraform plan` zurückgibt, dass keine Änderungen vorhanden sind.
2. Zwei Clouds GCP + AWS
3. Globale Lösung, die leicht aktualisiert werden kann, ohne jedes Mal drei Tage für jede Ressource zu verschwenden.
4. Open Source machen – jeder hat dieses Problem.
Die Sprache Go – deshalb liebe ich sie, und es gibt eine Bibliothek zur Erstellung von HCL-Dateien, die in Terraform verwendet wird + viel Code in Terraform, der nützlich sein kann.
Weg
Erster Versuch
Ich begann mit einer einfachen Variante. Anfragen an die Cloud über das SDK nach der benötigten Ressource und deren Umwandlung in Felder für Terraform. Der Versuch starb sofort an der Sicherheitsgruppe, weil mir nicht gefiel, dass ich 1,5 Tage benötigte, nur um die Sicherheitsgruppe zu konvertieren (es gibt viele Ressourcen). Es dauert lange und später könnten sich die Felder ändern/hinzugefügt werden.
Zweiter Versuch
Basierend auf der beschriebenen Idee. . Einfach die tfstate in tf konvertieren. Alle Daten sind dort vorhanden und die Felder sind die gleichen. Wie bekommt man einen vollständigen tfstate für viele Ressourcen?? Hier kommt der Befehl `terraform refresh` ins Spiel. Terraform nimmt alle Ressourcen im tfstate und zieht anhand der ID die Daten ab und schreibt alles in den tfstate. Das bedeutet, man erstellt einen leeren tfstate nur mit Namen und ID, startet `terraform refresh` und erhält vollständige tfstates. Hurra!
Jetzt kümmern wir uns um die rekursive Herausforderung, einen Konverter für tfstate in tf zu schreiben. Für diejenigen, die tfstate noch nie gelesen haben: Das ist JSON, aber etwas speziell.
Hier ist der wichtige Teil attributes
 "attributes": {
                            "id": "default/backend-logging-load-deployment",
                            "metadata.#": "1",
                            "metadata.0.annotations.%": "0",
                            "metadata.0.generate_name": "",
                            "metadata.0.generation": "24",
                            "metadata.0.labels.%": "1",
                            "metadata.0.labels.app": "backend-logging",
                            "metadata.0.name": "backend-logging-load-deployment",
                            "metadata.0.namespace": "default",
                            "metadata.0.resource_version": "109317427",
                            "metadata.0.self_link": "\/apis\/apps\/v1\/namespaces\/default\/deployments\/backend-logging-load-deployment",
                            "metadata.0.uid": "300ecda1-4138-11e9-9d5d-42010a8400b5",
                            "spec.#": "1",
                            "spec.0.min_ready_seconds": "0",
                            "spec.0.paused": "false",
                            "spec.0.progress_deadline_seconds": "600",
                            "spec.0.replicas": "1",
                            "spec.0.revision_history_limit": "10",
                            "spec.0.selector.#": "1",
Hier gibt es:
1. id – string
2. metadata – Array der Größe 1, darin ein Objekt mit den unten beschriebenen Feldern
3. spec – Hash der Größe 1, darin Key, Value
Kurz gesagt, ein lustiges Format, alles kann auch mehrere Ebenen tief sein.
                   "spec.#": "1",
                            "spec.0.min_ready_seconds": "0",
                            "spec.0.paused": "false",
                            "spec.0.progress_deadline_seconds": "600",
                            "spec.0.replicas": "1",
                            "spec.0.revision_history_limit": "10",
                            "spec.0.selector.#": "1",
                            "spec.0.selector.0.match_expressions.#": "0",
                            "spec.0.selector.0.match_labels.%": "1",
                            "spec.0.selector.0.match_labels.app": "backend-logging-load",
                            "spec.0.strategy.#": "0",
                            "spec.0.template.#": "1",
                            "spec.0.template.0.metadata.#": "1",
                            "spec.0.template.0.metadata.0.annotations.%": "0",
                            "spec.0.template.0.metadata.0.generate_name": "",
                            "spec.0.template.0.metadata.0.generation": "0",
                            "spec.0.template.0.metadata.0.labels.%": "1",
                            "spec.0.template.0.metadata.0.labels.app": "backend-logging-load",
                            "spec.0.template.0.metadata.0.name": "",
                            "spec.0.template.0.metadata.0.namespace": "",
                            "spec.0.template.0.metadata.0.resource_version": "",
                            "spec.0.template.0.metadata.0.self_link": "",
                            "spec.0.template.0.metadata.0.uid": "",
                            "spec.0.template.0.spec.#": "1",
                            "spec.0.template.0.spec.0.active_deadline_seconds": "0",
                            "spec.0.template.0.spec.0.container.#": "1",
                            "spec.0.template.0.spec.0.container.0.args.#": "3",
Im Grunde genommen, wer eine Programmieraufgabe für ein Vorstellungsgespräch möchte, der kann einfach darum bitten, einen Parser dafür zu schreiben 🙂
Nach vielen Versuchen, einen fehlerfreien Parser zu schreiben, fand ich einen Teil davon im Terraform-Code, und zwar den wichtigsten Teil. Und alles schien normal zu funktionieren.
Versuch drei
Ein Terraform-Provider ist eine Binärdatei, die Code mit allen Ressourcen und der Logik zur Arbeit mit Cloud-APIs enthält. Jede Cloud hat ihren eigenen Provider, und Terraform ruft sie über sein RPC-Protokoll zwischen zwei Prozessen auf.
Jetzt habe ich beschlossen, direkt über RPC-Aufrufe auf die Terraform-Provider zuzugreifen. Das hat sich schön dargestellt und ermöglicht es, Terraform-Provider auf neuere Versionen zu wechseln und neue Funktionen zu erhalten, ohne den Code zu ändern. Es stellte sich auch heraus, dass nicht alle Felder im tfstate im tf enthalten sein müssen, und wie erfährt man das? Nur indem man den Provider danach fragt. Danach begann eine weitere ärgerliche Rekursion beim Zusammenstellen von regulären Ausdrücken und dem Suchen von Feldern innerhalb des tfstate in alle Ebenen nach innen.
Am Ende entstand ein nützliches CLI-Tool, dessen Infrastruktur für alle Terraform-Provider gemein ist und man kann leicht neue hinzufügen. Auch die Hinzufügung von Ressourcen erfordert wenig Code. Außerdem gibt es allerlei zusätzliche Funktionen wie Verbindungen zwischen Ressourcen. Natürlich gab es viele verschiedene Probleme, die man nicht alle beschreiben kann.
Ich nannte das Tool Terrafomer.
Finale
Mit Terrafomer haben wir 500-700 Tausend Zeilen Code tf + tfstate in zwei Clouds generiert. Wir konnten Legacy-Dinge übernehmen und sie nur über Terraform angehen, wie es die besten Ideen der Infrastruktur als Code vorschlagen. Es ist einfach Magie, wenn man eine riesige Cloud nimmt und sie über das Kommando in Form von funktionierenden Terraform-Dateien erhält. Und dann grep/replace/git und so weiter.
Ich habe alles durchforstet und in Ordnung gebracht, die Genehmigungen eingeholt. Am Donnerstag (02.05.19) auf GitHub veröffentlicht.
Ich habe bereits 600 Sterne, 2 Pull-Requests zur Unterstützung von OpenStack und Kubernetes erhalten. Gute Rückmeldungen. Das Projekt ist im Allgemeinen nützlich für die Menschen.
Ich empfehle es jedem, der mit Terraform anfangen möchte und nicht alles dafür neu schreiben will.
Ich freue mich über Pull-Requests, Issues, Sterne.
Demo
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish