

Der Kanarienvogel ist ein kleiner Singvogel, der ständig singt. Diese Vögel sind empfindlich gegenüber Methan und Kohlenmonoxid. Selbst aus einer kleinen Konzentration von schädlichen Gasen in der Luft verlieren sie das Bewusstsein oder sterben. Goldsucher und Bergleute nahmen die Vögel mit in die Minen: Solange die Kanarienvögel singen, kann man arbeiten, wenn sie verstummen - dann ist Gas in der Mine und man muss gehen. Die Bergleute opferten den kleinen Vogel, um lebend aus den Minen herauszukommen.
Eine ähnliche Praxis hat auch im IT-Bereich Einzug gehalten. Zum Beispiel bei der Standardaufgabe, eine neue Version eines Dienstes oder einer Anwendung mit vorangehendem Testen in der Produktion bereitzustellen. Die Testumgebung kann zu teuer sein, automatisierte Tests decken nicht alles ab, was man sich wünschen würde, und auf Tests zu verzichten und dabei die Qualität zu opfern, ist riskant. In solchen Fällen hilft der Ansatz des Canary Deployments, bei dem ein Teil des echten Produktionstraffics auf die neue Version geleitet wird. Der Ansatz hilft, sicher die neue Version in der Produktion zu prüfen, indem man wenig für ein großes Ziel opfert. Detaillierter erklärt, wie der Ansatz funktioniert, welche Vorteile er bietet und wie man ihn umsetzt, wird Andrey Markelov (), anhand der Umsetzung im Unternehmen Infobip.
Andrey Markelov – leitender Ingenieur bei Infobip, beschäftigt sich seit 11 Jahren mit der Entwicklung von Anwendungen in Java im Bereich Finanzen und Telekommunikation. Entwickelt Open-Source-Produkte, ist aktiv in der Atlassian Community tätig und schreibt Plugins für Atlassian-Produkte. Evangelist für Prometheus, Docker und Redis.
Über das Unternehmen Infobip
Es ist eine globale Telekommunikationsplattform, die Banken, Einzelhändlern, Online-Shops und Transportunternehmen ermöglicht, ihren Kunden Nachrichten über SMS, Push, E-Mails und Sprachmitteilungen zu senden. In diesem Geschäft ist Stabilität und Zuverlässigkeit wichtig, damit die Kunden ihre Nachrichten rechtzeitig erhalten.
Die IT-Infrastruktur von Infobip in Zahlen:
- 15 Rechenzentren weltweit;
- 500 einzigartige Dienste in Betrieb;
- 2500 Instanzen von Diensten, was viel mehr ist als die Anzahl der Teams;
- 4,5 TByte Monatsverkehr;
- 4,5 Milliarden Telefonnummern;
Das Geschäft wächst und damit auch die Anzahl der Releases. Wir führen täglich 60 Releases durch, weil die Kunden mehr Möglichkeiten und Kapazitäten wollen. Aber das ist schwierig - es gibt viele Dienste, aber nur wenige Teams. Man muss schnell Code schreiben, der fehlerfrei in der Produktion funktionieren muss.
Versionen
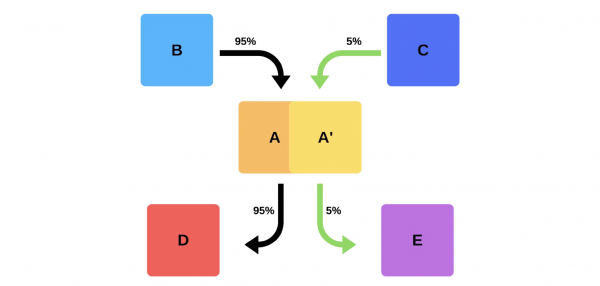
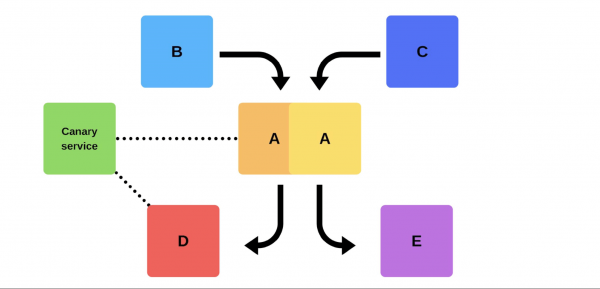
Ein typisches Release bei uns verläuft so. Zum Beispiel gibt es die Dienste A, B, C, D und E, die jeweils von einem eigenen Team entwickelt werden.
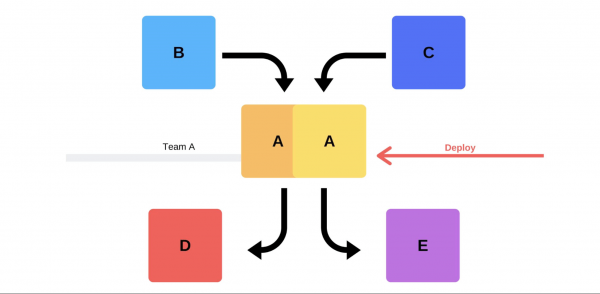
Irgendwann beschließt das Team des Dienstes A, eine neue Version bereitzustellen, aber die Teams der Dienste B, C, D und E wissen nichts davon. Es gibt zwei Möglichkeiten, wie das Team von Dienst A vorgehen kann.
Es wird ein inkrementelles Release durchführen: zuerst eine Version ersetzen und dann die andere.
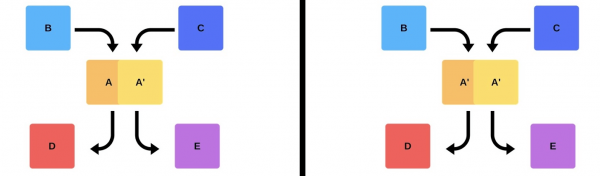
Aber es gibt eine zweite Möglichkeit: das Team findet zusätzliche Kapazitäten und Maschinen, wird die neue Version bereitstellen und dann den Router umschalten, damit die Version im Produktionsbetrieb arbeitet.
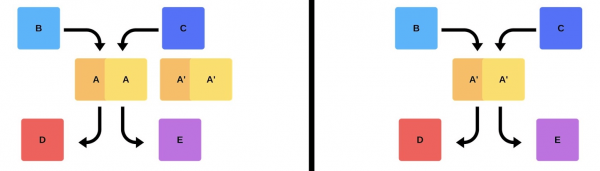
In jedem Fall treten nach dem Deployment fast immer Probleme auf, selbst wenn die Version getestet wurde. Man kann manuell testen, automatisiert testen oder gar nicht testen – Probleme werden in jedem Fall auftreten. Der einfachste und sinnvollste Weg, sie zu lösen, besteht darin, auf eine funktionierende Version zurückzukehren. Danach kann man sich um den Schaden und die Ursachen kümmern und diese beheben.
Was wollen wir also?
Probleme brauchen wir nicht. Wenn Kunden schneller Probleme entdecken als wir, schadet das unserem Ruf. Daher müssen wir Probleme schneller finden als die Kunden.Indem wir proaktiv arbeiten, minimieren wir den Schaden.
Gleichzeitig wollen wir das Deployment beschleunigen,um sicherzustellen, dass es schnell, einfach, selbstverständlich und ohne Stress für das Team abläuft. Ingenieure, DevOps-Ingenieure und Programmierer müssen geschont werden – ein Release einer neuen Version ist stressig. Ein Team ist kein Verbrauchsmaterial, wir streben an, menschliche Ressourcen effizient zu nutzen..
Deployment-Probleme
Der Kundenverkehr ist unberechenbar.Es ist unmöglich vorherzusagen, wann der Kundenverkehr am geringsten sein wird. Wir wissen nicht, wo und wann die Kunden ihre Kampagnen beginnen – vielleicht tonight in Indien und morgen in Hongkong. Angesichts der großen Zeitunterschiede garantiert ein Deployment um 2 Uhr nachts nicht, dass die Kunden nicht betroffen sind.
Provider-Probleme.Messenger und Anbieter sind unsere Partner. Manchmal haben sie Ausfälle, die während der Bereitstellung neuer Versionen Fehler verursachen.
Verteilte Teams.Teams, die den Client und das Backend entwickeln, befinden sich in verschiedenen Zeitzonen. Deshalb können sie oft nicht miteinander kommunizieren.
Rechenzentren lassen sich nicht in der Staging-Umgebung replizieren.In einem Rechenzentrum gibt es 200 Racks – dies in einer Sandbox auch nur annähernd zu reproduzieren ist nicht möglich.
Downtimessind nicht akzeptabel! Wir haben ein akzeptables Verfügbarkeitsniveau (Error Budget), wenn wir 99,99 % der Zeit arbeiten, zum Beispiel, und die verbleibenden Prozente sind das "Recht auf Fehler". Es ist unmöglich, 100 % Zuverlässigkeit zu erreichen, aber es ist wichtig, ständig auf Ausfälle und Stillstände zu achten.
Klassische Lösungsmöglichkeiten
Code ohne Fehler zu schreiben. Als ich ein junger Entwickler war, kamen Manager zu mir und baten um einen Release ohne Fehler, aber das ist nicht immer möglich.
Tests zu schreiben. Tests funktionieren, aber manchmal ganz anders, als es das Geschäft möchte. Geld zu verdienen ist nicht die Aufgabe von Tests.
Testen auf Stage. In meinen 3,5 Jahren bei Infobip habe ich nie gesehen, dass der Status der Stage auch nur teilweise mit der Produktion übereinstimmte.
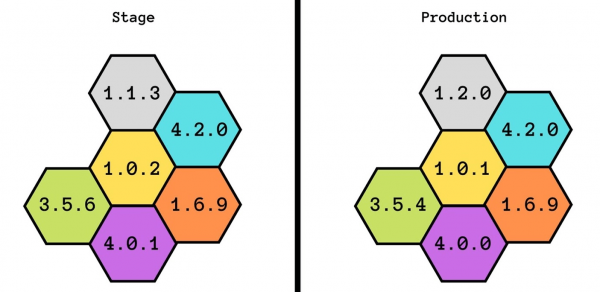
Wir haben sogar versucht, diese Idee weiterzuentwickeln: Zuerst hatten wir eine Stage, dann eine Pre-Production und dann eine Pre-Production der Pre-Production. Aber auch das hat nicht geholfen — sie stimmten nicht einmal in der Leistung überein. Mit der Stage können wir die grundlegende Funktionalität garantieren, wissen aber nicht, wie sie bei Lasten funktionieren wird.
Den Release macht derjenige, der entwickelt hat. Es ist eine gute Praxis: Selbst wenn jemand den Kommentar ändert, wird es sofort in die Produktion aufgenommen. Das hilft, Verantwortung zu entwickeln und die vorgenommenen Änderungen nicht zu vergessen.
Es gibt auch zusätzliche Schwierigkeiten. Für den Entwickler ist es stressig — viel Zeit darauf zu verwenden, alles manuell zu überprüfen.
Abgestimmte Releases. Diese Möglichkeit wird normalerweise von der Geschäftsführung vorgeschlagen: "Lass uns vereinbaren, dass ihr jeden Tag testet und neue Versionen hinzufügt." Das funktioniert nicht: Es gibt immer ein Team, das auf alle anderen wartet oder umgekehrt.
Smoke-Tests
Eine weitere Möglichkeit, unsere Probleme mit Deployments zu lösen. Lassen Sie uns betrachten, wie Smoke-Tests im vorherigen Beispiel funktionieren, wenn das Team A eine neue Version deployen möchte.
Zuerst deployt das Team eine Instanz in die Produktion. Mit Nachrichten in die Instanz von Mocks wird der echte Traffic emuliert, um mit dem normalen täglichen Traffic übereinzustimmen. Wenn alles gut ist, wechselt das Team die neue Version auf den Benutzertraffic.
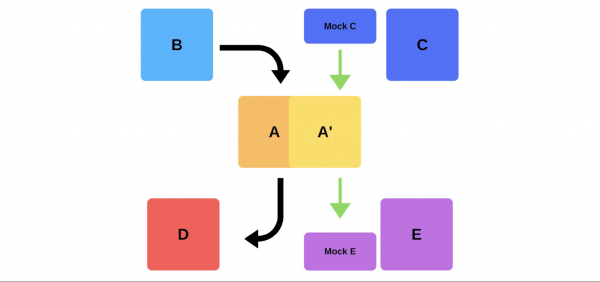
Die zweite Möglichkeit — deployen mit zusätzlicher Hardware. Das Team testet es in der Produktion, wechselt dann um, und alles funktioniert.
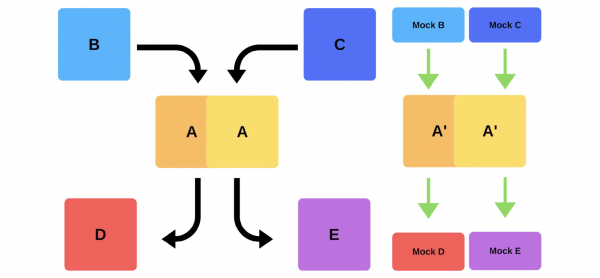
Nachteile der Smoke-Tests:
- Tests sind nicht vertrauenswürdig. Woher bekommen wir denselben Traffic wie in der Produktion? Man kann den von gestern oder vor einer Woche nutzen, aber der stimmt nicht immer mit dem aktuellen überein.
- Schwer zu warten. Wir müssen Testkonten pflegen, diese vor jedem Deployment ständig zurücksetzen, wenn aktive Einträge ins Repository gesendet werden. Das ist komplizierter, als einen Test in seiner eigenen Sandbox zu schreiben.
Der einzige Vorteil hier ist, dass man die Leistung überprüfen kann..
Canary-Releases
Aufgrund der Nachteile von Smoke-Tests haben wir begonnen, Canary-Releases zu verwenden.
Eine Praxis, ähnlich der, wie Bergleute Kanarienvögel zur Anzeige des Gasniveaus verwendeten, hat auch im IT-Bereich Fuß gefasst. Wir lassen ein wenig echten Produktionsverkehr auf die neue Version laufen,, während wir versuchen, die Service Level Agreement (SLA) einzuhalten. SLA ist unser „Recht auf Fehler“, das wir einmal im Jahr (oder in einem anderen Zeitrahmen) nutzen können. Wenn alles gut geht, fügen wir mehr Traffic hinzu. Wenn nicht, setzen wir die vorherigen Versionen zurück.
Implementierung und Nuancen
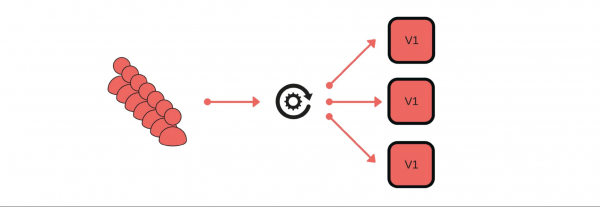
Wie haben wir die Canary-Releases implementiert? Zum Beispiel sendet eine Kundengruppe Nachrichten über unseren Service.
Das Deployment verläuft so: Wir entfernen einen Knoten vom Lastverteiler (1), ändern die Version (2) und leiten separat ein wenig Traffic (3) weiter.
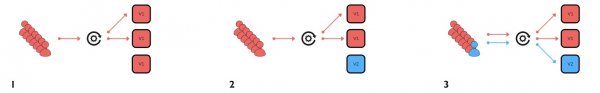
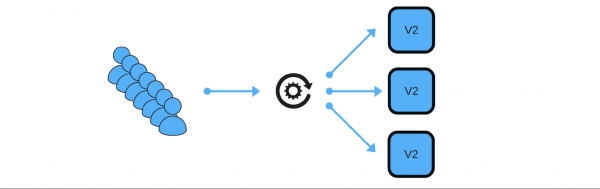
Im Allgemeinen werden alle in der Gruppe zufrieden sein, auch wenn ein Benutzer unzufrieden ist. Wenn alles gut läuft, ändern wir alle Versionen.
Ich werde schematisch zeigen, wie das in den meisten Fällen für Mikrodienste aussieht.
Es gibt Service Discovery und zwei weitere Dienste: S1N1 und S2. Der erste Dienst (S1N1) informiert die Service Discovery, wenn er startet, und die Service Discovery merkt sich ihn. Der zweite Dienst mit zwei Knoten (S2N1 und S2N2) informiert ebenfalls die Service Discovery beim Start.
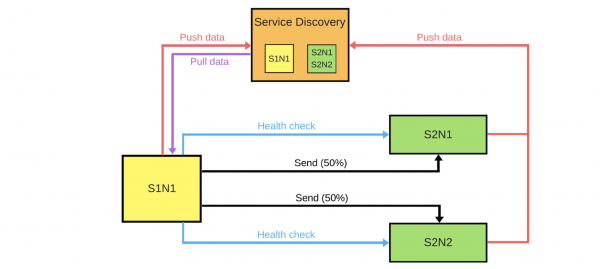
Der zweite Dienst funktioniert für den ersten als Server. Der erste fragt bei der Service Discovery nach Informationen über seine Server, und wenn er diese erhält, sucht und überprüft er sie („Health Check“). Wenn er überprüft hat, sendet er Nachrichten an sie.
Wenn jemand eine neue Version des zweiten Dienstes bereitstellen möchte, informiert er die Service Discovery, dass der zweite Knoten ein Canary-Knoten sein wird: Auf ihn wird weniger Traffic geleitet, da das Deployment jetzt stattfindet. Wir entfernen den Canary-Knoten vom Lastverteiler, und der erste Dienst sendet keinen Traffic mehr an ihn.
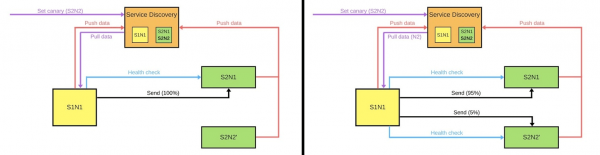
Wir wechseln die Version und der Service Discovery weiß, dass der zweite Knoten jetzt ein Canary ist — wir können ihm weniger Last (5%) geben. Wenn alles gut läuft, wechseln wir die Version, stellen die Last wieder her und arbeiten weiter.
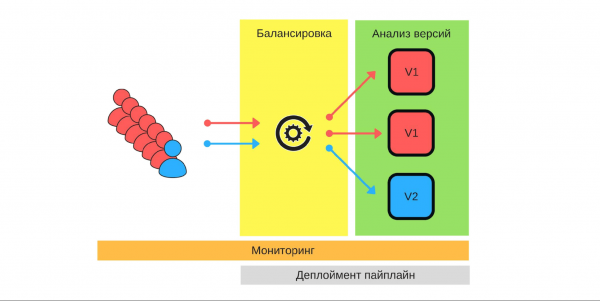
Um all das zu realisieren, brauchen wir:
- Lastverteilung;
- Überwachung, da es wichtig ist zu wissen, was jeder Nutzer erwartet und wie detailliert unsere Dienste arbeiten;
- Versionsanalyse, um zu verstehen, wie gut die neue Version im Produktionsumfeld funktionieren wird;
- Automatisierung — wir schreiben die Bereitfolgen (Deployment-Pipeline).
Lastverteilung
Das ist das erste, worüber wir nachdenken sollten. Es gibt zwei Strategien zur Lastverteilung.
Die einfachste Variante ist, wenn ein Knoten immer ein Canary ist. Dieser Knoten erhält immer weniger Traffic und wir beginnen das Deployment mit ihm. Bei Problemen vergleichen wir seine Leistung vor und während des Deployments. Zum Beispiel, wenn die Fehleranzahl sich verdoppelt hat, bedeutet das, dass auch der Schaden sich verdoppelt hat.
Der Canary-Knoten wird im Verlauf des Deployments festgelegt. Wenn das Deployment abgeschlossen ist und wir ihn vom Status des Canary-Knotens abziehen, wird die Lastverteilung wiederhergestellt. Mit weniger Maschinen erhalten wir eine faire Verteilung.
Überwachung
Der Grundpfeiler von Canary-Releases. Wir müssen genau verstehen, warum wir das tun und welche Metriken wir sammeln wollen.
Beispiele für Metriken, die wir von unseren Diensten sammeln.
- Anzahl der Fehler, die in die Protokolle geschrieben werden. Das ist ein offensichtlicher Indikator dafür, dass alles wie gewünscht funktioniert. Insgesamt ist das eine gute Metrik.
- Antwortzeiten (Latenz). Diese Metrik wird von allen überwacht, denn alle wollen schnell arbeiten.
- Größe der Warteschlange (Durchsatz).
- Anzahl erfolgreicher Antworten pro Sekunde.
- Die Zeit, die für 95% aller Anfragen benötigt wird.
- Geschäftsmetriken: Wie viel Geld das Unternehmen in einem bestimmten Zeitraum verdient oder der Abfluss von Nutzern. Diese Metriken können für unsere neue Version wichtiger sein als die, die die Ingenieure hinzufügen.
Beispiele für Metriken in den meisten beliebten Überwachungssystemen.
Zähler. Das ist eine bestimmte steigende Größe, zum Beispiel die Anzahl der Fehler. Diese Metrik lässt sich einfach interpolieren und der Graph lässt sich studieren: Gestern gab es 2 Fehler, heute 500, das heißt, irgendetwas ist schiefgegangen.
Die Anzahl der Fehler pro Minute oder pro Sekunde ist ein wichtiger Indikator, der mit dem Counter berechnet werden kann. Diese Daten geben einen klaren Überblick über die Leistung des Systems über einen bestimmten Zeitraum. Betrachten wir das Beispiel des Graphen der Anzahl der Fehler pro Sekunde für zwei Versionen des Produktionssystems.
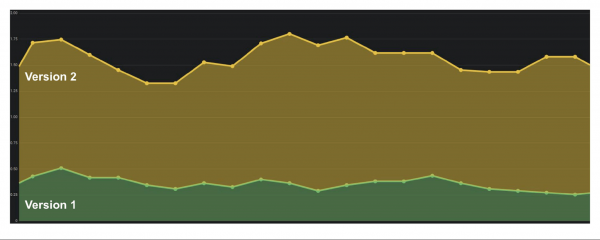
In der ersten Version gab es nur wenige Fehler, möglicherweise hat das Audit nicht funktioniert. In der zweiten Version ist alles viel schlimmer. Man kann eindeutig sagen, dass es Probleme gibt, daher müssen wir diese Version zurücksetzen.
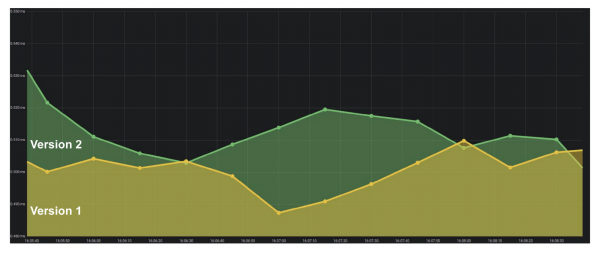
Gauge. Metriken sind ähnlich wie der Counter, aber wir zeichnen Werte auf, die sowohl steigen als auch fallen können. Zum Beispiel die Ausführungszeit von Anfragen oder die Größe einer Warteschlange.
Im Graphen sehen wir ein Beispiel für die Antwortzeit (Latency). Der Graph zeigt, dass die Versionen ähnlich sind und damit gearbeitet werden kann. Aber wenn man genauer hinsieht, wird deutlich, wie sich die Größe ändert. Wenn die Ausführungszeit von Anfragen mit der Anzahl der Benutzer steigt, ist sofort klar, dass es Probleme gibt — so etwas gab es vorher nicht.
Zusammenfassung. Einer der wichtigsten Indikatoren für Unternehmen sind die Perzentile. Die Metrik zeigt, dass in 95 % der Fälle unser System so funktioniert, wie wir es wollen. Wir können uns damit abfinden, wenn es irgendwo Probleme gibt, da wir die allgemeine Tendenz verstehen, wie gut oder schlecht alles läuft.
Werkzeuge
ELK Stack. Ein Canary kann mit Elasticsearch implementiert werden — wir zeichnen Fehler auf, wenn Ereignisse eintreten. Mit einem einfachen API-Aufruf kann man die Anzahl der Fehler zu jedem Zeitpunkt abrufen und mit vorherigen Zeiträumen vergleichen: GET /applg/_cunt?q=level:errr.
Prometheus. Hat sich gut bei Infobip bewährt. Es ermöglicht die Implementierung mehrdimensionaler Metriken, da Labels verwendet werden.
Wir können level, instance, service, in einem System kombinieren. Mit offset kann man zum Beispiel den Wert der Größe vor einer Woche mit nur einem Befehl ansehen GET /api/v1/query?query={query}{query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Analyse der Versionen
Es gibt mehrere Strategien zur Analyse von Versionen.
Metriken nur für die Canary-Node überwachen. Eine der einfachsten Optionen: Wir haben eine neue Version bereitgestellt und untersuchen nur die Leistung. Aber wenn der Ingenieur in dieser Zeit beginnt, die Logs zu studieren und ständig nervös die Seiten neu lädt, dann unterscheidet sich diese Lösung nicht von den anderen.
Die Canary-Node wird mit jeder anderen Node verglichen.. Dieser Vergleich erfolgt mit anderen Instanzen, die mit vollem Verkehr arbeiten. Wenn es beispielsweise bei geringem Verkehr schlechter oder nicht besser aussieht als bei den realen Instanzen, stimmt etwas nicht.
Die Canary-Node wird mit ihrer früheren Version verglichen. Die für den Canary-Prozess vorgesehenen Nodes können mit historischen Daten verglichen werden. Wenn beispielsweise vor einer Woche alles gut war, können wir uns auf diese Daten stützen, um die aktuelle Situation zu verstehen.
Automatisierung
Wir möchten die Ingenieure von manuellen Vergleichen befreien, daher ist es wichtig, eine Automatisierung umzusetzen. Der Prozess des Deployments (deployment pipeline) sieht normalerweise folgendermaßen aus:
- wir starten;
- wir entfernen die Node aus dem Load Balancer;
- wir stellen die Canary-Node ein;
- wir aktivieren den Load Balancer bereits mit einem eingeschränkten Verkehr;
- wir vergleichen.
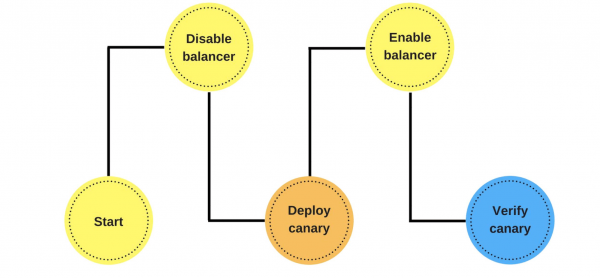
In diesem Schritt setzen wir den automatischen Vergleich um. Wie dieser aussehen kann und warum er besser ist als die Überprüfung nach dem Deployment, betrachten wir am Beispiel von Jenkins.
Das ist der Pipeline-Code in Groovy.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary ist fehlgeschlagen, Rückgängigmachen erforderlich"
        return false
    }
}
Hier in der Schleife legen wir fest, dass wir die neue Node eine Stunde lang vergleichen werden. Wenn der Canary-Prozess noch nicht beendet ist, rufen wir die Funktion auf. Diese gibt an, ob alles gut ist oder nicht: def isOk = compare(srv, canary, time, base, offset, metrics).
Wenn alles in Ordnung ist — sleep DEFAULT SLEEP, zum Beispiel eine Sekunde, und wir machen weiter. Wenn nicht, brechen wir ab — das Deployment war nicht erfolgreich.
Beschreibung der Metrik. Schauen wir uns an, wie die Funktion compare aussehen könnte,
am Beispiel von DSL.metric( 'errorCounts', 'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)', { baseValue, canaryValue -> if (canaryValue > baseValue * 1.3) return false return true } )
Angenommen, wir vergleichen die Anzahl der Fehler und möchten die Fehler pro Sekunde in den letzten 5 Minuten ermitteln. Wir haben zwei Werte: den Basiswert und den Wert der Canary-Node. Der Wert der Canary-Node ist der aktuelle. Der Basiswert ist baseValue — dieser Wert stammt von jeder anderen Node, die nicht als Canary fungiert. Wir vergleichen die Werte gemäß der Formel, die wir basierend auf unseren Erfahrungen und Beobachtungen aufgestellt haben. Wenn der Wert canaryValue
schlecht ist, war das Deployment nicht erfolgreich und wir rollen zurück.
Warum braucht man das alles? Ein Mensch kann nicht Hunderte und Tausende von Metriken überprüfen., umso mehr, dass dies schnell geschehen kann. Automatischer Vergleich hilft, alle Kennzahlen zu überprüfen und schnell über Probleme zu informieren. Die Benachrichtigungszeit ist entscheidend: Wenn etwas in den letzten 2 Sekunden passiert ist, ist der Schaden nicht so groß, wie wenn es vor 15 Minuten geschehen wäre. Während jemand das Problem bemerkt, eine Anfrage an den Support schreibt und der Support uns zurücksetzt, könnten wir Kunden verlieren.
Wenn der Prozess erfolgreich war, stellen wir alle anderen Knoten automatisch bereit. Während dieser Zeit machen die Ingenieure nichts. Nur wenn sie die Canary-Tests starten, entscheiden sie, welche Kennzahlen sie erfassen, wie lange sie den Vergleich durchführen und welche Strategie sie verwenden.
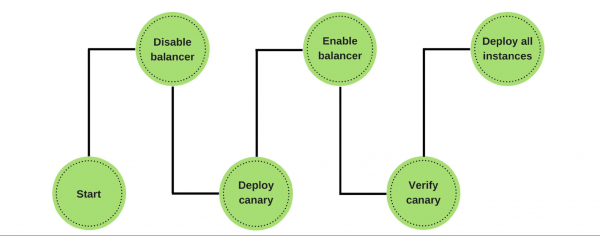
Wenn Probleme auftreten, setzen wir die Canary-Knoten automatisch zurück, arbeiten mit früheren Versionen und beheben die gefundenen Fehler. Anhand der Kennzahlen sind sie leicht zu finden und der Schaden durch die neue Version kann gesehen werden.
Herausforderungen
Das umzusetzen, ist natürlich nicht einfach. Zunächst benötigen wir ein gemeinsames Überwachungssystem. Die Ingenieure haben ihre eigenen Kennzahlen, der Support und die Analysten andere, und das Geschäft hat dritte. Ein gemeinsames System ist die gemeinsame Sprache, in der das Geschäft und die Entwicklung sprechen.
Es muss in der Praxis überprüft werden die Stabilität der Kennzahlen. Die Überprüfung hilft zu verstehen, welches minimale Set an Kennzahlen erforderlich ist, um Qualität zu gewährleisten..
Wie erreicht man das? Den Canary-Service nicht zum Zeitpunkt des Deployments verwenden. Wir fügen in der alten Version einen bestimmten Dienst hinzu, der jederzeit einen bestimmten Knoten übernehmen und den Datenverkehr ohne Deployment reduzieren kann. Danach vergleichen wir: Studieren die Fehler und suchen nach dem Punkt, an dem wir Qualität erreichen.
Welchen Nutzen haben wir aus den Canary-Releases gezogen?
Wir haben den Prozentsatz des Schadens durch Fehler minimiert. Die meisten Deployment-Fehler entstehen aufgrund von Inkonsistenzen bei Daten oder Prioritäten. Solche Fehler sind deutlich gesunken, da wir das Problem in den ersten Sekunden lösen können.
Wir haben die Arbeit der Teams optimiert. Neueinsteiger haben ein „Recht auf Fehler“: Sie können ohne Angst vor Fehlern in die Produktion deployen, was zusätzliche Initiative und Motivation schafft. Wenn sie etwas kaputt machen, hat das keine kritischen Folgen, und der Fehler wird nicht entlassen.
Wir haben das Deployment automatisiert. Es ist bereits nicht mehr ein manueller Prozess wie früher, sondern ein echter automatisierter. Aber es dauert länger.
Wichtige Kennzahlen wurden hervorgehoben.. Das gesamte Unternehmen, von der Geschäftsführung bis zu den Ingenieuren, versteht, was in unserem Produkt wirklich wichtig ist, welche Metriken, wie zum Beispiel Abwanderung und Zuwanderung von Nutzern. Wir kontrollieren den Prozess: testen Metriken, führen neue ein und beobachten, wie die alten funktionieren, um ein System aufzubauen, das profitabel Geld verdient.
Wir haben viele großartige Praktiken und Systeme, die uns helfen. Dennoch streben wir danach, Profis zu sein und unsere Arbeit qualitativ hochwertig zu erledigen, unabhängig davon, ob wir ein System haben, das uns unterstützt, oder nicht.
Ingenieuransätze und -praktiken — . Wenn Sie auf dem Weg zur technischen Perfektion Erfolge erzielt haben und bereit sind, zu erzählen, was Ihnen dabei geholfen hat, — .
Wir planen, die am 8. Juni durchzuführen. Wir verstehen, dass es im Moment schwierig ist, Entscheidungen über die Teilnahme an der Konferenz zu treffen. Gleichzeitig sind wir jedoch der Meinung, dass die Quarantäne kein Grund sein sollte, um den professionellen Austausch und die Weiterentwicklung zu stoppen. Daher werden wir auf jeden Fall einen Weg finden, die Herausforderungen der Tech-Leads und die Ansätze zu deren Lösung zu besprechen – wenn nötig, gehen wir online und machen Networking dort!
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish