

Was würden Sie fühlen, wenn an einem schönen Sommertag das Rechenzentrum mit Ihrer Ausrüstung so aussehen würde?
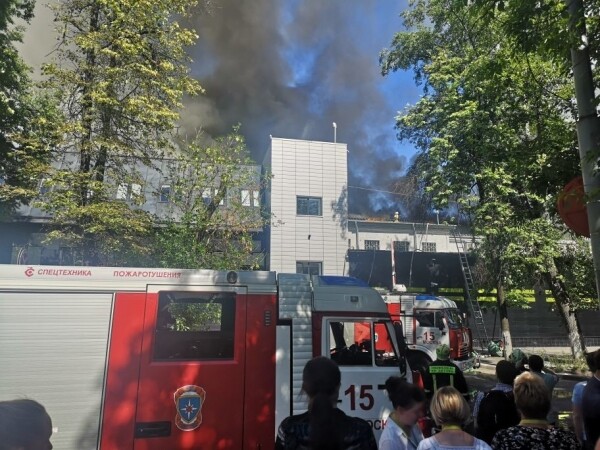
Hallo zusammen! Mein Name ist Dmitri Samsonov, ich arbeite als leitender Systemadministrator bei „“. Auf dem Foto sehen Sie eines der vier Rechenzentren, in denen die Ausrüstung für unser Projekt installiert ist. Hinter diesen Wänden befinden sich etwa 4.000 Geräte: Server, Speichersysteme, Netzwerkausrüstung usw. – fast ein Drittel unserer gesamten Ausrüstung.
Die meisten Server laufen mit Linux. Es gibt auch mehrere Dutzend Server mit Windows (MS SQL) – unser Erbe, von dem wir uns seit vielen Jahren schrittweise trennen.
Am 5. Juni 2019 um 14:35 Uhr berichteten die Ingenieure eines unserer Rechenzentren von einem Feueralarm.
Leugnung
14:45 Uhr. Kleinere Vorfälle mit Rauchentwicklung in Rechenzentren passieren häufiger, als man denkt. Die Werte in den Sälen waren normal, deshalb war unsere erste Reaktion relativ ruhig: wir haben die Arbeiten im Produktivbetrieb, also alle Änderungen an der Konfiguration und die Bereitstellung neuer Versionen usw. untersagt, außer für Arbeiten zur Behebung von Problemen.
Wut
Haben Sie jemals versucht, die Feuerwehr zu fragen, wo genau auf dem Dach das Feuer ausgebrochen ist, oder selbst auf das brennende Dach zu gelangen, um die Situation einzuschätzen? Wie hoch wäre das Vertrauen in Informationen, die über fünf Personen weitergeleitet wurden?
14:50. Es gab Informationen, dass das Feuer sich dem Kühlsystem nähert. Aber wird es das erreichen? Der diensthabende Systemadministrator leitet den externen Datenverkehr von den Fronten dieses Rechenzentrums ab.
Derzeit sind die Fronten aller unserer Dienste in drei Rechenzentren redundant, es wird ein DNS-Level-Balancing verwendet, was es ermöglicht, die Adressen eines Rechenzentrums aus dem DNS zu entfernen und somit die Benutzer vor potenziellen Problemen mit dem Zugriff auf die Dienste zu schützen. Falls im Rechenzentrum bereits Probleme aufgetreten sind, wird es automatisch aus der Rotation entfernt. Mehr dazu können Sie hier lesen:
Bisher hat das Feuer uns nicht beeinflusst – weder Benutzer noch Ausrüstung wurden beschädigt. Handelt es sich um einen Notfall? Der erste Abschnitt des Dokuments „Notfallaktionsplan“ definiert den Begriff „Notfall“ und endet mit den Worten:
«Wenn Zweifel bestehen, ob es sich um einen Notfall handelt oder nicht, dann ist es ein Notfall!»
14:53. Ein Koordinator für den Notfall wird ernannt.
Der Koordinator ist die Person, die die Kommunikation zwischen allen Beteiligten koordiniert, das Ausmaß des Notfalls bewertet, den „Notfallaktionsplan“ anwendet, das erforderliche Personal einbezieht, die Beendigung der Reparatur überwacht und vor allem Aufgaben delegiert. Mit anderen Worten, es ist die Person, die den gesamten Prozess der Notfallbewältigung managt.
Auktion
15:01. Wir beginnen mit dem Ausschalten der Server, die nicht mit der Produktion verbunden sind.
15:03. Wir schalten alle reservierten Dienste ordnungsgemäß aus.
Hierzu gehören nicht nur die Frontends (auf die zu diesem Zeitpunkt keine Benutzer mehr zugreifen), sowie ihre unterstützenden Dienste (Geschäftslogik, Caches usw.), sondern auch verschiedene Datenbanken mit einem Replikationsfaktor von 2 und mehr (, , , und andere).
15:06. Es gab Informationen, dass ein Feuer einen der Säle des Rechenzentrums bedroht. In diesem Saal haben wir keine Ausrüstung, aber die Möglichkeit, dass das Feuer vom Dach auf die Säle übergreift, ändert die gesamte Situation erheblich.
(Später stellte sich heraus, dass es keine physische Bedrohung für den Saal gab, da er hermetisch vom Dach isoliert ist. Die Bedrohung bestand nur für das Kühlsystem dieses Saals.)
15:07. Wir erlauben die Ausführung von Befehlen auf den Servern in beschleunigtem Modus ohne zusätzliche Prüfungen ().
15:08. Die Temperatur in den Sälen liegt im normalen Bereich.
15:12. Es wurde ein Anstieg der Temperatur in den Sälen festgestellt.
15:13. Mehr als die Hälfte der Server im Rechenzentrum ist abgeschaltet. Wir machen weiter.
15:16. Es wurde beschlossen, die gesamte Ausrüstung abzuschalten.
15:21. Wir beginnen, die Stromversorgung der zustandslosen Server ohne korrekte Abschaltung der Anwendung und des Betriebssystems auszuschalten.
15:23. Eine Gruppe von Verantwortlichen für MS SQL wird gebildet (es gibt nur wenige von ihnen, die Abhängigkeit der Dienste von ihnen ist nicht groß, aber das Verfahren zur Wiederherstellung der Betriebsfähigkeit dauert länger und ist komplizierter als beispielsweise bei Cassandra).
Depression
15:25. Es gab Informationen über die Abschaltung der Stromversorgung in vier Sälen von 16 (Nr. 6, 7, 8, 9). In den Sälen 7 und 8 befindet sich unsere Ausrüstung. Über zwei weitere Säle von uns (Nr. 1 und 3) liegen keine Informationen vor.
Normalerweise wird bei Bränden die Stromversorgung sofort abgeschaltet, aber in diesem Fall wurde sie dank der koordinierten Arbeit der Feuerwehr und des technischen Personals des Rechenzentrums nicht überall und nicht sofort, sondern nach Bedarf abgeschaltet.
(Später stellte sich heraus, dass die Stromversorgung in den Hallen 8 und 9 nicht unterbrochen wurde.)
15:28. Wir beginnen mit der Wiederherstellung der MS SQL-Datenbanken aus Backups in anderen Rechenzentren.
Wie viel Zeit wird dafür benötigt? Reicht die Bandbreite des Netzwerks auf der gesamten Strecke aus?
15:37. Es wurde eine Unterbrechung einiger Netzwerksegmente festgestellt.
Das Management-Netzwerk und das Produktionsnetzwerk sind physisch voneinander isoliert. Wenn das Produktionsnetzwerk verfügbar ist, können Sie auf den Server zugreifen, die Anwendung stoppen und das OS ausschalten. Wenn es nicht verfügbar ist, können Sie über IPMI auf den Server zugreifen, die Anwendung stoppen und das OS ausschalten. Wenn keines der Netzwerke funktioniert, können Sie nichts tun. „Danke, Kapitän!“, werden Sie sich denken.
„Und überhaupt, das ist ja ganz schön viel Aufregung“, denken Sie vielleicht auch.
Die Sache ist die, dass Server, selbst ohne Feuer, eine enorme Menge an Wärme erzeugen. Genauer gesagt, wenn Kühlung vorhanden ist, erzeugen sie Wärme, und wenn keine Kühlung vorhanden ist, schaffen sie die Hölle, die im besten Fall einen Teil der Hardware schmelzen und einen anderen Teil abschalten kann, und im schlimmsten Fall… einen Brand im Raum auslöst, der praktisch garantiert alles zerstört.
15:39. Wir stellen Probleme mit der Konfigurationsdatenbank fest.
Die Konfigurationsdatenbank ist das Backend für den gleichnamigen Dienst, der von allen Produktionsanwendungen zur sofortigen Änderung von Einstellungen verwendet wird. Ohne diese Datenbank können wir die Portalnutzung nicht steuern, aber das Portal selbst kann weiterhin funktionieren.
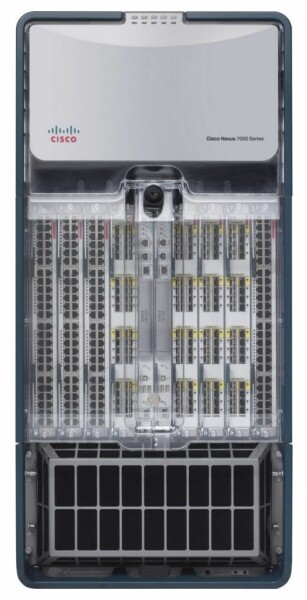
15:41. Die Temperatursensoren am Core-Netzwerkgerät zeigen Werte, die nahe an den maximal zulässigen Werten liegen. Das ist ein Kasten, der eine ganze Rack-Einheit einnimmt und den Betrieb aller Netzwerke im Rechenzentrum sicherstellt.
15:42. Issue Tracker und Wiki sind nicht verfügbar, wir schalten auf Standby um.
Das ist kein Produktionsnetzwerk, aber bei einem Ausfall kann die Verfügbarkeit jeder Wissensdatenbank kritisch sein.
15:50. Eines der Überwachungssysteme ist ausgefallen.
Es gibt mehrere, und sie sind für verschiedene Aspekte des Betriebs der Dienste verantwortlich. Einige davon sind auf einen autarken Betrieb innerhalb jedes Rechenzentrums eingestellt (d. h. sie überwachen nur ihr Rechenzentrum), andere bestehen aus verteilten Komponenten, die transparent den Verlust eines beliebigen Rechenzentrums überstehen.
In diesem Fall hat das , das im Master-Standby-Modus arbeitet, aufgehört zu funktionieren. Wir sind auf Standby umgeschaltet.
Abschluss
15:51. Über IPMI haben wir alle Server ohne ordnungsgemäße Beendigung der Arbeiten ausgeschaltet, mit Ausnahme von MS SQL.
Sind Sie bereit, die Server im Falle eines Bedarfs über IPMI massenhaft zu verwalten?
Der Moment, in dem die Rettung der Ausrüstung im Rechenzentrum an dieser Stelle abgeschlossen ist. Alles, was getan werden konnte, wurde getan. Einige Kollegen können sich ausruhen.
16:13. Es wurde informiert, dass auf dem Dach die Kühlmittelrohre der Klimaanlagen geplatzt sind – dies wird den Start des Rechenzentrums nach der Brandbekämpfung verzögern.
16:19. Laut Informationen des technischen Personals des Rechenzentrums hat die Temperatur in den Räumen zu steigen aufgehört.
17:10. Die Arbeit der Datenbank conf wurde wiederhergestellt. Jetzt können wir die Einstellungen der Anwendungen ändern.
Warum ist das so wichtig, wenn alles ausfallsicher ist und auch ohne ein Rechenzentrum funktioniert?
Erstens, nicht alles ist ausfallsicher. Es gibt verschiedene sekundäre Dienste, die bisher nicht gut genug mit dem Ausfall eines Rechenzentrums umgehen können, und es gibt Datenbanken im Master-Standby-Modus. Die Möglichkeit, die Einstellungen zu verwalten, ermöglicht es, alles Notwendige zu tun, um selbst unter schwierigen Bedingungen die Auswirkungen einer Störung auf die Benutzer zu minimieren.
Zweitens wurde klar, dass die Arbeit des Rechenzentrums in den nächsten Stunden nicht vollständig wiederhergestellt wird, daher mussten Maßnahmen ergriffen werden, damit die langfristige Unzugänglichkeit der Replikate nicht zu weiteren unangenehmen Überraschungen wie Festplattenspeicherüberläufen in den verbleibenden Rechenzentren führt.
17:29. Zeit für Pizza! Bei uns arbeiten Menschen, keine Roboter.
Rehabilitation
18:02. In den Räumen Nr. 8 (unser), 9, 10 und 11 hat sich die Temperatur stabilisiert. In einem der ausgeschalteten Räume (Nr. 7) befindet sich unsere Ausrüstung, und die Temperatur dort steigt weiter.
18:31. Wir haben grünes Licht für den Start der Ausrüstung in den Räumen Nr. 1 und 3 gegeben – diese Räume wurden nicht vom Feuer betroffen.
Derzeit wird der Start der Server in den Räumen Nr. 1, 3, 8 durchgeführt, beginnend mit den kritischsten. Die Funktionsfähigkeit aller gestarteten Dienste wird überprüft. Es gibt weiterhin Probleme mit dem Raum Nr. 7.
18:44. Das technische Personal des Rechenzentrums hat festgestellt, dass in Raum Nr. 7 (wo nur unsere Ausrüstung steht) viele Server nicht abgeschaltet sind. Nach unseren Informationen sind dort 26 Server eingeschaltet. Nach einer erneuten Überprüfung stellen wir 58 Server fest.
20:18. Das technische Personal des Rechenzentrums bläst die Luft in den Raum ohne Klimaanlagen über mobile Luftkanäle, die durch die Flure verlegt wurden.
23:08. Der erste Administrator wurde nach Hause geschickt. Jemand muss nachts schlafen, um morgen mit den Arbeiten fortzufahren. Dann lassen wir noch einige Administratoren und Entwickler nach Hause gehen.
02:56. Wir haben alles gestartet, was gestartet werden konnte. Wir führen eine umfassende Überprüfung aller Dienste mit automatisierten Tests durch.
03:02. Die Klimaanlage im letzten, 7. Raum wurde wiederhergestellt.
03:36. Wir haben die Fronten im Rechenzentrum in DNS rotieren lassen. Ab diesem Moment beginnt der Benutzerverkehr zu fließen.
Wir entlassen den Großteil des Administratorenteams nach Hause. Aber einige Personen bleiben.
Kleines FAQ:
Q: Was geschah von 18:31 bis 02:56?
A: Gemäß dem 'Notfallplan' starten wir alle Dienste, beginnend mit den wichtigsten. Dabei teilt der Koordinator im Chat einen Dienst einem freien Administrator zu, der überprüft, ob das OS und die Anwendung gestartet wurden, ob es Fehler gibt und ob die Werte in Ordnung sind. Nach Abschluss des Starts informiert er den Chat, dass er frei ist, und erhält vom Koordinator einen neuen Dienst.
Der Prozess wird zusätzlich durch ausgefallene Hardware verlangsamt. Selbst wenn das Stoppen des OS und das Ausschalten der Server korrekt durchgeführt wurden, kehren einige Server aufgrund plötzlich ausgefallener Festplatten, Speicher oder Gehäuse nicht zurück. Bei Stromausfall erhöht sich die Ausfallquote.
Q: Warum kann man nicht einfach alles auf einmal starten und dann das reparieren, was im Monitoring auftaucht?
A: Alles muss schrittweise erfolgen, da zwischen den Diensten Abhängigkeiten bestehen. Und man sollte alles sofort überprüfen, ohne auf das Monitoring zu warten — denn Probleme sollte man sofort lösen, um deren Verschärfung zu vermeiden.
7:40. Der letzte Administrator (Koordinator) ist schlafen gegangen. Die Arbeiten des ersten Tages sind abgeschlossen.
8:09. Die ersten Entwickler, Ingenieure in den Rechenzentren und Administratoren (einschließlich des neuen Koordinators) haben mit den Wiederherstellungsarbeiten begonnen.
09:37. Wir haben mit der Wiederherstellung des Raumes Nr. 7 (des letzten) begonnen.
Parallel dazu setzen wir die Wiederherstellung dessen fort, was in anderen Räumen nicht fertiggestellt wurde: Austausch von Festplatten/Speicher/Servern, Reparatur von allem, was im Monitoring 'brennt', Rückschaltung der Rollen in den Master-Standby-Schemata und andere Kleinigkeiten, von denen es dennoch genug gibt.
17:08. Wir genehmigen alle regulären Arbeiten mit der Produktion.
21:45. Die Arbeiten des zweiten Tages sind abgeschlossen.
09:45. Heute ist Freitag. Im Monitoring gibt es nach wie vor zahlreiche kleine Probleme. Das Wochenende steht vor der Tür, jeder möchte sich ausruhen. Wir setzen die umfangreichen Reparaturen aller möglicher Komponenten fort. Die administrativen Aufgaben, die aufgeschoben werden konnten, sind aufgeschoben. Ein neuer Koordinator ist im Einsatz.
15:40. Plötzlich hat sich die Hälfte des Stacks der Core-Netzwerkausrüstung in einem ANDEREN Rechenzentrum neu gestartet. Wir haben die Frontends aus dem Betrieb genommen, um Risiken zu minimieren. Die Nutzer haben keine Auswirkungen verspürt. Später stellte sich heraus, dass es sich um ein fehlerhaftes Chassis handelte. Der Koordinator arbeitet daran, gleich zwei Störungen zu beheben.
17:17. Der Netzbetrieb im anderen Rechenzentrum wurde wiederhergestellt, alles wurde überprüft. Das Rechenzentrum wurde wieder in den Betrieb genommen.
18:29. Die Arbeiten des dritten Tages und die allgemeine Wiederherstellung nach dem Vorfall sind abgeschlossen.
Nachwort
04.04.2013, , "Odноклассники" — während drei Tagen war das Portal vollständig oder teilweise nicht verfügbar. In dieser Zeit haben über 100 Personen aus verschiedenen Städten, aus verschiedenen Unternehmen (nochmals vielen Dank!), remote und direkt in den Rechenzentren, manuell und automatisch tausende Server repariert.
Wir haben Lehren daraus gezogen. Damit sich so etwas nicht wiederholt, haben wir umfassende Maßnahmen ergriffen und setzen diese bis heute fort.
Was sind die Hauptunterschiede des aktuellen Vorfalls im Vergleich zum 404?
- Wir haben einen "Notfallaktionsplan" eingeführt. Einmal im Quartal führen wir Übungen durch — wir simulieren einen Notfall, den die Gruppe der Administratoren (alle abwechselnd) mithilfe des "Notfallaktionsplans" beheben muss. Die leitenden Systemadministratoren üben abwechselnd die Rolle des Koordinators.
- Jedes Quartal isolieren wir im Testbetrieb die Rechenzentren (alle abwechselnd) im LAN- und WAN-Netzwerk, was es uns ermöglicht, Engpässe rechtzeitig zu erkennen.
- Weniger defekte Festplatten, da wir die Standards verschärft haben: weniger Betriebsstunden, strengere Schwellenwerte für S.M.A.R.T.
- Wir haben ganz auf BerkeleyDB verzichtet — die alte und instabile Datenbank, die viel Zeit für die Wiederherstellung nach dem Serverneustart benötigte.
- Die Anzahl der MS SQL-Server wurde reduziert und die Abhängigkeit von den verbleibenden Servern verringert.
- Wir haben unsere eigene , in die wir bereits seit zwei Jahren aktiv alle Dienste migrieren. Die Cloud vereinfacht den gesamten Arbeitszyklus mit der Anwendung erheblich und bietet im Falle eines Ausfalls einzigartige Werkzeuge wie:
- korrektes Stoppen aller Anwendungen mit einem Klick;
- einfache Migration von Anwendungen von fehlerhaften Servern;
- automatischer rangierter (nach Priorität der Dienste) Start eines gesamten Rechenzentrums.
Der in diesem Artikel beschriebene Vorfall war der größte seit dem 404. Natürlich lief nicht alles glatt. Zum Beispiel fiel während der Unzugänglichkeit des ausgebrannten Rechenzentrums in einem anderen Rechenzentrum eine Festplatte auf einem der Server aus, sodass nur eine von drei Repliken im Cassandra-Cluster verfügbar war, was dazu führte, dass 4,2 % der Benutzer mobiler Anwendungen sich nicht einloggen konnten. Gleichzeitig konnten bereits angemeldete Benutzer weiterhin arbeiten. Insgesamt wurden aufgrund des Vorfalls über 30 Probleme festgestellt – von banalen Bugs bis hin zu architektonischen Mängeln der Dienste.
Aber der wichtigste Unterschied zwischen dem aktuellen Vorfall und dem 404. ist, dass während wir die Folgen des Brandes beseitigten, die Benutzer weiterhin Nachrichten schrieben und Videoanrufe in , Spiele spielten, Musik hörten, sich gegenseitig Geschenke schenkten, Videos, Serien und Fernsehsender in , und auch in .
Wie verlaufen Ihre Vorfälle?
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish