

Vorwort
Es gibt ein solches einfaches und sehr nützliches Tool in der Welt — , und es hat sich so ergeben, dass es schon lange in unserem Produktionsprozess verwurzelt ist (obwohl ich es nicht geschafft habe, die Version zu installieren, war sie definitiv nicht die neueste verfügbare). Wir verwenden es für seinen ursprünglichen Zweck — das Erstellen von binären Patches. Wenn man sieht, was im Repository ist, wird es ein wenig traurig: Es ist im Wesentlichen seit langem aufgegeben worden und vieles dort ist stark veraltet (vor langer Zeit hat ein ehemaliger Kollege einige Änderungen vorgenommen, aber das ist lange her). Ich habe beschlossen, das Ganze wiederzubeleben: Ich habe geforkt, was ich nicht nutzen will, entfernt und das Projekt auf , „heiße“ Mikrofunktionen inline integriert, große Arrays vom Stack entfernt (und Arrays variabler Länge, die mir offen gesagt „auf die Nerven gingen“), den Profiler erneut durchlaufen lassen — und festgestellt, dass etwa 40 % der Zeit auf …
verwendet werden. Was ist also mit fwrite?
Im vorliegenden Code wird fwrite (in meinem spezifischen Testfall: Patch-Erstellung zwischen nahen 300 MB Dateien, die Eingabedaten vollständig im Speicher) millionenfach mit einem kleinen Puffer aufgerufen. Es ist offensichtlich, dass diese Angelegenheit verlangsamen wird, und deshalb wollte ich irgendwie Einfluss darauf nehmen, ohne allzu große Umstellungen vorzunehmen. Quellen für Daten einführen, asynchrone Ein- und Ausgabe ist momentan nicht gewünscht; ich wollte eine einfachere Lösung finden. Das Erste, was mir einfiel, war, die Pufferspeichergröße zu erhöhen
setvbuf(file, nullptr, _IOFBF, 64* 1024), aber ich habe keine wesentliche Verbesserung des Ergebnisses erhalten (jetzt wurden etwa 37 % der Zeit auf fwrite verwendet) — das heißt, es liegt wohl nicht an der häufigen Schreibvorgängen auf die Festplatte. Ein Blick „unter die Haube“ von fwrite zeigt, dass intern ungefähr so etwas wie lock/unlock der FILE-Struktur geschieht (Pseudocode, die gesamte Analyse erfolgte unter Visual Studio 2017):
size_t fwrite (const void *buffer, size_t size, size_t count, FILE *stream)
{
   size_t retval = 0;
   _lock_str(stream);   \/\* lock stream *\/\n   __try\n   {\n      retval = _fwrite_nolock(buffer, size, count, stream);\n   }\n   __finally \n   {\n       _unlock_str(stream);   \/\* unlock stream *\/\n   }\n   return retval;\n}
Wenn der Profiler zu glauben ist, entfällt auf _fwrite_nolock lediglich 6 % der Zeit, der Rest ist Overhead. In meinem speziellen Fall ist Thread-Sicherheit ein offensichtlicher Luxus, den ich opfere, indem ich den Aufruf von fwrite durch — man muss nicht einmal mit Argumenten herumspielen. Insgesamt hat diese einfache Manipulation die Kosten für das Ergebnis erheblich reduziert, die im ursprünglichen Fall fast die Hälfte der zeitlichen Aufwendungen ausmachten. Übrigens gibt es in der Welt von POSIX eine ähnliche Funktion — . Grundsätzlich gilt das Gleiche für fread. Somit kann man mit einem Paar #define eine völlig plattformübergreifende Lösung ohne unnötige Sperren erhalten, sofern diese nicht notwendig sind (und das kommt ziemlich oft vor).
fwrite, _fwrite_nolock, setvbuf
Lassen Sie uns von dem ursprünglichen Projekt abstrahieren und einen spezifischen Fall testen: das Schreiben einer großen Datei (512 MB) in minimalen Portionen — jeweils 1 Byte. Testsystem: AMD Ryzen 7 1700, 16 GB RAM, HDD 7200 U/min mit 64 MB Cache, Windows 10 1809, das Binary wurde 32-Bit kompiliert, Optimierungen sind aktiviert, die Bibliothek wurde statisch verlinkt.
Beispiel für das Experiment:
#include <chrono>
#include <cstdio>
#include <inttypes.h>
#include <memory>

#ifdef _MSC_VER
#define fwrite_unlocked _fwrite_nolock
#endif

using namespace std::chrono;

int main()
{
    std::unique_ptr<FILE, int(*)(FILE*)> file(fopen("test.bin", "wb"), fclose);
    if (!file)
        return 1;

    constexpr size_t TEST_BUFFER_SIZE = 256 * 1024;
    if (setvbuf(file.get(), nullptr, _IOFBF, TEST_BUFFER_SIZE) != 0)
        return 2;

    auto start = steady_clock::now();
    const uint8_t b = 77;
    constexpr size_t TEST_FILE_SIZE = 512 * 1024 * 1024;
    for (size_t i = 0; i < TEST_FILE_SIZE; ++i)
        fwrite_unlocked(&b, 1, sizeof(b), file.get());

    auto end = steady_clock::now();
    auto interval = duration_cast<microseconds>(end - start);
    printf("Time: %lldn", interval.count());

    return 0;
}
Als Variablen werden TEST_BUFFER_SIZE verwendet, außerdem ersetzen wir in einigen Fällen fwrite_unlocked durch fwrite. Wir beginnen mit dem Fall fwrite ohne explizite Puffergröße (wir kommentieren setvbuf und den dazugehörigen Code aus): Zeit 27048906 µs, Schreibgeschwindigkeit — 18,93 MB/s. Jetzt setzen wir die Puffergröße auf 64 KB: Zeit — 25037111 µs, Geschwindigkeit — 20,44 MB/s. Jetzt testen wir die Funktion _fwrite_nolock ohne Aufruf von setvbuf: 7262221 µs, Geschwindigkeit — 70,5 MB/s!
Jetzt experimentieren wir mit der Puffergröße (setvbuf):
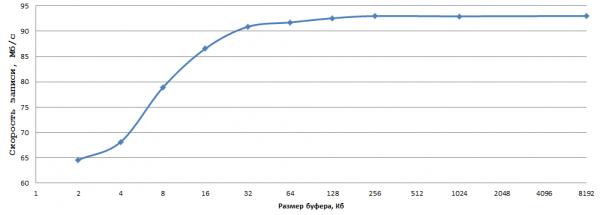
Die Daten stammen aus dem Durchschnitt von 5 Experimenten, die Fehler zu berechnen, war mir zu mühsam. Meiner Meinung nach ist 93 MB/s beim Schreiben von 1 Byte auf eine normale HDD ein sehr gutes Ergebnis; man muss lediglich die optimale Puffergröße wählen (in meinem Fall 256 KB — das ist genau richtig) und fwrite durch _fwrite_nolock/fwrite_unlocked ersetzen (sofern keine Thread-Sicherheit erforderlich ist, versteht sich).
Ähnlich verhält es sich mit fread unter ähnlichen Bedingungen. Da ich keinen "hardwaremäßigen" Rechner mit Linux zur Hand hatte (Einplatinencomputer zählen nicht), beschloss ich, ein begrenztes Experiment auf einer virtuellen Maschine (Hyper-V, OpenSUSE 15, GCC 8.3.1) durchzuführen — die Regelmäßigkeit ist grundsätzlich die gleiche: „nacktes“ fwrite 20 MB/s, fwrite + Puffer von 256 KB gab 23 MB/s, fwrite_unlocked mit demselben Puffer — 35 MB/s (Binary 64-Bit, kompiliert mit g++ -o2 -s -static-libgcc -static-libstdc++ fwrite_test.cpp -o fwrite_test).
Nachwort
Ziel dieses Artikels war es, eine einfache und in vielen Fällen effektive Methode zu beschreiben (mit den Funktionen _fwrite_nolock/fwrite_unlocked hatte ich vorher nie zu tun, sie sind nicht besonders beliebt – zu Unrecht). Ich erhebe keinen Anspruch auf Neuheit des Materials, hoffe jedoch, dass der Artikel der Gemeinschaft nützlich sein wird.
Quelle: habr.com
