

Der legitime Verkehr im DDoS-Guard-Netz hat kürzlich die Hundert-Gigabit-Sekunden-Marke überschritten. Aktuell erzeugen 50 % unseres gesamten Verkehrs Web-Dienste von Kunden. Das sind viele zehntausende Domains, sehr unterschiedlich und in den meisten Fällen erforden sie einen individuellen Ansatz.
Unter dem Cut - wie wir die Front-Nodes verwalten und ausgeben SSL-Zertifikate für Hunderttausende von Webseiten.
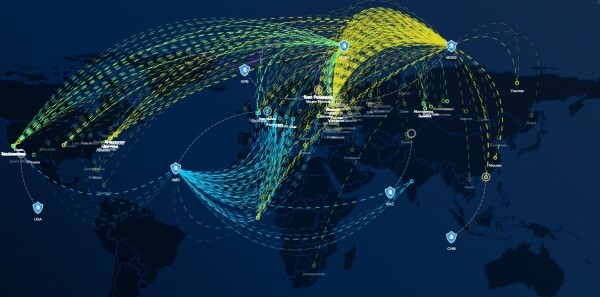
Die Front für eine einzige Webseite einzurichten, selbst für eine sehr große, ist einfach. Wir nehmen nginx oder haproxy oder lighttpd, richten sie gemäß den Anleitungen ein und vergessen es. Wenn wir etwas ändern müssen, machen wir einen Reload und vergessen es wieder.
Alles ändert sich, wenn man in Echtzeit große Verkehrsvolumen bearbeitet, die Legitimität von Anfragen bewertet, Nutzerinhalte komprimiert und cached und dabei die Parameter mehrmals pro Sekunde ändert. Der Nutzer möchte die Ergebnisse auf allen externen Nodes sehen, sobald er die Einstellungen in seinem Benutzerkonto geändert hat. Außerdem kann der Nutzer über die API mehrere Tausend (manchmal sogar Zehntausende) Domains mit individuellen Verkehrsbearbeitungsparametern hochladen. All dies muss ebenfalls sofort in Amerika, Europa und Asien funktionieren – eine nicht triviale Aufgabe, wenn man bedenkt, dass in Moskau mehrere physisch verteilte Filterknoten existieren.
Warum viele große zuverlässige Knoten weltweit?
- Die Qualität der Kundenverkehrsbereitstellung – Anfragen aus den USA müssen genau dort bearbeitet werden (auch hinsichtlich Angriffe, Parsing und andere Anomalien), und nicht nach Moskau oder Europa geschickt werden, was die Verarbeitungslatenz unvorhersehbar erhöht.
- Angreifender Verkehr muss lokalisiert werden – Transitbetreiber können während der Angriffe, deren Volumen oft 1 Tbps überschreitet, degradieren. Es ist keine gute Idee, angreifenden Verkehr über transatlantische oder transasiatische Verbindungen zu transportieren. Wir hatten echte Fälle, bei denen Tier-1-Betreiber sagten: 'Die Angriffsvolumen, die Sie empfangen, sind für uns gefährlich.' Genau deshalb nehmen wir eingehende Ströme so nah wie möglich an deren Quellen auf.
- Strenge Anforderungen an die Servicekontinuität – die Reinigungseinheiten dürfen nicht voneinander oder von lokalen Ereignissen in unserer sich schnell verändernden Welt abhängig sein. Wenn für eine Woche der Strom in allen 11 Etagen von MMTS-9 ausfällt? – kein Problem. Kein Kunde, der nicht physisch an diesem Standort angeschlossen ist, wird davon betroffen sein, und die Webdienste werden unter keinen Umständen beeinträchtigt.
Wie verwaltet man das alles?
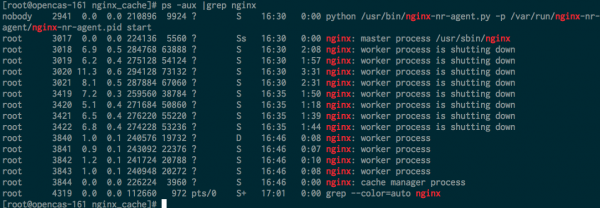
Die Konfigurationen der Dienste müssen so schnell wie möglich (idealerweise sofort) auf allen Front-End-Knoten verbreitet werden. Man kann nicht einfach die Textkonfigurationen ändern und die Dienste bei jeder Änderung neu starten – dasselbe gilt für nginx, das laufende Prozesse (worker shutting down) noch mehrere Minuten (oder sogar Stunden, wenn es lange Websocket-Sitzungen gibt) hält.
Beim Neustarten der nginx-Konfiguration sieht die folgende Situation durchaus normal aus:
Zur Speichernutzung:
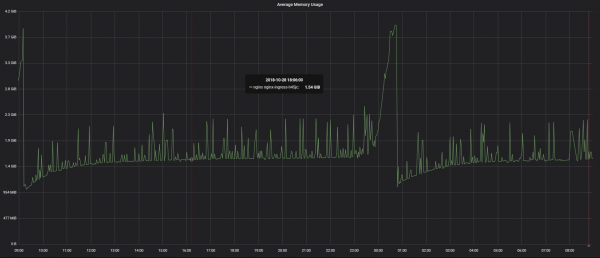
Die alten Worker verbrauchen Speicher, der unter anderem nicht linear von der Anzahl der Verbindungen abhängt – das ist normal. Wenn die clientseitigen Verbindungen geschlossen werden, wird dieser Speicher wieder freigegeben.
Warum war das kein Problem, als nginx gerade anfing, sich zu entwickeln? Es gab weder HTTP/2 noch WebSocket noch viele langfristige Keep-Alive-Verbindungen. 70 % unseres Webtraffics sind HTTP/2, und das sind sehr langanhaltende Verbindungen.
Die Lösung ist einfach – nginx nicht verwenden, Frontends nicht auf Basis von Textdateien verwalten und auf keinen Fall komprimierte Textkonfigurationen über transozeanische Kanäle bombardieren. Die Kanäle sind zwar garantiert und reserviert, aber dennoch transkontinental.
Wir haben einen eigenen Front-Server-Balancer, über dessen Innere ich in den folgenden Artikeln berichten werde. Das Wichtigste ist, dass er in der Lage ist, Tausende von Konfigurationsänderungen pro Sekunde in Echtzeit anzuwenden, ohne Neustarts, Reloads, sprunghaften Anstieg des Speicherverbrauchs und all das. Das ist sehr ähnlich wie Hot Code Reload, zum Beispiel in Erlang. Die Daten werden in einer geo-distribuierten Key-Value-Datenbank gespeichert und sofort von den ausführenden Mechanismen der Front-End-Systeme abgerufen. D.h. Sie haben das SSL-Zertifikat über die Web-Oberfläche oder API in Moskau hochgeladen, und nach ein paar Sekunden ist es bereits einsatzbereit in unserem Rechenzentrum in Los Angeles. Falls eines Tages ein Weltkrieg ausbricht und das Internet weltweit ausfällt, werden unsere Knoten weiterhin autonom arbeiten und das Split-Brain-Problema beheben, sobald einer der dedizierten Kanäle Los Angeles-Amsterdam-Moskau, Moskau-Amsterdam-Hongkong-Los Angeles oder zumindest einer der Reserve-Overlay-GRE verfügbar ist.
Dieser Mechanismus ermöglicht es uns auch, Zertifikate sofort auszustellen und zu verlängern. Zertifikate von Let’s Encrypt. Sehr vereinfacht funktioniert das so:
- Sobald wir auch nur eine HTTPS-Anfrage für die Domain unseres Kunden ohne Zertifikat (oder mit abgelaufenem Zertifikat) sehen, meldet der externe Knoten, der die Anfrage entgegengenommen hat, dies dem internen Zertifizierungszentrum.

- Wenn der Benutzer die Ausstellung von Let’s Encrypt nicht blockiert hat, erstellt das Zertifizierungszentrum ein CSR, erhält ein Bestätigungstoken von LE und sendet es über einen verschlüsselten Kanal an alle Frontend-Systeme. Jetzt kann jeder Knoten die Validierungsanfrage von LE bestätigen.
- Nach ein paar Momenten erhalten wir ein korrektes Zertifikat und einen privaten Schlüssel und verteilen diese ebenfalls an die Frontend-Systeme. Wiederum ohne Neustart der Daemons.
- Sieben Tage vor dem Ablaufdatum wird das Verfahren zur Neuausstellung des Zertifikats eingeleitet.
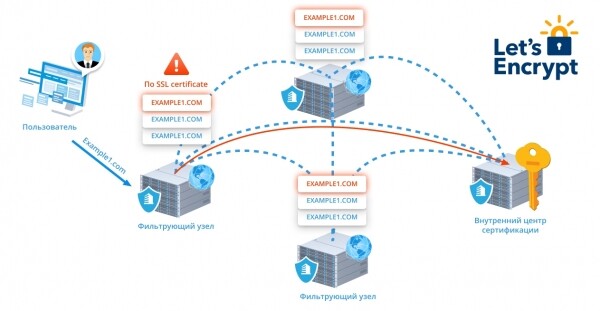
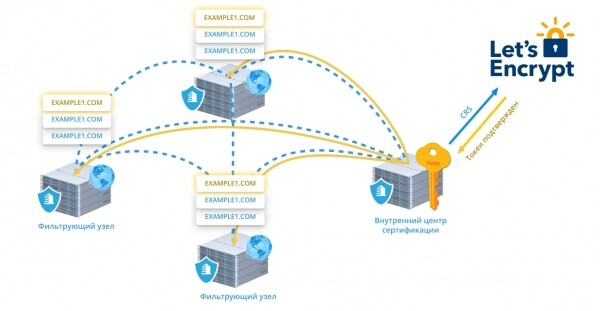
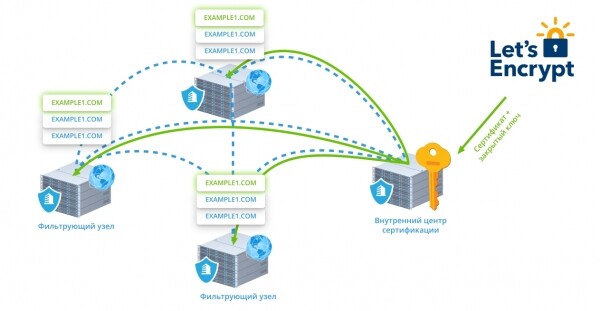
Aktuell rotieren wir in Echtzeit 350.000 Zertifikate völlig transparent für die Benutzer.
In den kommenden Artikeln der Reihe werde ich über andere Eigenschaften der Echtzeitverarbeitung großer Web-Traffic-Mengen berichten — zum Beispiel über die Analyse von RTT bei unvollständigen Daten zur Verbesserung der Servicequalität für Transitkunden und allgemein über den Schutz von Transit-Traffic gegen Terabitt-Angriffe, über die Lieferung und Aggregation von Informationen über den Traffic, über WAF, nahezu unbegrenzte CDN und viele Mechanismen zur Optimierung der Inhaltsauslieferung.
Nur registrierte Benutzer können an der Umfrage teilnehmen. Bitte einloggen.
Worüber möchten Sie zuerst Informationen erhalten?
- 14,3%Cluster-Algorithmen und Analyse der Qualität des Web-Traffics<3
- 33,3%Innere von DDoS-Guard-Balancern7
- 9,5%Schutz des transitiven L3/L4-Traffics2
- 0,0%Schutz von Webseiten im transitiven Traffic0
- 14,3%Web Application Firewall3
- 28,6%Schutz vor Parsing und Click Fraud6
21 Benutzer haben abgestimmt. 6 Benutzer haben sich enthalten.
Quelle: habr.com
