

TL; DR: JSONB kann die Entwicklung von DB-Schemata erheblich vereinfachen, ohne die Abfrageleistung zu beeinträchtigen.
Einführung
Ein klassisches Beispiel, wahrscheinlich eine der ältesten Anwendungen in der Welt der relationalen Datenbanken (Datenbank): Wir haben eine Entität und müssen bestimmte Eigenschaften (Attribute) dieser Entität speichern. Aber nicht alle Exemplare können denselben Satz von Eigenschaften haben; zudem können in Zukunft weitere Eigenschaften hinzugefügt werden.
Der einfachste Weg, dieses Problem zu lösen, besteht darin, eine Spalte in der DB-Tabelle für jeden Wert des Attributs zu erstellen und einfach die auszufüllen, die für ein bestimmtes Exemplar der Entität benötigt werden. Großartig! Problem gelöst... bis deine Tabelle Millionen von Datensätzen enthält und du die Notwendigkeit hast, einen neuen Datensatz hinzuzufügen.
Betrachten wir das EAV-Muster (), das ziemlich häufig vorkommt. Eine Tabelle enthält Entitäten (Datensätze), eine andere Tabelle enthält Eigenschaftsnamen (Attribute), und eine dritte Tabelle verbindet Entitäten mit ihren Attributen und enthält die Werte dieser Attribute für die aktuelle Entität. Dies ermöglicht es dir, verschiedene Eigenschaftssätze für unterschiedliche Objekte zu haben und Eigenschaften „on the fly“ hinzuzufügen, ohne die DB-Strukturen zu ändern.
Dennoch würde ich diese Notiz nicht schreiben, wenn es nicht auch Nachteile bei der Verwendung von EAV gäbe. So benötigt man zum Abrufen einer oder mehrerer Entitäten, die jeweils 1 Attribut haben, 2 Joins in der Abfrage: der erste – der Join mit der Tabelle der Attribute, der zweite – der Join mit der Tabelle der Werte. Haben die Entitäten 2 Attribute, sind es bereits 4 Joins! Darüber hinaus werden alle Attribute normalerweise als Strings gespeichert, was zu Typumwandlungen sowohl für das Ergebnis als auch für die WHERE-Bedingung führt. Wenn du viele Abfragen schreibst, ist das hinsichtlich des Ressourcenverbrauchs recht verschwenderisch.
Trotz dieser offensichtlichen Nachteile wird EAV schon lange zur Lösung solcher Probleme eingesetzt. Es waren unvermeidbare Nachteile, und es gab einfach keine bessere Alternative.
Doch dann kam eine neue „Technologie“ in PostgreSQL…
Seit PostgreSQL 9.4 wurde der Datentyp JSONB hinzugefügt, um binäre JSON-Daten zu speichern. Obwohl die Speicherung von JSON in diesem Format in der Regel etwas mehr Platz und Zeit benötigt als einfacher Text-JSON, sind die Operationen damit viel schneller. Außerdem unterstützt JSONB das Indizieren, was Abfragen noch schneller macht.
Der Datentyp JSONB ermöglicht es uns, das umständliche EAV-Muster zu ersetzen, indem wir lediglich eine JSONB-Spalte zu unserer Entitätstabelle hinzufügen, was das Datenbankdesign erheblich vereinfacht. Viele behaupten jedoch, dass dies mit einem Rückgang der Leistung einhergehen sollte… Aus diesem Grund ist dieser Artikel entstanden.
Einrichten einer Testdatenbank
Für diesen Vergleich habe ich eine Datenbank auf einer neuen Installation von PostgreSQL 9.5 auf einem 80-Dollar-Bauteil erstellt Ubuntu 14.04. Nach der Anpassung einiger Parameter in postgresql.conf habe ich das Skript mit psql ausgeführt. Für die Darstellung der Daten im EAV wurden die folgenden Tabellen erstellt:
CREATE TABLE entity (
  id           SERIAL PRIMARY KEY,
  name         TEXT,
  description  TEXT
);
CREATE TABLE entity_attribute (
  id          SERIAL PRIMARY KEY,
  name        TEXT
);
CREATE TABLE entity_attribute_value (
  id                  SERIAL PRIMARY KEY,
  entity_id           INT    REFERENCES entity(id),
  entity_attribute_id INT    REFERENCES entity_attribute(id),
  value               TEXT
);
Unten ist die Tabelle dargestellt, wo die gleichen Daten gespeichert werden, aber mit Attributen in der JSONB-Spalte – properties.
CREATE TABLE entity_jsonb (
  id          SERIAL PRIMARY KEY,
  name        TEXT,
  description TEXT,
  properties  JSONB
);
Sieht viel einfacher aus, oder? Dann wurden 10 Millionen Datensätze zu den Entitätstabellen (entity & entity_jsonb) hinzugefügt, und entsprechend wurden die Tabellen, in denen das EAV-Muster und der Ansatz mit der JSONB-Spalte verwendet wird, mit denselben Daten gefüllt – entity_jsonb.properties. Damit erhielten wir mehrere verschiedene Datentypen unter all den Eigenschaften. Beispiel für Daten:
{
  id:          1
  name:        "Entity1"
  description: "Test-Entity Nr. 1"
  properties:  {
    color:        "rot"
    length:       120
    width:        3.1882420
    hasSomething: true
    country:      "Belgien"
  }
}
Jetzt haben wir also die gleichen Daten für zwei Varianten. Lassen Sie uns beginnen, die Implementierungen in der Praxis zu vergleichen!
Vereinfachung des Designs
Es wurde bereits erwähnt, dass das Datenbankdesign erheblich vereinfacht wurde: eine Tabelle, durch die Verwendung der JSONB-Spalte für Eigenschaften, anstelle von drei Tabellen für EAV. Aber wie wirkt sich das auf die Abfragen aus? Die Aktualisierung einer Eigenschaft einer Entität sieht folgendermaßen aus:
-- EAV
UPDATE entity_attribute_value
SET value = 'blau'
WHERE entity_attribute_id = 1
  AND entity_id = 120;

-- JSONB
UPDATE entity_jsonb
SET properties = jsonb_set(properties, '{"color"}', '"blau"')
WHERE id = 120;
Wie wir sehen, sieht die letzte Abfrage nicht einfacher aus. Um den Wert einer Eigenschaft im JSONB-Objekt zu aktualisieren, müssen wir die Funktion , und wir müssen unseren neuen Wert als JSONB-Objekt übergeben. Allerdings müssen wir keinen Identifier im Voraus kennen. Schaut man sich das Beispiel mit EAV an, müssen wir sowohl entity_id als auch entity_attribute_id kennen, um das Update durchzuführen. Wenn Sie eine Eigenschaft in einer JSONB-Spalte basierend auf dem Objektname aktualisieren möchten, geschieht das alles in einer einfachen Zeile.
Jetzt lassen Sie uns die Entität auswählen, die wir gerade basierend auf ihrer neuen Farbe aktualisiert haben:
-- EAV
SELECT e.name
FROM entity e
  INNER JOIN entity_attribute_value eav ON e.id = eav.entity_id
  INNER JOIN entity_attribute ea ON eav.entity_attribute_id = ea.id
WHERE ea.name = 'farbe' AND eav.value = 'blau';

-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties ->> 'color' = 'blau';
Ich denke, wir können uns einigen, dass die zweite Abfrage kürzer ist (ohne Join!) und somit lesbarer. Hier gewinnt JSONB! Wir verwenden den JSON-Operator ->>, um die Farbe als Textwert aus dem JSONB-Objekt zu erhalten. Es gibt auch einen zweiten Weg, um dasselbe Ergebnis im JSONB-Modell mit dem Operator @> zu erreichen:
-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties @> '{"color": "blau"}';
Das ist etwas komplizierter: Wir prüfen, ob das JSON-Objekt in der Spalte Eigenschaften das Objekt enthält, das sich rechts vom Operator @> befindet. Weniger lesbar, aber leistungsstärker (siehe weiter unten).
Lassen Sie uns die Verwendung von JSONB noch weiter vereinfachen, wenn Sie mehrere Eigenschaften gleichzeitig auswählen müssen. Hier passt der JSONB-Ansatz wirklich gut: Wir wählen einfach die Eigenschaften als zusätzliche Spalten in unserem Ergebnisset aus, ohne Joins vornehmen zu müssen:
-- JSONB
SELECT name
  , properties ->> 'color'
  , properties ->> 'country'
FROM entity_jsonb
WHERE id = 120;
Mit EAV benötigen Sie 2 Joins für jede Eigenschaft, die Sie abfragen möchten. Meiner Meinung nach zeigen die oben genannten Abfragen eine erhebliche Vereinfachung im Datenbankdesign. Mehr Beispiele, wie man Abfragen an JSONB schreibt, finden Sie möglicherweise auch in dem Beitrag.
Jetzt ist es an der Zeit, über die Leistung zu sprechen.
Leistung
Um die Leistung zu vergleichen, habe ich In den Abfragen zur Berechnung der Ausführungszeit. Jede Abfrage wurde mindestens dreimal ausgeführt, da der Abfrageplaner beim ersten Mal mehr Zeit benötigt. Zuerst habe ich die Abfragen ohne jegliche Indizes ausgeführt. Offensichtlich hatte dies einen Vorteil für JSONB, da die Joins, die für EAV erforderlich sind, keine Indizes verwenden konnten (die Fremdschlüssel-Felder waren nicht indiziert). Danach habe ich einen Index für die 2 externen Schlüsselspalten der EAV-Wertetabelle sowie einen Index erstellt. für die JSONB-Spalte.
Die Datenaktualisierungen zeigten die folgenden Ergebnisse hinsichtlich der Zeit (in ms). Bitte beachten Sie, dass die Skala logarithmisch ist:
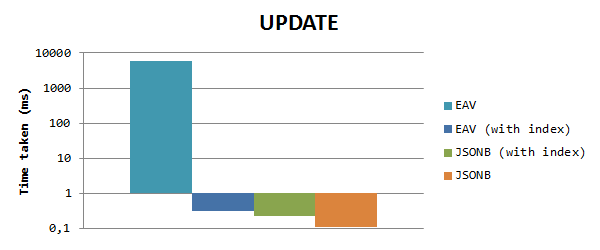
Wir sehen, dass JSONB viel schneller (> 50000-x) als EAV ist, wenn keine Indizes verwendet werden, aus den oben genannten Gründen. Wenn wir die Spalten mit Primärschlüsseln indizieren, verschwindet der Unterschied fast, aber JSONB ist immer noch 1,3-mal schneller als EAV. Beachten Sie, dass der Index in der JSONB-Spalte hier keinen Einfluss hat, da wir die Eigenschaften-Spalte in den Bewertungskriterien nicht verwenden.
Für die Auswahl von Daten basierend auf dem Wert von Eigenschaften erhalten wir die folgenden Ergebnisse (normale Skala):
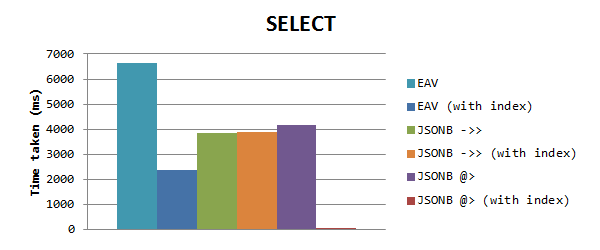
Es ist zu erkennen, dass JSONB erneut schneller arbeitet als EAV ohne Indizes, aber wenn EAV mit Indizes arbeitet, ist es dennoch schneller als JSONB. Dann habe ich gesehen, dass die Zeit für JSONB-Abfragen gleich war, was mich auf die Tatsache aufmerksam machte, dass der GIN-Index nicht greift. Offenbar funktioniert der GIN-Index für Spalten mit ausgefüllten Eigenschaften nur bei der Verwendung des Einschlussoperators @>. Ich nutzte dies in einem neuen Test, was einen enormen Einfluss auf die Zeit hatte: nur 0,153 ms! Das ist 15000-mal schneller als EAV und 25000-mal schneller als der Operator ->>.
Ich denke, das war schnell genug!
Größe der Datenbanktabellen
Lassen Sie uns die Größen der Tabellen bei beiden Ansätzen vergleichen. In psql können wir die Größe aller Tabellen und Indizes mit dem Befehl dti+
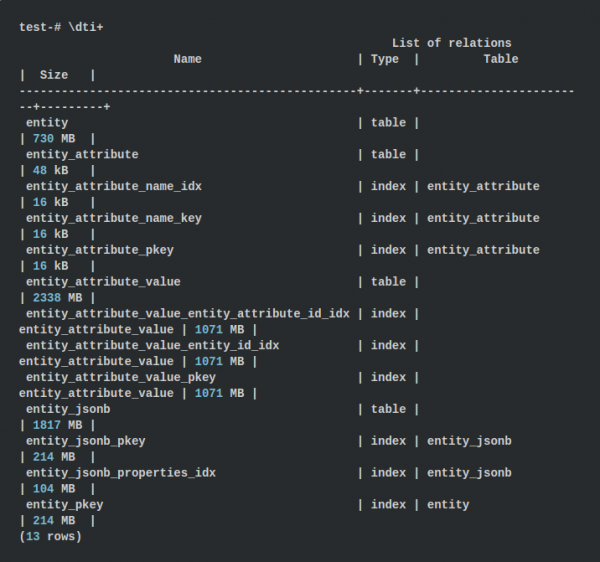
Für den EAV-Ansatz betragen die Tabellengrößen etwa 3068 MB, und die Indizes bis zu 3427 MB, was insgesamt 6,43 GB ergibt. Bei Verwendung des JSONB-Ansatzes werden 1817 MB für die Tabelle und 318 MB für die Indizes verwendet, was 2,08 GB ergibt. Das ist dreimal weniger! Diese Tatsache hat mich etwas überrascht, da wir die Eigenschaften in jedem JSONB-Objekt speichern.
Aber die Zahlen sprechen für sich selbst: In EAV speichern wir 2 Ganzzahl-Fremdschlüssel auf Attributwerte, was zu 8 zusätzlichen Bytes an Daten führt. Darüber hinaus werden in EAV alle Eigenschaftswerte als Text gespeichert, während JSONB numerische und boolesche Werte verwendet, wo dies möglich ist, was zu einem geringeren Volumen führt.
Ergebnisse
Insgesamt denke ich, dass die Speicherung von Entitätseigenschaften im JSONB-Format das Design und die Wartung Ihrer Datenbank erheblich vereinfachen kann. Wenn Sie viele Abfragen durchführen, wird alles, was in einer Tabelle mit der Entität gespeichert ist, tatsächlich effizienter funktionieren. Und die Tatsache, dass es die Interaktion zwischen den Daten vereinfacht, ist bereits ein Vorteil, aber auch die resultierende Datenbank hat ein Volumen, das dreimal kleiner ist.
Auch aus den durchgeführten Tests lässt sich zusammenfassen, dass die Leistungseinbußen sehr geringfügig sind. In einigen Fällen funktioniert JSONB sogar schneller als EAV, was es noch besser macht. Allerdings deckt dieser Benchmark-Test natürlich nicht alle Aspekte ab (zum Beispiel Entitäten mit einer sehr großen Anzahl von Eigenschaften, signifikantem Anstieg der Eigenschaften vorhandener Daten,…), daher, wenn Sie Vorschläge haben, wie man sie verbessern kann, zögern Sie bitte nicht, sie in den Kommentaren zu hinterlassen!
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish