

Liebe Leser, guten Tag. Heute sprechen wir ein wenig über Apache Spark und seine Entwicklungsperspektiven.
In der heutigen Welt der Big Data ist Apache Spark de facto der Standard für die Entwicklung von Batch-Datenverarbeitungsaufgaben. Darüber hinaus wird er auch zur Erstellung von Streaming-Anwendungen verwendet, die im Mikro-Batch-Konzept arbeiten und Daten in kleinen Portionen verarbeiten und bereitstellen (Spark Structured Streaming). Traditionell war er Teil des Hadoop-Stacks und verwendete YARN als Ressourcensmanager (oder in einigen Fällen Apache Mesos). Bis 2020 steht die Nutzung in ihrer traditionellen Form für die meisten Unternehmen in Frage, da es an brauchbaren Hadoop-Distributionen mangelt – die Entwicklung von HDP und CDH wurde eingestellt, CDH ist unzureichend entwickelt und hat hohe Kosten, während andere Hadoop-Anbieter entweder ihren Betrieb eingestellt haben oder eine ungewisse Zukunft haben. Daher wird das Starten von Apache Spark mit Kubernetes bei der Community und großen Unternehmen zunehmend interessant – als Standard in der Containerorchestrierung und Ressourcennutzung in privaten und öffentlichen Cloud-Umgebungen löst es das Problem der umständlichen Ressourcenplanung für Spark-Aufgaben auf YARN und bietet eine stabil wachsende Plattform mit zahlreichen kommerziellen und Open-Source-Distributionen für Unternehmen aller Größen und Branchen. Darüber hinaus haben viele Unternehmen auf der Welle der Popularität bereits ein paar ihrer eigenen Installationen eingerichtet und ihre Expertise in der Nutzung ausgebaut, was den Umstieg erleichtert.
Seit Version 2.3.0 hat Apache Spark die offizielle Unterstützung für das Starten von Aufgaben im Kubernetes-Cluster erhalten, und heute werden wir über die aktuelle Reife dieses Ansatzes, verschiedene Nutzungsmöglichkeiten und die Herausforderungen sprechen, die bei der Implementierung auf uns zukommen werden.
Zunächst werden wir den Entwicklungsprozess von Aufgaben und Anwendungen auf Basis von Apache Spark betrachten und typische Fälle hervorheben, in denen es erforderlich ist, eine Aufgabe im Kubernetes-Cluster zu starten. Bei der Vorbereitung dieses Beitrags wurde OpenShift als Distribution verwendet, und es werden Befehle aufgeführt, die für dessen Kommandozeilen-Utility (oc) relevant sind. Für andere Kubernetes-Distributionen können entsprechende Befehle der Standard-Kommandozeilen-Utility Kubernetes (kubectl) oder deren Alternativen (beispielsweise für oc adm policy) verwendet werden.
Die erste Verwendung ist — spark-submit
Im Prozess der Entwicklung von Aufgaben und Anwendungen muss der Entwickler Aufgaben zur Debugging von Datentransformationen ausführen. Theoretisch könnten dafür Stubs verwendet werden, aber die Entwicklung mit realen (auch wenn es sich um Testversionen handelt) Instanzen finaler Systeme hat sich in dieser Kategorie von Aufgaben als schneller und qualitativ besser erwiesen. Wenn wir Debugging an realen Instanzen finaler Systeme durchführen, gibt es zwei mögliche Arbeitsabläufe:
- der Entwickler führt die Spark-Aufgabe lokal im Standalone-Modus aus;

- der Entwickler führt die Spark-Aufgabe auf einem Kubernetes-Cluster in einer Testumgebung aus.
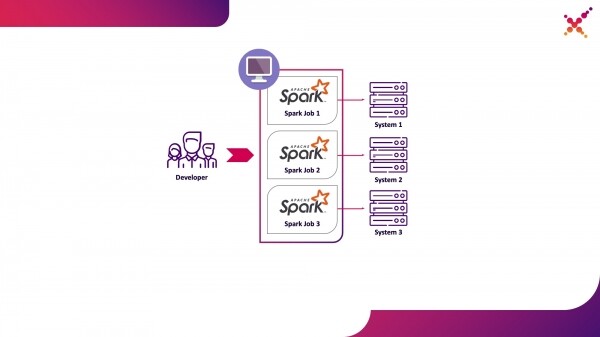
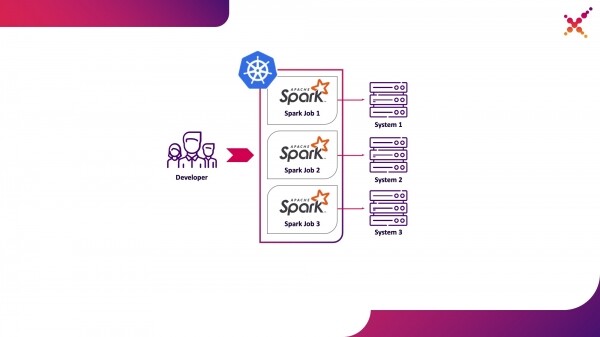
Die erste Variante hat ihre Berechtigung, bringt jedoch eine Reihe von Nachteilen mit sich:
- Für jeden Entwickler muss der Zugriff von seinem Arbeitsplatz auf alle erforderlichen Instanzen finaler Systeme gewährleistet sein;
- auf dem Arbeitsgerät müssen ausreichend Ressourcen vorhanden sein, um die zu entwickelnde Aufgabe auszuführen.
Die zweite Variante hat diese Nachteile nicht, da die Verwendung eines Kubernetes-Clusters es ermöglicht, den erforderlichen Ressourcenpool für die Ausführung von Aufgaben bereitzustellen und den erforderlichen Zugang zu den Instanzen finaler Systeme zu gewährleisten, indem der Zugriff über ein Rollenkonzept von Kubernetes flexibel für alle Mitglieder des Entwicklerteams bereitgestellt wird. Heben wir sie als die erste Verwendung hervor — die Ausführung von Spark-Aufgaben von der lokalen Maschine des Entwicklers auf einem Kubernetes-Cluster in einer Testumgebung.
Lassen Sie uns genauer auf den Prozess der Konfiguration von Spark für den lokalen Start eingehen. Um Spark zu verwenden, muss es installiert werden:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Wir sammeln die erforderlichen Pakete für die Zusammenarbeit mit Kubernetes:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
Der vollständige Build dauert lange, und um Docker-Images zu erstellen und sie wirklich auf dem Kubernetes-Cluster auszuführen, werden in der Realität nur die Jar-Dateien aus dem Verzeichnis „assembly/“ benötigt, daher kann nur dieses Unterprojekt gebaut werden:
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
Um Spark-Aufgaben in Kubernetes auszuführen, muss ein Docker-Image erstellt werden, das als Basis dienen wird. Hier gibt es 2 Ansätze:
- Das erstellte Docker-Image enthält den ausführbaren Code der Spark-Aufgabe;
- Das erstellte Image enthält nur Spark und die notwendigen Abhängigkeiten, der ausführbare Code wird remote bereitgestellt (z. B. in HDFS).
Beginnen wir mit dem Erstellen des Docker-Images, das ein Testbeispiel für die Spark-Aufgabe enthält. Zum Erstellen von Docker-Images gibt es bei Spark ein entsprechendes Tool namens „docker-image-tool“. Lassen Sie uns die Hilfe dazu anschauen:
./bin/docker-image-tool.sh --help
Mit diesem Tool können Docker-Images erstellt und in remote Registries hochgeladen werden, aber standardmäßig hat es einige Nachteile:
- es erstellt zwingend 3 Docker-Images – für Spark, PySpark und R;
- es erlaubt nicht, einen Namen für das Image anzugeben.
Deshalb verwenden wir eine modifizierte Version dieses Tools, die wie folgt aussieht:
vi bin/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
Damit erstellen wir ein Basis-Image von Spark, das eine Testaufgabe zur Berechnung der Zahl Pi mit Spark enthält (hierbei ist {docker-registry-url} – die URL Ihres Docker-Image-Registrierung, {repo} – der Name des Repositories innerhalb der Registry, das mit dem Projekt in OpenShift übereinstimmt, {image-name} – der Name des Images (wenn eine dreistufige Trennung der Images verwendet wird, wie z. B. im integrierten Image-Registry von Red Hat OpenShift), {tag} – der Tag dieser Version des Images):
./bin/docker-image-tool-upd.sh -f resource-managers/kubernetes/docker/src/main/dockerfiles/spark/Dockerfile -r {docker-registry-url}/{repo} -i {image-name} -t {tag} build
Wir melden uns im OKD-Cluster mit dem Konsolen-Tool an (hierbei ist {OKD-API-URL} – die URL der API des OKD-Clusters):
oc login {OKD-API-URL}
Wir erhalten das Token des aktuellen Benutzers zur Authentifizierung im Docker Registry:
oc whoami -t
Wir melden uns im internen Docker Registry des OKD-Clusters an (als Passwort verwenden wir das mit dem vorherigen Befehl erhaltene Token):
docker login {docker-registry-url}
Wir laden das erstellte Docker-Image in das OKD Docker Registry hoch:
./bin/docker-image-tool-upd.sh -r {docker-registry-url}/{repo} -i {image-name} -t {tag} push
Wir überprüfen, ob das erstellte Image im OKD verfügbar ist. Dazu öffnen wir im Browser die URL mit der Liste der Images des entsprechenden Projekts (hierbei ist {project} – der Name des Projekts innerhalb des OpenShift-Clusters, {OKD-WEBUI-URL} – die URL der Webkonsole von OpenShift) – https://{OKD-WEBUI-URL}/console/project/{project}/browse/images/{image-name}.
Für die Ausführung von Aufgaben muss ein Dienstkonto mit Berechtigungen zum Starten von Pods unter root erstellt werden (dies werden wir später besprechen):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Wir führen den Befehl spark-submit aus, um die Spark-Aufgabe im OKD-Cluster zu veröffentlichen, und geben das erstellte Dienstkonto und das Docker-Image an:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Hier:
—name — der Name der Aufgabe, der in die Benennung der Kubernetes-Pods einfließt;
—class — Klasse der ausführbaren Datei, die beim Starten der Aufgabe aufgerufen wird;
—conf — Konfigurationsparameter von Spark;
spark.executor.instances — Anzahl der gestarteten Spark-Executor;
spark.kubernetes.authenticate.driver.serviceAccountName — Name des Kubernetes-Servicekontos, das beim Starten der Pods verwendet wird (zur Bestimmung des Sicherheitskontextes und der Berechtigungen bei der Interaktion mit der Kubernetes-API);
spark.kubernetes.namespace — Kubernetes-Namensraum, in dem die Pods des Treibers und der Executor gestartet werden;
spark.submit.deployMode — Methode zum Starten von Spark (für das Standard-spark-submit wird „cluster“ verwendet, für den Spark Operator und spätere Versionen von Spark „client“);
spark.kubernetes.container.image — Docker-Image, das zum Starten der Pods verwendet wird;
spark.master — URL der Kubernetes-API (angegeben wird der externe Zugriff von einem lokalen Computer);
local:// — Pfad zur ausführbaren Spark-Datei innerhalb des Docker-Images.
Wir wechseln zum entsprechenden OKD-Projekt und untersuchen die erstellten Pods — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
Zur Erleichterung des Entwicklungsprozesses kann eine weitere Option verwendet werden, bei der ein gemeinsames Basis-Image von Spark erstellt wird, das von allen Aufgaben zum Starten verwendet wird, und die Snapshots der ausführbaren Dateien in einem externen Speicher (z.B. Hadoop) veröffentlicht werden und beim Aufruf von spark-submit als Link angegeben werden. In diesem Fall können verschiedene Versionen von Spark-Jobs ohne Neugebäude der Docker-Images gestartet werden, beispielsweise indem WebHDFS zur Veröffentlichung der Images verwendet wird. Wir senden eine Anfrage zur Erstellung der Datei (hierbei ist {host} der Host des WebHDFS-Dienstes, {port} der Port des WebHDFS-Dienstes, {path-to-file-on-hdfs} der gewünschte Pfad zur Datei auf HDFS):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE
In diesem Fall wird eine Antwort in folgender Form erhalten (hier ist {location} die URL, die zum Hochladen der Datei verwendet werden muss):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Wir laden die ausführbare Spark-Datei in HDFS hoch (hierbei ist {path-to-local-file} der Pfad zur ausführbaren Spark-Datei auf dem aktuellen Host):
curl -i -X PUT -T {path-to-local-file} "{location}"
Danach können wir spark-submit mit der in HDFS hochgeladenen Spark-Datei ausführen (hierbei ist {class-name} der Name der Klasse, die zur Ausführung der Aufgabe gestartet werden soll):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
Dabei sollte beachtet werden, dass für den Zugriff auf HDFS und die ordnungsgemäße Ausführung der Aufgabe möglicherweise Änderungen an der Dockerfile und dem Skript entrypoint.sh erforderlich sind — fügen Sie eine Direktive zum Dockerfile hinzu, um abhängige Bibliotheken in das Verzeichnis /opt/spark/jars zu kopieren und die HDFS-Konfigurationsdatei in SPARK_CLASSPATH in entrypoint.sh aufzunehmen.
Die zweite Nutzungsmöglichkeit – Apache Livy
Wenn die Aufgabe entwickelt und das Ergebnis getestet werden soll, stellt sich die Frage, wie sie im CI/CD-Prozess gestartet und ihre Ausführungsstatus verfolgt werden können. Natürlich kann sie auch über einen lokalen Aufruf von spark-submit gestartet werden, aber das kompliziert die CI/CD-Infrastruktur, da es die Installation und Konfiguration von Spark auf den CI-Server-Agenten/Runners und den Zugriff auf die Kubernetes-API erfordert. Für diesen Fall wurde als Zielimplementierung die Verwendung von Apache Livy als REST-API zum Starten von Spark-Jobs gewählt, die innerhalb des Kubernetes-Clusters gehostet wird. Damit können Spark-Jobs im Kubernetes-Cluster über einfache cURL-Anfragen gestartet werden, was sich leicht in jede CI-Lösung integrieren lässt, und das Hosting innerhalb des Kubernetes-Clusters löst das Authentifizierungsproblem beim Zugriff auf die Kubernetes-API.
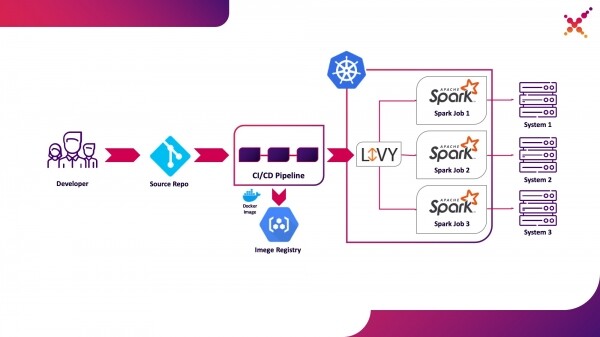
Wir heben dies als zweite Nutzungsmöglichkeit hervor – das Starten von Spark-Jobs im Rahmen des CI/CD-Prozesses auf einem Kubernetes-Cluster in einem Testumfeld.
Ein paar Worte zu Apache Livy – es fungiert als HTTP-Server, der eine Weboberfläche und ein RESTful API bereitstellt, mit dem Spark-Jobs remot über spark-submit gestartet werden können, wobei die notwendigen Parameter übergeben werden. Traditionell wurde es als Teil der HDP-Distribution geliefert, kann jedoch auch in OKD oder jeder anderen Kubernetes-Installation mit dem entsprechenden Manifest und einem Satz von Docker-Images bereitgestellt werden, wie zum Beispiel diesem — . Für unseren Anwendungsfall wurde ein ähnliches Docker-Image erstellt, das Spark Version 2.4.5 aus dem folgenden Dockerfile umfasst:
FROM java:8-alpine

ENV SPARK_HOME=/opt/spark
ENV LIVY_HOME=/opt/livy
ENV HADOOP_CONF_DIR=/etc/hadoop/conf
ENV SPARK_USER=spark

WORKDIR /opt

RUN apk add --update openssl wget bash &&
    wget -P /opt https://downloads.apache.org/spark/spark-2.4.5/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s /opt/spark-2.4.5-bin-hadoop2.7 /opt/spark

RUN wget http://mirror.its.dal.ca/apache/incubator/livy/0.7.0-incubating/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s /opt/apache-livy-0.7.0-incubating-bin /opt/livy &&
    mkdir /var/log/livy &&
    ln -s /var/log/livy /opt/livy/logs &&
    cp /opt/livy/conf/log4j.properties.template /opt/livy/conf/log4j.properties

ADD livy.conf /opt/livy/conf
ADD spark-defaults.conf /opt/spark/conf/spark-defaults.conf
ADD entrypoint.sh /entrypoint.sh

ENV PATH="/opt/livy/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["/entrypoint.sh"]
CMD ["livy-server"]
Das erzeugte Image kann in Ihr vorhandenes Docker-Repository, beispielsweise das interne OKD-Repository, geladen werden. Für die Bereitstellung wird folgendes Manifest verwendet ({registry-url} — URL des Docker-Image-Registrierungsdienstes, {image-name} — Name des Docker-Images, {tag} — Tag des Docker-Images, {livy-url} — gewünschte URL, unter der der Livy-Server verfügbar sein wird; das Manifest „Route“ wird verwendet, wenn Red Hat OpenShift als Kubernetes-Distribution eingesetzt wird, andernfalls wird das entsprechende Manifest Ingress oder Service vom Typ NodePort verwendet):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
Nach seiner Anwendung und dem erfolgreichen Start des Pods ist die grafische Benutzeroberfläche von Livy unter folgendem Link verfügbar: http://{livy-url}/ui. Mit Livy können wir unsere Spark-Aufgabe veröffentlichen, indem wir eine REST-Anfrage verwenden, beispielsweise aus Postman. Ein Beispiel für eine Sammlung von Anfragen ist unten dargestellt (im Array „args“ können Konfigurationsargumente mit Variablen übergeben werden, die für die Ausführung der gestarteten Aufgabe erforderlich sind):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Job mit Jar einreichen",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt"file": "local://opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar", nt"className": "org.apache.spark.examples.SparkPi",nt"numExecutors":1,nt"name": "spark-test-1",nt"conf": {ntt"spark.jars.ivy": "/tmp/.ivy",ntt"spark.kubernetes.authenticate.driver.serviceAccountName": "spark",ntt"spark.kubernetes.namespace": "{project}",ntt"spark.kubernetes.container.image": "{docker-registry-url}/{repo}/{image-name}:{tag}"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Job ohne Jar einreichen",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt"file": "hdfs://{host}:{port}/{path-to-file-on-hdfs}", nt"className": "{class-name}",nt"numExecutors":1,nt"name": "spark-test-2",nt"proxyUser": "0",nt"conf": {ntt"spark.jars.ivy": "/tmp/.ivy",ntt"spark.kubernetes.authenticate.driver.serviceAccountName": "spark",ntt"spark.kubernetes.namespace": "{project}",ntt"spark.kubernetes.container.image": "{docker-registry-url}/{repo}/{image-name}:{tag}"nt},nt"args": [ntt"HADOOP_CONF_DIR=/opt/spark/hadoop-conf",ntt"MASTER=k8s://https://kubernetes.default.svc:8443"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Wir führen die erste Anfrage aus der Sammlung durch, gehen zur OKD-Oberfläche und überprüfen, ob der Job erfolgreich gestartet wurde — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. Gleichzeitig wird in der Livy-Oberfläche (http://{livy-url}/ui) eine Sitzung angezeigt, anhand derer Sie den Fortschritt des Jobs über die Livy-API oder die grafische Benutzeroberfläche verfolgen und die Sitzungsprotokolle einsehen können.
Jetzt zeigen wir den Mechanismus der Arbeit von Livy. Dazu betrachten wir die Protokolle des Livy-Containers innerhalb des Pods mit dem Livy-Server — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. Daraus geht hervor, dass beim Aufruf der REST-API von Livy im Container mit dem Namen „livy“ ein spark-submit ausgeführt wird, das dem oben verwendeten ähnlich ist (hier ist {livy-pod-name} der Name des erstellten Pods mit dem Livy-Server). In der Sammlung wird auch eine zweite Anfrage angezeigt, mit der Aufgaben mit einer remote gehosteten Spark-Ausführungsdatei mithilfe des Livy-Servers gestartet werden können.
Die dritte Nutzungsmöglichkeit — Spark Operator
Jetzt, da die Aufgabe getestet ist, stellt sich die Frage nach ihrer regelmäßigen Ausführung. Eine native Möglichkeit zur regelmäßigen Ausführung von Aufgaben im Kubernetes-Cluster ist die CronJob-Entität, die verwendet werden kann. Derzeit erfreuen sich jedoch Operatoren zur Verwaltung von Anwendungen in Kubernetes großer Beliebtheit, und für Spark gibt es einen ausreichend ausgereiften Operator, der auch in Lösungen auf Enterprise-Ebene eingesetzt wird (z. B. Lightbend FastData Platform). Wir empfehlen, ihn zu verwenden — die aktuelle stabile Version von Spark (2.4.5) hat im Hinblick auf die Konfiguration der Ausführung von Spark-Aufgaben in Kubernetes recht eingeschränkte Möglichkeiten. In der nächsten Hauptversion (3.0.0) ist jedoch eine umfassende Unterstützung für Kubernetes angekündigt, deren Veröffentlichungstermin derzeit unbekannt ist. Der Spark Operator kompensiert diesen Nachteil, indem er wichtige Konfigurationsparameter hinzufügt (z. B. das Einbinden von ConfigMap mit Konfigurationen für den Zugriff auf Hadoop in Spark-Pods) und die Möglichkeit zur regelmäßigen Ausführung von Aufgaben nach einem Zeitplan bietet.
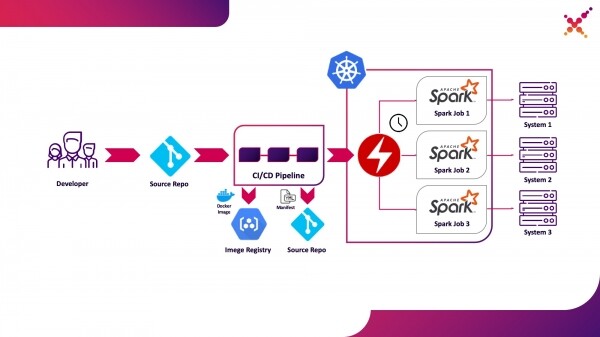
Hervorzuheben ist dies als dritte Nutzungsmöglichkeit — regelmäßige Ausführung von Spark-Aufgaben im Kubernetes-Cluster in einer Produktionsumgebung.
Der Spark Operator hat einen offenen Quellcode und wird im Rahmen der Google Cloud Platform entwickelt — . Seine Installation kann auf drei Arten erfolgen:
- Im Rahmen der Installation von Lightbend FastData Platform/Cloudflow;
- Mit Helm:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - Die Verwendung von Manifesten aus dem offiziellen Repository (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). Dabei ist Folgendes zu beachten – Cloudflow enthält einen Operator mit der API-Version v1beta1. Wenn dieser Installationstyp verwendet wird, sollten die Beschreibungen der Spark-Anwendungsmanifeste auf den Beispielen aus den Git-Tags mit der entsprechenden API-Version basieren, beispielsweise „v1beta1-0.9.0-2.4.0“. Die Version des Operators kann in der Beschreibung des CRD, das Teil des Operators im Wörterbuch „versions“ ist, eingesehen werden:
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Wenn der Operator korrekt installiert ist, wird im entsprechenden Projekt ein aktives Pod mit dem Spark-Operator erscheinen (zum Beispiel cloudflow-fdp-sparkoperator im Cloudflow-Namespace für die Cloudflow-Installation) und es wird einen entsprechenden Kubernetes-Ressourcentyp mit dem Namen „sparkapplications“ geben. Die vorhandenen Spark-Anwendungen können mit folgendem Befehl untersucht werden:
oc get sparkapplications -n {project}
Um Aufgaben mit dem Spark-Operator auszuführen, sind 3 Schritte erforderlich:
- ein Docker-Image zu erstellen, das alle erforderlichen Bibliotheken sowie Konfigurations- und Ausführungsdateien enthält. In der Zielarchitektur ist dies ein Bild, das in der CI/CD-Phase erstellt und im Testcluster getestet wurde;
- das Docker-Image in ein aus dem Kubernetes-Cluster zugängliches Registry zu veröffentlichen;
- ein Manifest mit dem Typ „SparkApplication“ und der Beschreibung der auszuführenden Aufgabe zu erstellen. Beispiele für Manifeste sind im offiziellen Repository verfügbar (zum Beispiel, ). Es sind wichtige Punkte bezüglich des Manifests zu beachten:
- Im Wörterbuch „apiVersion“ muss die API-Version angegeben werden, die der Version des Operators entspricht;
- Im Wörterbuch „metadata.namespace“ muss der Namespace angegeben sein, in dem die Anwendung gestartet wird;
- Im Wörterbuch „spec.image“ muss die Adresse des erstellten Docker-Images im verfügbaren Registry angegeben sein;
- Im Wörterbuch „spec.mainClass“ muss die Spark-Klasse angegeben werden, die beim Start des Prozesses ausgeführt werden soll;
- Im Wörterbuch „spec.mainApplicationFile“ muss der Pfad zur ausführbaren Jar-Datei angegeben werden;
- Im Wörterbuch „spec.sparkVersion“ muss die verwendete Spark-Version angegeben sein;
- Im Wörterbuch „spec.driver.serviceAccount“ muss das Dienstkonto im entsprechenden Kubernetes-Namespace angegeben werden, das für den Start der Anwendung verwendet werden soll;
- Im Wörterbuch „spec.executor“ muss die Anzahl der für die Anwendung zugewiesenen Ressourcen angegeben sein;
- Im Wörterbuch „spec.volumeMounts“ muss das lokale Verzeichnis angegeben werden, in dem die lokalen Dateien der Spark-Tasks erstellt werden.
Beispiel für die Erstellung eines Manifests (hier ist {spark-service-account} das Dienstkonto innerhalb des Kubernetes-Clusters zum Ausführen von Spark-Tasks):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
In diesem Manifest ist das Dienstkonto angegeben, für das vor der Veröffentlichung des Manifests die erforderlichen Rollenzuweisungen erstellt werden müssen, die die erforderlichen Berechtigungen für die Interaktion der Spark-Anwendung mit der API von Kubernetes bereitstellen (falls erforderlich). In unserem Fall benötigt die Anwendung Berechtigungen zum Erstellen von Pods. Erstellen wir die erforderliche Rollenzuweisung:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
Es ist auch erwähnenswert, dass in der Spezifikation dieses Manifests der Parameter „hadoopConfigMap“ angegeben werden kann, der es ermöglicht, eine ConfigMap mit der Hadoop-Konfiguration anzugeben, ohne die entsprechende Datei zuvor in das Docker-Image zu legen. Dies ist auch für den regelmäßigen Betrieb von Aufgaben geeignet – mit dem Parameter „schedule“ kann ein Zeitplan für die Ausführung dieser Aufgabe angegeben werden.
Nachdem wir unser Manifest in der Datei spark-pi.yaml gespeichert haben, wenden wir es auf unser Kubernetes-Cluster an:
oc apply -f spark-pi.yaml
Dabei wird ein Objekt vom Typ „sparkapplications“ erstellt:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
Dadurch wird ein Pod mit der Anwendung erstellt, dessen Status im erzeugten „sparkapplications“ angezeigt wird. Dies kann mit dem folgenden Befehl eingesehen werden:
oc get sparkapplications spark-pi -o yaml -n {project}
Nach Abschluss der Aufgabe wechselt der POD in den Status „Completed“, der auch in „sparkapplications“ aktualisiert wird. Die Protokolle der Anwendung können im Browser oder mit dem folgenden Befehl angezeigt werden (hier ist {sparkapplications-pod-name} der Name des Pods der ausgeführten Aufgabe):
oc logs {sparkapplications-pod-name} -n {project}
Die Verwaltung von Spark-Aufgaben kann auch mit dem spezialisierten Tool sparkctl erfolgen. Um es zu installieren, klonen wir das Repository mit dem Quellcode, installieren Go und bauen das Tool:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Lassen Sie uns die Liste der laufenden Spark-Aufgaben betrachten:
sparkctl list -n {project}
Erstellen wir eine Beschreibung für die Spark-Aufgabe:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Starten wir die beschriebene Aufgabe mit sparkctl:
sparkctl create spark-app.yaml -n {project}
Lassen Sie uns die Liste der laufenden Spark-Aufgaben betrachten:
sparkctl list -n {project}
Lassen Sie uns die Liste der Ereignisse der laufenden Spark-Aufgabe ansehen:
sparkctl event spark-pi -n {project} -f
Lassen Sie uns den Status der laufenden Spark-Aufgabe prüfen:
sparkctl status spark-pi -n {project}
Abschließend möchte ich die festgestellten Nachteile der Nutzung der aktuellen stabilen Version von Spark (2.4.5) in Kubernetes betrachten:
- Der erste und wohl größte Nachteil ist das Fehlen der Datenlokalität. Trotz aller Nachteile von YARN gab es auch Vorteile bei seiner Nutzung, zum Beispiel das Prinzip der Code-Zustellung zu den Daten (nicht die Daten zum Code). Dank dieser Funktion wurden Spark-Aufgaben auf den Knoten ausgeführt, auf denen sich die Daten befanden, die an den Berechnungen beteiligt waren, was die Zeit für die Datenübertragung über das Netzwerk erheblich verringerte. Bei der Verwendung von Kubernetes stehen wir jedoch vor der Herausforderung, dass Daten, die für die Ausführung einer Aufgabe erforderlich sind, über das Netzwerk verschoben werden müssen. Falls diese Daten groß genug sind, kann die Dauer der Aufgabenausführung erheblich verlängert werden, und es kann auch ein großer Speicherplatz erforderlich sein, der den Instanzen der Spark-Aufgabe für die temporäre Speicherung zugewiesen wird. Dieser Nachteil kann durch den Einsatz spezialisierter Software verringert werden, die die Datenlokalität in Kubernetes sicherstellt (zum Beispiel Alluxio), was jedoch faktisch bedeutet, dass eine vollständige Kopie der Daten auf den Knoten des Kubernetes-Clusters gespeichert werden muss.
- Der zweite wesentliche Nachteil ist die Sicherheit. Standardmäßig sind die Funktionen zum Schutz der Sicherheit beim Start von Spark-Aufgaben deaktiviert, und die Verwendung von Kerberos wird in der offiziellen Dokumentation nicht behandelt (obwohl entsprechende Optionen in Version 3.0.0 hinzugefügt wurden, was zusätzlichen Aufwand erfordert), und in der Dokumentation zur Sicherheit von Spark (https://spark.apache.org/docs/2.4.5/security.html) werden nur YARN, Mesos und Standalone-Cluster als Schlüsselspeicher angegeben. Zudem kann der Benutzer, unter dem die Spark-Aufgaben ausgeführt werden, nicht direkt angegeben werden – wir legen lediglich ein Dienstkonto fest, unter dem der Pod arbeiten wird, und der Benutzer wird basierend auf den konfigurierten Sicherheitsrichtlinien ausgewählt. Infolgedessen wird entweder der Benutzer root verwendet, was in einer Produktionsumgebung nicht sicher ist, oder ein Benutzer mit einer zufälligen UID, was die Verwaltung der Zugriffsrechte auf die Daten kompliziert (dies kann durch das Erstellen von PodSecurityPolicies und deren Zuordnung zu den entsprechenden Dienstkonten gelöst werden). Derzeit wird dies entweder durch das Platzieren aller erforderlichen Dateien direkt im Docker-Image oder durch die Modifikation des Spark-Startskripts gelöst, um den in Ihrer Organisation akzeptierten Mechanismus zur Speicherung und Abholung von Geheimnissen zu nutzen.
- Der Start von Spark-Jobs mit Kubernetes befindet sich offiziell weiterhin im experimentellen Modus, und in Zukunft sind erhebliche Änderungen an den verwendeten Artefakten (Konfigurationsdateien, Basis-Docker-Images und Startskripten) möglich. Tatsächlich wurde bei der Vorbereitung des Materials die Version 2.3.0 und 2.4.5 getestet, und ihr Verhalten unterschied sich erheblich.
Wir warten auf Updates — kürzlich wurde eine neue Spark-Version (3.0.0) veröffentlicht, die spürbare Änderungen an der Funktionsweise von Spark auf Kubernetes mit sich brachte, jedoch den experimentellen Status der Unterstützung dieses Ressourcenmanagers beibehielt. Möglicherweise ermöglichen die nächsten Updates tatsächlich eine vollständige Empfehlung, auf YARN zu verzichten und Spark-Jobs auf Kubernetes auszuführen, ohne sich um die Sicherheit Ihres Systems Sorgen zu machen und ohne die Notwendigkeit, funktionale Komponenten selbstständig zu erweitern.
Fin.
Quelle: habr.com
