

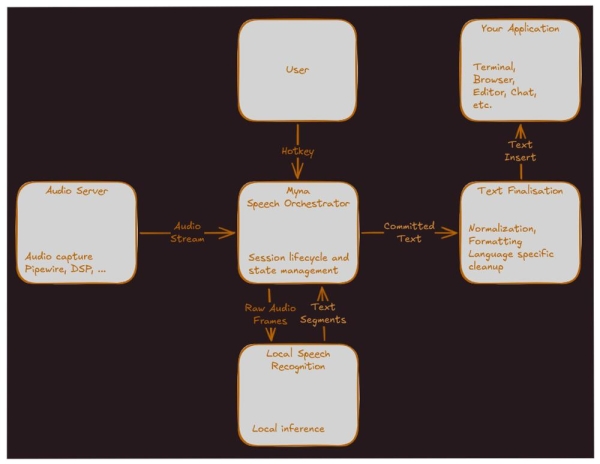
Canonical stellte das Projekt vor Myna — ein neues System zur Sprach-zu-Text-Umwandlung für Ubuntu Desktop. Das Projekt zielt auf die integrierte Diktierfunktion ab: Der Benutzer drückt eine Tastenkombination, spricht und der erkannte Text erscheint in der aktiven Anwendung. Im Ankündigung wird betont, dass Myna sich wie ein natürlicher Teil des Ubuntu-Desktops anfühlen soll und dabei die Privatsphäre des Nutzers berücksichtigt. Die Liste der unterstützten Eingabesprachen wurde zum Zeitpunkt der Veröffentlichung der Nachricht nicht bekannt gegeben.
Das erste Ziel des Projekts ist Ubuntu 26.10. In dieser Phase versucht Canonical nicht, einen vollwertigen sprachgesteuerten Assistenten oder ein Sprachsteuerungssystem für den Desktop zu entwickeln. Die Entwickler haben absichtlich den Rahmen der ersten Version auf ein einfaches, zuverlässiges Diktat beschränkt: Tastenkombination drücken, Text aussprechen und das Ergebnis im aktuellen Eingabefeld erhalten. Die primäre getestete Umgebung ist Ubuntu Desktop unter Wayland mit GNOME, aber die Architektur soll offen genug für zukünftige Unterstützung anderer Umgebungen bleiben.
Myna ist auf die lokale Spracherkennung ausgelegt. Nach der Installation der erforderlichen Modelle ist keine Internetverbindung für das Diktieren erforderlich, das Mikrofon sollte nur nach ausdrücklicher Aktivierung durch den Benutzer verwendet werden, Audio wird im Speicher verarbeitet und anschließend verworfen, und Aufzeichnungen werden nicht an externe Dienste gesendet. In den Projektspezifikationen wird auch angegeben, dass die Lösung standardmäßig die Speicherung von Audio vermeiden sollte und nicht heimlich auf einen Cloud-Dienst umschalten darf.
Der Code und die Dokumentation von Myna sind im Repository von Canonical veröffentlicht GitHub. Das Projekt wird als leichtes Speech-to-Text-Anwendung für Ubuntu Desktop beschrieben und unter der GPL-3.0-Lizenz vertrieben. Das Projekt befindet sich jedoch noch in einem frühen Stadium: Im Repository gibt es bisher keine veröffentlichten Versionen, und die architektonische Spezifikation hat den Status Vorschlag.
Hauptfunktionen und Merkmale von Myna
Push-to-Talk-Diktat. Der Benutzer hält die anpassbare Tastenkombination gedrückt, spricht, und das System fügt den erkannten Text in das gewählte Eingabefeld ein. Das Diktat endet mit dem Loslassen der Taste.
Lokale Spracherkennung. Die Erkennung erfolgt auf dem Gerät des Benutzers über einen lokalen Inferenz-Stack. Dies reduziert die Abhängigkeit von der Cloud und ermöglicht die Nutzung ohne Netzwerk nach der Installation der Modelle.
Private Audioverarbeitung. Das Mikrofon wird nur während der Benutzersitzung aktiviert. Audio sollte standardmäßig nicht auf die Festplatte aufgezeichnet werden, ein begrenzter Speicherpuffer wird verwendet, der nach Abschluss der Sitzung gelöscht wird.
Visueller Aktivitätsindikator. Während der Aufnahme und Transkription sollte der Benutzer einen verständlichen Statusindikator sehen. In der Spezifikation werden Status wie Aufzeichnung, Transkription, Finalisierung und Fehler erwähnt.
Einfügen von stabilen Texten. Bei der ersten Implementierung sollten Zwischenhypothesen der Erkennung nicht direkt in die Anwendung eingefügt werden. Nur der bestätigte endgültige Text wird ins Zielfeld gesendet.
Nachbearbeitung des Textes. Die rohe Transkription kann normalisiert, mit Interpunktion versehen, kapitalisiert, formatiert und mündliche Formen in schriftliche umgewandelt werden, zum Beispiel "twenty two" → "22".
Auswahl der Sprache für die Diktierung. Das System sollte eine anpassbare Diktatsprache unterstützen, wobei standardmäßig die Sprache der Benutzeroberfläche verwendet wird, sofern ein passendes Modell verfügbar ist.
Modelqualitätsprofile. Die Spezifikation sieht verschiedene Modellprofile vor: eine leichtgewichtige Variante mit geringeren Ressourcenanforderungen, ein ausgewogenes Standardprofil und eine qualitativ hochwertigere, aber ressourcenintensivere Variante.
Sichere Verarbeitung des Eingabefokus. Das Ziel für das Einfügen von Text wird zu Beginn der Sitzung ausgewählt. Wenn sich der Fensterfokus während der Diktation ändert, sollte das System den Text nicht stillschweigend in eine andere Anwendung senden.
Sperrung in geschützten Feldern. Die Diktation sollte in Passwortfeldern, Authentifizierungsfenstern und anderen geschützten Bereichen blockiert werden, sofern die Anwendung oder das Toolkit dies zulässt.
Integration mit Wayland/GNOME. Die erste Version ist auf Wayland und GNOME ausgerichtet. Für die anfängliche Texteingabe wird IBus in Betracht gezogen, und in Zukunft ist ein nativere Weg über Input-Methode/Text-Eingabe-Protokolle geplant.
Benutzereinstellungen. In der geplanten Einstellungsoberfläche sollten die Aktivierung/deaktivierung von STT, die Auswahl der Tastenkombination, der Diktier-Sprache, des Mikrofons, des Modellprofils, der Nachbearbeitungsoptionen und des Aktivitätsindikators enthalten sein.
In der ersten Iteration bleiben außerhalb des Projekts die Schlüsselphrase-Wachsamkeit, ständiges Hintergrund-Listening, Cloud-Spracherkennung, Sprachassistent, Sprachbefehle, Desktop-Verwaltung, Sprachübersetzung, Sprechererkennung, automatische Spracherkennung und Diktierhistorie zurück. Mit anderen Worten, Canonical beginnt nicht mit einem "AI-Assistenten", sondern mit einer bodenständigeren Funktion: lokaler Spracherkennung für die Texteingabe in reguläre Ubuntu-Anwendungen.
Quelle: linux.org.ru
