

Zur Diskussion in der Mailingliste der Linux-Kernel-Entwickler wurden Patches veröffentlicht, die ein Dateisystem BeamFS implementieren, welches Reed-Solomon-Codierung verwendet, um beschädigte Daten vor Ort in Konfigurationen mit einem einzigen Speichergerät zu erkennen und wiederherzustellen. Die Hauptanwendungsbereiche von BeamFS sind Bordcomputer von Satelliten, Geräte in Strahlentherapie-Räumen und andere Systeme, die unter erhöhten Strahlungsbedingungen arbeiten, bei denen die Rückgabe von verzerrten Daten kritischer ist als die Unmöglichkeit, Informationen zu lesen.
Standardmäßig kann BeamFS bis zu 8 verlorene Bytes in jedem 255-Byte-Bereich mit einem Overhead von 7 % wiederherstellen (288 Byte Wiederherstellungscodes für jeweils 4096 Byte gespeicherte Daten). Fehlerkorrekturcodes werden nicht nur für Daten, sondern auch für Verwaltungsinformationen im Superblock, Inode, Verzeichnisindizes und Bitkarten angewendet. Die Integritätsprüfung und der Versuch, fehlende Daten wiederherzustellen, erfolgen bei jeder Leseoperation. Kann die Korrektheit der Informationen nicht gewährleistet werden, wird die Operation mit dem Fehler "-EIO" abgebrochen, was eine stille Rückgabe beschädigter Daten ausschließt.
Durchgeführte Experimente zeigten, dass bei der Bestrahlung der i.MX 8M Plus-Platine mit Linux und dem Dateisystem ext4 mit Protonen mit einer Energie von 20 bis 58 MeV, 90 % aller Ausfälle auf der Ebene des Dateisystems und der Speichergerätetreiber auftraten. Außerdem wurde eine Simulation einzelner Bitfehler beim Lesen von einem Medium durchgeführt: BeamFS und Btrfs erkannten erfolgreich die Datenbeschädigung und gaben immer einen Fehler zurück, während ext4 und ext3 stillschweigend verzerrte Daten zurückgaben.
BeamFS gewährleistet die Integrität und Wiederherstellung nur in der Phase vom Lesen vom physischen Speichergerät bis zur Übertragung an den Seiten-Cache im RAM. Die Integrität der Speicherung im RAM kann durch Speichermodule mit Fehlerkorrekturen aufrechterhalten werden.
Zu den Einschränkungen von BeamFS gehört die fehlende Unterstützung für Journaling und den Copy-on-Write (CoW)-Modus – die Metadaten werden unsortiert auf das Speichermedium geschrieben, weshalb im Falle eines inkorrekten Systemabbruchs eine vollständige Überprüfung mit fsck erforderlich ist.
Neben BeamFS wurden kürzlich noch zwei weitere Dateisysteme für den Linux-Kernel vorgeschlagen:
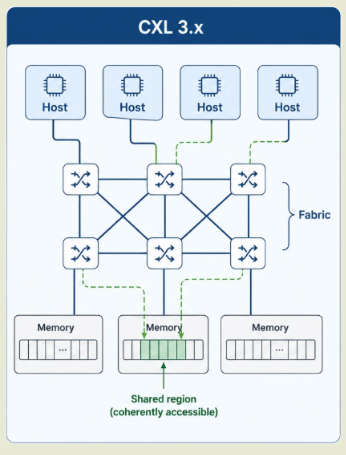
- Auf der vor einigen Tagen stattgefundenen Konferenz Linux Plumbers Conference 2026 stellte ein Ingenieur von Huawei das Dateisystem XMFS (cross-node eXpress Memory File System) für den Linux-Kernel vor, das für den Einsatz in Clustern mit gemeinsam genutztem Arbeitsspeicher aller Knoten (ähnlich tmpfs, aber für den Speicher aller Knoten) vorgesehen ist. XMFS ermöglicht die Verwendung der standardmäßigen POSIX-Schnittstelle von Dateisystemen, um auf externen Speicher zuzugreifen, der direkt über Technologien wie CXL 3.0 (Compute Express Link) und den Huawei United Bus adressiert wird. Das Projekt befindet sich in der experimentellen Prototyp-Phase und wird intern getestet, ist jedoch noch nicht bereit für die Integration in den Kernel.

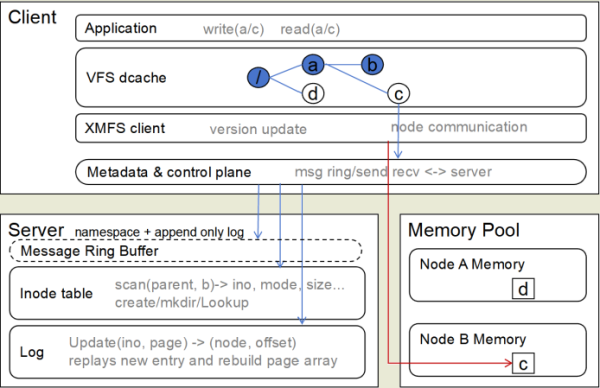
Das Dateisystem hat die klassische Architektur verteilter Dateisysteme mit der Zuordnung von Server, die für das Journaling, die Verwaltung der Inode-Tabellen und die Zuordnung von Inhalten und Metadaten zum Speicher der einzelnen Knoten zuständig ist.

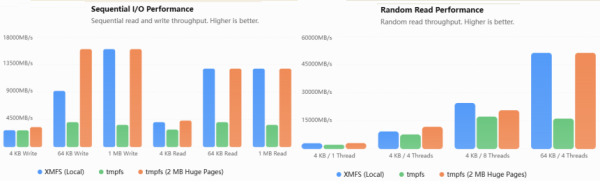
Bei den Tests zur Verwendung von XMFS für Aufgaben wie den gemeinsamen Zugriff auf Container-Images von verschiedenen Knoten zeigte die Implementierung eine Leistung, die nah an der von tmpfs lag, insbesondere bei der Verwendung großer Seiten im Speicher (2 MB Huge Pages).


- Mit Hilfe von KI wurde das Dateisystem MeshXFS entwickelt, das ein Fork von XFS darstellt, der für die gleichzeitige Nutzung auf mehreren Knoten in einem Cluster angepasst ist. MeshXFS ermöglicht es, ein gemeinsames Blockgerät im Lese-Schreib-Modus auf verschiedenen Knoten zu mounten, die Integrität zu gewährleisten und beim gleichzeitigen Datenzugriff Locking zu verwalten. Das Projekt begann als Experiment zur Erforschung der Möglichkeiten der Erstellung eines Linux-Treibers mit einem Dateisystem, das verteilte Sperren, parallelen Zugriff und Wiederherstellung nach Ausfällen unterstützt, mithilfe von KI-Modellen. Die Hauptarbeit wurde mit Claude Opus durchgeführt, aber für besonders komplexe Probleme wurden gezielt Modelle wie Claude Fable, GPT, Gemini und Astra hinzugezogen. Das Experiment wurde als erfolgreich angesehen, und es wurden bereits mehrere funktionierende Versionen von MeshXFS veröffentlicht.
Zu den zusätzlichen Möglichkeiten, die über XFS bereitgestellt werden, gehören zwei Modi zur Verwaltung verteilter Sperren (Netzwerksynchronisierung und Speicherung des Status auf einer separaten gemeinsamen Festplatte), die Sicherstellung der Konsistenz des Caches an verschiedenen Knoten, Protokollierung zur Wiederherstellung sowie Anpassungen des Festplattenformats und der Dienstprogramme für die spezifischen Anforderungen des Clusterdateisystems. Die Verwendung eines gemeinsamen Speichers, der über iSCSI angeschlossen ist (auf 16 Knoten getestet), wird unterstützt oder bei der Replikation von Blockgeräten durch DRBD. Die Koordination von Sperren, Funktionen zur Erkennung von Knoten, Verfügbarkeitsprüfungen und die Identifizierung von fehlerhaften Knoten sind in einem gemeinsamen Kernelmodul implementiert. Die Funktionalität wurde in Proxmox VE 9, RHEL 9, Ubuntu 24.04/26.04 und Debian 12/13 getestet.
Quelle: opennet.ru
