

Im Rahmen des Forschungsprojekts wurde mit der Implementierung einer Funktion begonnen, die es ermöglicht, den Kompilierungsprozess in mehrere parallel ausgeführte Threads zu unterteilen. Derzeit wird zur Verbesserung der Geschwindigkeit des Build-Prozesses auf Mehrkernsystemen das Starten separater Compiler-Prozesse auf der Ebene des Make-Tools verwendet, wobei jeder Prozess eine separate Datei mit Code kompiliert. Das neue Projekt experimentiert mit der Bereitstellung von Parallelisierung auf der Ebene des Compilers, was potenziell die Effizienz auf Mehrkernsystemen erhöhen könnte.
Für Tests ein separater Parallelisierungs-Branch von GCC, in dem ein neuer Parameter "—param=num-threads=N" vorgeschlagen wird, um die Anzahl der Threads festzulegen. In der Anfangsphase wurden Inter-Procedural-Optimierungen in separate Ausführungsthreads ausgelagert, die zyklisch für jede Funktion aufgerufen werden und gut parallelisierbar sind. Außerdem wurden GIMPLE-Operationen in separate Threads ausgelagert, die für hardwareunabhängige Optimierungen verantwortlich sind und die Interaktion zwischen Funktionen bewerten.
In der nächsten Phase ist geplant, auch inter-procedurale RTL-Optimierungen, die die spezifischen Eigenschaften der Hardwareplattform berücksichtigen, in separate Threads auszulagern. Danach soll die Parallelisierung von Intra-Procedural-Optimierungen (IPA), die auf Code innerhalb der Funktion angewendet wird, unabhängig von den Besonderheiten des Aufrufs, realisiert werden. Ein begrenzender Faktor ist derzeit der Garbage Collector, dem eine globale Sperre hinzugefügt wurde, die Garbage Collection-Operationen während des Multithread-Betriebs deaktiviert (in Zukunft wird der Garbage Collector für die Multithread-Ausführung von GCC angepasst werden).
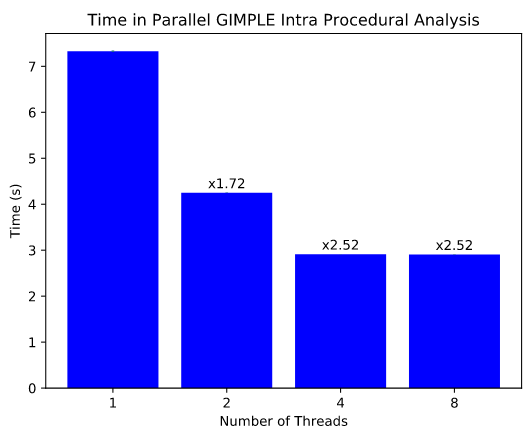
Zur Bewertung der Leistungsänderung wurde ein Testset vorbereitet, das die Kompilierung der Datei gimple-match.c durchführt, die mehr als 100.000 Zeilen Code und 1.700 Funktionen umfasst. Tests auf einem System mit einem Intel Core i5-8250U CPU mit 4 physischen Kernen und 8 virtuellen Kernen (Hyperthreading) zeigten eine Reduzierung der Ausführungszeit der Intra-Procedure-GIMPLE-Optimierungen von 7 auf 4 Sekunden bei Verwendung von 2 Threads und auf 3 Sekunden bei 4 Threads. Das bedeutet eine Geschwindigkeitssteigerung der betreffenden Build-Phase um 1,72 und 2,52 Mal, entsprechend. Die Tests zeigten auch, dass die Verwendung virtueller Kerne bei Hyperthreading nicht zu einem Anstieg der Leistung führt.
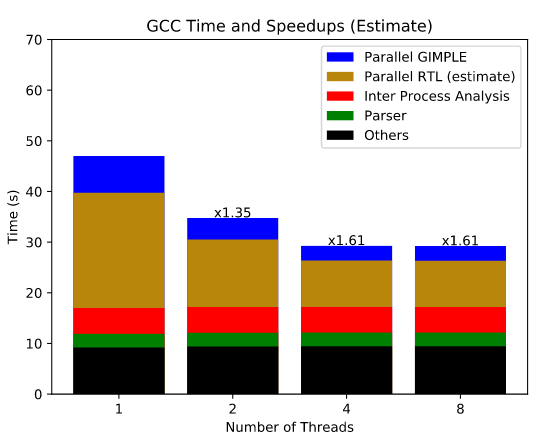
Die gesamte Montagezeit hat sich um etwa 10 % verringert, aber laut Prognosen wird die Parallelisierung von RTL-Optimierungen zu spürbareren Ergebnissen führen, da diese Phase bei der Kompilierung erheblich mehr Zeit in Anspruch nimmt. Schätzungsweise wird sich nach der Parallelisierung von RTL die gesamte Montagezeit um das 1,61-Fache reduzieren. Darüber hinaus kann die Montagezeit durch die Parallelisierung von IPA-Optimierungen um weitere 5-10 % verkürzt werden.
Quelle: opennet.ru
