

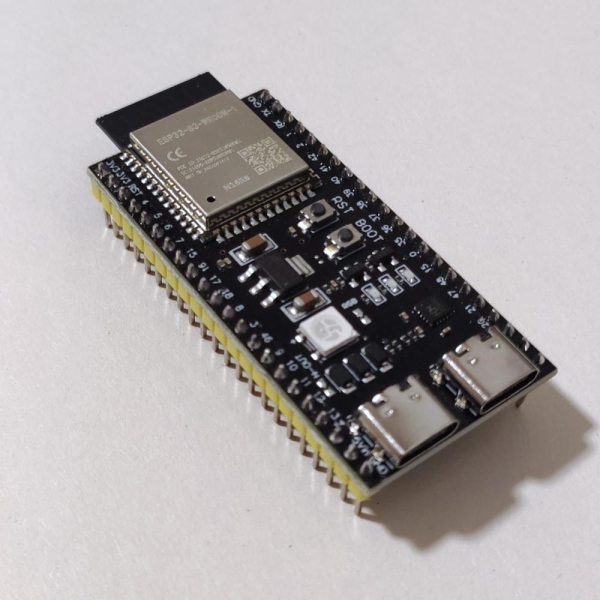
Der Entwickler Wjatscheslaw Serbow, der unter dem Pseudonym slvDev auftritt, demonstrierte eine vollständig lokale Texterzeugung auf dem Mikrocontroller ESP32-S3. Das von ihm entwickelte Sprachmodell enthält 28,9 Millionen Parameter und gibt etwa 9,9 Tokens pro Sekunde aus, ohne auf einen Server oder andere externe Rechenressourcen zuzugreifen. Die generierten Kurzgeschichten werden auf einem angeschlossenen OLED-Display ausgegeben.
Projekt esp32-ai wurde auf dem Modul ESP32-S3 N16R8 mit 512 KB integrierter SRAM, 8 MB PSRAM und 16 MB Flash-Speicher getestet. Das auf vier Bits quantisierte Modell benötigt 14,9 MB. Im Repository wurden der Quellcode der Laufzeitumgebung in C, die Trainings- und Quantisierungswerkzeuge für das Modell, die Firmware, Tests und Szenarien für das Laden auf die Platine veröffentlicht.
Die angegebenen 28,9 Millionen Parameter sollten nicht direkt mit der Anzahl der Parameter herkömmlicher Desktop-LLMs verglichen werden. Laut dem detaillierten Bericht des Entwicklers, besteht das Modell aus einem dichten Rechenkern mit etwa 559.000 Parametern, einer Ausgabeschicht mit 3,1 Millionen Parametern und einer Tabelle mit schichtbezogenen Vektorrepräsentationen von etwa 25 Millionen Parametern. Letztere stellt den Großteil der formalen Größe des Modells dar, wird jedoch nicht vollständig bei der Erzeugung jedes Tokens verarbeitet.
Für die Unterbringung des Modells werden drei Speicherebenen genutzt. Die am häufigsten verwendeten Daten befinden sich in der internen SRAM, die Ausgabeschicht, der KV-Cache und temporäre Pufferspeicher in der PSRAM, während die 25-Millionen-Tabelle im Flash-Speicher bleibt und über eine Abbildung in den Adressraum zugänglich ist. Für jedes Token werden nur etwa sechs Zeilen mit einem Gesamtvolumen von ungefähr 450 Byte gelesen.
Eine solche Vorrichtung basiert auf der Technologie der Per-Layer Embeddings, die von Google in Gemma 3n angewendet wurde. Laut der Google-Dokumentation, können PLE-Parameter außerhalb des Arbeitsspeichers des Modells gespeichert und während des Ausgabeverfahrens hinzugefügt werden, während einzelne Schichten verarbeitet werden. In esp32-ai wurde dieser Ansatz in die Speicherhierarchie des Mikrocontrollers übertragen, wo die schnelle SRAM besonders begrenzt ist.
Die erste korrekte Version der unter C geschriebenen Laufzeitumgebung gab nur 0,57 Token pro Sekunde aus. Nach der Platzierung der Ausgabeschicht im PSRAM, dem Wechsel zu achtbitigen Aktivierungen, der Verteilung der Berechnungen zwischen zwei Xtensa LX7-Kernen und weiteren Optimierungen wurde die Verzögerung auf 94,9 ms pro Modellschritt reduziert. Die endgültig gemessene Geschwindigkeit erreichte 9,88 Token pro Sekunde unter Berücksichtigung des gesamten Generierungsprozesses. Das Hauptlimit ist jetzt die Bandbreite des PSRAM beim Lesen der Ausgabeschicht.
Das Modell wurde auf einem synthetischen Datensatz trainiert TinyStories, der aus einfachen englischsprachigen Geschichten mit begrenztem Wortschatz besteht. Deshalb ist es in der Lage, Sätze fortzusetzen und kleine zusammenhängende Geschichten zu erfinden, ist jedoch nicht für die Beantwortung von Fragen, die Ausführung von Anweisungen, Programmierung oder das Wiedergeben von tatsächlichem Wissen gedacht. Der Entwickler betrachtet die Arbeit in erster Linie als Demonstration der effektiven Unterbringung des Modells im Speicher eines Mikrocontrollers und nicht als fertigen autonomen Chatbot.
In der aktuellen Dokumentation hebt der Autor hervor, dass esp32-ai eine eigenständige Entwicklung ist. Projekte llama2.c von Andrei Karpathy und der frühere Start eines 260.000-Modelle auf dem ESP32-S3 werden nur als Orientierung und Beispiele für frühere Arbeiten angeführt: Der Code, die Kontrollpunkte und die Methodik stammen nicht direkt von ihnen. Der Quellcode von esp32-ai wird unter der MIT-Lizenz verbreitet.
Quelle: linux.org.ru
