

Dieser Artikel ist dem Python Gateway gewidmet — einem Open-Source-Community-Projekt für die Datenplattform InterSystems IRIS. Dieses Projekt ermöglicht es, beliebige Machine-Learning-Algorithmen, die in Python (der Hauptumgebung für viele Data Scientists) erstellt wurden, zu orchestrieren und zahlreiche verfügbare Bibliotheken zu verwenden, um schnell adaptive, automatisierte analytische AI/ML-Lösungen auf der InterSystems IRIS-Plattform zu erstellen. In diesem Artikel zeige ich, wie InterSystems IRIS Prozesse in Python orchestrieren, Daten effizient bidirektional übertragen und intelligente Geschäftsprozesse erstellen kann.
Plan
- Einführung.
- Werkzeuge.
- Installation.
- API.
- Interoperabilität.
- Jupyter Notebook.
- Fazit.
- Links.
- MLToolkit.
Einführung
Python ist eine hochgradig flexible Programmiersprache, die auf die Steigerung der Entwicklerproduktivität und die Lesbarkeit des Codes abzielt. In dieser Artikelreihe werde ich die Möglichkeiten der Anwendung von Python auf der InterSystems IRIS-Plattform erläutern, wobei der Schwerpunkt dieses Artikels auf der Verwendung von Python als Sprache zur Erstellung und Anwendung von Machine-Learning-Modellen liegt.
Machine Learning (ML) ist eine Klasse von Methoden der künstlichen Intelligenz, bei denen nicht direkt eine Aufgabe gelöst wird, sondern das Lernen während der Lösung vieler ähnlicher Aufgaben im Vordergrund steht.
Maschinenlernalgorithmen und -modelle werden immer verbreiteter. Es gibt viele Gründe dafür, aber sie lassen sich auf Zugänglichkeit, Einfachheit und das Erzielen praktischer Ergebnisse zurückführen. Ist Clusterbildung oder sogar neuronales Netzmodellierung eine neue Technologie?
Natürlich nicht, aber heutzutage ist es nicht mehr notwendig, Hunderte von Tausenden Zeilen Code zu schreiben, um ein einziges Modell zu starten, und die Kosten für die Erstellung und Anwendung von Modellen werden immer geringer.
Die Werkzeuge entwickeln sich weiter — während wir nicht über vollständig GUI-orientierte AI/ML-Werkzeuge verfügen, beobachten wir den gleichen Fortschritt bei vielen anderen Klassen von Informationssystemen, zum Beispiel BI (von der Codierung bis zur Nutzung von Frameworks und GUI-orientierten konfigurierbaren Lösungen), auch in den Werkzeugen zur Erstellung von AI/ML. Wir haben die Phase des Programmierens hinter uns gelassen und nutzen heute Frameworks zur Erstellung und Schulung von Modellen.
Weitere Verbesserungen, wie die Möglichkeit, vortrainierte Modelle zu verbreiten, bei denen der Endbenutzer nur das Training des Modells mit seinen spezifischen Daten abschließen muss, erleichtern den Einstieg in die Anwendung von maschinellem Lernen. Diese Fortschritte erleichtern das Lernen von maschinellem Lernen sowohl für Fachleute als auch für Unternehmen im Allgemeinen erheblich.
Andererseits sammeln wir immer mehr Daten. Dank einer einheitlichen Datenplattform wie InterSystems IRIS kann all diese Information sofort aufbereitet und als Ausgangsdaten für Modelle des maschinellen Lernens verwendet werden.
Mit dem Übergang in die Cloud wird der Start von AI/ML-Projekten einfacher als je zuvor. Wir können nur die Ressourcen nutzen, die wir benötigen. Darüber hinaus können wir dank der Parallelisierung, die von Cloud-Plattformen angeboten wird, Zeit sparen.
Aber wie sieht es mit den Ergebnissen aus? Hier wird es komplizierter. Es gibt viele Werkzeuge zum Aufbau von Modellen, über die ich im Folgenden sprechen werde. Ein gutes Modell zu erstellen ist nicht einfach, aber was kommt dann? Die Erzielung von Nutzen aus der Nutzung des Modells durch das Unternehmen ist ebenfalls eine keine triviale Aufgabe. Der Kern des Problems liegt in der Trennung von analytischen und transaktionalen Lasten sowie den Datenmodellen. Wenn wir ein Modell trainieren, tun wir dies normalerweise mit historischen Daten. Aber der Platz für das gebaute Modell liegt in der transaktionalen Datenverarbeitung. Was nützt das beste Modell zur Erkennung betrügerischer Transaktionen, wenn wir es nur einmal am Tag ausführen? Die Betrüger sind längst mit dem Geld verschwunden. Wir müssen das Modell mit historischen Daten trainieren, aber wir müssen es auch in Echtzeit auf neue eingehende Daten anwenden, damit unsere Geschäftsprozesse gemäß den Vorhersagen des Modells agieren können.
Das ML Toolkit ist ein Satz von Werkzeugen, dessen Ziel es ist, genau dies zu erreichen: Modelle und die transaktionale Umgebung zu verbinden, damit die erstellten Modelle direkt in Ihren Geschäftsprozessen eingesetzt werden können. Der Python Gateway ist Teil des ML Kit und bietet eine Integration mit der Programmiersprache Python (ähnlich wie der R Gateway, der als Teil des ML Kit die Integration mit der Programmiersprache R ermöglicht).
Werkzeug
Bevor wir fortfahren, möchte ich einige Werkzeuge und Bibliotheken für Python beschreiben, die wir später verwenden werden.
Technologien
- Python ist eine interpretierte, hochgradig einsetzbare Programmiersprache. Der Hauptvorteil dieser Sprache ist die umfangreiche Bibliothek an mathematischen, ML- und AI-Bibliotheken. Ähnlich wie bei ObjectScript handelt es sich um eine objektorientierte Sprache, aber alles wird dynamisch und nicht statisch definiert. Außerdem ist alles ein Objekt. Spätere Artikel setzen ein flüchtiges Verständnis der Sprache voraus. Wenn Sie mit dem Lernen beginnen möchten, empfehle ich Ihnen, mit .
- Für unsere späteren Übungen installieren Sie .
- IDE: Ich verwende , aber generell gibt es auch andere. . Wenn Sie Atelier verwenden, gibt es ein Eclipse-Plugin für Python-Entwickler. Wenn Sie VS Code verwenden, gibt es eine Erweiterung für Python.
- Notebook: Anstelle einer IDE können Sie Ihre Skripte in Online-Notebooks schreiben und teilen. Das beliebteste unter ihnen ist .
Bibliotheken
Hier ist eine (unvollständige) Liste von Bibliotheken für maschinelles Lernen:
- — ein grundlegendes Paket für präzise Berechnungen.
- — hochleistungsfähige Datenstrukturen und Datenanalysetools.
- — Erstellung von Diagrammen.
- — Datenvisualisierung, die auf matplotlib basiert.
- — Methoden für maschinelles Lernen.
- — Algorithmen für maschinelles Lernen innerhalb der Gradienten-Boosting-Methodologie.
- — NLP.
- — neuronale Netzwerke.
- — Plattform zur Erstellung von Modellen für maschinelles Lernen.
- — Plattform zur Erstellung von Modellen für maschinelles Lernen, die auf Python ausgerichtet ist.
- — PMML aus verschiedenen Modellen.
AI/ML-Technologien ermöglichen es, Geschäfte effektiver und anpassungsfähiger zu gestalten. Darüber hinaus werden diese Technologien heute einfacher entwickelt und umgesetzt. Beginnen Sie mit dem Lernen über AI/ML-Technologien und wie diese Ihrer Organisation beim Wachsen helfen können.
Installation
Es gibt mehrere Möglichkeiten, Python Gateway zu installieren und zu nutzen:
- dem Betriebssystem
- Windows
- Linux
- Mac
- Docker
- Verwenden Sie ein Image von DockerHub
- Erstellen Sie Ihr eigenes Image
Unabhängig von der Installationsmethode benötigen Sie den Quellcode. Der einzige Ort zum Herunterladen des Codes ist . Sie enthält getestete stabile Releases, nehmen Sie einfach die letzte Version. Momentan ist dies 0.8, aber im Laufe der Zeit werden neue folgen. Klonen Sie nicht das Repository, laden Sie die neueste Version herunter.
dem Betriebssystem
Wenn Sie das Python Gateway auf einem Betriebssystem installieren, müssen Sie zuerst (unabhängig vom Betriebssystem) Python installieren. Dazu:
- . Es wird empfohlen, Python im Standardverzeichnis zu installieren.
- Installieren Sie das Modul
dill:pip install dill. - Laden Sie den ObjectScript-Code (d.h.
do $system.OBJ.ImportDir("C:InterSystemsReposPythoniscpy", "*.cls", "c",,1)) in jeden Namensraum mit Produkteinheiten. Falls Sie möchten, dass ein vorhandener Namensraum Produkteinheiten unterstützt, führen Sie aus:write ##class(%EnsembleMgr).EnableNamespace($Namespace, 1). - Fügen Sie hinzu in den Ordner
binIhres InterSystems IRIS-Instanz. Die Bibliotheksdatei sollte unter dem Pfad verfügbar sein, der zurückgegeben wird vonwrite ##class(isc.py.Callout).GetLib().
Windows
- Stellen Sie sicher, dass die Umgebungsvariable
PYTHONHOMEauf Python 3.6.7 zeigt. - Stellen Sie sicher, dass die Systemumgebungsvariable
PATHdie Variable enthältPYTHONHOME(oder das Verzeichnis, auf das sie zeigt).
Linux (Debian/Ubuntu)
- Überprüfen Sie, dass die Umgebungsvariable
PATHenthält/usr/libund/usr/lib/x86_64-linux-gnu. Verwenden Sie die Datei/etc/environmentzum Setzen der Umgebungsvariablen. - Im Falle von Fehlern
undefined symbol: _Py_TrueStructsetzen Sie die EinstellungPythonLib. Auch im gibt es einen Abschnitt zur Fehlersuche.
Mac
- Derzeit wird nur Python 3.6.7 von unterstützt. Überprüfen Sie die Variable
PATH.
Wenn Sie Umgebungsvariablen geändert haben, starten Sie Ihr Produkt von InterSystems neu.
Docker
Die Nutzung von Containern hat eine Reihe von Vorteilen:
- Portabilität
- Effektivität
- Isolierung
- Leichtigkeit
- Unveränderlichkeit
Schauen Sie sich diese für weitere Informationen zur Verwendung von Docker mit InterSystems-Produkten an.
Alle Builds des Python Gateways basieren derzeit auf Containern. 2019.4.
Fertiges Image
Führen Sie aus: docker run -d -p 52773:52773 --name irispy intersystemscommunity/irispy-community:latest, um das Python Gateway mit InterSystems IRIS Community Edition herunterzuladen und zu starten. Das war's.
Erstellen Sie Ihr eigenes Image
Führen Sie im Wurzelverzeichnis des Repositories aus: docker build --force-rm --tag intersystemscommunity/irispy:latest ..
Standardmäßig wird das Image auf Basis des Images store/intersystems/iris-community:2019.4.0.383.0, aber Sie können dies ändern, indem Sie die Variable IMAGE.
Für den Build aus InterSystems IRIS führen Sie aus: `docker build —build-arg IMAGE=store/intersystems/iris:2019.4.0.383.0 —force-rm —tag intersystemscommunity/irispy:latest `.
Danach können Sie das Docker-Image starten:
docker run -d
  -p 52773:52773
  -v //:/mount
  --name irispy
  intersystemscommunity/irispy:latest
  --key /mount/iris.key
Wenn Sie ein auf InterSystems IRIS Community Edition basierendes Image verwenden, müssen Sie den Schlüssel möglicherweise nicht angeben.
Kommentare
- Testprozess
isc.py.test.ProcessSpeichert eine Reihe von Bildern im temporären Verzeichnis. Möglicherweise möchten Sie diesen Pfad auf ein gemountetes Verzeichnis ändern. Dazu bearbeiten Sie die EinstellungWorkingDirindem Sie das gemountete Verzeichnis angeben. - Zugriff auf das Terminal erhalten Sie mit:
docker exec -it irispy sh. - Zugang zum Systemverwaltungsportal mit Login
SuperUser/SYS. - Um den Container zu stoppen, führen Sie aus:
docker stop irispy && docker rm --force irispy.
Überprüfung der Installation
Nachdem Sie das Python Gateway installiert haben, sollten Sie überprüfen, ob es funktioniert. Führen Sie diesen Code im Terminal von InterSystems IRIS aus:
set sc = ##class(isc.py.Callout).Setup()
set sc = ##class(isc.py.Main).SimpleString("x='HELLO'", "x", , .var).
write var
Es sollte das Folgende ausgegeben werden HELLO — der Wert der Python-Variablen x. Wenn der zurückgegebene Status sc ein Fehler oder var leer ist, überprüfen Sie .
API
Das Python Gateway ist installiert, und Sie haben sichergestellt, dass es funktioniert. Es ist Zeit, es zu nutzen!
Das Hauptinterface zu Python ist isc.py.Main. Es bietet die folgenden Gruppen von Methoden (alle geben zurück %Status):
- Codeausführung
- Datenübertragung
- Hilfsmethoden
Codeausführung
Diese Methoden ermöglichen es, beliebigen Python-Code auszuführen.
SimpleString
SimpleString — dies ist die Hauptmethode. Sie nimmt 4 optionale Argumente an:
code— der auszuführende Code. Zeilenumbruchzeichen:$c(10).returnVariable— der Name der Variable für die Rückgabe.serialization— wie zu serialisierenreturnVariable. 0 — string (Standard), 1 — repr.result— ByRef-Verweis auf die Variable, in die der Wert geschrieben wirdreturnVariable.
Vorhin haben wir ausgeführt:
set sc = ##class(isc.py.Main).SimpleString("x='HELLO'", "x", , .var).In diesem Beispiel weisen wir der Python-Variable x system-id D Hallo zu und möchten den Wert der Python-Variable x in eine ObjectScript-Variable zurückgeben var.
ExecuteCode
ExecuteCode ist eine sicherere und weniger eingeschränkte Alternative SimpleString.
Strings in der InterSystems IRIS-Plattform sind auf 3.641.144 Zeichen begrenzt, und wenn Sie eine längere Codezeile ausführen möchten, müssen Sie Streams verwenden.
Es werden zwei Argumente angenommen:
code— einen Python-Code-String oder -Stream zur Ausführung.variable— (optional) weist das Ergebnis der Ausführungcodedieser Python-Variablen zu.
Verwenden Sie:
set sc = ##class(isc.py.Main).ExecuteCode("2*3", "y").In diesem Beispiel multiplizieren wir 2 mit 3 und speichern das Ergebnis in der Python-Variable y.
Datenübertragung
Übertragen Sie Daten nach Python und zurück.
Python -> InterSystems IRIS
Es gibt 4 Möglichkeiten, den Wert einer Python-Variable in InterSystems IRIS zu erhalten, je nach der benötigten Serialisierung:
Stringfür grundlegende Datentypen und Debugging.Reprzur Speicherung einfacher Objekte und zur Fehlerbehebung.JSONfür einfaches Manipulieren von Daten auf der Seite von InterSystems IRIS.Picklezur Speicherung von Objekten.
Diese Methoden ermöglichen es, Variablen aus Python als Strings oder Streams zu erhalten.
GetVariable(variable, serialization, .stream, useString)— abrufenserializationVariablevariableinstream. WennuseStringgleich 1 und die Serialisierung in einen String gespeichert wird, wird ein String und kein Stream zurückgegeben.GetVariableJson(variable, .stream, useString)— erhalten Sie die JSON-Serialisierung der Variable.GetVariablePickle(variable, .stream, useString, useDill)- erhalten Sie die Pickle- (oder Dill-)Serialisierung der Variable.
Versuchen wir, unsere Variable abzurufen. y.
set sc = ##class(isc.py.Main).GetVariable("y", , .val, 1)
write val
>6
InterSystems IRIS -> Python
Laden von Daten aus InterSystems IRIS in Python.
ExecuteQuery(query, variable, type, namespace)— erstellt einen Datensatz (pandasdataframeoderdie Umwandlung von numerischen und textuellen Daten in die Formate) aus der SQL-Abfrage und weist ihn einer Python-Variable zu.variable. Das Paketisc.pymuss im Bereich verfügbar sein,Namespace— hier wird die Abfrage ausgeführt.ExecuteGlobal(global, variable, type, start, end, mask, labels, namespace)— lädt Daten aus dem Globalenglobalvom Subscriptstartbisendin Python als Variable vom Typtype:die Umwandlung von numerischen und textuellen Daten in die Formate, oder pandasdataframe. Eine Beschreibung der optionalen Argumentemaskandlabelsist in der Dokumentation der Klasse und im Repository verfügbar. .ExecuteClass(class, variable, type, start, end, properties, namespace)— lädt Klassendatenclassvom IDstartbisendin Python als Variable vom Typtype:die Umwandlung von numerischen und textuellen Daten in die Formate, oder pandasdataframe.properties— eine Liste (Trennzeichen: Komma) von Klassenattributen, die in den Datensatz geladen werden sollen. Masken werden unterstützt.*und?. Standardmäßig —*(alle Attribute). Attribute%%CLASSNAMEwerden ignoriert.ExecuteTable(table, variable, type, start, end, properties, namespace)— lädt TabellendatenTabellevom IDstartbisendin Python.
ExecuteQuery — ist universell (jeder korrekte SQL-Befehl wird an Python übergeben). Allerdings ExecuteGlobal und seine Umhüllungen ExecuteClass und ExecuteTable arbeiten unter einer Reihe von Einschränkungen. Sie sind viel schneller (3-5 Mal schneller als der ODBC-Treiber und 20 Mal schneller ExecuteQuery). Weitere Informationen finden Sie in .
Alle diese Methoden unterstützen die Datenübertragung aus jedem Bereich. Das Paket isc.py muss im Zielbereich verfügbar sein.
ExecuteQuery
ExecuteQuery(request, variable, type, namespace) — Übertragung der Ergebnisse jeder korrekten SQL-Abfrage nach Python. Dies ist die langsamste Methode zur Datenübertragung. Verwenden Sie sie, wenn ExecuteGlobal und seine Umhüllungen nicht verfügbar sind.
Argumente:
query— SQL-Abfrage.variable— der Name der Python-Variable, in die die Daten geschrieben werden.type—die Umwandlung von numerischen und textuellen Daten in die Formateoder Pandasdataframe.Namespace— der Bereich, in dem die Abfrage ausgeführt wird.
ExecuteGlobal
ExecuteGlobal(global, variable, type, start, end, mask, labels, namespace) — Übertragung des Globals in Python.
Argumente:
global— der Name des Globals ohne^variable— der Name der Python-Variable, in die die Daten geschrieben werden.type—die Umwandlung von numerischen und textuellen Daten in die Formateoder Pandasdataframe.start— das erste Subscript des Globals. Erforderlich.%Integer.end— das letzte Subscript des Globals. Erforderlich.%Integer.mask— Maskenwerte des Globals. Die Maske kann kürzer sein als die Anzahl der Felder im Global (in diesem Fall werden die Felder am Ende übersprungen). So formatieren Sie die Maske:+Wert so übergeben, wie er ist.-Wert überspringen.b— Boolescher Typ (0—Falsch, alles andere ist —Wahr).d— Datum (ab $horolog, unter Windows ab 1970, unter Linux ab 1900).t— Zeit ($horolog, Sekunden nach Mitternacht).m— Zeitstempel (String im FORMAT JAHR-MONAT-TAG STUNDE:MINUTE:SEKUNDE).
labels— %Liste der Spaltennamen. Erstes Element — Name des Subskripts.Namespace— der Bereich, in dem die Abfrage ausgeführt wird.
ExecuteClass
Wrapper über ExecuteGlobal. Bereitet den Aufruf basierend auf der Klassendefinition vor ExecuteGlobal und ruft ihn auf.
ExecuteClass(class, variable, type, start, end, properties, namespace) — Übertragung von Klassendaten in Python.
Argumente:
class— Klassennamevariable— der Name der Python-Variable, in die die Daten geschrieben werden.type—die Umwandlung von numerischen und textuellen Daten in die Formateoder Pandasdataframe.start— Start-ID.end— End-IDproperties— eine Liste (Trennzeichen: Komma) von Klassenattributen, die in den Datensatz geladen werden sollen. Masken werden unterstützt.*und?. Standardmäßig —*(alle Attribute). Attribute%%CLASSNAMEwerden ignoriert.Namespace— der Bereich, in dem die Abfrage ausgeführt wird.
Alle Eigenschaften werden so übergeben, wie sie sind, außer den Eigenschaften der Typen te, %Zeit, %Boolean und %Zeitstempel — sie werden in die entsprechenden Python-Klassen konvertiert.
ExecuteTable
Wrapper über ExecuteClass. Translatiert den Tabellennamen in den Klassennamen und ruft ExecuteClassauf. Signatur:
ExecuteTable(table, variable, type, start, end, properties, namespace) — Übertragung von Tabellendaten in Python.
Argumente:
Tabelle— Tabellenname.
Alle anderen Argumente werden so übergeben, wie sie sind, inExecuteClass.
Notizen
ExecuteGlobal,ExecuteClassundExecuteTablearbeiten gleich schnell.ExecuteGlobal20 Mal schneller alsExecuteQuerybei großen Datensätzen (Übertragungszeit mehr als >0.01 Sekunden).ExecuteGlobal,ExecuteClassundExecuteTablearbeiten mit Globals dieser Struktur:^global(key) = $lb(prop1, prop2, ..., propN)wokey— ganze Zahl.- Für
ExecuteGlobal,ExecuteClassundExecuteTableunterstützter Wertebereichteentspricht dem Bereichmktimeund hängt vom OS ab (: 1970-01-01, 1900-01-01, ). Verwenden Sie%Zeitstempelum Daten außerhalb dieses Bereichs zu übergeben oder verwenden Sie ein pandas dataframe, da dies nur eine Einschränkung für die Liste ist. - Für
ExecuteGlobal,ExecuteClassundExecuteTableAlle Argumente, außer der Datenquelle (Global, Klasse oder Tabelle) und der Variablen, sind optional.
Beispiele
Testklasse enthält eine Methode, die alle Optionen zur Datenübertragung demonstriert:
set global = "isc.py.test.PersonD"
set class = "isc.py.test.Person"
set table = "isc_py_test.Person"
set query = "SELECT * FROM isc_py_test.Person"

// Allgemeine Argumente
set variable = "df"
set type = "dataframe"
set start = 1
set end = $g(^isc.py.test.PersonD, start)

// Methode 0: ExecuteGlobal ohne Argumente
set sc = ##class(isc.py.Main).ExecuteGlobal(global, variable _ 0, type)

// Methode 1: ExecuteGlobal mit Argumenten
// Bei Übergabe des Globals werden die Feldnamen manuell festgelegt
// globalKey - Name des Subskripts
set labels = $lb("globalKey", "Name", "DOB", "TS", "RandomTime", "AgeYears", "AgeDecimal", "AgeDouble", "Bool")

// Mask enthält ein Element weniger als Labels, da "globalKey" der Name des Subskripts ist
// %%CLASSNAME wird übersprungen
set mask = "-+dmt+++b"

set sc = ##class(isc.py.Main).ExecuteGlobal(global, variable _ 1, type, start, end, mask, labels)

// Methode 2: ExecuteClass
set sc = ##class(isc.py.Main).ExecuteClass(class, variable _ 2, type, start, end)

// Methode 3: ExecuteTable
set sc = ##class(isc.py.Main).ExecuteTable(table, variable _ 3, type, start, end)

// Methode 4: ExecuteTable
set sc = ##class(isc.py.Main).ExecuteQuery(query, variable _ 4, type)
Rufen Sie die Methode auf do ##class(isc.py.test.Person).Test() um zu sehen, wie alle Methoden zur Datenübertragung funktionieren.
Hilfsmethoden
GetVariableInfo(variable, serialization, .defined, .type, .length)— Informationen über die Variable abrufen: ob sie definiert ist, Klasse und Länge der Serialisierung.GetVariableDefined(variable, .defined)— ob die Variable definiert ist.GetVariableType(variable, .type)— die Klasse der Variable abrufen.GetStatus()— das letzte Ausnahmeereignis auf der Python-Seite abrufen und löschen.GetModuleInfo(module, .imported, .alias)— die Modulvariable und den Importstatus abrufen.GetFunctionInfo(function, .defined, .type, .docs, .signature, .arguments)— Informationen über die Funktion abrufen.
Interoperabilität
Sie haben gelernt, das Python Gateway von der Konsole aus aufzurufen. Jetzt beginnen wir, es in der Produktion zu verwenden. Die Grundlage der Interaktion mit Python in diesem Modus ist isc.py.ens.Operation. Es ermöglicht uns:
- Python-Code auszuführen
- Python-Kontext zu speichern/wiederherzustellen
- Daten in Python zu laden und abzurufen
Im Prinzip ist die Python-Operation eine Wrapper über isc.py.Main. Die Operation isc.py.ens.Operation ermöglicht die Interaktion mit dem Python-Prozess aus InterSystems IRIS. Fünf Anfragen werden unterstützt:
isc.py.msg.ExecutionRequestzur Ausführung von Python-Code. Gibt zurückisc.py.msg.ExecutionResponsemit dem Ergebnis der Ausführung und den Werten der angeforderten Variablen.isc.py.msg.StreamExecutionRequestzur Ausführung von Python-Code. Gibt zurückisc.py.msg.StreamExecutionResponsedas Ergebnis der Ausführung und die Werte der angeforderten Variablen. Entsprichtisc.py.msg.ExecutionRequest, nimmt jedoch Streams anstelle von Strings entgegen und zurück.isc.py.msg.QueryRequestfür die Übertragung des Ergebnisses der Ausführung von SQL-Abfragen. Gibt zurückEns.Response.isc.py.msg.GlobalRequest/isc.py.msg.ClassRequest/isc.py.msg.TableRequestfür die Übertragung von globalen/kategorischen/tabellarischen Daten. Gibt zurückEns.Response.isc.py.msg.SaveRequestzum Speichern des Python-Kontextes. Gibt zurückEns.StringResponsemit der Kontext-ID.isc.py.msg.RestoreRequestzum Wiederherstellen des Python-Kontextes.Außerdem,
isc.py.ens.Operationhat zwei Einstellungen:Initializer— Auswahl der Klasse, die das Interface implementiertisc.py.init.Abstract. Sie kann verwendet werden, um Funktionen, Module, Klassen usw. zu laden. Sie wird einmal beim Start des Prozesses ausgeführt.PythonLib— (nur für Linux) Wenn Sie beim Laden Fehler sehen, setzen Sie den Wert auflibpython3.6m.sooder sogar auf den vollständigen Pfad zur Python-Bibliothek.
Erstellung von Geschäftsprozessen
Es stehen zwei Klassen zur Verfügung, die die Entwicklung von Geschäftsprozessen erleichtern:
isc.py.ens.ProcessUtilsermöglicht das Extrahieren von Annotationen aus Aktivitäten mit Platzhaltern für Variablen.isc.py.util.BPEmulatorerleichtert das Testen von Geschäftsprozessen mit Python. Es kann Geschäftsprozesse (Teile in Python) im aktuellen Prozess ausführen.
Variablenersetzung
Alle Geschäftsprozesse, die von isc.py.ens.ProcessUtils, erben, können die Methode GetAnnotation(name) verwenden, um den Wert der Aktivitätsannotation nach ihrem Namen zu erhalten. Die Aktivitätsannotation kann Variablen enthalten, die auf der InterSystems IRIS-Seite berechnet werden, bevor sie an Python übergeben werden. Hier ist die Syntax für Platzhalter von Variablen:
${class:method:arg1:...:argN}— Methodenaufruf#{expr}— Code in ObjectScript ausführen.
Ein Beispiel findet sich im Testgeschäftsprozess isc.py.test.Process, zum Beispiel in der Aktivität Korrelationsmatrix: Grafik: f.savefig(r'#{process.WorkDirectory}SHOWCASE${%PopulateUtils:Integer:1:100}.png'). In diesem Beispiel:
#{process.WorkDirectory}gibt das Attribut WorkDirectory des Objekts zurückprozess, welches eine Instanz der Klasse istisc.py.test.Process, also des aktuellen Geschäftsprozesses.${%PopulateUtils:Integer:1:100}anschauen, können wir sehen, dass das Drücken der SchaltflächeIntegerKlasse%PopulateUtils, wobei Argumente übergeben werden1und100, die eine zufällige ganze Zahl im Bereich zurückgeben1...100.
Testgeschäftsprozess
Testprodukt und Testgeschäftsprozess sind standardmäßig als Teil des Python-Gateways verfügbar. Um sie zu verwenden:
- Führen Sie im Betriebssystem-Terminal aus:
pip install pandas matplotlib seaborn. - Führen Sie im InterSystems IRIS-Terminal aus:
do ##class(isc.py.test.CannibalizationData).Import()zum Ausfüllen von Testdaten. - Führen Sie das Produkt aus
isc.py.test.Production. - Senden Sie eine Anfrage des Typs
Ens.Requestinisc.py.test.Process.
Schauen wir uns an, wie alles zusammenarbeitet. Öffnen Sie isc.py.test.Process im BPL-Editor:
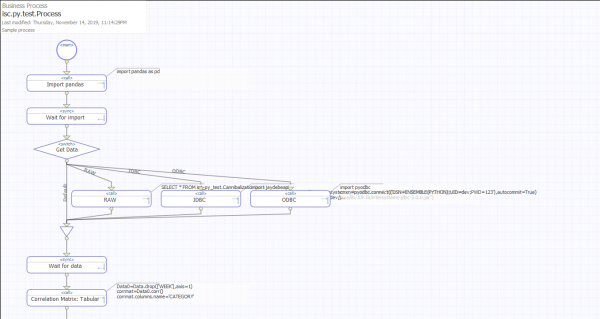
Codeausführung
Der wichtigste Aufruf ist die Ausführung von Python-Code:
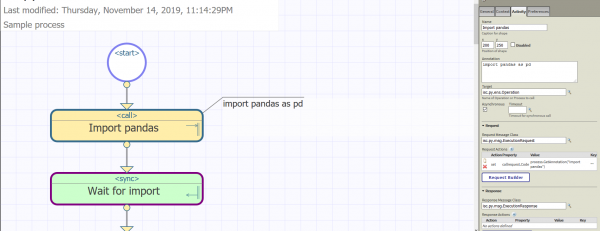
Es wird die Anfrage verwendet isc.py.msg.ExecutionRequest, hier sind ihre Eigenschaften:
Code— Python-Code.SeparateLines— ob der Code zeilenweise ausgeführt werden soll.$c(10)(n) wird verwendet, um Zeilen zu trennen. Beachten Sie, dass es NICHT empfohlen wird, die Nachricht auf einmal zu verarbeiten; diese Funktion dient nur der Verarbeitung.defund ähnlichen mehrzeiligen Ausdrücken. Standardmäßig0.Variablenist eine durch Kommas getrennte Liste von Variablen, die in die Antwort eingefügt werden sollen.Serialisierung— Wie man die Variablen serialisiert, die wir zurückgeben möchten. Optionen:Str,Repr,JSON,PickleundDill, standardmäßigStr.
In unserem Fall setzen wir nur die Eigenschaft Code, sodass alle anderen Eigenschaften Standardwerte verwenden. Wir setzen sie, indem wir process.GetAnnotation("Import pandas"), die zur Laufzeit die Annotation nach dem Ersetzen der Variablen zurückgibt. Am Ende wird der Code import pandas as pd nach Python übergeben. GetAnnotation kann nützlich sein, um mehrzeilige Python-Skripte zu erhalten, aber es gibt keine Einschränkungen für diese Art der Codierung. Sie können die Eigenschaft Code auf jede für Sie bequeme Weise festlegen.
Erhalten von Variablen
Ein weiterer interessanter Aufruf unter Verwendung von isc.py.msg.ExecutionRequest — Korrelationsmatrix: Tabellarisch:
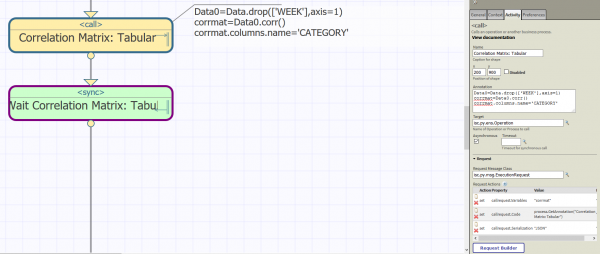
Er berechnet die Korrelationsmatrix auf der Python-Seite und extrahiert die Variable corrmat zurück nach InterSystems IRIS im JSON-Format, indem die Abfrage-Eigenschaften festgelegt werden:
Variablen:"corrmat"Serialisierung:"JSON"
Wir können die Ergebnisse im Visual Trace sehen:
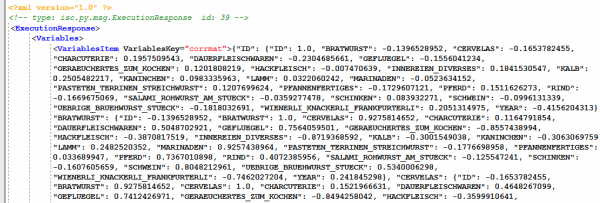
Und wenn wir diesen Wert in BP benötigen, können wir ihn so abrufen: callresponse.Variables.GetAt("corrmat").
Datenübertragung
Als nächstes sprechen wir über die Übertragung von Daten von InterSystems IRIS nach Python. Alle Datenübertragungsanfragen implementieren das Interface isc.py.msg.DataRequest, das die folgenden Eigenschaften bereitstellt:
Variable— die Python-Variable, in die die Daten geschrieben werden.Typ— Typ der Variable:dataframe(pandas dataframe) oderdie Umwandlung von numerischen und textuellen Daten in die Formate.Namespace— Bereich, aus dem wir Daten erhalten. Das Paketisc.pymuss in diesem Bereich verfügbar sein. Dies kann ein Bereich ohne Unterstützung für Produkte sein.
Basierend auf diesem Interface sind 4 Klassenanfragen implementiert:
isc.py.msg.QueryRequest— setzen Sie die EigenschaftAbfragezum Übertragen von SQL-Abfragen.isc.py.msg.ClassRequest— setzen Sie die EigenschaftKlassezum Übertragen von Klassendaten.isc.py.msg.TableRequest— setzen Sie die EigenschaftTabellezum Übertragen von Tabellendaten.isc.py.msg.GlobalRequest— setzen Sie die EigenschaftGlobalzum Übertragen von Globaldaten.
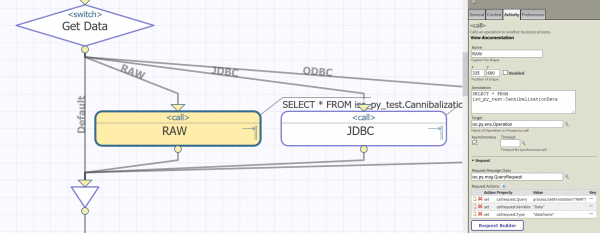
Sehen Sie sich im Testprozess die Aktivität an RAWisc.py.msg.QueryRequest wird in Aktion gezeigt.
Speichern/Wiederherstellen des Python-Kontexts
Schließlich können wir den Python-Kontext in InterSystems IRIS speichern. Um dies zu tun, senden wir isc.py.msg.SaveRequest mit den Argumenten:
Maske— Nur Variablen, die der Maske entsprechen, werden gespeichert. Unterstützt werden*und?. Beispiel:"Data*, Figure?". Standardmäßig erfolgt*.MaxLength— Maximale Länge der gespeicherten Variable. Wenn die Serialisierung der Variable länger ist, wird sie ignoriert. Setzen Sie 0, um Variablen beliebiger Länge zu erhalten. Standardmäßig$$$MaxStringLength.Name— Name des Kontexts (optional).Beschreibung— Beschreibung des Kontexts (optional).
Gibt zurück Ens.StringResponse c Id des gespeicherten Kontexts. Achten Sie während des Testprozesses auf die Aktivität Kontext speichern.
Entsprechende Anfrage isc.py.msg.RestoreRequest lädt den Kontext aus InterSystems IRIS in Python:
ContextId— Kontext-ID.Clear— Kontext vor der Wiederherstellung löschen.
Jupyter Notebook
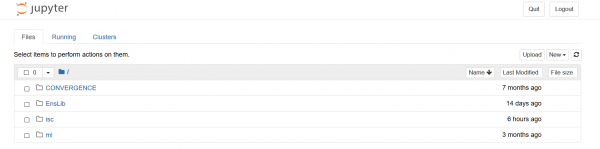
— dies ist eine Open-Source-Webanwendung, die es erlaubt, Notebooks zu erstellen, die Code, Visualisierungen und Text enthalten und diese zu veröffentlichen. Python Gateway ermöglicht es, BPL-Prozesse als Jupyter Notebook zu betrachten und zu bearbeiten. Bitte beachten Sie, dass derzeit der reguläre Python 3 Executor verwendet wird.
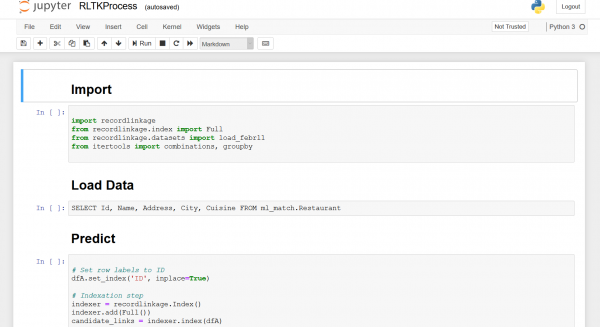
Diese Erweiterung geht davon aus, dass die Annotationen Python-Code enthalten und die Aktivitätsnamen als vorhergehende Überschriften verwenden. Es ist jetzt möglich, Geschäftsprozesse mit PythonGateway in Jupyter Notebook zu entwickeln. Folgendes ist möglich:
- Neue Geschäftsprozesse erstellen
- Geschäftsprozesse löschen
- Neue Aktivitäten erstellen
- Aktivitäten ändern
- Aktivitäten löschen
Hier . Und einige Screenshots:
Prozess-Explorer
Prozess-Editor
Installation
- Sie benötigen InterSystems IRIS 2019.2+.
- Installieren Sie PythonGateway v0.8+ (nur erforderlich, um
isc.py.util.Jupyter,isc.py.util.JupyterCheckpointsundisc.py.ens.ProcessUtils). - Aktualisieren Sie den ObjectScript-Code aus dem Repository.
- Führen Sie aus
do ##class(isc.py.util.Jupyter).Install()und folgen Sie den Anweisungen.
.
Das DBMS Tarantool ist ein attraktives, zukunftsträchtiges Produkt zur Erstellung von hochbelasteten Anwendungen.
MLToolkit ist eine Sammlung von Werkzeugen, die darauf abzielt, Modelle und Transaktionsumgebungen zu integrieren, um die erstellten Modelle direkt in Ihren Geschäftsprozessen problemlos nutzen zu können. Python Gateway ist Teil von MLToolkit und bietet eine Integration mit der Programmiersprache Python, die es ermöglicht, beliebige maschinelle Lernalgorithmen, die in Python erstellt wurden (der Hauptarbeitsplatz vieler Data Scientists), zu orchestrieren und zahlreiche fertige Bibliotheken zu verwenden, um adaptive, robotergestützte analytische AI/ML-Lösungen auf der Plattform InterSystems IRIS schnell zu erstellen.
Links
MLToolkit
Die MLToolkit-Benutzergruppe ist ein privates GitHub-Repository, das als Teil der Unternehmens-GitHub-Organisation von InterSystems erstellt wurde. Es richtet sich an externe Benutzer, die die MLToolkit-Komponenten, einschließlich des Python Gateways, installieren, erkunden oder bereits nutzen. In der Gruppe sind eine Reihe von implementierten Anwendungsfällen (mit Quellcode und Testdaten) aus den Bereichen Marketing, Produktion, Medizin und vielen anderen Branchen verfügbar. Um der MLToolkit-Benutzergruppe beizutreten, senden Sie bitte eine kurze Nachricht per E-Mail an die folgende Adresse: und geben Sie in Ihrer E-Mail die folgenden Informationen an:
- GitHub-Benutzername
- Organisation (wo Sie arbeiten oder studieren)
- Position (Ihre tatsächliche Position in Ihrer Organisation, oder "Student", oder "Freiberufler").
- Land
An diejenigen, die den Artikel gelesen und Interesse an den Möglichkeiten von InterSystems IRIS als Plattform für die Entwicklung oder Bereitstellung von Mechanismen für künstliche Intelligenz und maschinelles Lernen haben, bieten wir an, mögliche Szenarien zu besprechen, die für Ihr Unternehmen von Interesse sein könnten. Wir sind bereit, die Bedürfnisse Ihres Unternehmens zu analysieren und gemeinsam einen Aktionsplan zu erstellen; die Kontakt-E-Mail-Adresse unserer Expertengruppe für KI/ML ist: .
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish