

Hallo, Habra!
Im Herbst letzten Jahres fand auf Kaggle ein Wettbewerb zur Klassifikation handgezeichneter Bilder, das Quick Draw Doodle Recognition, statt, an dem unter anderem ein Team von R-Entwicklern teilnahm, bestehend aus , und . Eine ausführliche Beschreibung des Wettbewerbs werden wir nicht geben, das ist bereits in .
beschrieben. Mit dem Medaillenfarm war es dieses Mal nicht einfach, aber wir haben viele wertvolle Erfahrungen gesammelt, daher möchten wir der Community über einige der interessantesten und nützlichsten Dinge auf Kaggle und in der täglichen Arbeit berichten. Zu den behandelten Themen gehören: das nicht leichte Leben ohne OpenCV, Parsing von JSON (in diesen Beispielen wird die Integration von C++-Code in Skripte oder Pakete in R mittels Rcpp), Parametrisierung von Skripten und Dockerisierung der endgültigen Lösung. Der gesamte Code aus der Nachricht ist in einer lauffähigen Version verfügbar in .
Inhalt:
1. Effektives Laden von Daten aus CSV in die MonetDB-Datenbank
Die Daten in diesem Wettbewerb werden nicht als fertige Bilder bereitgestellt, sondern in Form von 340 CSV-Dateien (jeweils eine Datei pro Klasse), die JSON mit den Koordinaten der Punkte enthalten. Durch das Verbinden dieser Punkte mit Linien erhalten wir das endgültige Bild mit einer Größe von 256x256 Pixel. Außerdem wird für jeden Eintrag ein Label angegeben, ob das Bild vom zum Zeitpunkt der Datensatzsammlung verwendeten Klassifikator richtig erkannt wurde, ein zweibuchstabiger Ländercode des Wohnlandes des Künstlers, eine eindeutige Kennung, ein Zeitstempel und der Klassenname, der mit dem Dateinamen übereinstimmt. Die vereinfachte Version der Ausgangsdaten hat eine Größe von 7,4 GB im Archiv und etwa 20 GB nach der Entpackung, die vollständigen Daten nehmen nach der Entpackung 240 GB ein. Die Organisatoren garantierten, dass beide Versionen die gleichen Zeichnungen reproduzieren, das heißt, die vollständige Version ist redundant. In jedem Fall wurde die Speicherung von 50 Millionen Bildern in Grafikdateien oder in Form von Arrays sofort als unrentabel angesehen, und wir entschieden uns, alle CSV-Dateien aus dem Archiv train_simplified.zip in die Datenbank zu laden, mit anschließender Generierung der Bilder in der benötigten Größe "on the fly" für jedes Batch.
Als DBMS wurde eine gut bewährte MonetDB, nämlich die Implementierung für R in Form eines Pakets . Das Paket enthält eine eingebettete Version des Datenbankservers und ermöglicht es, den Server direkt aus der R-Session zu starten und dort zu arbeiten. Die Erstellung einer Datenbank und die Verbindung zu dieser erfolgt mit einem Befehl:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Wir müssen zwei Tabellen erstellen: eine für alle Daten, die andere für die Verwaltungsinformationen zu den hochgeladenen Dateien (nützlich, wenn etwas schief geht und der Prozess nach dem Hochladen mehrerer Dateien fortgesetzt werden muss):
Tabellen erstellen
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
Die schnellste Methode zum Hochladen von Daten in die DB stellte sich als das direkte Kopieren von CSV-Dateien mittels SQL heraus – der Befehl COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORTtablename — der Name der Tabelle und path — der Pfad zur Datei. Bei der Arbeit mit dem Archiv wurde festgestellt, dass die integrierte Implementierung unzip in R mit einigen Dateien aus dem Archiv nicht korrekt funktionierte, daher verwendeten wir das systemeigene unzip (mit dem Parameter getOption("unzip")).
Funktion zum Schreiben in die Datenbank
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
Falls eine Umwandlung der Tabelle vor dem Schreiben in die DB erforderlich ist, reicht es, die Argumente preprocess Funktion zu übergeben, die die Daten umwandelt.
Code zum sequenziellen Hochladen von Daten in die Datenbank:
Daten in die Datenbank schreiben
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
Die Dauer des Datenuploads kann abhängig von den Geschwindigkeitsmerkmalen des verwendetenSpeichers variieren. In unserem Fall dauert das Lesen und Schreiben innerhalb eines SSD oder von einem USB-Stick (Quelldatei) auf SSD (DB) weniger als 10 Minuten.
Einige Sekunden sind erforderlich, um eine Spalte mit einer ganzzahligen Klassenbezeichnung und eine Spalte mit dem Index (ORDERED INDEX) mit den Zeilennummern zu erstellen, nach denen Beobachtungen beim Erstellen von Batches ausgewählt werden:
Zusätzliche Spalten und Index erstellen
message("Generate labels")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Generate row numbers")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
Um die Aufgabe der Batch-Bildung „on the fly“ zu lösen, mussten wir die maximale Geschwindigkeit beim Abrufen zufälliger Zeilen aus der Tabelle erreichen. Doodles. Dazu haben wir 3 Tricks verwendet. Der erste bestand darin, den Datentyp für die Beobachtungs-ID zu verkleinern. Im ursprünglichen Datensatz benötigte der Datentyp bigint, aber die Anzahl der Beobachtungen ermöglicht es, ihre Identifikatoren, die den Ordnungszahlen entsprechen, im Datentyp intunterzubringen. Dadurch erfolgt die Suche deutlich schneller. Der zweite Trick war die Verwendung von ORDERED INDEX — zu dieser Lösung sind wir empirisch gelangt, indem wir alle verfügbaren Der dritte bestand darin, parametrisierte Abfragen zu verwenden. Es geht darum, einmal den Befehl PREPARE auszuführen, gefolgt von der Verwendung des vorbereiteten Ausdrucks bei der Erstellung von Mengen ähnlicher Abfragen, wobei sich in der Praxis der Gewinn im Vergleich zu einfachen SELECT in einem Bereich der statistischen Fehlergrenze bewegte.
Der Prozess des Datenladens benötigt nicht mehr als 450 MB RAM. Das bedeutet, dass der beschriebene Ansatz es ermöglicht, Datensätze von mehreren Dutzend Gigabyte praktisch auf jeder Budget-Hardware zu verarbeiten, einschließlich einiger Einplatinencomputer, was ziemlich beeindruckend ist.
Es bleibt, die Geschwindigkeit des Abrufs (zufälliger) Daten zu messen und das Scaling bei der Auswahl von Batchgrößen unterschiedlicher Größe zu bewerten:
Datenbank-Benchmark
library(ggplot2)

set.seed(0)
# Verbindung zur Datenbank
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Funktion zur Vorbereitung der Anfrage auf Serverseite
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Funktion zum Abrufen von Daten
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Durchführung des Benchmarks
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Benchmark-Parameter
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("median time, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 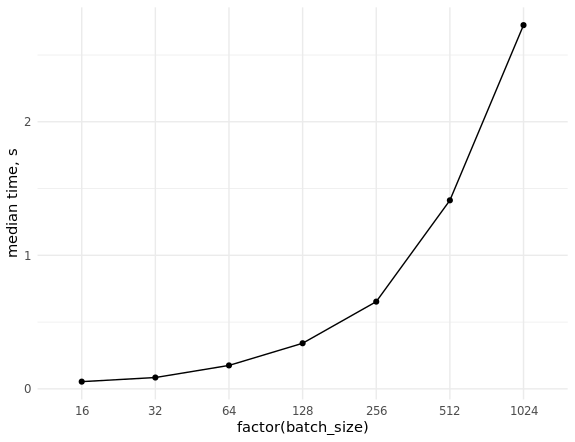
2. Vorbereitung der Batches
Der gesamte Prozess der Vorbereitung von Batches besteht aus folgenden Schritten:
- Parsen mehrerer JSONs, die Vektoren von Strings mit den Koordinaten der Punkte enthalten.
- Zeichnen von farbigen Linien anhand der Koordinaten der Punkte auf einem Bild der gewünschten Größe (z.B. 256×256 oder 128×128).
- Umwandlung der erhaltenen Bilder in einen Tensor.
Im Rahmen des Wettbewerbs unter Kernels auf Python wurde das Problem hauptsächlich mit Mitteln OpenCV. Ein naheliegender und offensichtlicher Analogon in R würde wie folgt aussehen:
Implementierung der Transformation von JSON in einen Tensor in R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # Parsing JSON
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Löschen Sie die temporäre Datei nach Beendigung der Funktion
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Leeres Diagramm
  plot.new()
  # Fenstergröße des Diagramms
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Farben der Linien
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Umwandlung des Bildes in ein 3D-Array
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Fusion der 3D-Bildarrays in ein 4D-Array im Tensor
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
Die Zeichnung erfolgt mit den Standardmitteln von R und wird in einem temporären PNG gespeichert, das im RAM verbleibt (in Linux befinden sich die temporären Verzeichnisse von R im Verzeichnis /tmp, das im RAM gemountet ist). Anschließend wird diese Datei als 3D-Array mit Zahlen im Bereich von 0 bis 1 gelesen. Dies ist wichtig, da ein allgemeineres BMP in ein Raw-Array mit Hex-Farbcodes eingelesen worden wäre.
Lassen Sie uns das Ergebnis testen:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 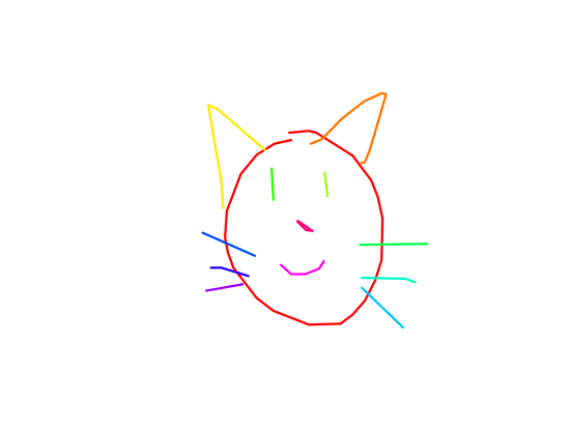
Der Batch wird wie folgt gebildet:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
Diese Implementierung erschien uns nicht optimal, da die Bildung großer Batches unangemessen viel Zeit in Anspruch nimmt, und wir beschlossen, die Erfahrungen von Kollegen zu nutzen, indem wir eine leistungsstarke Bibliothek einsetzten OpenCV. Zu diesem Zeitpunkt gab es kein vorhandenes Paket für R (gibt es auch jetzt nicht), daher wurde eine minimale Implementierung der erforderlichen Funktionalität in C++ geschrieben, die in den R-Code integriert wurde mithilfe von Rcpp.
Um die Aufgabe zu lösen, wurden die folgenden Pakete und Bibliotheken verwendet:
OpenCV für die Arbeit mit Bildern und das Zeichnen von Linien. Dabei wurden bereits installierte Systembibliotheken und Header-Dateien sowie dynamische Verlinkung verwendet.
xtensor zum Arbeiten mit mehrdimensionalen Arrays und Tensoren. Wir haben die Header-Dateien verwendet, die im gleichnamigen R-Paket enthalten sind. Die Bibliothek ermöglicht die Arbeit mit mehrdimensionalen Arrays, sowohl im Zeilenmajor- als auch im Spaltenmajor-Format.
ndjson zum Parsen von JSON. Diese Bibliothek wird in xtensor automatisch verwendet, wenn sie im Projekt vorhanden ist.
RcppThread zur Organisation der mehrfädigen Verarbeitung von Vektoren aus JSON. Wir haben die Header-Dateien verwendet, die von diesem Paket bereitgestellt werden. Im Gegensatz zu dem bekannteren RcppParallel unterscheidet sich das Paket unter anderem durch einen integrierten Mechanismus zur Unterbrechung von Schleifen (interrupt).
Es ist erwähnenswert, dass xtensor sich als eine echte Entdeckung erwies: Neben umfangreicher Funktionalität und hoher Leistung zeigten sich die Entwickler äußerst reaktionsschnell und beantworteten zeitnah und ausführlich alle aufkommenden Fragen. Mit ihrer Hilfe konnten die Transformationen von OpenCV-Matrizen in xtensor-Tensoren sowie die Möglichkeit, 3D-Bilder-Tensoren in einen 4D-Tensor mit der richtigen Dimension (also Batch) zu kombinieren, realisiert werden.
Materialien zur Erlernung von Rcpp, xtensor und RcppThread
Um Dateien zu kompilieren, die Systemdateien verwenden und dynamisch mit im System installierten Bibliotheken verlinkt sind, haben wir das Plugin-System verwendet, das im Paket umgesetzt ist Rcpp. Zur automatischen Auffindung von Pfaden und Flags verwendeten wir das beliebte Linux-Tool pkg-config.
Implementierung eines Rcpp-Plugins zur Verwendung der OpenCV-Bibliothek
Rcpp::registerPlugin("opencv", function() {
  # Mögliche Paketnamen
  pkg_config_name <- c("opencv", "opencv4")
  # Binärdatei des pkg-config-Tools
  pkg_config_bin <- Sys.which("pkg-config")
  # Überprüfen der Anwesenheit des Tools im System
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Überprüfung der Existenz der OpenCV-Einstellungsdatei für pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("OpenCV-Konfiguration für pkg-config nicht gefunden", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
Im Ergebnis der Plugin-Ausführung werden während des Kompilierungsprozesses folgende Werte eingesetzt:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
Der Code zur Implementierung der JSON-Parsing und der Batch-Bildung für die Modellübertragung ist unter dem Spoiler aufgeführt. Zunächst fügen wir das lokale Projektverzeichnis hinzu, um die Header-Dateien zu suchen (notwendig für ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Implementierung der Umwandlung von JSON in einen Tensor in C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Dieser Code sollte in eine Datei eingefügt werden src/cv_xt.cpp und mit dem Befehl kompiliert werden Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); außerdem wird benötigt nlohmann/json.hpp aus . Der Code ist in mehrere Funktionen unterteilt:
to_xt— eine templatisierte Funktion zur Umwandlung einer Bildmatrix (cv::Mat) in einen Tensorxt::xtensor;parse_json— die Funktion parst einen JSON-String, extrahiert die Koordinaten der Punkte und packt sie in einen Vektor;ocv_draw_lines— zeichnet aus dem erhaltenen Punktvektor mehrfarbige Linien;prozess— kombiniert die oben beschriebenen Funktionen und fügt die Möglichkeit der Skalierung des erhaltenen Bildes hinzu;cpp_process_json_str— eine Wrapper-Funktion,prozessdie das Ergebnis in ein R-Objekt (mehrdimensionales Array) exportiert;cpp_process_json_vector— eine Wrapper-Funktion,cpp_process_json_str— die es ermöglicht, einen String-Vektor im Multithreading-Modus zu verarbeiten.
Für das Zeichnen der mehrfarbigen Linien wurde das HSV-Farbmodell verwendet, gefolgt von einer Konvertierung in RGB. Lassen Sie uns das Ergebnis testen:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 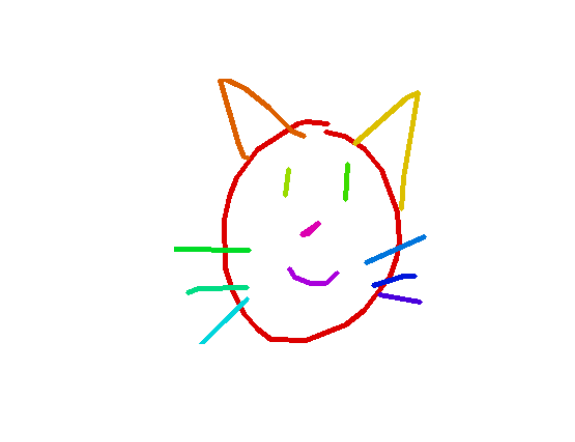
Vergleich der Ausführungsgeschwindigkeit der Implementierungen in R und C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Benchmarkparameter
cols <- c("expression", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   expression                min     median       max `itr/sec` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Durchführung der Messung
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expression   batch_size      min   median      max `itr/sec` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>         <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("Medianzeit, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 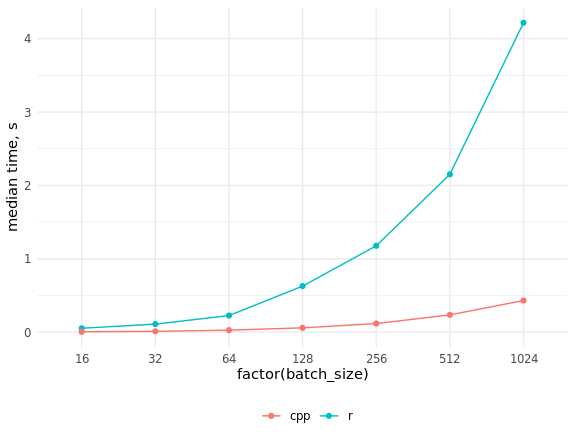
Wie wir sehen, war der Geschwindigkeitszuwachs sehr signifikant, und es ist nicht möglich, den Code in C++ durch Parallelisierung des Codes in R einzuholen.
3. Iteratoren zum Laden von Batches aus der Datenbank
R hat sich einen verdienten Ruf als Sprache für die Verarbeitung von Daten erarbeitet, die im Arbeitsspeicher Platz finden, während Python eher für iterative Datenverarbeitung bekannt ist, die es ermöglicht, Out-of-Core-Berechnungen (Berechnungen mit externem Speicher) leicht und ohne Aufwand umzusetzen. Ein klassisches und relevantes Beispiel für solche Berechnungen in unserem Kontext sind tiefe neuronale Netze, die mit dem Gradientenabstieg trainiert werden, wobei der Gradient bei jedem Schritt anhand einer kleinen Menge an Beobachtungen oder einem Mini-Batch approximiert wird.
Deep-Learning-Frameworks, die in Python geschrieben sind, verfügen über spezielle Klassen, die Iteratoren für Daten implementieren: Tabellen, Bilder in Ordnern, binäre Formate usw. Man kann fertige Varianten nutzen oder eigene für spezifische Aufgaben schreiben. In R können wir auf alle Möglichkeiten der Python-Bibliothek zugreifen. keras mit seinen verschiedenen Backends über das gleichnamige Paket, das wiederum auf dem Paket reticulateaufbaut. Letzteres verdient einen eigenen, umfassenden Artikel; es ermöglicht nicht nur das Ausführen von Python-Code aus R, sondern sorgt auch für die Übertragung von Objekten zwischen R- und Python-Sitzungen, wobei automatisch alle erforderlichen Typumwandlungen durchgeführt werden.
Durch die Nutzung von MonetDBLite haben wir die Notwendigkeit beseitigt, alle Daten im Arbeitsspeicher zu speichern. Die gesamte "neuronale Netz"-Arbeit wird vom originären Python-Code erledigt. Es bleibt uns nur, einen Dateniterator zu schreiben, da es keine fertige Lösung für eine solche Situation in R oder Python gibt. Die Anforderungen an ihn sind im Wesentlichen zwei: Er muss kontinuierlich Chargen in einer unendlichen Schleife zurückgeben und seinen Zustand zwischen den Iterationen speichern (letzteres wird in R auf einfachste Weise durch Closures realisiert). Früher war es erforderlich, innerhalb des Iterators explizit R-Arrays in NumPy-Arrays umzuwandeln, aber die aktuelle Version des Pakets keras macht dies von selbst.
Der Iterator für Trainings- und Validierungsdaten sieht wie folgt aus:
Iterator für Trainings- und Validierungsdaten
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
Die Funktion akzeptiert eine Eingangsvariable mit einer Verbindung zur Datenbank, die Zeilennummern, die verwendeten Klassen, die Batchgröße, den Maßstab (scale = 1 entspricht der Darstellung von Bildern mit 256x256 Pixeln, scale = 0.5 – 128x128 Pixel), einen Farbindikator (color = FALSE bestimmt die Darstellung in Graustufen, bei Verwendung Farbe = WAHR Jeder Strich wird in einer neuen Farbe gezeichnet) und ein Präprozess-Indikator für Netzwerke, die auf imagenet trainiert wurden. Letzterer ist notwendig, um die Pixelwerte aus dem Bereich [0, 1] in den Bereich [-1, 1] umzurechnen, der beim Training verwendet wurde, das mitgeliefert wird keras Modelle.
Die externe Funktion enthält eine Typüberprüfung der Argumente, eine Tabelle data.table mit zufällig durchmischten Zeilennummern aus samples_index und Batch-Nummern, einen Zähler und die maximale Anzahl an Batches sowie einen SQL-Ausdruck zum Abrufen von Daten aus der Datenbank. Zusätzlich haben wir innerhalb einen schnellen Ersatz für die Funktion definiert keras::to_categorical(). Wir haben fast alle Daten zum Trainieren verwendet und nur einen halben Prozentsatz für die Validierung gelassen, sodass die Größe der Epoche durch den Parameter steps_per_epoch beim Aufruf keras::fit_generator(), und die Bedingung if (i > max_i) triggere nur für den Validierungsiterator.
In der inneren Funktion erfolgt die Auswahl der Zeilenindizes für den nächsten Batch, das Abrufen von Datensätzen aus der Datenbank mit Erhöhen des Batch-Zählers, das Parsen von JSON-Daten (die Funktion cpp_process_json_vector(), geschrieben in C++) und die Erstellung von Arrays für die Bilder. Dann werden One-Hot-Vektoren mit den Klassenbezeichnungen erstellt, die Arrays mit den Pixelwerten und den Bezeichnungen werden in einer Liste zusammengeführt, die den Rückgabewert darstellt. Zur Beschleunigung der Verarbeitung wurde die Erstellung von Indizes in den Tabellen verwendet data.table und Modifikation durch Referenz – ohne diese 'Tricks' des Pakets data.table ist es ziemlich schwierig, eine effiziente Verarbeitung mit irgendeinem signifikanten Datenvolumen in R vorzustellen.
Die Ergebnisse der Geschwindigkeitsmessungen auf einem Notebook mit Core i5 sehen wie folgt aus:
Benchmark des Iterators
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Indizes für den Trainingsdatensatz
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Indizes für den Validierungsdatensatz
val_ind <- ind[-train_ind]
rm(ind)
# Skalierungsfaktor
scale <- 0.5

# Durchführung der Messung
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Parameter des Benchmarks
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("Medianzeit, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 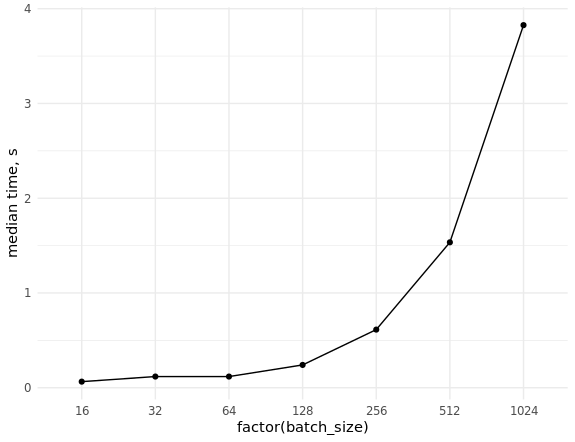
Wenn ausreichend RAM vorhanden ist, lässt sich die Datenbank erheblich beschleunigen, indem sie in diesen RAM verschoben wird (für unsere Aufgabe reichen 32 GB aus). Auf Linux wird standardmäßig eine Partition gemountet /dev/shm, die bis zur Hälfte des RAMs einnimmt. Es kann auch mehr zugewiesen werden, indem man /etc/fstab, um eine Konfiguration wie folgt zu erstellen tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Auf jeden Fall neu starten und das Ergebnis überprüfen, indem man den Befehl ausführt df -h.
Der Iterator für die Testdaten sieht viel einfacher aus, da der gesamte Testdatensatz im RAM Platz hat:
Iterator für Testdaten
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Auswahl der Architektur des Modells
Eine der verwendeten Architekturen war , deren Besonderheiten in der Mitteilung behandelt werden. Sie ist im Standardpaket enthalten keras und somit im gleichnamigen R-Paket verfügbar. Aber beim Versuch, sie mit einkanaligen Bildern zu verwenden, stellte sich etwas Seltsames heraus: Der Eingabetensor muss immer die Dimension (batch, height, width, 3) haben., das heißt, die Anzahl der Kanäle kann nicht geändert werden. In Python gibt es diese Einschränkung nicht, deshalb haben wir uns beeilt und unsere eigene Implementierung dieser Architektur geschrieben, indem wir dem Originalartikel gefolgt sind (ohne Dropout, wie es in der Keras-Variante der Fall ist):
Architektur mobilenet v1
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Die Nachteile dieses Ansatzes sind offensichtlich. Man möchte viele Modelle prüfen, aber es ist unerwünscht, jede Architektur manuell neu zu schreiben. Zudem waren wir nicht in der Lage, vorab auf Imagenet trainierte Modellgewichte zu verwenden. Wie so oft half das Studium der Dokumentation. Die Funktion get_config() ermöglicht es, die Beschreibung des Modells in einem bearbeitbaren Format zu erhalten (base_model_conf$layers — gewöhnliche R-Listen), und die Funktion from_config() führt die Umwandlung in ein Modellobjekt rückgängig durch:
base_model_conf < - get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] < - 1L
base_model < - from_config(base_model_conf)
Jetzt ist es nicht schwer, eine universelle Funktion zum Abrufen eines beliebigen der mitgelieferten Modelle zu schreiben, keras die mit preisgegebenen Gewichten für imagenet oder ohne geliefert werden:
Funktion zum Laden vorgefertigter Architekturen
get_model < - function(name = "mobilenet_v2",
                      input_shape = NULL,
                      weights = "imagenet",
                      pooling = "avg",
                      num_classes = NULL,
                      optimizer = keras::optimizer_adam(lr = 0.002),
                      loss = "categorical_crossentropy",
                      metrics = NULL,
                      color = TRUE,
                      compile = FALSE) {
  # Überprüfung der Argumente
  checkmate::assert_string(name)
  checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3)
  checkmate::assert_count(num_classes)
  checkmate::assert_flag(color)
  checkmate::assert_flag(compile)

  # Erhalten das Objekt aus dem keras-Paket
  model_fun < - get0(paste0("application_", name), envir = asNamespace("keras"))
  # Überprüfen, ob das Objekt im Paket vorhanden ist
  if (is.null(model_fun)) {
    stop("Modell ", shQuote(name), " nicht gefunden.", call. = FALSE)
  }

  base_model < - model_fun(
    input_shape = input_shape,
    include_top = FALSE,
    weights = weights,
    pooling = pooling
  )

  # Wenn das Bild nicht farbig ist, ändere die Eingabedimension
  if (!color) {
    base_model_conf < - keras::get_config(base_model)
    base_model_conf$layers[[1]]$config$batch_input_shape[[4]] < - 1L
    base_model < - keras::from_config(base_model_conf)
  }

  predictions < - keras::get_layer(base_model, "global_average_pooling2d_1")$output
  predictions < - keras::layer_dense(predictions, units = num_classes, activation = "softmax")
  model < - keras::keras_model(
    inputs = base_model$input,
    outputs = predictions
  )

  if (compile) {
    keras::compile(
      object = model,
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )
  }

  return(model)
}
Bei der Verwendung von einkanaligen Bildern werden keine vortrainierten Gewichte verwendet. Dies könnte behoben werden: durch die Funktion get_weights() um die Gewichte des Modells als Liste von R-Arrays abzurufen, die Dimension des ersten Elements dieser Liste zu ändern (indem ein Farbkanal genommen oder alle drei gemittelt werden) und dann die Gewichte mit der Funktion set_weights(). Wir haben diese Funktionalität nicht hinzugefügt, da bereits zu diesem Zeitpunkt klar war, dass es produktiver ist, mit farbigen Bildern zu arbeiten.
Die Hauptmasse der Experimente haben wir mit den Versionen 1 und 2 von mobilenet sowie mit resnet34 durchgeführt. In diesem Wettbewerb haben sich modernere Architekturen wie SE-ResNeXt gut bewährt. Leider standen uns keine fertigen Implementierungen zur Verfügung, und die eigenen haben wir noch nicht geschrieben (aber wir werden es unbedingt tun).
5. Parametrisierung der Skripte
Zur Vereinfachung wurde der gesamte Code für den Ausbildungsstart in Form eines einzigen Skripts gestaltet, das mit Hilfe von folgendermaßen ausführen:
doc <- '
Verwendung:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [Optionen]

Optionen:
  -h --help                   Diese Nachricht anzeigen.
  -l --list-models            Verfügbare Modelle auflisten.
  -m --model=          Name des neuronalen Netzmodells [Standard: mobilenet_v2].
  -b --batch-size=      Batch-Größe [Standard: 32].
  -s --scale-factor=   Skalierungsfaktor [Standard: 0.5].
  -c --color                  Farbige Linien verwenden [Standard: FALSE].
  -d --db-dir=          Pfad zum Datenbankverzeichnis [Standard: Sys.getenv("db_dir")].
  -r --validate-ratio= Validierungsstichprobenverhältnis [Standard: 0.995].
  -n --n-gpu=         Anzahl der GPUs [Standard: 1].
'
args <- docopt::docopt(doc)
Paket docopt stellt eine Implementierung für R dar. Damit werden die Skripte einfach mit Befehlen wie Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db oder ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, wenn die Datei train_nn.R ausführbar ist (dieser Befehl startet das Training des Modells resnet50 mit dreifarbigen Bildern in der Größe 128x128 Pixel, die Datenbank muss sich im Ordner /home/andrey/doodle_db). In die Liste können Lernrate, Optimierer und alle anderen konfigurierbaren Parameter hinzugefügt werden. Während der Vorbereitung der Veröffentlichung stellte sich heraus, dass die Architektur mobilenet_v2 aus der aktuellen Version keras in R verwendet werden kann wegen unberücksichtigter Änderungen im R-Paket — wir warten darauf, dass dies behoben wird.
Dieser Ansatz hat es ermöglicht, die Experimente mit verschiedenen Modellen im Vergleich zu einem traditionelleren Start von Skripten in RStudio erheblich zu beschleunigen (als mögliche Alternative sei das Paket ). Aber der Hauptvorteil liegt in der Möglichkeit, Skripte einfach in Docker oder einfach auf einem Server zu steuern, ohne dafür RStudio zu installieren.
6. Dockerisierung der Skripte
Wir haben Docker verwendet, um die Übertragbarkeit der Umgebung für das Training von Modellen zwischen den Teammitgliedern zu gewährleisten und um eine schnelle Bereitstellung in der Cloud zu ermöglichen. Man kann sich mit diesem für R-Programmierer relativ ungewohnten Werkzeug über eine Serie von Veröffentlichungen oder über .
Docker ermöglicht es, eigene Images „von Grund auf“ zu erstellen oder andere Images als Grundlage für die Erstellung eigener Images zu verwenden. Bei der Analyse der vorhandenen Optionen sind wir zu dem Schluss gekommen, dass die Installation von NVIDIA-Treibern, CUDA+cuDNN und Python-Bibliotheken ein ziemlich umfangreicher Teil des Images ist, und haben beschlossen, das offizielle Image als Grundlage zu verwenden. tensorflow/tensorflow:1.12.0-gpu, indem wir die erforderlichen R-Pakete hinzugefügt haben.
Die endgültige Docker-Datei sieht folgendermaßen aus:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
Zur Vereinfachung wurden die verwendeten Pakete in Variablen ausgelagert; der Großteil der geschriebenen Skripte wird beim Build in die Container kopiert. Außerdem haben wir die Shell auf /bin/bash für die Benutzerfreundlichkeit des Inhalts geändert. /etc/os-release. Dies hat es ermöglicht, die Angabe der OS-Version im Code zu vermeiden.
Zusätzlich wurde ein kleines Bash-Skript geschrieben, das es ermöglicht, den Container mit verschiedenen Befehlen zu starten. Zum Beispiel könnten dies Skripte für das Training von neuronalen Netzwerken sein, die zuvor im Container gespeichert wurden, oder eine Shell für Debugging und Monitoring der Containerarbeit:
Skript zum Starten des Containers
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Wenn dieses Bash-Skript ohne Parameter gestartet wird, wird innerhalb des Containers ein Skript aufgerufen train_nn.R mit Standardwerten; wenn das erste positionale Argument „bash“ ist, wird der Container im interaktiven Modus mit einer Kommandozeile gestartet. In allen anderen Fällen erfolgt die Ersetzung der Werte der positionalen Argumente: CMD="Rscript /app/train_nn.R $@".
Es ist zu beachten, dass die Verzeichnisse mit den Quelldaten und der Datenbank sowie das Verzeichnis zum Speichern der trainierten Modelle aus dem Host-System in den Container eingebunden werden, was den Zugriff auf die Ergebnisse der Skripte ohne zusätzliche Manipulationen ermöglicht.
7. Verwendung mehrerer GPUs in der Google Cloud
Eine der Besonderheiten des Wettbewerbs waren die sehr rauschenden Daten (siehe das Titelbild, entnommen von @Leigh.plt aus ODS-Slack). Große Batchgrößen helfen, dies zu bekämpfen, und nach Experimenten auf einem PC mit 1 GPU entschieden wir uns, das Training von Modellen auf mehreren GPUs in der Cloud zu erlernen. Wir verwendeten Google Cloud () aufgrund der großen Auswahl an verfügbaren Konfigurationen, akzeptablen Preisen und einem Bonus von $300. Aus Gier bestellten wir einen Instanz mit 4xV100 mit SSD und viel RAM, und das war ein großer Fehler. Solch eine Maschine frisst das Geld schnell, und bei Experimenten ohne ausgereiteten Pipeline kann man bankrottgehen. Für Lernzwecke ist es besser, K80 zu nehmen. Der große RAM hat sich jedoch als nützlich erwiesen – die Cloud-SSD war nicht beeindruckend schnell, daher haben wir die Datenbank bei jedem Start der Instanz auf dev/shm.
Besonders interessant ist der Code-Ausschnitt, der für die Verwendung mehrerer GPUs verantwortlich ist. Zunächst wird das Modell auf der CPU mit einem Kontext-Manager erstellt, ganz wie in Python:
with(tensorflow::tf$device("/cpu:0"), {
  model_cpu <- get_model(
    name = model_name,
    input_shape = input_shape,
    weights = weights,
    metrics =(top_3_categorical_accuracy,
    compile = FALSE
  )
})
Dann wird das nicht kompilierte (das ist wichtig) Modell auf die angegebene Anzahl verfügbarer GPUs kopiert, und erst danach wird es kompiliert:
model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu)
keras::compile(
  object = model,
  optimizer = keras::optimizer_adam(lr = 0.0004),
  loss = "categorical_crossentropy",
  metrics = c(top_3_categorical_accuracy)
)
Es war nicht möglich, das klassische Verfahren, bei dem alle Schichten außer der letzten eingefroren, die letzte Schicht trainiert, dann aufgetaut und das Modell insgesamt für mehrere GPUs weitertrainiert wird, zu realisieren.
Das Training wurde ohne Verwendung von tensorboard, indem sie die Protokolle aufzeichnen und die Modelle mit informativen Namen nach jeder Epoche speichern:
Callbacks
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. Fazit
Eine Reihe von Problemen, mit denen wir konfrontiert waren, konnten vorerst nicht gelöst werden:
- in keras es gibt keine fertige Funktion zur automatischen Suche nach der optimalen Lernrate (Analog
lr_finderin der Bibliothek fast.ai); mit etwas Aufwand können externe Implementierungen in R portiert werden, beispielsweise ; - als Folge des vorherigen Punktes konnte die richtige Lernrate bei der Verwendung mehrerer GPUs nicht gefunden werden;
- es fehlen moderne Architekturen von neuronalen Netzen, insbesondere vortrainierte auf Imagenet;
- es gibt keine One Cycle Policy und discriminative Learning Rates (cosine annealing wurde auf unsere Bitte hin , danke ).
Was nützlich war, aus diesem Wettbewerb mitzunehmen:
- Auf relativ schwacher Hardware kann man problemlos mit anständigen (deutlich über dem RAM-Größe liegenden) Datenmengen arbeiten. Das Paket data.table spart Speicher durch in-place Modifikationen von Tabellen, was das Kopieren vermeidet, und zeigt bei richtiger Nutzung seiner Möglichkeiten fast immer die höchste Geschwindigkeit unter allen uns bekannten Tools für Skriptsprache. Die Speicherung von Daten in einer Datenbank ermöglicht es in vielen Fällen, sich überhaupt keine Gedanken über die Notwendigkeit zu machen, den gesamten Datensatz in den RAM zu quetschen.
- Langsame Funktionen in R können durch schnelle in C++ mithilfe des Pakets Rcppersetzt werden. Wenn man zusätzlich RcppThread oder RcppParallelverwendet, erhält man plattformübergreifende Multi-Threaded-Implementierungen, sodass der Code auf der R-Ebene nicht parallelisiert werden muss.
- Das Paket Rcpp kann ohne fundierte Kenntnisse in C++ verwendet werden, das notwendige Minimum ist beschrieben . Header-Dateien für eine Reihe von coolen C-Bibliotheken wie xtensor sind auf CRAN verfügbar, was bedeutet, dass eine Infrastruktur für die Umsetzung von Projekten entsteht, die hochperformanten C++-Code in R integrieren. Ein zusätzliches Plus — Syntax-Highlighting und ein statischer Code-Analysator für C++ in RStudio.
- docopt ermöglicht das Ausführen von eigenständigen Skripten mit Parametern. Das ist praktisch für die Nutzung auf einem Remote-Server, auch unter Docker. In RStudio ist es unpraktisch, stundenlange Experimente mit dem Training von neuronalen Netzen durchzuführen, und die Installation der IDE auf einem Server ist nicht immer gerechtfertigt.
- Docker ermöglicht die Portabilität von Code und die Reproduzierbarkeit von Ergebnissen zwischen Entwicklern mit unterschiedlichen Betriebssystemversionen und Bibliotheken sowie die einfache Ausführung auf Servern. Die gesamte Pipeline für das Training kann mit nur einem Befehl ausgeführt werden.
- Google Cloud ist eine kostengünstige Möglichkeit, auf teurer Hardware zu experimentieren, aber man muss die Konfigurationen sorgfältig wählen.
- Die Geschwindigkeit der Ausführung einzelner Codefragmente zu messen, ist sehr nützlich, besonders in der Kombination von R und C++, und mit dem Paket bench ist es noch dazu sehr einfach.
Insgesamt war diese Erfahrung sehr hilfreich, und wir arbeiten weiterhin an der Lösung einiger der genannten Probleme.
Quelle: habr.com
