

Der Code von Softwareprodukten für maschinelles Lernen ist oft komplex und verwirrend. Das Entdecken und Beheben von Bugs in ihm ist eine ressourcenintensive Aufgabe. Selbst die einfachsten erfordern einen ernsthaften Ansatz zur Netzwerkarchitektur, zur Initialisierung von Gewichten und zur Optimierung des Netzwerks. Ein kleiner Fehler kann zu unangenehmen Problemen führen.
Dieser Artikel befasst sich mit dem Debugging-Algorithmus für Ihre neuronalen Netzwerke.
Skillbox empfiehlt: Praktischer Kurs .
Wir erinnern daran: alle Leser von „Habr“ erhalten einen Rabatt von 10.000 Rubel bei der Anmeldung zu einem beliebigen Kurs von Skillbox mit dem Aktionscode „Habr“.
Der Algorithmus besteht aus fünf Phasen:
- ein einfacher Start;
- Überprüfung der Verluste;
- Überprüfung der Zwischenresultate und Verbindungen;
- Diagnose der Parameter;
- Überwachung der Leistung.
Wenn Ihnen etwas interessanter erscheint als das andere, können Sie sofort zu diesen Abschnitten wechseln.
Ein einfacher Start
Eine neuronale Netzwerk mit komplexer Architektur, Regularisierung und Lernratenplaner zu debuggen, ist schwieriger als eine normale. Hier schummeln wir etwas, da dieser Punkt nur indirekt mit dem Debugging zu tun hat, aber es ist dennoch eine wichtige Empfehlung.
Ein einfacher Start besteht darin, ein vereinfachtes Modell zu erstellen und es mit einem Datensatz (Punkt) zu trainieren.
Zuerst erstellen wir ein vereinfachtes Modell
Für einen schnellen Start erstellen wir ein kleines Netzwerk mit einer einzigen versteckten Schicht und überprüfen, ob alles korrekt funktioniert. Dann machen wir das Modell schrittweise komplizierter, indem wir jeden neuen Aspekt seiner Struktur (eine zusätzliche Schicht, Parameter usw.) überprüfen und weiterarbeiten.
Trainieren Sie das Modell mit einem einzigen Datensatz (Punkt) von Daten
Zur schnellen Überprüfung der Funktionsfähigkeit Ihres Projekts können Sie ein oder zwei Datenpunkte zum Trainieren verwenden, um zu bestätigen, dass das System korrekt funktioniert. Das neuronale Netzwerk sollte eine Genauigkeit von 100 % im Training und in der Überprüfung zeigen. Wenn nicht, dann ist entweder das Modell zu klein oder Sie haben bereits einen Bug.
Selbst wenn alles gut aussieht, bereiten Sie das Modell darauf vor, eine oder mehrere Epochen zu durchlaufen, bevor Sie fortfahren.
Bewertung der Verluste
Die Bewertung der Verluste ist der Hauptweg, um die Leistung des Modells zu verfeinern. Sie müssen sicherstellen, dass der Verlust mit der Aufgabe übereinstimmt und die Verlustfunktionen auf der richtigen Skala bewertet werden. Wenn Sie mehr als einen Verlusttyp verwenden, stellen Sie sicher, dass alle von gleicher Ordnung sind und richtig skaliert werden.
Es ist wichtig, auf die anfänglichen Verluste zu achten. Überprüfen Sie, wie nah das tatsächliche Ergebnis der Erwartung ist, wenn das Modell mit einer zufälligen Annahme gestartet wurde. In : „Stellen Sie sicher, dass Sie das erwartete Ergebnis erzielen, wenn Sie mit einer kleinen Anzahl von Parametern arbeiten. Es ist besser, sofort den Verlust zu überprüfen (indem der Regularisierungsgrad auf Null gesetzt wird). Zum Beispiel erwarten wir für CIFAR-10 mit dem Softmax-Klassifikator, dass die anfänglichen Verluste 2.302 betragen, weil die erwartete diffuse Wahrscheinlichkeit 0.1 für jede Klasse beträgt (da es 10 Klassen gibt) und der Softmax-Verlust die negative logarithmische Wahrscheinlichkeit der richtigen Klasse ist, also –ln (0.1) = 2.302.“
Für ein binäres Beispiel wird eine ähnliche Berechnung für jede der Klassen durchgeführt. Hier sind zum Beispiel die Daten: 20 % 0's und 80 % 1's. Der erwartete anfängliche Verlust beträgt bis zu –0,2ln (0,5) –0,8ln (0,5) = 0,693147. Wenn das Ergebnis größer als 1 ist, kann das darauf hindeuten, dass die Gewichte des Neuralnetz nicht angemessen ausbalanciert sind oder die Daten nicht normalisiert sind.
Wir überprüfen die Zwischenergebnisse und Verbindungen
Für das Debugging des Neuralnetzwerks ist es notwendig, die Dynamik der Prozesse innerhalb des Netzwerks und die Rolle der einzelnen Zwischenschichten zu verstehen, da sie miteinander verbunden sind. Hier sind typische Fehler, mit denen Sie möglicherweise konfrontiert werden:
- falsche Ausdrücke für die Gradientenaktualisierungen;
- Gewichtsaktualisierungen werden nicht angewendet;
- verschwindende oder explodierende Gradienten (exploding gradients).
Wenn die Gradientenwerte null sind, bedeutet das, dass die Lernrate im Optimierer zu niedrig ist oder dass Sie mit einem falschen Ausdruck für die Gradientenaktualisierung konfrontiert sind.
Darüber hinaus sollten die Werte der Aktivierungsfunktionen, Gewichte und Aktualisierungen jeder Schicht überwacht werden. Zum Beispiel sollte die Größe der Parameteraktualisierungen (Gewichte und Bias) .
Es gibt ein Phänomen, das als „Dying ReLU“ bekannt ist oder , bei dem ReLU-Neuronen null ausgeben, nachdem sie einen großen negativen Bias-Wert für ihre Gewichte gelernt haben. Diese Neuronen werden an keinem Punkt der Daten jemals wieder aktiviert.
Sie können die Gradientenüberprüfung verwenden, um diese Fehler zu identifizieren, indem Sie den Gradienten mit einem numerischen Ansatz approximieren. Wenn er den berechneten Gradienten nahe kommt, wurde das Backpropagation korrekt implementiert. Um eine Gradientenüberprüfung zu erstellen, konsultieren Sie diese wunderbaren Ressourcen aus CS231 und , sowie das von Andrew Ng zu diesem Thema.
weist auf drei Hauptmethoden zur Visualisierung von neuronalen Netzwerken hin:
- Vorab-Methoden – einfache Methoden, die uns die allgemeine Struktur des trainierten Modells zeigen. Dazu gehört die Ausgabe von Formen oder Filtern einzelner Schichten des neuronalen Netzwerks und der Parameter in jeder Schicht.
- Aktivierungsbasierte Methoden. Hier entschlüsseln wir die Aktivierungen einzelner Neuronen oder Gruppen von Neuronen, um ihre Funktionen zu verstehen.
- Gradientenbasierte Methoden. Diese Methoden tendieren dazu, mit Gradienten zu arbeiten, die aus dem Vorwärts- und Rückwärts-Durchlauf beim Training des Modells generiert werden (einschließlich Bedeutungskarten und Aktivierungskarten der Klasse).
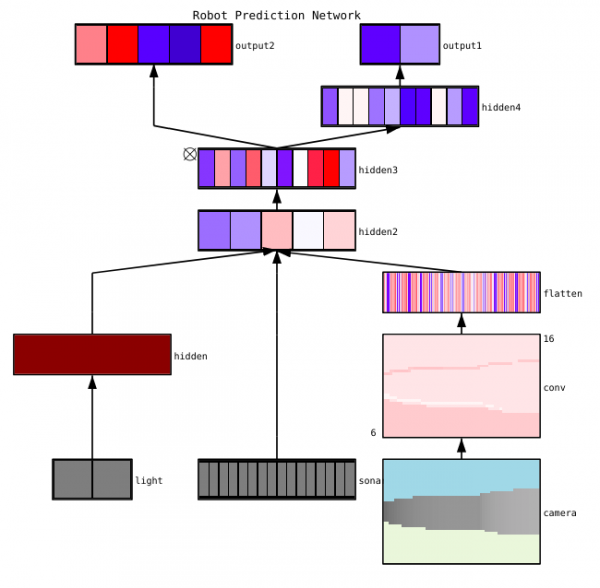
Es gibt mehrere nützliche Tools zur Visualisierung von Aktivierungen und Verbindungen einzelner Schichten, wie zum Beispiel und .
Parameterdiagnose
Neuronale Netzwerke haben eine Vielzahl von Parametern, die miteinander interagieren, was die Optimierung erschwert. Tatsächlich ist dieser Abschnitt Gegenstand aktiver Forschung von Fachleuten, daher sollten die folgenden Vorschläge nur als Ratschläge und Ausgangspunkte betrachtet werden.
Batch-Größe – die Batch-Größe sollte groß genug sein, um genaue Schätzungen des Fehlergradienten zu erhalten, aber klein genug, damit der stochastische Gradientenabstieg (SGD) Ihr Netzwerk ordnen kann. Kleine Batch-Größen führen zu schnellerer Konvergenz aufgrund von Rauschen während des Trainings und damit zu Optimierungsschwierigkeiten. Dies wird ausführlicher beschrieben .
Lernrate – eine zu niedrige Lernrate führt zu langsamer Konvergenz oder dem Risiko, in lokalen Minima stecken zu bleiben. Gleichzeitig kann eine hohe Lernrate zu Divergenz der Optimierung führen, da Sie riskieren, über einen steilen, aber schmalen Teil der Verlustfunktion 'hinwegzuspringen'. Versuchen Sie, die Lernrate während des Trainings des neuronalen Netzwerks zu planen. Im Kurs CS231n .
Gradientenbeschneidung – Beschneidung der Gradientenparameter während der Rückwärtsausbreitung basierend auf dem maximalen Wert oder der Grenznorm. Nützlich zur Lösung von Problemen mit explosiven Gradienten, die Sie im dritten Punkt antreffen können.
Batch-Normalisierung – wird verwendet, um die Eingabedaten jeder Schicht zu normalisieren, was hilft, das Problem der internen Kovariatenverschiebung zu lösen. Wenn Sie Dropout und Batch Normalization zusammen verwenden, .
Stochastischer Gradientenabstieg (SGD) – es gibt mehrere Varianten von SGD, die Momentum, adaptive Lernraten und die Nesterov-Methode nutzen. Dabei hat keine von ihnen einen klaren Vorteil hinsichtlich der Effizienz des Lernens oder der Verallgemeinerung ().
Regulierung – ist entscheidend für den Aufbau eines generalisierbaren Modells, da sie eine Strafe für die Komplexität des Modells oder extreme Parameterwerte hinzufügt. Dies ist ein Weg, die Varianz des Modells zu reduzieren, ohne signifikant dessen Verzerrung zu erhöhen. Mehr .
Um alles selbst zu bewerten, ist es notwendig, die Regularisierung auszuschalten und den Verlustgradienten selbst zu überprüfen.
Dropout – ist eine weitere Methode, um Ihr Netzwerk zu strukturieren, um Überanpassung zu verhindern. Während des Trainings wird das Dropout nur durch die Beibehaltung der Aktivität eines Neurons mit einer gewissen Wahrscheinlichkeit p (Hyperparameter) oder durch Setzen auf null im anderen Fall durchgeführt. Dadurch muss das Netzwerk ein anderes Teilset von Parametern für jede Trainingsbatch verwenden, was die Veränderungen bestimmter Parameter reduziert, die dominant werden.
Wichtig: Wenn Sie sowohl Dropout als auch Batch-Normalisierung verwenden, seien Sie vorsichtig mit der Reihenfolge dieser Vorgänge oder sogar mit deren gleichzeitiger Verwendung. All dies wird noch aktiv diskutiert und ergänzt. Hier sind zwei wichtige Diskussionen zu diesem Thema und .
Arbeitskontrolle
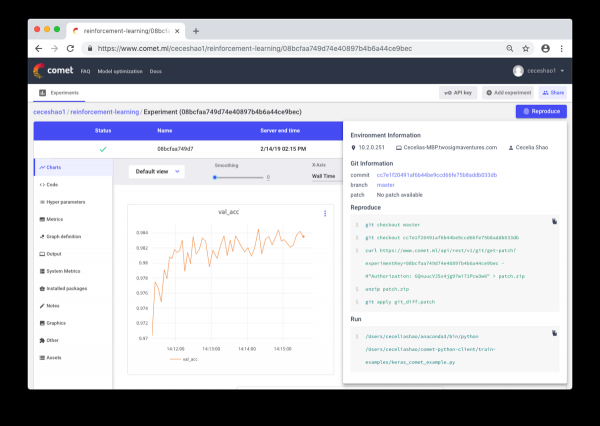
Es geht um die Dokumentation von Arbeitsprozessen und Experimenten. Wenn man nichts dokumentiert, kann man vergessen, welche Lernrate oder Gewichtung der Klassen verwendet wird. Durch die Überwachung ist es problemlos möglich, frühere Experimente einzusehen und nachzuvollziehen. Dadurch kann die Anzahl der sich wiederholenden Experimente verringert werden.
Allerdings kann die manuelle Dokumentation bei einem großen Arbeitsaufwand zu einer Herausforderung werden. Hier kommen Werkzeuge wie Comet.ml ins Spiel, die dabei helfen, Datensätze, Codeänderungen, die Historie von Experimenten und Produktionsmodelle automatisch zu protokollieren, einschließlich wichtiger Informationen über Ihr Modell (Hyperparameter, Leistungskennzahlen und Umgebungsinformationen).
Neurale Netzwerke können sehr empfindlich auf kleine Änderungen reagieren, was zu einem Rückgang der Modellleistung führen kann. Das Tracking und die Dokumentation der Arbeit sind der erste Schritt, den Sie unternehmen sollten, um die Umgebung und Modellierung zu standardisieren.
Ich hoffe, dass dieser Post ein Ausgangspunkt sein kann, von dem aus Sie das Debugging Ihres neuronalen Netzwerks beginnen.
Skillbox empfiehlt:
- Zweijähriger praktischer Kurs .
- Online-Kurs .
- Praktischer Jahreskurs .
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish