

La empresa NVIDIA ha publicado el código fuente de StyleGAN3, un sistema de aprendizaje automático basado en una red neuronal generativa adversarial (GAN) diseñado para sintetizar imágenes realistas de rostros humanos. El código está escrito en Python utilizando el marco PyTorch y se distribuye bajo la licencia NVIDIA Source Code License, que impone restricciones sobre el uso comercial.
También están disponibles para descarga modelos preentrenados, entrenados en la colección Flickr-Faces-HQ (FFHQ), que incluye 70,000 imágenes PNG de alta calidad (1024×1024) de rostros humanos. Además, hay modelos basados en las colecciones AFHQv2 (fotos de rostros de animales) y Metfaces (imágenes de rostros humanos de retratos de pintura clásica). Aunque el desarrollo se centra en los rostros, el sistema se puede entrenar para generar cualquier objeto, como paisajes y automóviles. También se proporcionan herramientas para entrenar la red neuronal con colecciones de imágenes propias. Se requiere una o varias tarjetas gráficas NVIDIA (se recomienda GPU Tesla V100 o A100), al menos 12 GB de RAM, PyTorch 1.9 y el toolkit CUDA 11.1+. Se está desarrollando un detector especial para identificar la naturaleza artificial de los rostros generados.
El sistema permite sintetizar la imagen de un nuevo rostro mediante la interpolación de características de varios rostros, combinando rasgos característicos y adaptando la imagen final a la edad, género, longitud del cabello, expresión de la sonrisa, forma de la nariz, color de piel, gafas y ángulo de la fotografía necesarios. El generador considera la imagen como una colección de estilos, separando automáticamente los detalles característicos (pecas, cabello, gafas) de los atributos generales de alto nivel (postura, género, cambios relacionados con la edad) y permite combinarlos de manera arbitraria, determinando las propiedades dominantes a través de coeficientes de peso. Como resultado, se generan imágenes prácticamente indistinguibles de las fotografías reales.
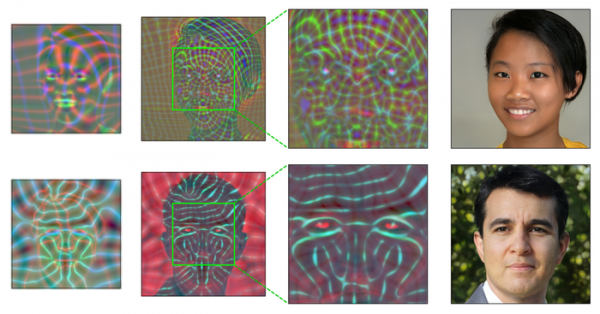
La primera versión de la tecnología StyleGAN fue publicada en 2019, tras lo cual en 2020 se propuso una edición mejorada, StyleGAN2, que permite una mejor calidad de las imágenes y elimina algunos artefactos. Sin embargo, el sistema seguía siendo estático, es decir, no permitía lograr una animación realista y movimiento facial. En el desarrollo de StyleGAN3, el objetivo principal fue adaptar la tecnología para su aplicación en animación y video.
StyleGAN3 utiliza una arquitectura de generación de imágenes reestructurada, libre de aliasing, y se proponen nuevos escenarios de entrenamiento para la red neuronal. Incluye nuevas herramientas para visualización interactiva (visualizer.py), análisis (avg_spectra.py) y generación de video (gen_video.py). Además, se ha reducido el consumo de memoria y se ha acelerado el proceso de entrenamiento.
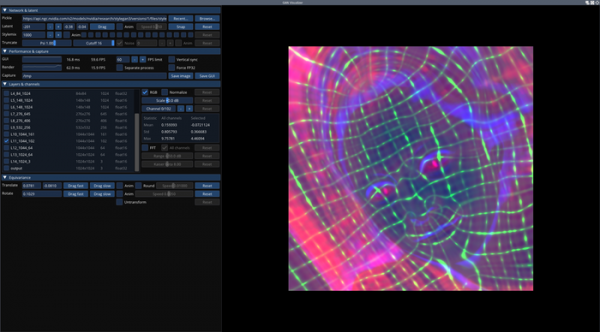
Una característica clave de la arquitectura StyleGAN3 fue la transición a la interpretación de todas las señales en la red neuronal en forma de procesos continuos, lo que permitió manipular las posiciones relativas al formar detalles, no atados a coordenadas absolutas de píxeles individuales en la imagen, sino fijados a la superficie de los objetos representados. En StyleGAN y StyleGAN2, la vinculación a los píxeles al generar causaba problemas en la visualización dinámica, por ejemplo, al moverse la imagen se observaba desincronización de pequeños detalles, como arrugas y cabellos, que se movían como si estuvieran separados del resto de la cara. En StyleGAN3, estos problemas se han resuelto y la tecnología se ha vuelto completamente adecuada para la creación de video.
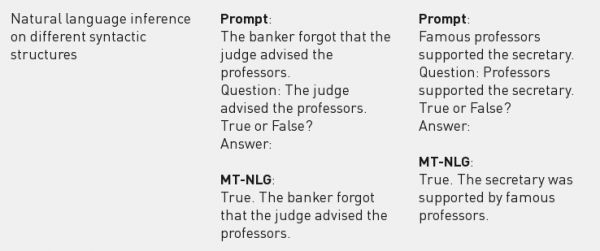
Adicionalmente, se puede mencionar el anuncio de la creación por parte de NVIDIA y Microsoft del mayor modelo de lenguaje MT-NLG basado en una red neuronal profunda con arquitectura de «transformer». El modelo abarca 530 mil millones de parámetros, y para su entrenamiento se utilizó un clúster que cuenta con 4480 GPU (560 servidores DGX A100 con 8 GPU A100 de 80 GB cada uno). Las áreas de aplicación del modelo incluyen la resolución de tareas de procesamiento de información en lenguaje natural, como la predicción del final de una oración incompleta, respuestas a preguntas, comprensión lectora, generación de conclusiones en lenguaje natural y desambiguación del significado de las palabras.
Fuente: opennet.ru
